
PyTorch optimization tools กลายเป็นด่านหน้าใหม่ของ machine learning infrastructure
หัวข้อหลักของบทความนี้คือการที่ PyTorch ได้รับการรองรับแบบเนทีฟบนฮาร์ดแวร์เฉพาะทางอย่าง TPU และ AWS Trainium ผ่านเครื่องมือโอเพนซอร์ส TorchTPU และ TorchNeuron ซึ่งช่วยให้เวิร์กโหลด PyTorch สามารถรันบนตัวเร่งความเร็วเหล่านี้ได้โดยแทบไม่ต้องแก้ไขโค้ด ลดความยุ่งยากในการปรับเฟรมเวิร์กและทำให้การนำโมเดลไปใช้งานบนโครงสร้างพื้นฐานแมชชีนเลิร์นนิงมีประสิทธิภาพและเข้าถึงได้มากขึ้นสำหรับนักพัฒนาและองค์กรทุกขนาด ในงาน PyTorch Conference 2026 Google ประกาศเปิดซอร์ส TorchTPU สแต็ก PyTorch แบบเนทีฟสำหรับ Tensor Processing Units บน GitHub อย่างเป็นทางการ ขณะที่ Amazon เปิดตัว TorchNeuron ชุดเครื่องมือโอเพนซอร์สสำหรับรันเวิร์กโหลด PyTorch บนชิป AWS Trainium ทั้งสองเหตุการณ์ไม่ใช่แค่ข่าวผลิตภัณฑ์ใหม่ แต่เป็นสัญญาณว่าผู้ให้บริการคลาวด์รายใหญ่กำลังยอมรับว่าความง่ายในการทำ AI framework deployment สำคัญพอ ๆ กับพลังการคำนวณ การผลัก PyTorch เข้าไปอยู่ใจกลางของ TPU hardware support และ AWS Trainium chips โดยตรง ทำให้ PyTorch optimization tools กลายเป็นหัวใจของ machine learning infrastructure ยุคใหม่ที่เน้นความยืดหยุ่นและเปิดกว้างมากกว่าการล็อกผู้ใช้ไว้กับสแต็กเฉพาะ
TorchTPU: TPU ไม่ใช่แค่ของเล่นสายวิจัย แต่เป็นตัวเลือกเนทีฟของ PyTorch แล้ว
การเปิดซอร์ส TorchTPU ทำให้ TPU ขยับจากภาพเดิมที่ดูเป็นฮาร์ดแวร์เฉพาะทางของทีมวิจัย กลายเป็นตัวเลือกเนทีฟในระดับเดียวกับ GPU และ CPU สำหรับงาน PyTorch ตั้งแต่การฝึก การให้บริการ ไปจนถึงการนำไปใช้งานจริงผ่านเครื่องมืออย่าง vLLM, SGLang, llm-d, TorchTitan, Ray, TorchRec, Hugging Face และ LiteRT จุดสำคัญคือสแต็กนี้ถูกออกแบบให้รันเวิร์กโหลด PyTorch ที่มีอยู่บน TPU ได้โดยแทบไม่ต้องแก้ไขโค้ด ซึ่งเป็นการตัดต้นทุนด้านเวลาและความเสี่ยงจากการพอร์ตโค้ดไปเฟรมเวิร์กอื่น ในเชิงสถาปัตยกรรม TorchTPU สานต่อแนวทาง Eager First ที่เปิดตัวต่อสาธารณะตั้งแต่เดือนเมษายน 2026 บนอินเทอร์เฟซ PrivateUse1 ของ PyTorch นักพัฒนาสามารถดีบักโมเดลในโหมด eager แล้วค่อยเพิ่มประสิทธิภาพด้วย torch.compile เพื่อปรับการใช้ TPU ให้เหมาะสมและลดภาระหน่วยความจำ แนวทางนี้ต่างจากยุคที่ต้องย้ายไปใช้เฟรมเวิร์กอื่นเพื่อเข้าถึง TPU โดยตรงอย่างชัดเจน และส่งผลให้ทีมที่ลงทุนกับ PyTorch มานานไม่ต้องเสียโอกาสเพียงเพราะเลือกฮาร์ดแวร์ผิดฝั่ง
ตัวเลขที่บอกว่า TorchTPU ไม่ใช่แค่สวยหรูบนสไลด์
สิ่งที่ทำให้ TorchTPU น่าเชื่อถือไม่ใช่แค่คำประกาศ แต่เป็นตัวเลขที่แสดงให้เห็นว่ามันทำงานได้จริงในระดับศูนย์ข้อมูล Google ระบุว่าการผสานรวม TorchTPU กับ TorchTitan สำหรับการฝึกแบบกระจาย ถูกตรวจสอบความถูกต้องบน Ironwood TPU รุ่น v7x สูงสุดถึง 8,000 ตัว และสามารถขยายขนาดได้เกือบเป็นเส้นตรงเมื่อใช้ Ironwood TPU สูงสุด 8,192 ตัว โดยทำค่า Model Flops Utilization ได้สูงสุด 52% บนโมเดล Qwen 3 8B นี่คือคำยืนยันว่าการฝึกโมเดลขนาดใหญ่บน TPU ผ่าน PyTorch ไม่ใช่การทดลองในห้องแลบ แต่เป็นเวิร์กโหลดระดับผลิตจริง ในฝั่งการอนุมาน llm-d 1.0 ซึ่งเชื่อมระบบนิเวศการให้บริการ PyTorch เข้ากับการนำไปใช้งานบน Kubernetes แสดงผลลัพธ์ที่จับต้องได้เช่นกัน ศ. Sashikumaar Ganesan ระบุว่า GKE Inference Gateway ที่ขับเคลื่อนด้วย llm-d ทำให้ปริมาณงานอนุมานรวมสำหรับการสร้างข้อมูลสังเคราะห์ของบริษัทสูงขึ้นกว่า 4 เท่า โดยเพิ่มความสามารถในการสร้างโทเคนต่อวันจาก 1.47 พันล้านเป็น 5.97 พันล้านโทเคนต่อเครื่องเร่งความเร็ว TPU v6e จำนวน 1,000 ตัว ตัวเลขนี้สะท้อนว่าการลงทุนกับสแต็ก PyTorch บน TPU สามารถแปลงเป็นผลผลิตเชิงธุรกิจได้ ไม่ใช่แค่คะแนนเบนช์มาร์ก
TorchNeuron กับ AWS Trainium: เมื่อฮาร์ดแวร์แรงไม่พอ ต้องทำให้ใช้ได้ง่ายด้วย
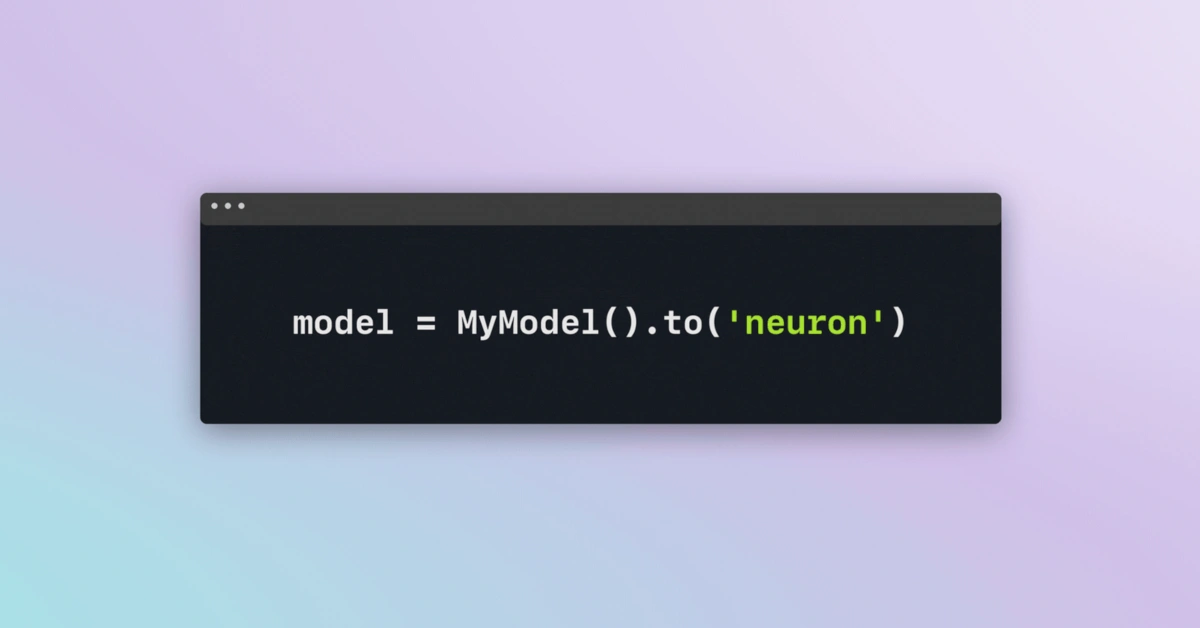
ฝั่ง Amazon ปัญหาที่ถูกยอมรับตรง ๆ คือการรันโปรเจกต์ AI ที่ใช้ PyTorch บนอินสแตนซ์ AWS ที่ใช้ชิป Trainium ก่อนหน้านี้ต้องอาศัยการทำงานแบบแมนนวลจำนวนมาก เพิ่มต้นทุนในการพัฒนาและสร้างอุปสรรคต่อการเข้าใช้งานของผู้ใช้ TorchNeuron ถูกออกแบบมาเพื่อตัดความยุ่งยากนี้ โดยช่วยให้สามารถรันโปรเจกต์ PyTorch บนชิป Trainium ได้โดยไม่ต้องแก้ไขโค้ดมากมาย นักพัฒนาต้องเพียงตั้งค่าให้เวิร์กโหลดใช้ชิปที่ต้องการ และ TorchNeuron รองรับทั้ง Trainium2 และ Trainium3 Trainium3 เองเป็นโปรเซสเซอร์ที่มีสเปกน่าจับตา มีคอร์ประมวลผล 8 คอร์ แต่ละคอร์ประกอบด้วย 4 โมดูลที่ปรับแต่งมาสำหรับชุดข้อมูลย่อยต่าง ๆ ที่โมเดล AI ใช้ในการประมวลผล และมีหน่วยความจำออนบอร์ดขนาด 154 กิกะไบต์สำหรับเก็บข้อมูลโมเดล AWS รัน Trainium3 ในเซิร์ฟเวอร์แบบคัสตอมที่รองรับตัวเร่งความเร็วได้สูงสุด 144 ตัวต่อเครื่อง โดยระบบเดียวสามารถดำเนินการคำนวณได้สูงสุดถึง 362 พันล้านล้านครั้งต่อวินาทีในรูปแบบ MXFP8 แต่ตัวเลขเหล่านี้จะมีความหมายก็ต่อเมื่อทีมพัฒนาสามารถนำเวิร์กโหลด PyTorch ไปใช้บนชิปเหล่านี้ได้โดยไม่ต้องสร้างสแต็กใหม่ทั้งชุด ซึ่งคือช่องว่างที่ TorchNeuronกำลังปิด
ผลกระทบต่อ AI framework deployment และทิศทางต่อไปของนักพัฒนา
ทั้ง TorchTPU และ TorchNeuron มีจุดร่วมสำคัญคือการลดความจำเป็นในการแปลงเฟรมเวิร์กหรือเขียนโค้ดใหม่จำนวนมากเพื่อใช้ฮาร์ดแวร์เฉพาะทาง ซอฟต์แวร์ TorchTPU ถูกพัฒนาร่วมกับทีม PyTorch ของ Meta เพื่อให้เวิร์กโหลด PyTorch ที่มีอยู่รันบน TPU ได้โดยแทบไม่ต้องแก้ไขโค้ด ขณะที่ TorchNeuron ก็ช่วยให้โปรเจกต์ PyTorch บนชิป Trainium ใช้งานได้โดยไม่ต้องแก้ไขโค้ดมากมาย นี่คือการยอมรับว่าค่าใช้จ่ายที่แท้จริงของ AI framework deployment ไม่ได้อยู่แค่ค่าคอมพิวต์ แต่รวมถึงเวลาที่ทีมต้องเสียไปกับการพอร์ตและดีบัก ในระดับ ecosystem TorchNeuron ยังรองรับเครื่องมือโอเพนซอร์สอื่น ๆ ที่มักใช้คู่กับ PyTorch รวมถึง TorchTitan เอนจินการฝึกฝน AI ที่ช่วยกระจายการฝึกข้ามตัวเร่งความเร็วต่าง ๆ โดยใช้ Fully Sharded Data Parallelism หรือ FSDP ด้าน Google ก็ผลัก TorchTPU เข้าไปอยู่ในเวิร์กโฟลว์เดียวกับ Ray เพื่อจัดการการประมวลผลข้อมูล การฝึก การเรียนรู้แบบเสริมกำลัง และการให้บริการด้วย PyTorch บน CPU GPU และ TPU ทิศทางนี้บอกนักพัฒนาว่าอนาคตของ machine learning infrastructure จะไม่แยกฮาร์ดแวร์ออกจากเฟรมเวิร์กอีกต่อไป แต่จะผูกให้ทำงานร่วมกันอย่างแนบแน่นผ่านสแต็กโอเพนซอร์สที่ปรับแต่งมาเฉพาะ