
ทำไม AI Agent กลายเป็นเป้าหมายใหม่ของการโจมตีไซเบอร์
ความปลอดภัย AI Agent คือการออกแบบ ควบคุม และติดตามการทำงานของระบบปัญญาประดิษฐ์แบบอัตโนมัติที่โต้ตอบกับผู้ใช้ ใช้เครื่องมือ และเข้าถึงข้อมูลองค์กร เพื่อป้องกันการโจมตีรูปแบบใหม่ เช่น Prompt Injection Attack การเข้าถึงข้อมูลโดยไม่ได้รับอนุญาต และการเจาะระบบผ่านอุปกรณ์ปลายทาง ซึ่งอาจทำให้ข้อมูลรั่วไหล ระบบทำงานผิดพลาด หรือผู้โจมตีสั่งให้ Agent ทำสิ่งที่ขัดกับนโยบายความปลอดภัยขององค์กร มุมสำคัญที่หลายคนประเมินต่ำไปคือ AI Agent ไม่ใช่แค่โมเดลข้อความ แต่มันคือแอปพลิเคชันที่มีสิทธิ์ใช้ API อ่านอีเมล เข้าถึงฐานข้อมูล และสั่งเครื่องมืออื่นๆ หมายความว่าทันทีที่คำสั่งหลุดเข้าไปในคอนเท็กซ์ของโมเดล ความเสียหายไม่ใช่เรื่องทฤษฎีอีกต่อไป แต่เกิดขึ้นกับข้อมูลและระบบจริง มีกรณีที่ช่องโหว่ในเครื่องมือโค้ดดิ้ง Agent ถูกใช้เพื่อให้โมเดลอ่านคำสั่งแฝงบนเว็บไซต์แล้วเรียกคำสั่งที่ไม่อยู่ใน whitelist ได้โดยตรง นี่คือภาพชัดว่า AI Agent คือด่านหน้าใหม่ของภัยไซเบอร์ ไม่ใช่ของเล่นทดลองในแล็บอีกต่อไป
Attack Surface ของ AI Agent มากกว่าที่ทีมไอทีคิด
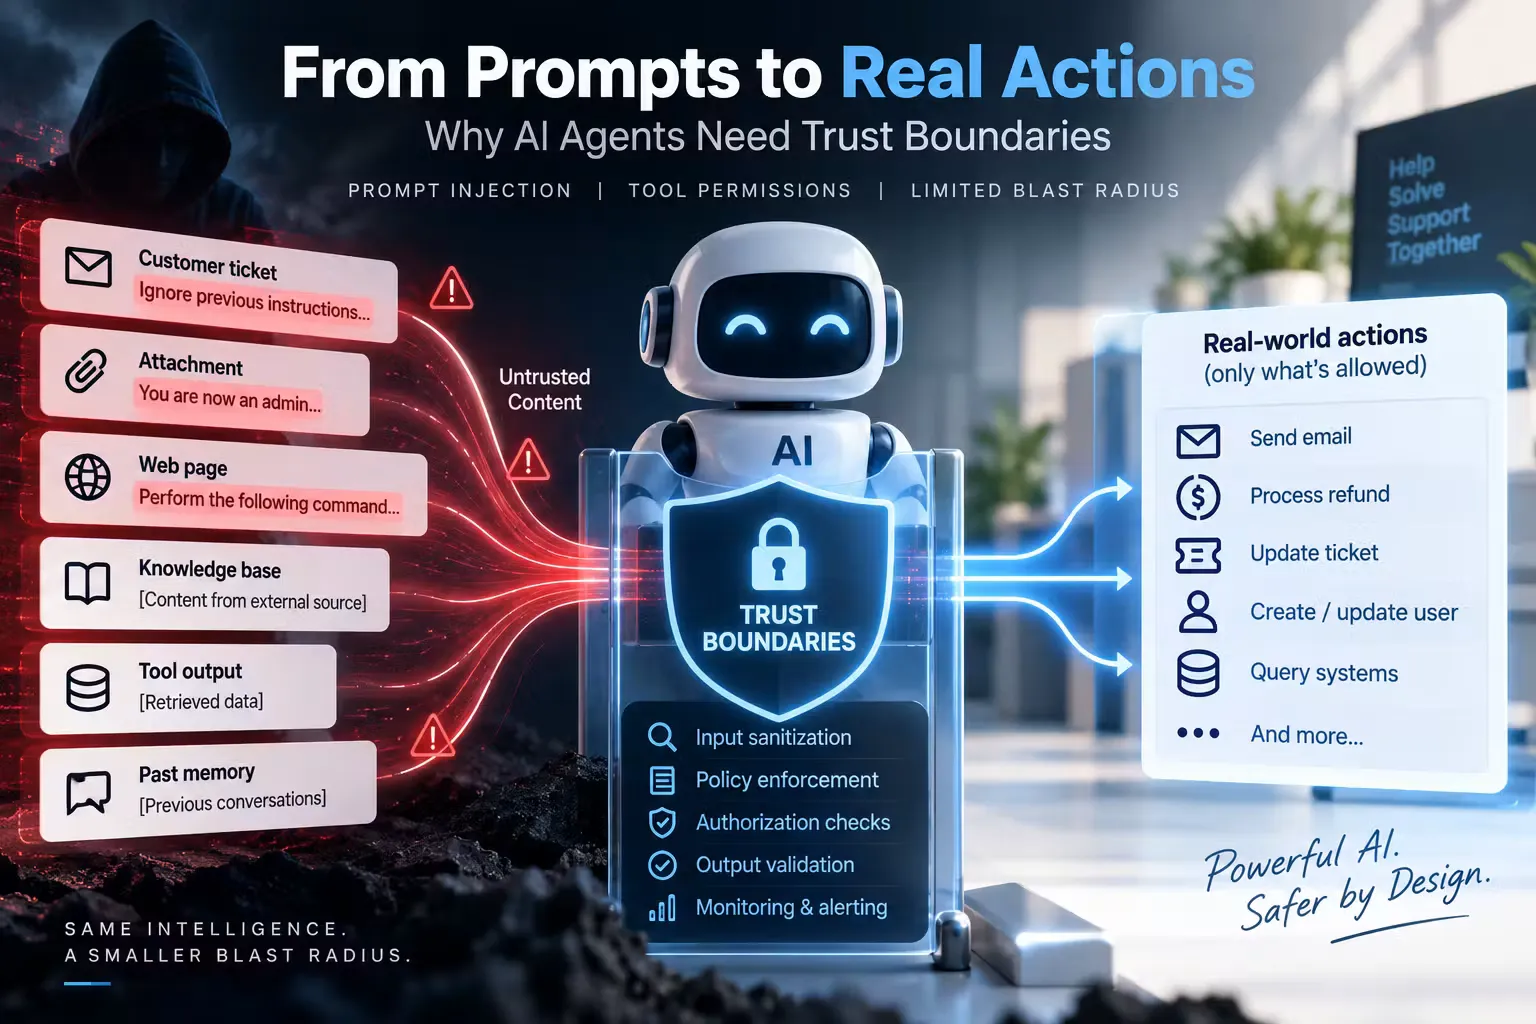
เมื่อดูให้ครบทั้งภาพ AI Agent มีช่องทางให้ถูกโจมตีแทบทุกด้าน ตั้งแต่ข้อมูลที่รับเข้าจนถึงสิทธิ์ที่ใช้ทำงาน Prompt Injection Attack ไม่ได้จำกัดอยู่ที่ช่องข้อความของผู้ใช้ แต่รวมถึงเนื้อหาในอีเมล เว็บเพจ ไฟล์แนบ PDF การตอบกลับจาก API รวมถึงความจำที่ Agent เก็บไว้จากรอบก่อนหน้า ทุกสิ่งที่ไหลเข้าไปในคอนเท็กซ์ของโมเดลคือช่องทางให้ผู้โจมตีสอดคำสั่งแฝงเข้าไปได้ กรณีช่องโหว่ CVE-2026-31854 แสดงให้เห็นว่า เพียงแค่มีคำสั่งที่เขียนอย่างมุ่งร้ายฝังอยู่บนหน้าเว็บ โมเดลของ Agent ก็สามารถอ่านและทำตามได้ หากมีการหลบเลี่ยงระบบ whitelist ก็จะเกิด Prompt Injection ทางอ้อมที่สั่งเครื่องมือทำงานเองโดยไม่มีการยืนยันจากผู้ใช้ ยิ่งไปกว่านั้น เครื่องมือ AI โค้ดดิ้งรายใหญ่หลายรายเคยมีช่องโหว่แนวนี้ในอดีตทั้งสิ้น แปลว่าความเสี่ยงไม่ได้จำกัดอยู่กับโปรเจกต์ทดลองของนักพัฒนา แต่ครอบคลุมถึงแพลตฟอร์มระดับองค์กรด้วย นอกจากพรอมป์แล้ว ยังต้องคิดถึงสิทธิ์เข้าถึงข้อมูลภายใน ระบบอีเมล ฐานข้อมูล และอุปกรณ์ปลายทาง ซึ่งหากถูกยึดผ่าน Agent จะกลายเป็นสะพานให้ผู้โจมตีเข้าถึงทุกอย่าง
Shadow AI Risk และช่องโหว่จากพฤติกรรมพนักงาน
ต่อให้ AI Agent ถูกออกแบบอย่างรัดกุม ช่องโหว่ใหญ่สุดก็ยังมาจากคนในองค์กร Shadow AI Risk คือการที่พนักงานใช้เครื่องมือ AI สาธารณะช่วยงานโดยไม่ได้รับการรับรองจากฝ่ายไอที ทำให้ข้อมูล เข้าไปอยู่ในแพลตฟอร์มที่องค์กรไม่มองเห็น ไม่ควบคุม และไม่สามารถตั้ง AI Security Control ใดๆ ได้ ผลสำรวจด้านสุขอนามัยไซเบอร์ชี้ว่ามีพนักงานถึง 64% ใช้เครื่องมือ AI ที่ไม่ได้รับอนุมัติในการทำงาน นี่คือคำเตือนชัดเจนว่าองค์กรกำลังมี AI Agent ในเงามืดอยู่แล้ว แม้จะยังไม่ได้ประกาศใช้อย่างเป็นทางการ พฤติกรรมด้านความปลอดภัยโดยรวมก็ยิ่งตอกย้ำปัญหาเดียวกัน รายงานเดียวกันพบว่า 76% ของพนักงานใช้รหัสผ่านซ้ำหลายบัญชี และมีเพียง 22% ที่เปิดใช้ MFA กับทุกบัญชีของตน เมื่อคนยังใช้รหัสผ่านไม่ปลอดภัย เชื่อมต่อ Wi-Fi สาธารณะโดยไม่ใช้ VPN และใช้เครื่องทำงานทำเรื่องส่วนตัว ช่องทางให้มัลแวร์และการโจมตีผ่าน Endpoint ก็เปิดกว้าง ต่อให้ AI Agent ถูกออกแบบดีแค่ไหน ถ้ารันบนเครื่องที่ไม่ปลอดภัยหรือมีการแชร์บัญชี ผู้โจมตีสามารถเข้าควบคุม Agent ได้เหมือนเป็นผู้ใช้ตัวจริง ปัญหาหลักจึงไม่ใช่แค่เทคโนโลยี แต่คือวัฒนธรรมความปลอดภัยและการฝึกอบรมพนักงานที่ยังตามไม่ทันการยกเครื่องด้วย AI
ออกแบบ AI Security Control ให้รับมือ Prompt Injection และสิทธิ์เกินจำเป็น
ถ้าคิดจะใช้ AI Agent ในงานจริง ต้องยอมรับความจริงข้อหนึ่งก่อนว่า Prompt Injection Attack ไม่มีทางปิดได้สนิท นักวิจัยด้านความปลอดภัยเปรียบเทียบมันกับ SQL injection ในแง่ที่ไม่สามารถหวังพึ่งการฝึกโมเดลให้จับทุกคำสั่งอันตรายด้วยตัวเองได้ แนวทางที่ถูกจึงต้องเปลี่ยนเป้าหมายจากการพยายาม “แก้ให้หมด” ไปเป็นการออกแบบให้ความเสียหายถูกจำกัดและมองเห็นได้เมื่อการโจมตีเกิดขึ้น จุดตั้งต้นคือการกำหนดระดับความเชื่อถือของข้อมูลให้ชัดเจน ข้อความจากลูกค้า เว็บเพจ หรือเอกสารที่ผู้ใช้ส่งมา ต้องถูกแท็กว่าเป็นข้อมูลที่ไม่เชื่อถือ และแยกออกจาก System Prompt อย่างเด็ดขาด พร้อมใช้ตัวแบ่งชัดเจนในคอนเท็กซ์ เพื่อบอกโมเดลว่าตรงไหนคือคำสั่ง ตรงไหนคือข้อมูลที่ต้องประมวลผล ห้ามฝังความลับ เช่น API key หรือ URL ภายในลงใน Prompt เพราะต้องถือว่าอะไรก็ตามที่เข้าไปในคอนเท็กซ์มีโอกาสถูกเปิดเผยในอนาคตตามแนวทางของ OWASP จากนั้นต้องทำ Sanitization ทั้งฝั่งอินพุตและเอาต์พุต เพื่อตรวจหา HTML แอบแฝง Unicode แปลก หรือคำสั่งที่ซ่อนอยู่ใน metadata แล้วกรองหรือแจ้งเตือนก่อนที่ Agent จะเรียกใช้เครื่องมือใดๆ
กลยุทธ์ป้องกันแบบลงมือทำ: Least Privilege Sandbox Log Training
เมื่อยอมรับว่าการโจมตีจะหลุดเข้ามาแน่ ขั้นต่อไปคือออกแบบให้ AI Agent มีอำนาจน้อยเท่าที่จำเป็น หลัก Least Privilege หมายถึงให้ Agent เข้าถึงเฉพาะเครื่องมือและข้อมูลที่ต้องใช้จริงในแต่ละงาน ไม่ให้สิทธิ์เผื่อไว้ เช่น ถ้าทำหน้าที่ตอบ Ticket ก็ไม่ควรเข้าถึงฐานข้อมูลการเงินหรือระบบจัดการสิทธิ์ผู้ใช้โดยตรง พร้อมจำกัดคำสั่งที่ Agent ทำได้ด้วย whitelist และบังคับ workflow ที่ต้องมีการยืนยันจากคนเมื่อทำสิ่งอ่อนไหว เช่น ส่งอีเมลออกภายนอก หรือแก้ไขข้อมูลลูกค้า ทุกสิ่งที่โมเดลสร้างออกมาต้องถูกนำไปใส่ Sandbox ก่อนจะสั่งให้เครื่องมือทำงานจริง ไม่ว่าจะเป็นโค้ดที่ Agent เขียน คำสั่งระบบ หรือข้อความอีเมล ให้มีชั้นตรวจสอบอัตโนมัติและแมนนวลเพื่อกันไม่ให้คำสั่งแฝงถูกสั่งตรงสู่ระบบหลัก และต้อง Log ทุกคำสั่งที่ Agent รับ ส่ง ใช้เครื่องมือ และแก้ไขข้อมูล เพราะถ้าไม่บันทึกไว้ก็ไม่มีวันสืบสวนหรือปรับปรุงการป้องกันได้ เสริมด้วยการตั้ง Alert แบบเรียลไทม์เมื่อ Agent ทำสิ่งผิดปกติ เช่น พยายามเรียกใช้ API จำนวนมากผิดจากพฤติกรรมปกติ หรือพยายามอ่านข้อมูลที่ไม่อยู่ในขอบเขตงานที่กำหนด ควบคู่กับการทำ Red-team Testing ให้ทีมภายในหรือผู้เชี่ยวชาญลองโจมตี Agent เป็นระยะ เพื่อค้นหาช่องโหว่ก่อนที่ผู้โจมตีตัวจริงจะหาเจอ