
DeepSeek V4.1-Flash คืออะไร และทำไมจึงสำคัญ
DeepSeek V4.1-Flash คือโมเดล AI ประสิทธิภาพสูงที่ออกแบบมาให้ประหยัดทรัพยากร รองรับทั้งข้อความและภาพในโมเดลเดียว มุ่งตอบโจทย์การใช้งานระดับธุรกิจและนักพัฒนาด้วยความเร็ว ค่าใช้จ่ายต่อการประมวลผลที่ต่ำลง และความสามารถใกล้เคียงโมเดลระดับเรือธงที่มีราคาสูงกว่าอย่างมาก โดยเน้นการใช้งานจริงในงานตัวแทนอัตโนมัติ การเขียนโค้ด และงานวิเคราะห์ข้อมูลเชิงลึกที่ต้องใช้บริบทยาวต่อเนื่อง
ห้องปฏิบัติการ AI ของ DeepSeek ประกาศเปิดตัว DeepSeek-V4.1-Flash โดยนิยามว่าเป็นโมเดลที่ฉลาดขึ้น เร็วขึ้น และมีประสิทธิภาพมากขึ้น โมเดลนี้เป็นสมาชิกที่มีขนาดเล็กที่สุดในสถาปัตยกรรมตระกูลใหม่ และเป็นตัวแรกในตระกูลที่ฝังความสามารถเห็นภาพ AI และ Multimodal AI ขนาดเล็กไว้ในตัวโมเดลโดยตรง ไม่ใช่โมดูลเสริมภายนอก การออกแบบนี้ส่งสัญญาณชัดว่า ยุคที่โมเดล AI ราคาประหยัดต้องยอมแพ้ให้รุ่นเรือธงนั้นกำลังเปลี่ยนไปแล้ว โดยเฉพาะเมื่อ DeepSeek ประกาศชัดว่าต้องการให้โมเดลระดับ “flash” ไม่ตามหลังโมเดลชั้นนำจากค่ายอื่นในด้านความสามารถ ขณะเดียวกันกลับใช้ต้นทุนการรันเพียงส่วนหนึ่งเท่านั้น
ประสิทธิภาพทัดเทียมรุ่นเรือธง ในร่าง Multimodal AI ขนาดเล็ก
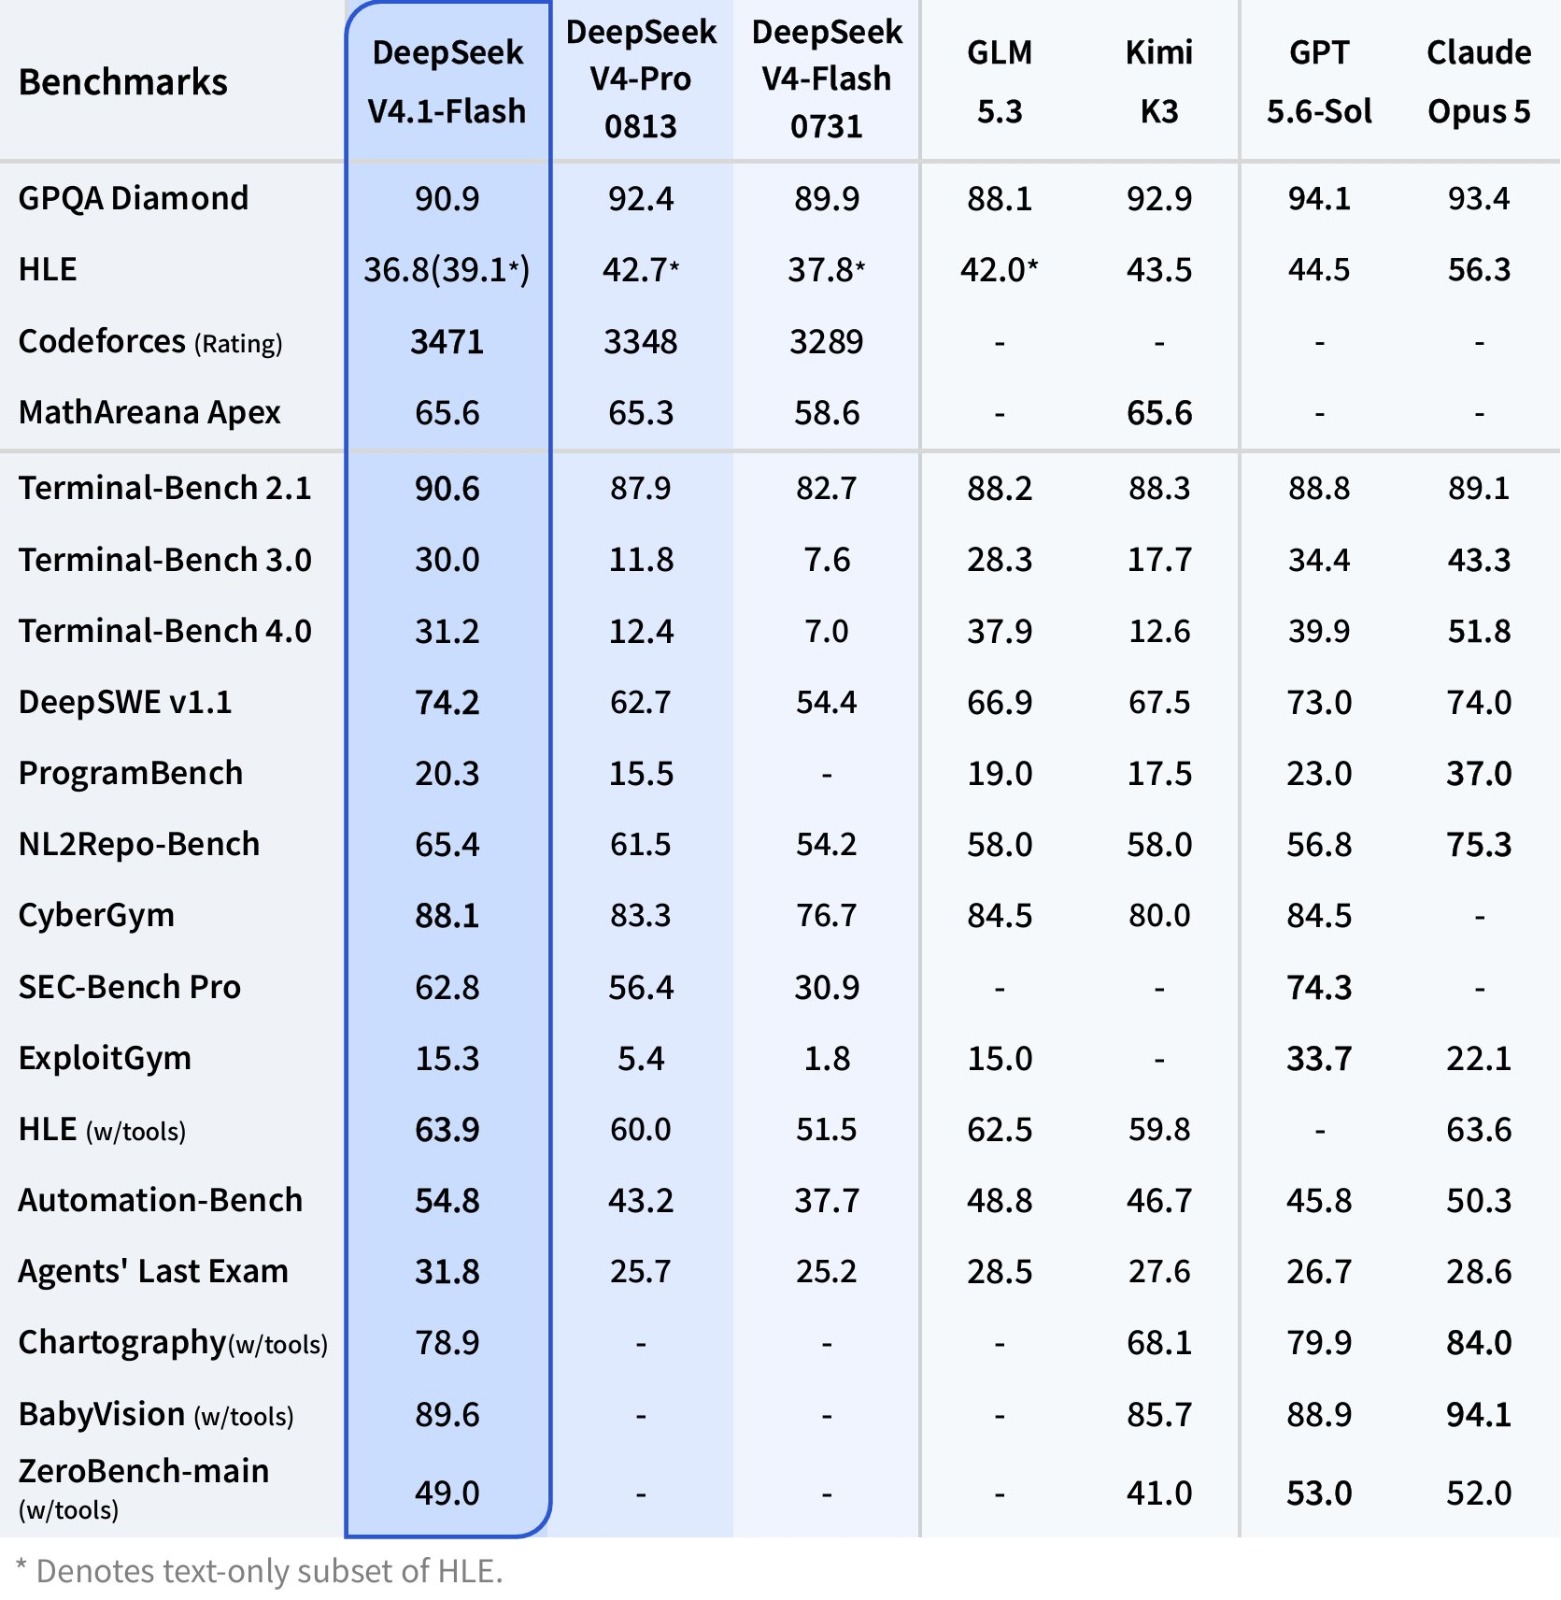
หัวใจของ DeepSeek V4.1-Flash คือการกล้าท้าชนโมเดลเรือธงอย่าง GPT-5.6 Sol และ Claude Opus 5 โดยเน้นจุดแข็งด้านงานเอเจนต์และการเขียนโค้ด มากกว่าการพยายามชนะทุกสนามแบบครอบจักรวาล โมเดลนี้ใช้สถาปัตยกรรมแบบ Causal Encoder–Decoder ที่ไม่สมมาตรและเป็นโมเดลแบบ Mixture-of-Experts จำนวน 552 พันล้านพารามิเตอร์ แต่เปิดใช้เฉพาะบางส่วนขณะประมวลผลเพื่อรักษาค่าใช้จ่ายให้ต่ำ ในหลายชุดทดสอบด้านไซเบอร์ซีเคียวริตี้ ซอฟต์แวร์เอนจิเนียริง และงานอัตโนมัติ ผลลัพธ์ของ V4.1-Flash ทำคะแนนแซงหรือสูสีกับ GPT-5.6 Sol และ Claude Opus 5 ทั้งที่โมเดลเหล่านั้นเป็นกลุ่มพรีเมียม
จุดที่น่าสนใจไม่แพ้กันคือความเป็น Multimodal AI ขนาดเล็กที่มาพร้อมความสามารถเห็นภาพ AI แบบเนทีฟ ทำให้การประมวลผลข้อความและภาพรวมกันเกิดขึ้นในโมเดลเดียว ไม่ต้องพึ่งโมเดลเสริมแยกต่างหากอีกต่อไป เดิมทีความสามารถด้านภาพถูกแยกไว้ในโมเดล V4-Flash-Vision-Exp แต่ตอนนี้ถูกผสานเข้าใน V4.1-Flash โดยตรง นั่นหมายความว่าแอปพลิเคชันตั้งแต่ระบบช่วยวิเคราะห์เอกสารภาพ สไลด์ ไปจนถึงหน้าจอเครื่องมือเทคนิค สามารถเรียกใช้โมเดลเดียวจบ ลดความซับซ้อนทั้งด้านสถาปัตยกรรมและต้นทุนการผสานระบบ เหมาะกับธุรกิจที่อยากทดลองใช้ Multimodal โดยไม่ต้องเริ่มจากระบบใหญ่และแพง
ประหยัดทรัพยากรอย่างเห็นได้ชัด ด้วยการหด KV cache และสถาปัตยกรรมใหม่
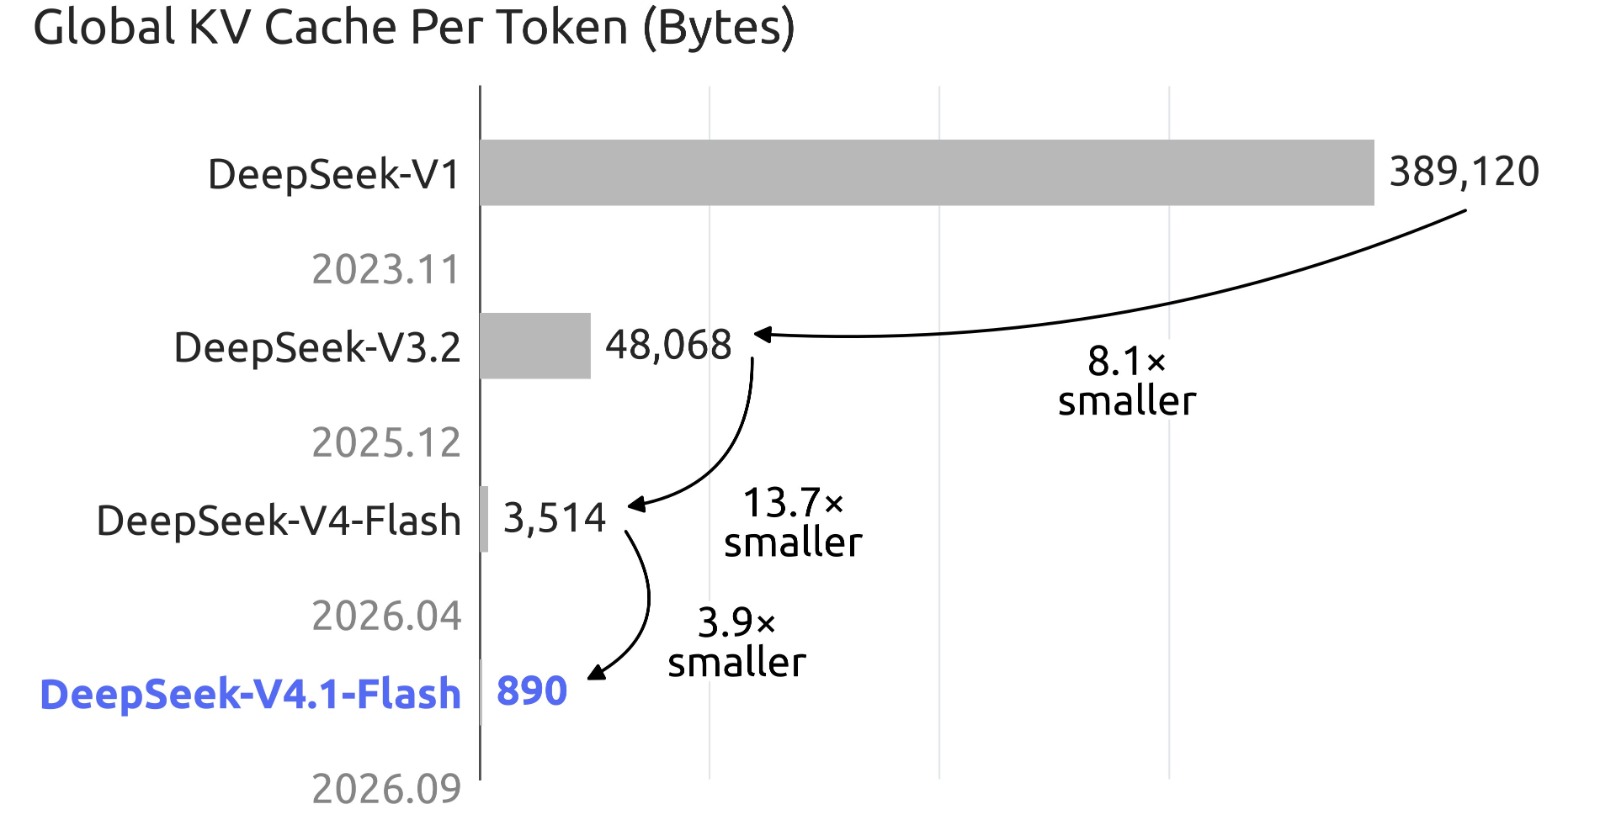
สิ่งที่ทำให้ DeepSeek V4.1-Flash น่าจับตาสำหรับนักพัฒนาและผู้ประกอบการ คือการลดภาระฮาร์ดแวร์อย่างจริงจัง โดยเฉพาะในส่วน KV cache หรือหน่วยความจำต่อโทเคนที่โมเดลต้องใช้ระหว่างการรันเอเจนต์หรือสนทนายาว DeepSeek แสดงข้อมูลว่าขนาด KV cache ลดลงเหลือเพียงเศษเสี้ยวของรุ่นก่อนหน้า ทำให้รุ่นนี้มีขนาดเล็กกว่ารุ่นแรกเริ่มของตระกูลมากกว่าสี่ร้อยเท่า และเล็กกว่ารุ่นก่อนหน้าเกือบสี่เท่าในมิติเดียวกัน ผลลัพธ์คือการใช้หน่วยความจำบน HBM และพื้นที่จัดเก็บบน SSD น้อยลงอย่างมีนัยสำคัญ ซึ่งช่วยลดค่าใช้จ่ายต่อการรันงานเอเจนต์ที่ต้องใช้บริบทซ้ำบ่อยครั้ง
ในเชิงธุรกิจ ผลจากการหด KV cache ทำให้ค่าใช้จ่ายส่วนที่เกิดจาก cache-hit ซึ่งมักกินสัดส่วนส่วนใหญ่ของการรันเอเจนต์ AI ที่ใช้บริบทซ้ำ ถูกกดลงไปพร้อมกัน DeepSeek ระบุว่า “ขนาด cache ที่เล็กลงส่งผลโดยตรงต่อค่าใช้จ่ายที่นักพัฒนาต้องจ่ายเพื่อรักษาบทสนทนายาวหรือเซสชันเอเจนต์ให้ทำงานต่อเนื่อง” นี่คือก้าวสำคัญของโมเดล AI ราคาประหยัด เพราะไม่ใช่เพียงโมเดลเล็กลง แต่เป็นการออกแบบเพื่อให้ค่าใช้จ่ายหน่วยประมวลลดลงในระดับที่สัมผัสได้ ช่วยเปิดโอกาสให้ทีมเล็กหรือสตาร์ทอัปทดลองแนวคิดที่ใช้เอเจนต์หลายตัวหรือเวิร์กโฟลว์ซับซ้อนได้โดยไม่ถูกขัดขวางด้วยงบประมาณ
โครงสร้างราคาและการเปิดโอเพ่นซอร์ส ลดกำแพงให้ผู้เล่นหน้าใหม่
DeepSeek เลือกใช้โครงสร้างราคาที่แตกต่างชัดเจนด้วยแนวคิดการคิดค่าบริการแบบช่วงเวลาพีคและนอกพีค โดยกำหนดให้ช่วงเวลาทำงานพีคอยู่ระหว่าง 01:00–04:00 และ 06:00–10:00 ตามเวลาสากลในวันทำงาน ส่วนช่วงเวลาอื่นรวมถึงวันหยุดถูกคิดในอัตราที่ถูกกว่า และยังคงนโยบายให้อัตรานอกพีคถูกกว่าช่วงพีคครึ่งหนึ่ง เพื่อจูงใจให้ผู้พัฒนาเลื่อนงานที่ยืดหยุ่น เช่น การประมวลผลงานเป็นชุดหรือเทรนนิงย่อย ไปอยู่ในช่วงเวลาที่โหลดระบบต่ำ แนวทางนี้สะท้อนมุมมองเชิงระบบว่าการจัดสมดุลภาระเซิร์ฟเวอร์ควรผูกกับสิทธิประโยชน์ด้านราคาอย่างเป็นรูปธรรมไม่ใช่แค่การรณรงค์เชิงข้อความ
ในด้านการเข้าถึง DeepSeek วาง V4.1-Flash ไว้บน API ภายใต้ชื่อ deepseek-flash พร้อมรองรับ Multimodal แบบเนทีฟ และได้ยุบโมเดล V4-Flash และ V4-Flash-Vision-Exp เดิมลง โดยยังคงรูตปลายทางเก่าให้ชี้มาที่รุ่นใหม่เพื่อรักษาความเข้ากันได้กับระบบที่ใช้งานอยู่ ควบคู่กัน DeepSeek ได้เผยแพร่โมเดลและรายงานเทคนิคบนแพลตฟอร์มโอเพ่นซอร์ส และประกาศทำงานร่วมกับชุมชนนักพัฒนาเพื่อสนับสนุนการรันอินเฟอเรนซ์ พร้อมเปิดรับพันธมิตรที่ต้องการดีพลอยระดับหลายพันจีพียู นี่คือจุดที่ โมเดล AI ราคาประหยัด ไม่ได้หมายถึงแค่ราคาต่อการใช้งานที่ต่ำลง แต่ยังหมายถึงกำแพงการเข้าถึงเทคโนโลยีขั้นสูงที่เตี้ยลงสำหรับทุกขนาดองค์กร
ผลสะเทือนต่ออนาคต AI ประสิทธิภาพสูง และทิศทางต่อไปของ DeepSeek
DeepSeek ไม่ได้หยุดแค่การเปิดตัวโมเดลใหม่ แต่ใช้ V4.1-Flash เป็นจุดเปลี่ยนเชิงกลยุทธ์ โดยประกาศยกเลิกระดับ V4-Pro ที่มีต้นทุนสูง และจะรูตคำขอทั้งหมดที่ใช้ deepseek-v4-pro ไปยัง V4.1-Flash โดยคิดค่าบริการในอัตราของ V4.1-Flash แทน DeepSeek ให้ข้อมูลว่าผู้ทดสอบอิสระหลายรายพบว่า V4.1-Flash เหนือกว่า V4-Pro ทั้งด้านประสิทธิภาพ ต้นทุน ความเร็ว และเวลารวมในการรัน การตัดสินใจเช่นนี้เป็นสัญญาณชัดว่าโมเดลประสิทธิภาพสูงยุคใหม่ไม่จำเป็นต้องจับคู่กับค่าใช้จ่ายระดับพรีเมียมเสมอไป และบีบให้ผู้ให้บริการ AI รายอื่นต้องตั้งคำถามกับโครงสร้างไลน์ผลิตภัณฑ์ของตนเอง
สถาปัตยกรรม V4.1 ถูกออกแบบให้เป็นฐานที่รองรับโมเดลพี่น้องที่ใหญ่ขึ้นในอนาคต โดยมุ่งเพิ่มความสามารถ ความเร็วในการอินเฟอเรนซ์ และอัตราการประมวลผลผ่านระบบเดียวกัน DeepSeek ระบุชัดว่าการรูตไปยัง V4.1-Flash จะดำเนินต่อไปจนกว่าโมเดล V4.1-Pro จะพร้อมเปิดตัว ทิศทางนี้บอกเราว่าเกมการแข่งขันกำลังขยับจากการสร้างโมเดลยักษ์ที่เก่งแต่แพง ไปสู่ยุคที่ใครทำให้ Multimodal AI ขนาดเล็ก ฉลาด ประหยัด และเข้าถึงได้มากที่สุด จะเป็นผู้กำหนดมาตรฐานใหม่ของอุตสาหกรรม สำหรับนักพัฒนาและธุรกิจ นี่คือโอกาสทดลองสถาปัตยกรรม AI ประสิทธิภาพสูงรุ่นล่าสุด โดยไม่จำเป็นต้องมีงบเทียบเท่าบริษัทยักษ์อีกต่อไป