
AI Agent ไม่ใช่ฟังก์ชันธรรมดา ทำไมการทดสอบต้องเปลี่ยนมุมคิด
การทดสอบ AI Agent คือกระบวนการออกแบบ ตรวจสอบ และปรับปรุงพฤติกรรมของตัวแทนอัจฉริยะที่ใช้การเรียนรู้ของเครื่องให้ทำงานตามสัญญาเครื่องมือ นโยบายความปลอดภัย และผลลัพธ์ที่คาดหวัง โดยไม่ยึดติดกับถ้อยคำคำตอบเป๊ะ และต้องคำนึงถึงผลกระทบในโลกจริงที่อาจเกิดขึ้นจากการตัดสินใจที่ไม่เป็นเชิงกำหนด
ปัญหาสำคัญของการทดสอบ AI Agent คือมันไม่ใช่ฟังก์ชันแบบเดิมที่ป้อนอินพุตชุดเดิมแล้วได้ผลเหมือนกันทุกครั้ง อุณหภูมิ การเรียกโมเดลจากระยะไกล เชนเครื่องมือ และสภาพแวดล้อมที่เปลี่ยนตลอด ทำให้การยืนยันด้วยการเปรียบเทียบสตริงคำตอบคำต่อคำพังได้ง่าย แม้สองคำตอบจะสื่อสารความหมายช่วยผู้ใช้จองเที่ยวบินเหมือนกัน การบังคับให้เอเจนต์พูดประโยคเดิมทุกครั้งยิ่งทำให้มันแข็งทื่อ และยังหลอกตัวเองว่าระบบปลอดภัย ทั้งที่ในโลกจริงสถานการณ์อาจเปลี่ยนไปแล้ว
ทางออกจึงไม่ใช่หยุดทดสอบ แต่ต้องย้ายจุดโฟกัสไปที่สัญญารอบส่วนที่เป็นความน่าจะเป็น เช่น สคีมา การเสนอและเรียกใช้เครื่องมือ การอนุญาต การเปลี่ยนสถานะ และผลย้อนหลัง แทนที่จะหวังให้ AI Agent กลายเป็นฟังก์ชันเชิงกำหนดทั้งระบบ เพราะแม้เอเจนต์จะไม่ใช่ฟังก์ชันบริสุทธิ์ ส่วนประกอบรอบมันหลายส่วนยังทำให้เชิงกำหนดได้และควรทำให้เชิงกำหนดเพื่อเพิ่มความเชื่อถือได้ของระบบ
ทดสอบสคีมา เครื่องมือ และขอบเขตการอนุญาต ก่อนสนใจคำตอบสวยงาม
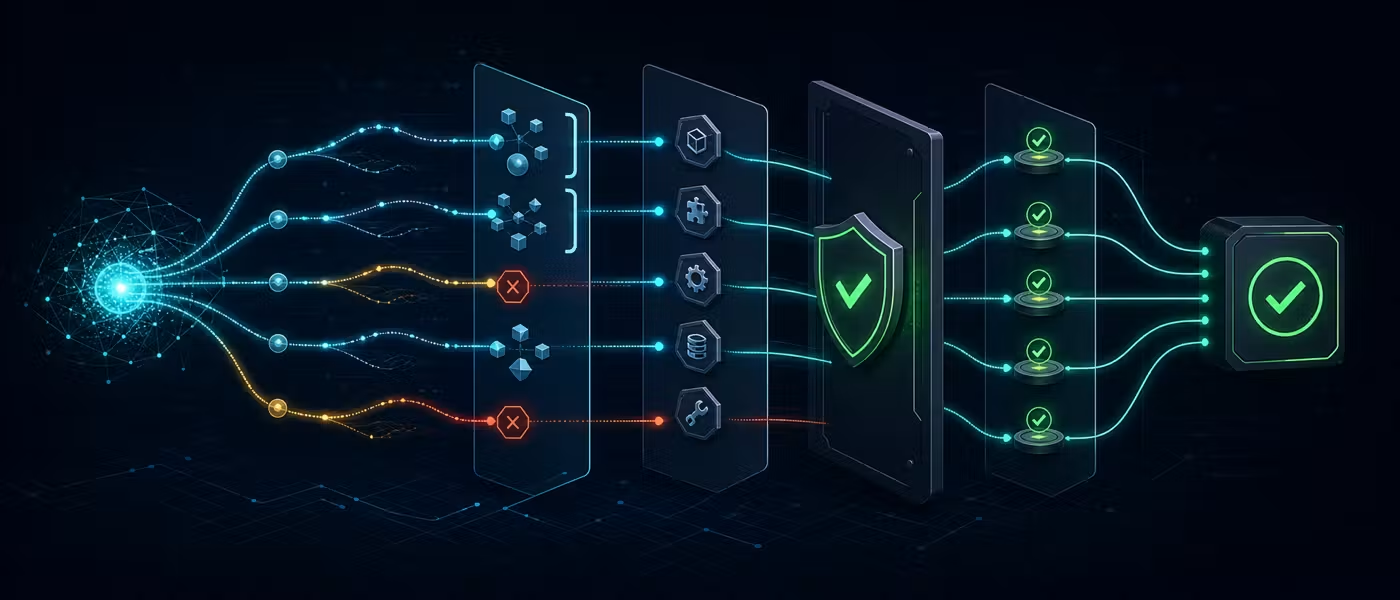
หัวใจของการทดสอบ AI Agent ที่ตรวจสอบความปลอดภัย AI ได้จริง ไม่ใช่การถามว่ามันตอบสวยไหม แต่ต้องถามว่ามันใช้เครื่องมือถูกตัวหรือไม่ อยู่ในขอบเขตนโยบายหรือเปล่า และรักษาสัญญาทางเทคนิคครบถ้วนหรือไม่ การทดสอบที่ดีต้องตรวจดูสคีมาที่โมเดลใช้ เสนอเครื่องมืออะไร เรียกใช้เครื่องมือใดจริง มีผลอนุญาตหรือปฏิเสธอย่างไร และมีรีเกรสชันจากเวอร์ชันก่อนหรือไม่
ตัวอย่างที่ควรทดสอบคือแยกชัดเจนระหว่างการเสนอเครื่องมือและการเรียกใช้จริง สัญญาผลลัพธ์ของเอเจนต์ควรเก็บทั้งรายการเครื่องมือที่เสนอ รายชื่อเครื่องมือที่ถูกเรียกใช้จริง และผลของเลเยอร์นโยบายสำหรับแต่ละคำขอ ฟิลด์เหล่านี้ช่วยให้เรายืนยันได้ว่าแค่มีการเสนอคำสั่งจองไม่ได้แปลว่ามีการจองเกิดขึ้น และเราสามารถเขียนเทสต์เพื่อยืนยันว่าการค้นหาที่ควรอ่านอย่างเดียวจะไม่ไปเรียกเครื่องมือที่มีผลทำลายข้อมูลหรือยกเลิกการจองโดยไม่จำเป็น
สำหรับข้อความที่เป็นภาษาธรรมชาติ ส่วนใหญ่ไม่ควรถูกล็อกด้วยประโยคเดียวแบบเทสต์สตริง แต่ควรประเมินจากความหมายและคุณภาพประสบการณ์ผู้ใช้ เช่น ใช้รูบริกหรือเกรดเดอร์แบบมีขอบเขตที่วัดว่าคำตอบมีประโยชน์ ถูกต้องตามบริบท และไม่ละเมิดนโยบายหรือข้อความบังคับ ในขณะที่ข้อความบางประเภท เช่น ข้อความยินยอม ข้อความตามกฎระเบียบ หรือข้อความในส่วนตายตัวของ UI อาจต้องใช้การตรวจแบบตรงตัวเพราะมีข้อบังคับทางกฎหมายหรือการออกแบบ
ตรวจสอบความปลอดภัย AI ด้วยการอนุญาตแบบเด็ดขาดและการยืนยันตัวตนอย่างเป็นทางการ
หากต้องการตรวจสอบความปลอดภัย AI อย่างจริงจัง เราต้องยอมรับว่าความเชื่อมั่นที่โมเดลรายงานไม่ควรมีสิทธิ์ข้ามขั้นตอนอนุมัติได้เอง การกระทำที่ทำลายข้อมูล ใช้ค่าใช้จ่ายสูง ไม่สามารถย้อนกลับ หรือเสี่ยงข้อมูลส่วนตัวต้องมีระบบอนุญาตแบบเชิงกำหนดนอกโมเดลคอยตัดสินใจ สรุปสั้นๆ คือความมั่นใจของโมเดลห้ามแทนที่บรรทัดฐานด้านความปลอดภัยของระบบได้
แต่คำถามคือเราจะรู้ได้อย่างไรว่านโยบายอนุญาตที่เขียนไว้ทำงานถูกต้องในทุกกรณี เช่น นโยบายที่ระบุว่าเอเจนต์อ่านข้อมูลลูกค้าได้แต่ห้ามลบ แล้วจะยืนยันได้อย่างไรว่านั่นเป็นจริงในสถานการณ์ที่ไม่รู้จบ การทดสอบให้คำตอบได้แค่กรณีที่เรานึกออกและเขียนเทสต์ แต่เว้นช่องว่างกรณีที่ไม่มีใครคาดถึง นี่คือช่องที่การยืนยันตัวตนอย่างเป็นทางการเข้ามาปิด เพราะมันสร้างหลักฐานทางคณิตศาสตร์ว่านโยบายทำงานถูกต้องตลอดโดเมนอินพุตที่เป็นไปได้
สิ่งที่น่าสนใจคือการยืนยันตัวตนอย่างเป็นทางการไม่ได้อยู่แค่ในงานวิจัยอีกต่อไป แต่เริ่มถูกใช้ในเครื่องมือจริง เช่น เฟรมเวิร์กยืนยันนโยบายบนภาษาแสดงออกทั่วไปที่ใช้ในเอนจินนโยบายจำนวนมาก ซึ่งรวมการทดสอบแบบฮิวริสติกกับการพิสูจน์ทางคณิตศาสตร์ว่านโยบายทำงานภายใต้โดเมนอินพุตทั้งหมด การมีเครื่องมือระดับนี้หมายความว่าเราสามารถพิสูจน์ได้ว่า AI Agent จะคงอยู่ในสิทธิ์ที่กำหนด เช่น อ่านได้แต่ลบไม่ได้ โดยไม่ต้องลองทุกอินพุตด้วยมือ
Decision logging ทำให้การดีบักเอเจนต์เข้าใจได้โดยไม่ละเมิดความเป็นส่วนตัว
เมื่อเริ่มทดสอบ AI Agent อย่างจริงจัง คำถามแรกที่มักโผล่ขึ้นมาคือ ทำไมเอเจนต์ถึงทำแบบนั้น ทำไมมันส่งการแจ้งเตือน ทำไมมันกดปิด ทำไมมันเรียกใช้เครื่องมือเดิมซ้ำ ทำไมมันใช้ข้อมูลหมดอายุ หรือทำไมการคาดการณ์ที่ระดับความมั่นใจสูงถึงผิดพลาด การมีแค่ล็อกเหตุการณ์แบบแอปทั่วไป เช่น ฟังก์ชันรันสำเร็จ API ส่งกลับ หรือเกิดข้อผิดพลาด ไม่เพียงพอ เพราะเราไม่เห็นเส้นแบ่งการตัดสินใจว่าระบบเลือกเส้นทางไหนจากอีกทางหนึ่ง
แนวคิด decision logging จึงเข้ามาช่วยโดยเน้นบันทึกการตัดสินใจที่สำคัญ ไม่ใช่เก็บทุกพรอมต์หรือเหตุผลภายในโมเดล แต่มุ่งที่ข้อเท็จจริงที่แอปยืนยันได้ เช่น กฎนโยบายข้อใดถูกทริกเกอร์ เครื่องมือใดถูกเสนอ เหตุผลที่รันไทม์ลองใหม่หรือปฏิเสธ แหล่งที่มาของคะแนนความเชื่อมั่น และผลลัพธ์ที่สังเกตได้ภายหลัง การบันทึกแบบโครงสร้างนี้ทำให้เราเปลี่ยนความรู้สึกว่าโมเดลเลือกผิดกลายเป็นข้อผิดพลาดของระบบที่ทดสอบได้ เช่น ค้นพบว่าการลองใหม่ครั้งที่สองใช้ข้อมูลแคชเก่าเกินช่วงความสด ทำให้เปรียบเทียบราคาผิด
สิ่งสำคัญคือ decision logging ที่ดีต้องไม่ละเมิดความเป็นส่วนตัว การบันทึกควรอธิบายพฤติกรรมด้วยข้อมูลที่ตรวจสอบได้ โดยไม่จำเป็นต้องเก็บคำค้นโรงแรม โปรไฟล์ผู้ใช้ หรือเนื้อหาการแจ้งเตือนที่สร้างขึ้น การเก็บเฉพาะเมทาดาทาและรหัสเหตุผลเพียงพอสำหรับการดีบักและสังเกตการณ์พฤติกรรมของเอเจนต์ แต่ลดความเสี่ยงจากการเก็บตัวระบุผู้ใช้หรือข้อมูลอ่อนไหวที่ไม่จำเป็น การจัดสมดุลแบบนี้ทำให้ทั้งฝ่ายวิศวกรรมและฝ่ายกำกับดูแลสบายใจมากขึ้นว่าระบบสังเกตการณ์ไม่กลายเป็นความเสี่ยงด้านข้อมูลส่วนตัว