
เริ่มจากงานที่ต้องการ ไม่ใช่ตัวเลขพารามิเตอร์
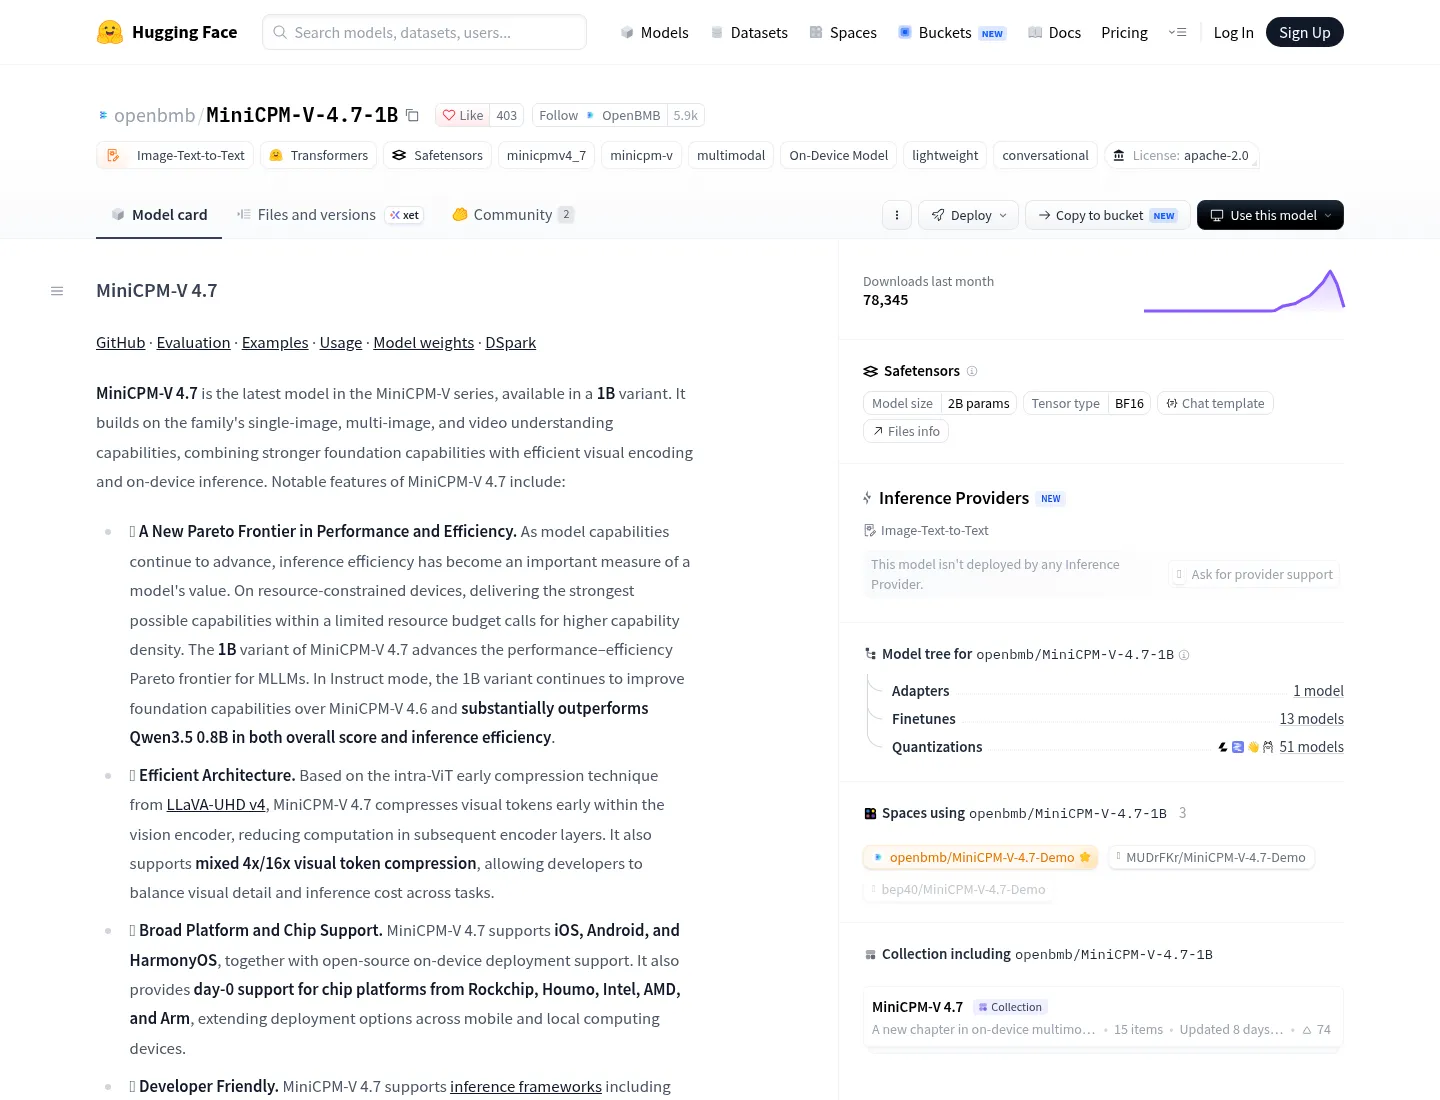
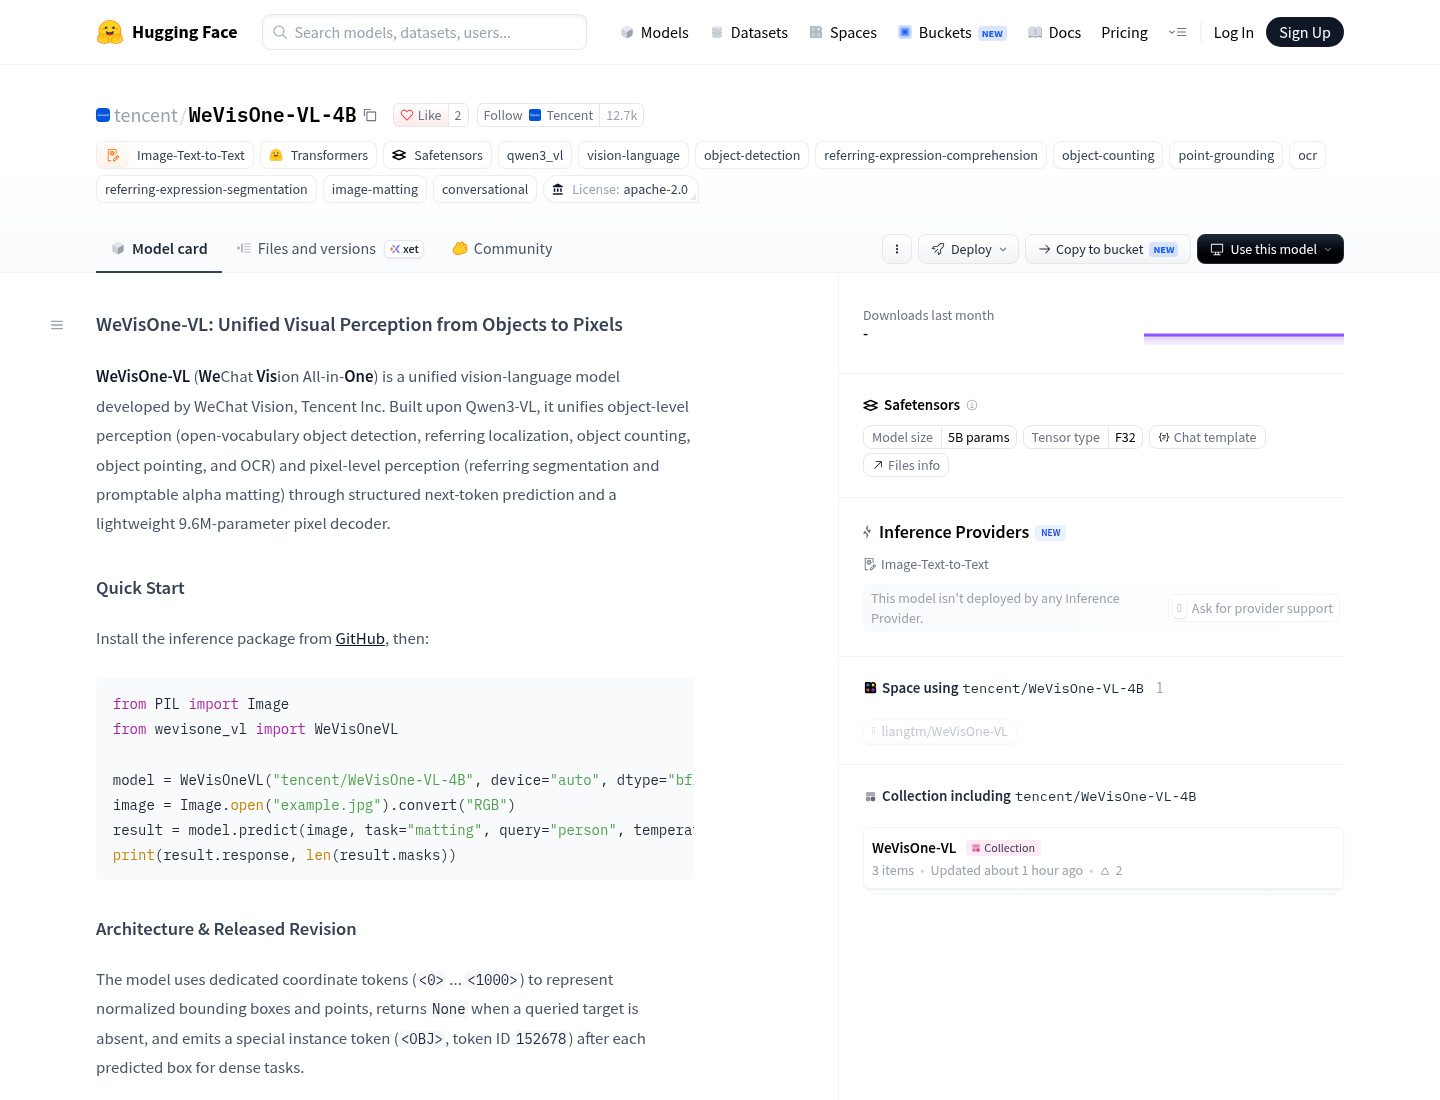
โมเดล AI ภาพคือระบบที่รับรูปภาพร่วมกับข้อความ แล้วใช้ความสามารถด้านการมองเห็นเพื่ออ่านข้อความ ตอบคำถาม หรือระบุสิ่งที่ปรากฏในภาพ โดยความแม่นยำและรูปแบบผลลัพธ์ขึ้นกับงานที่ออกแบบมาให้ทำ MiniCPM-V 4.7 1B เหมาะกับผู้ที่ต้องอ่านเอกสารหรือวิเคราะห์ภาพหลายชิ้นภายใต้งบหน่วยความจำจำกัด ส่วน WeVisOne-VL-4B เหมาะกับงานที่ต้องชี้ตำแหน่งวัตถุหรือสร้างแมตต์ละเอียด และ LFM3-Omni-2B น่าสนใจกว่าเมื่อภาพต้องทำงานร่วมกับเสียงและเสียงพูด
อย่าใช้คะแนน OCRBench 86.1 ของ MiniCPM-V 4.7 1B เทียบตรงกับ TotalText 52.0 ของ WeVisOne-VL-4B แล้วสรุปว่าโมเดลแรกอ่านเก่งกว่ากัน 34.1 คะแนน เพราะเป็นคนละการทดสอบ OCRBench วัดการถอดอักขระจากภาพ ส่วน TotalText วัดค่า F1 ในการระบุตำแหน่งข้อความ โดยพิจารณาเกณฑ์ IoU ตั้งแต่ 0.5 ถึง 0.95 ตัวหนึ่งเน้นการรู้จำ อีกตัวเน้นความแม่นยำทางตำแหน่ง จึงใช้ตัดสินผู้ชนะร่วมกันไม่ได้
ความต่างของแนวทางเป็นหัวใจในการเลือก MiniCPM บีบอัดโทเคนภาพตั้งแต่ต้นเพื่อให้ใส่ภาพหรือวิดีโอได้มากขึ้นในบริบทที่จำกัด ขณะที่ WeVisOne รักษารายละเอียดภาพไว้เพื่อให้ทำงานระดับพิกเซลได้ดีกว่า คะแนนจากคนละเบนช์มาร์กจึงไม่ควรถูกนำมาจัดอันดับเสมือนเป็นการแข่งขันสนามเดียวกัน
ข้อมูลหลักและคะแนนที่เทียบกันได้
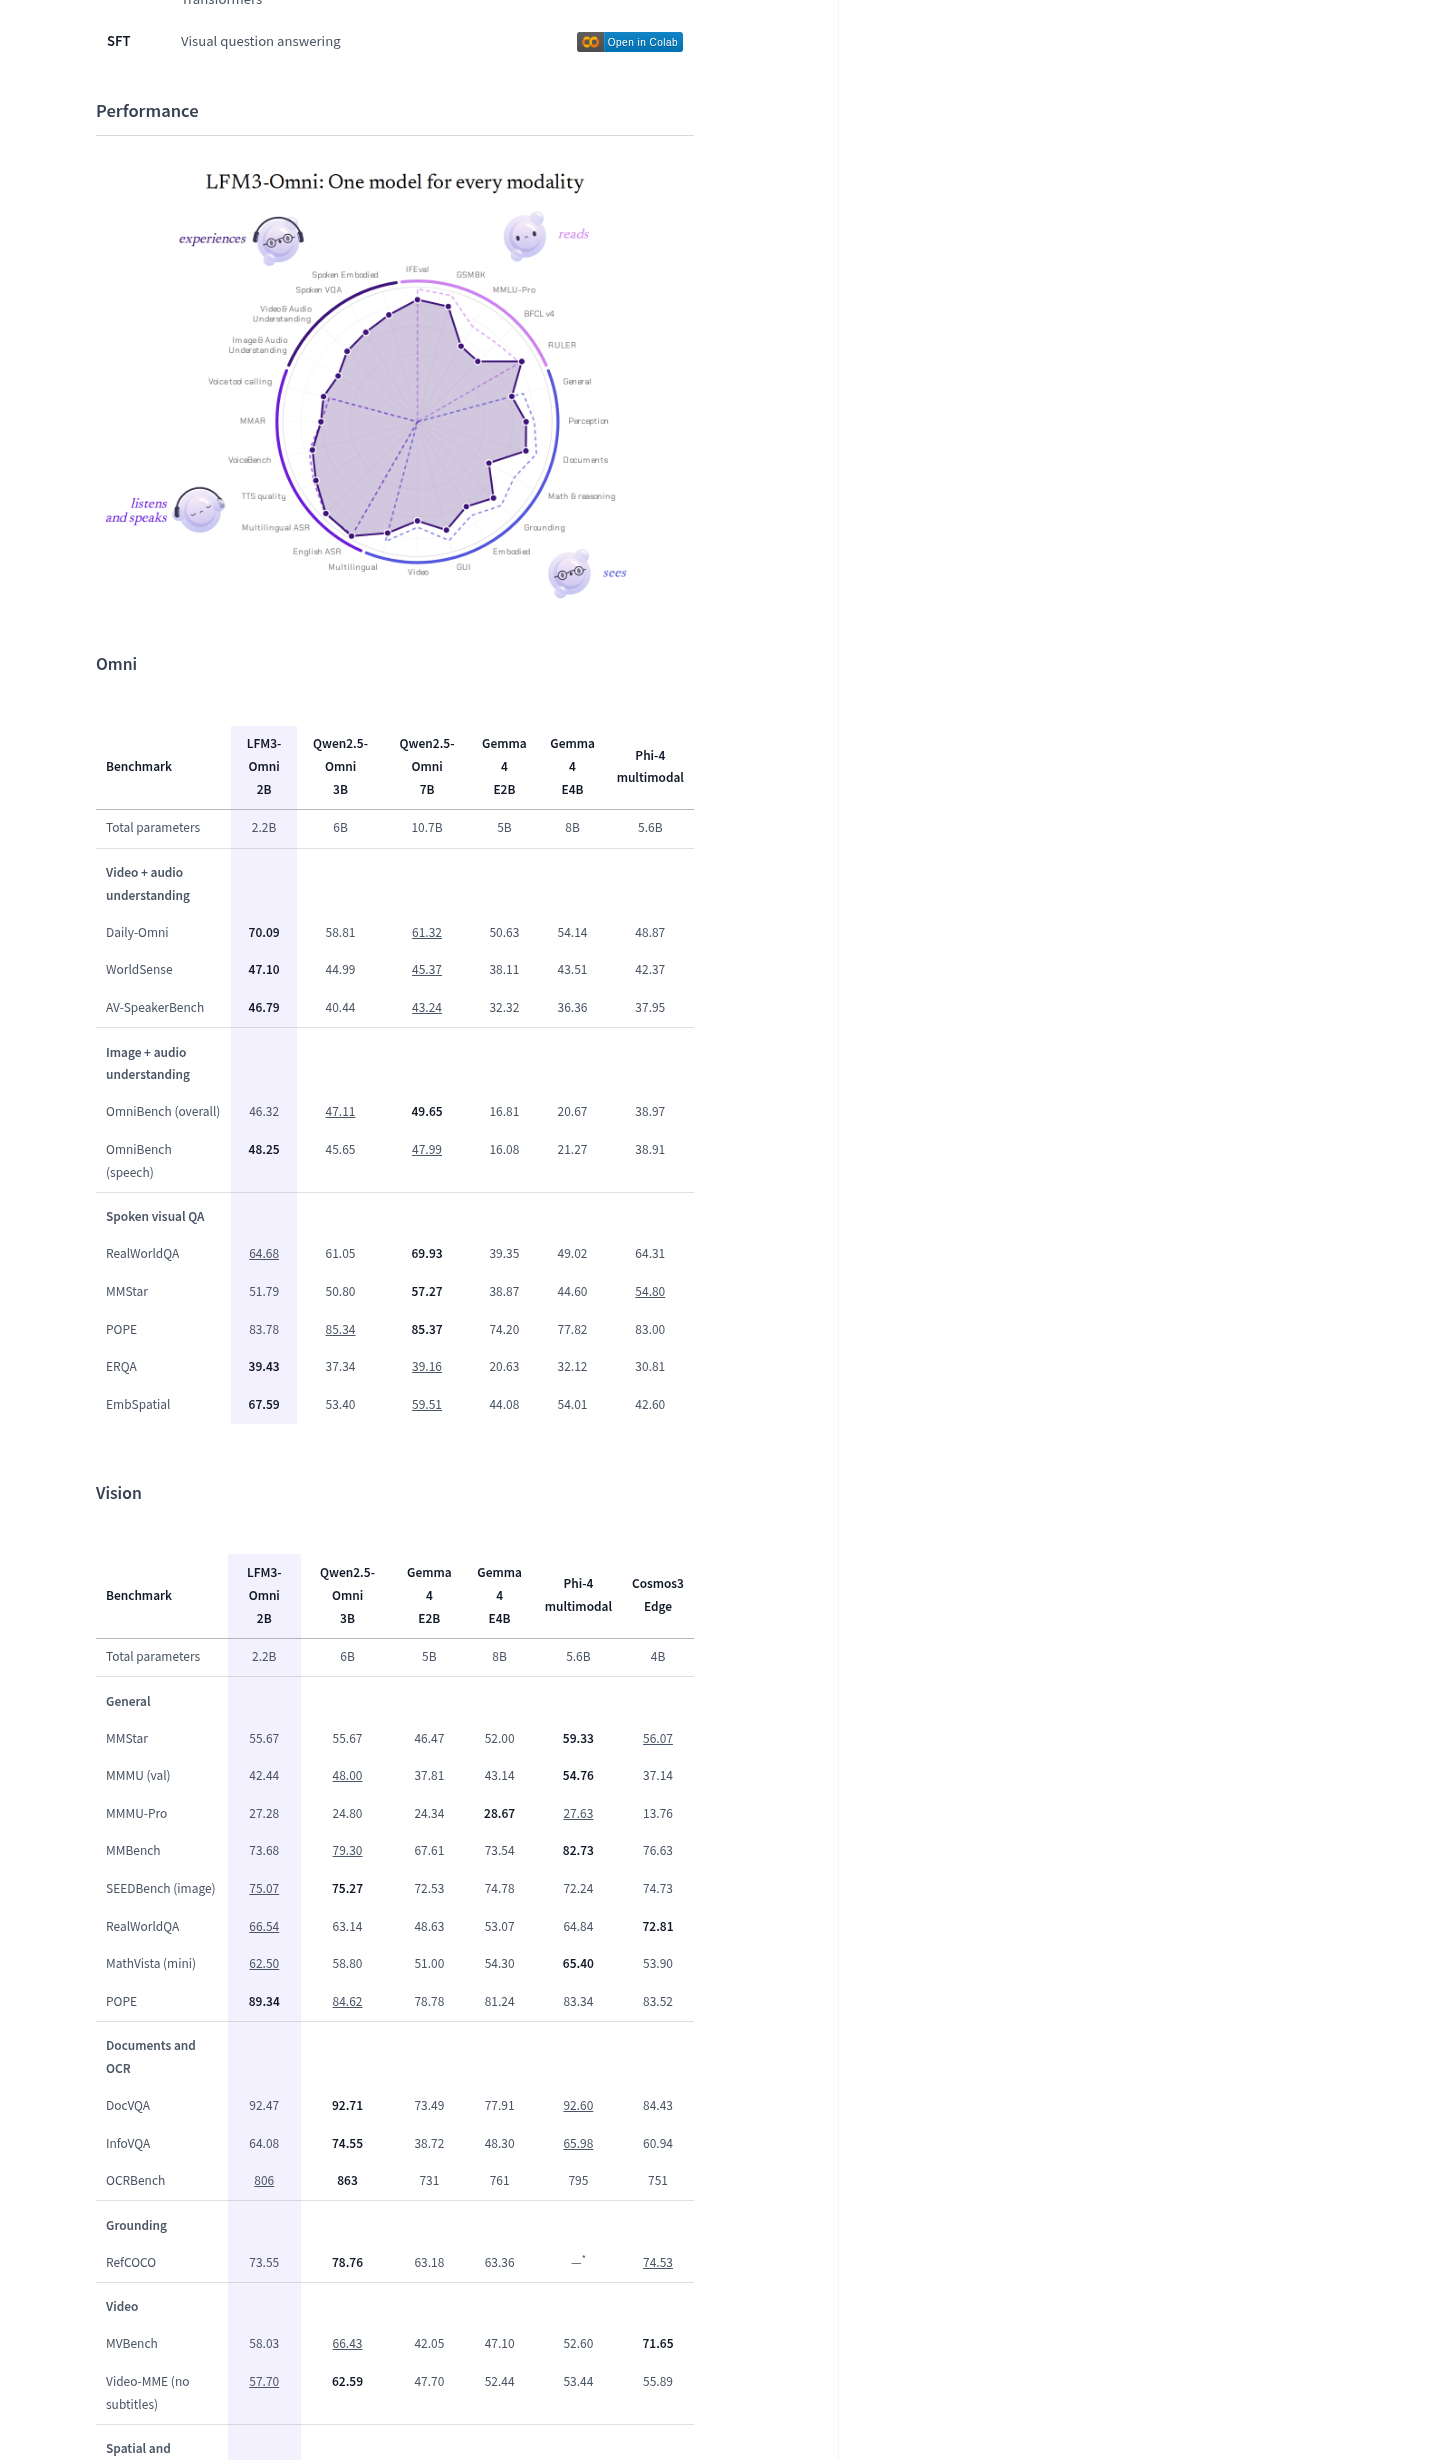
เมื่อต้องเลือกระหว่างทั้งสามรุ่น ให้ดูทั้งขนาดที่ต้องรองรับ วิธีรับข้อมูล และชนิดผลลัพธ์ที่ต้องการ ตารางนี้รวบรวมข้อแตกต่างที่ช่วยตัดสินใจได้ ส่วนคะแนนภาพของ MiniCPM-V กับ LFM3 เปรียบเทียบได้ตรงกว่า เพราะทั้งคู่มีผลในชุดทดสอบเดียวกัน อย่างไรก็ตาม คะแนนยังเป็นข้อมูลที่ผู้พัฒนาแต่ละรายรายงาน ไม่ใช่ผลทดสอบซ้ำจากผู้ประเมินอิสระ
| คุณสมบัติ | MiniCPM-V 4.7 1B | WeVisOne-VL-4B | LFM3-Omni-2B |
|---|---|---|---|
| พารามิเตอร์ | ประมาณ 1.3–1.55B แบบหนาแน่น; เมทาดาทาบางแห่งระบุ 2B | 4.83B แบบหนาแน่น | 2.17B แบบหนาแน่น |
| น้ำหนักหรือหน่วยความจำ | ประมาณ 3.1 GB แบบ BF16; รุ่น Q4_K_M ประมาณ 0.67 GB ก่อนรวมตัวฉายภาพ | ไฟล์ F32 ประมาณ 19 GB | ประมาณ 4.3 GB แบบ BF16 |
| บริบท | 262,144 โทเคน | ไม่มีการเผยแพร่ตัวเลข | 32,768 โทเคน |
| อินพุตและเอาต์พุต | ข้อความ ภาพหลายภาพ และวิดีโอ; เอาต์พุตข้อความ | ภาพเดียวต่อรอบ; ไม่รองรับวิดีโอแบบกริด | ข้อความ ภาพ วิดีโอพร้อมเสียง และเสียง 16 kHz; เอาต์พุตข้อความและเสียงพูด 24 kHz |
| การจัดการภาพ | บีบอัดโทเคนภาพ 4× หรือ 16×; LFM3 จำกัด 2,048 โทเคนต่อภาพ | สูงสุด 1,960 โทเคนภาพต่อภาพ พร้อมตัวถอดรหัสพิกเซล | จำกัด 2,048 โทเคนต่อภาพ |
| OCRBench | 86.1 | ไม่มีคะแนนที่เทียบตรงได้จากข้อมูลนี้ | 80.6 |
| MMStar | 69.5 | ไม่มีคะแนนที่เทียบตรงได้จากข้อมูลนี้ | 55.67 |
| MMMU | 56.9 | ไม่มีคะแนนที่เทียบตรงได้จากข้อมูลนี้ | 42.44 |
| MathVista mini | 74.3 | ไม่มีคะแนนที่เทียบตรงได้จากข้อมูลนี้ | 62.50 |
| สัญญาอนุญาต | Apache 2.0 | Apache 2.0 | LFM Open License v1.0 |
ผลในชุดทดสอบร่วมชี้ว่า MiniCPM-V 4.7 1B นำ LFM3-Omni-2B ทั้ง OCRBench, MMStar, MMMU และ MathVista mini โดยมีคะแนนตามลำดับ 86.1 เทียบกับ 80.6, 69.5 เทียบกับ 55.67, 56.9 เทียบกับ 42.44 และ 74.3 เทียบกับ 62.50 ตัวเลขเหล่านี้สนับสนุนการเลือก MiniCPM สำหรับงานภาพโดยเฉพาะ แต่ไม่ได้แปลว่าแทน LFM3 ได้ทุกด้าน เพราะ LFM3 ยังรับเสียงและสร้างเสียงพูดได้
โทเคนภาพกับงานแมตต์ เป็นคนละเป้าหมาย
MiniCPM-V 4.7 1B เปิดให้สลับการบีบอัดโทเคนภาพระหว่าง 4× และ 16× การบีบอัด 16× ช่วยประหยัดงบโทเคน เหมาะกับคำบรรยายภาพและการติดตามวิดีโอจำนวนมาก ส่วน 4× เก็บข้อมูลภาพไว้มากกว่าและเป็นการตั้งค่าที่ใช้กับคะแนน OCRBench 86.1 จึงเหมาะกว่าเมื่ออ่านเอกสารหรือแผนภูมิที่มีรายละเอียดแน่น การบีบอัดที่หนักขึ้นช่วยให้ประมวลผลข้อมูลได้มาก แต่ต้องยอมแลกกับรายละเอียดบางส่วน
WeVisOne-VL-4B เลือกเก็บคุณลักษณะภาพความละเอียดสูงก่อนการรวม แล้วใช้ตัวถอดรหัสพิกเซลเพื่อสร้างแอลฟาแมตต์ที่ความละเอียดเต็มและสไตรด์ 1 แนวทางนี้เหมาะกับการแยกวัตถุหรือขอบเขตให้ละเอียด ไม่ใช่การยัดภาพจำนวนมากลงในบริบท และการใช้รายละเอียดระดับพิกเซลก็แลกกับโทเคนและความหน่วงที่มากขึ้น โมเดลนี้ไม่รองรับวิดีโอแบบกริด เพราะตัวถอดรหัสพิกเซลไม่รองรับรูปแบบดังกล่าว
บริบท 262,144 โทเคนของ MiniCPM เป็นข้อได้เปรียบเมื่อต้องอ่านเอกสารยาวหรือคุยต่อเนื่องกับภาพหลายชุด โดยมากกว่า LFM3-Omni-2B ซึ่งมี 32,768 โทเคนถึงแปดเท่า แต่บริบทที่ยาวไม่ใช่หลักฐานว่าเข้าใจทุกหน้าได้สมบูรณ์ ผู้ใช้ยังต้องเลือกการบีบอัดให้เหมาะกับรายละเอียด และตรวจผลจริงกับเอกสารของตน
เลือกตามงานอ่าน วิเคราะห์ภาพ หรือใช้เสียง
ถ้างานหลักคือ OCR ใบแจ้งหนี้ แบบฟอร์ม แผนภูมิ ภาพหน้าจอ หรือ PDF ยาว MiniCPM-V 4.7 1B เป็นตัวเลือกที่มีหลักฐานรองรับมากที่สุดในกลุ่มนี้ ทั้งคะแนน OCRBench และผลในชุดภาพร่วมกับ LFM3 สนับสนุนการเลือกโมเดลเฉพาะทางนี้ อีกทั้งมีรุ่นควอนไทซ์และการรองรับรันไทม์บน iOS, Android, HarmonyOS, llama.cpp และ Ollama จึงเหมาะกับผู้ที่ต้องนำโมเดลไปใช้บนอุปกรณ์
ถ้าต้องการระบุตำแหน่งวัตถุอย่างหนาแน่น สร้างมาสก์หรือแมตต์ หรือแยกขอบเขตภาพระดับละเอียด ให้พิจารณา WeVisOne-VL-4B และเตรียมระบบที่มี GPU รองรับ เพราะความสามารถด้านพิกเซลตรงกับงานเหล่านี้มากกว่าคะแนนอ่านตัวอักษร ส่วน LFM3-Omni-2B เหมาะเมื่อแอปต้องฟังเสียงและตอบเป็นเสียงพูด แม้คะแนนภาพที่มีร่วมกันจะตาม MiniCPM
ข้อควรระวังคือคะแนน MiniCPM 86.1 วัดที่การบีบอัด 4× ขณะที่คะแนนที่ 16× ไม่ได้เผยแพร่ไว้ และตัวเลขเบนช์มาร์กเป็นคำกล่าวอ้างจากผู้พัฒนา จึงควรทดสอบกับภาพจริงก่อนเลือกใช้งาน สรุปคือเลือก MiniCPM เพื่ออ่านและจัดการบริบทยาว เลือก WeVisOne เพื่อผลลัพธ์ระดับตำแหน่งและพิกเซล และเลือก LFM3 เมื่อเสียงเป็นส่วนสำคัญของงาน
Buy if / Skip if
- Buy the MiniCPM-V 4.7 1B if ต้องอ่านข้อความจากเอกสาร ภาพหน้าจอ แผนภูมิ หรือ PDF หลายหน้า และต้องการบริบทขนาดใหญ่
- Skip the MiniCPM-V 4.7 1B if งานหลักต้องสร้างเสียงพูดหรือรับเสียงเป็นส่วนหนึ่งของเวิร์กโฟลว์
- Buy the WeVisOne-VL-4B if ต้องสร้างมาสก์หรือแมตต์ และระบุตำแหน่งรายละเอียดในภาพอย่างแม่นยำ
- Skip the WeVisOne-VL-4B if ต้องรันบนโทรศัพท์หรือประมวลผลวิดีโอแบบกริด
- Buy the LFM3-Omni-2B if ต้องรวมภาพ วิดีโอ เสียง และเอาต์พุตเสียงพูดไว้ในโมเดลเดียว