
Gemini 3.5 Transcribe คืออะไร และทำไมจึงสำคัญกว่าโมเดลถอดเสียงรุ่นก่อน
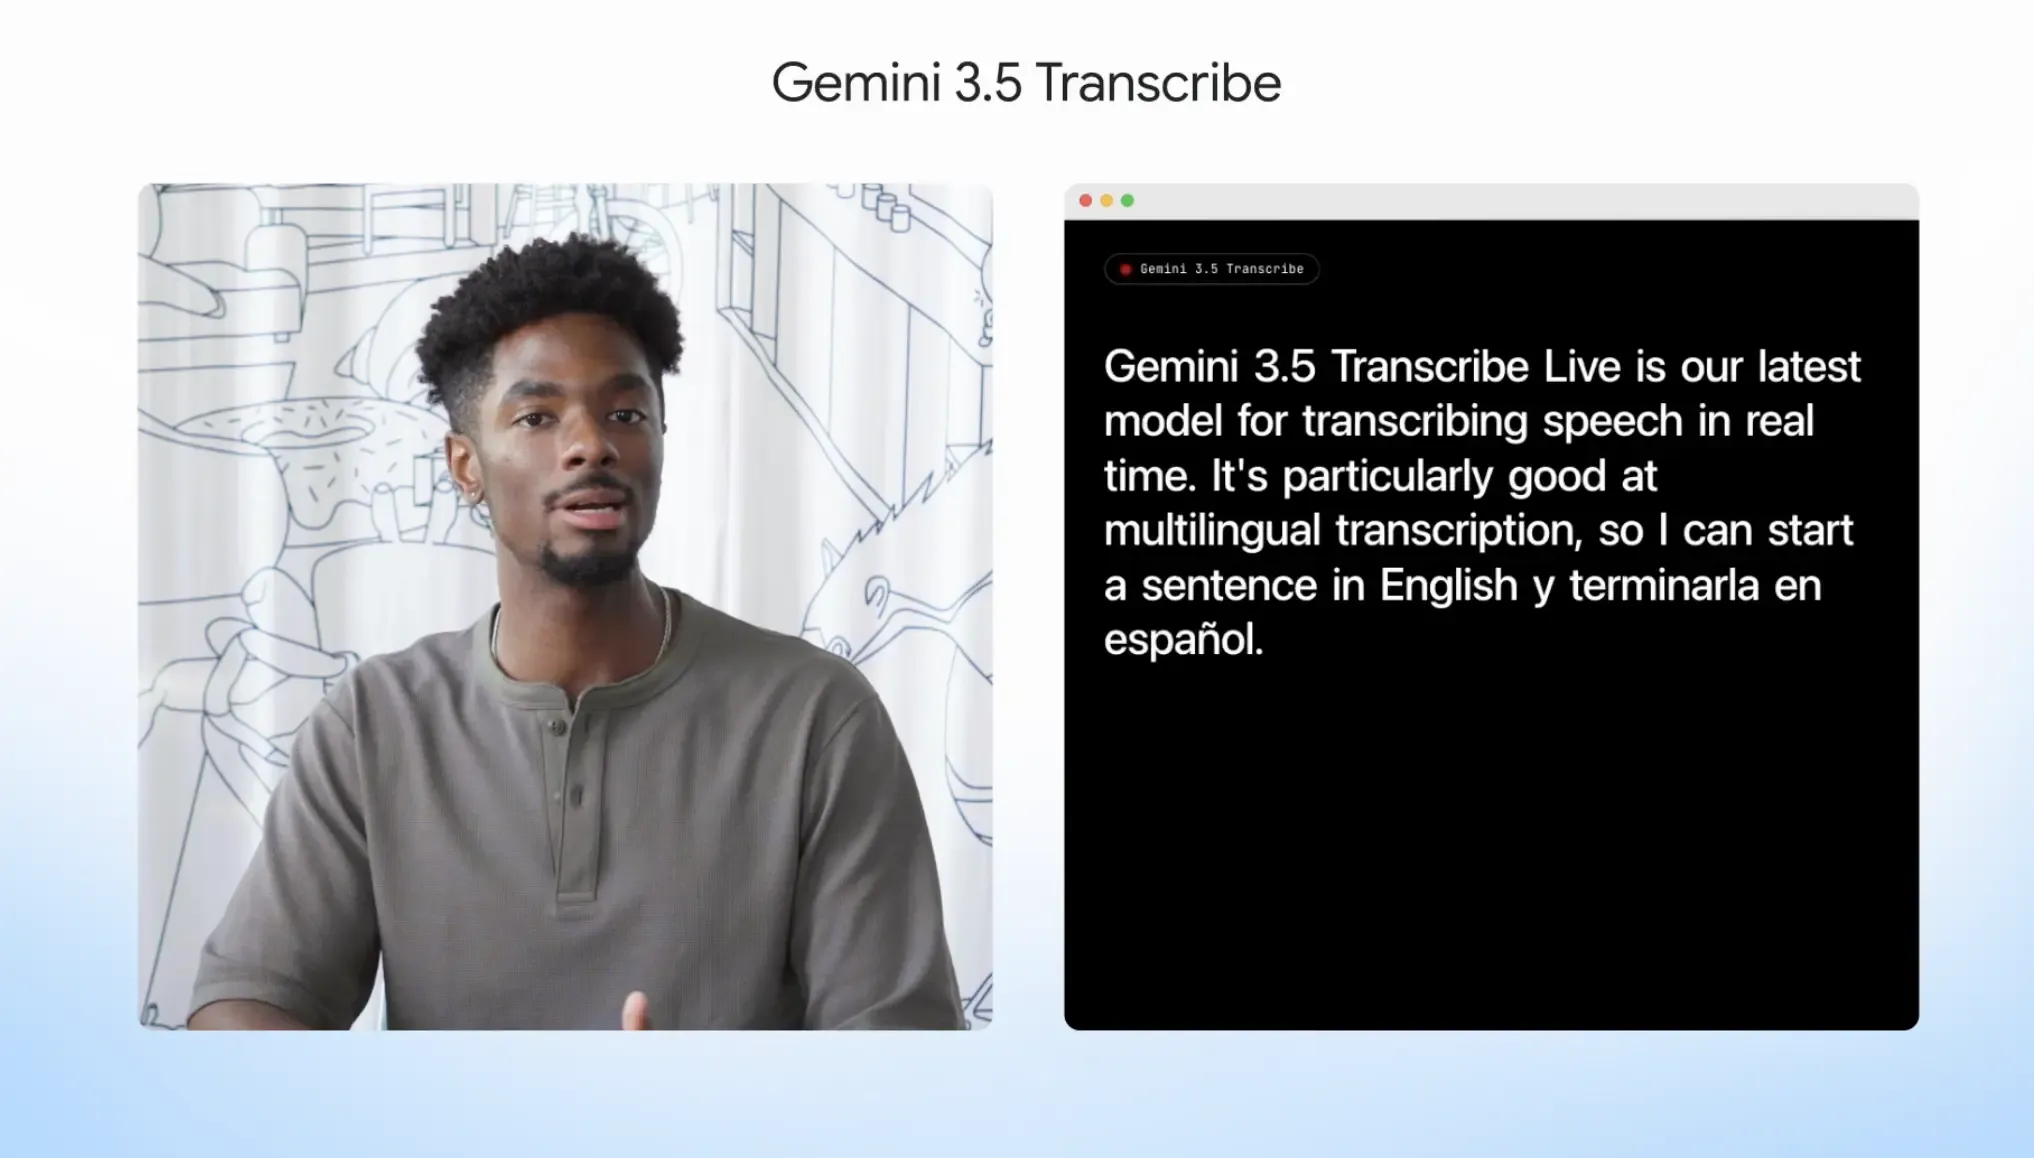
Gemini 3.5 Transcribe คือโมเดลถอดเสียงเป็นข้อความแบบ speech to text ที่ออกแบบให้ AI รู้จำเสียงได้ใกล้เคียงการฟังของมนุษย์ สามารถประมวลผลภาษา 85 ภาษาแบบเรียลไทม์ จัดการเสียงรบกวน สำเนียงแตกต่าง และรูปแบบการพูดที่ไม่เป็นทางการ แล้วเปลี่ยนเป็นข้อความที่อ่านง่าย ตรงความตั้งใจของผู้พูด รองรับทั้งการใช้งานผ่านแอปสำหรับผู้ใช้ทั่วไปและผ่านแพลตฟอร์มนักพัฒนาเพื่อสร้างระบบโต้ตอบด้วยเสียงหลากหลายรูปแบบ การเปิดตัวโมเดลนี้คือสัญญาณชัดเจนว่าเสียงจะกลายเป็นอินเทอร์เฟซหลักถัดไป Google ระบุว่า Gemini 3.5 Transcribe เป็นโมเดลแปลงเสียงเป็นข้อความที่แม่นยำที่สุดของบริษัทในตอนนี้ และถูกออกแบบมาเพื่อการโต้ตอบด้วยเสียงอย่างชาญฉลาด ไม่ใช่แค่ฟังก์ชันช่วยพิมพ์ธรรมดาอีกต่อไป การที่ AI สามารถทำความสะอาดประโยค ตัดคำฟุ่มเฟือย และเข้าใจการแก้คำกลางประโยค ทำให้เสียงกลายเป็นช่องทางสื่อสารที่ใช้ทำงานได้จริง ไม่ใช่เพียงส่งข้อความสั้นๆ หรือคำสั่งง่ายๆ เท่านั้น เมื่อมองเชิงยุทธศาสตร์ Gemini 3.5 Transcribe คือชิ้นส่วนสำคัญในระบบเทคโนโลยีเสียง AI ของ Google ที่เชื่อมระหว่างผู้ใช้ แอปพลิเคชัน และโมเดล AI รุ่นใหญ่ หากเสียงคือวิธีคุยกับ AI ในอนาคต โมเดลถอดเสียงย่อมต้องแม่นยำ มีความหน่วงต่ำ และเข้าใจบริบท ซึ่ง Gemini 3.5 กำลังพยายามตอบโจทย์เหล่านี้อย่างจริงจัง

เทคโนโลยีเสียง AI ที่ฟังคนพูดเหมือนคนจริง แม่นยำทั้งเสียงรบกวนและสำเนียง
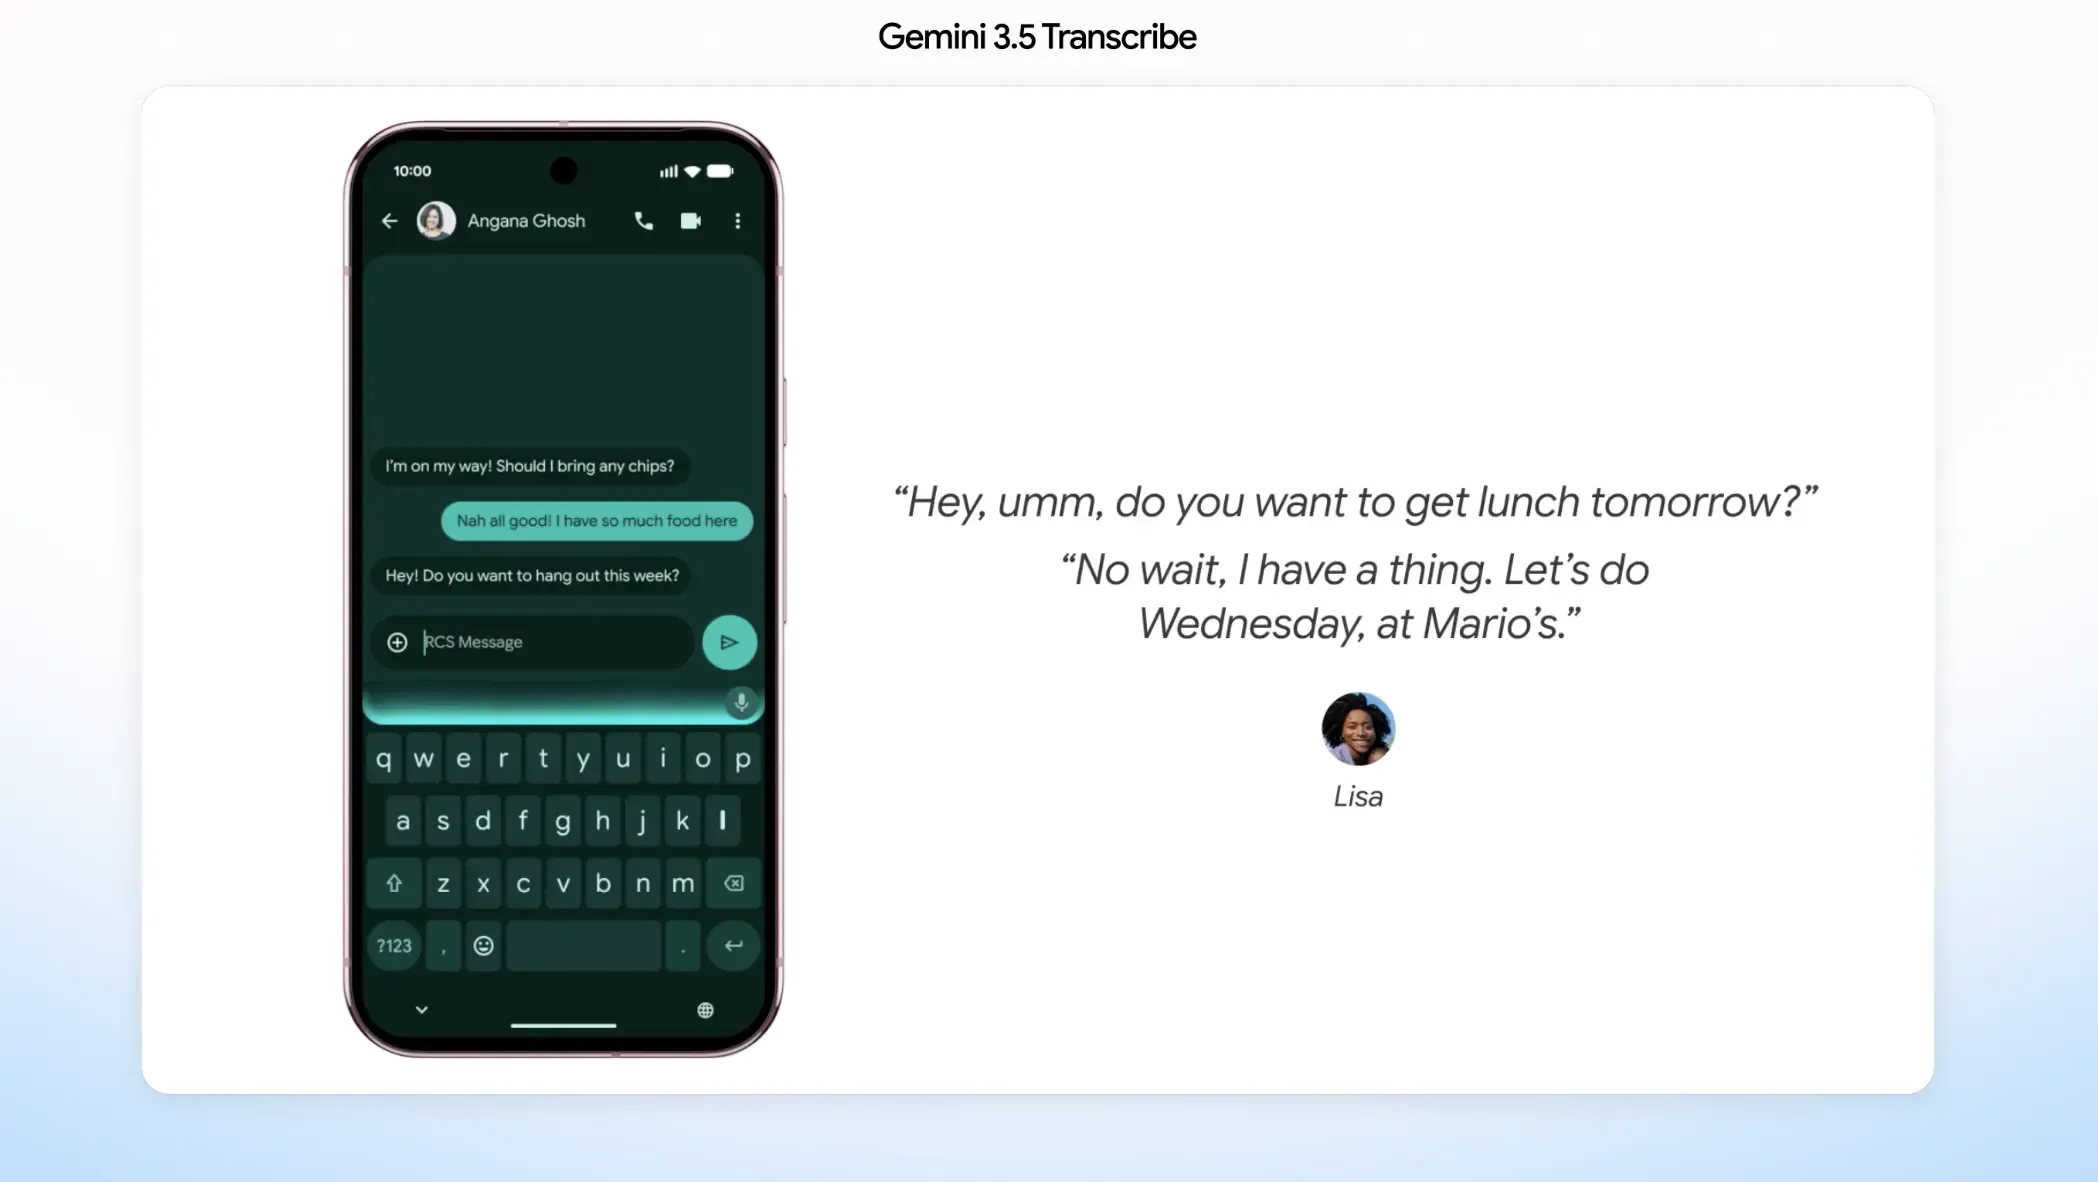
หัวใจของ Gemini 3.5 Transcribe ไม่ใช่แค่การฟังให้ครบคำ แต่คือการเข้าใจวิธีที่คนพูดจริงในชีวิตประจำวันที่เต็มไปด้วยเสียงรบกวน การลังเล และการแก้ประโยคกลางคัน โมเดลสามารถจัดการเสียงพื้นหลัง สุ้มเสียงที่ฟังยาก และคำพูดที่ไม่เป็นระเบียบให้กลายเป็นข้อความที่สละสลวย พร้อมใช้งานทันที ผ่านฟีเจอร์ Smart Transcription ที่เข้าใจการพูดเช่น “นัดวันอังคาร ไม่ใช่ วันพุธ” แล้วสะท้อนความตั้งใจสุดท้ายของผู้พูด พร้อมตัดคำอย่าง “เอ่อ” หรือ “อืม” ออกจากข้อความให้อัตโนมัติ จุดเปลี่ยนสำคัญคือความสามารถด้านประมวลผลภาษา 85 ภาษา ที่ตรวจจับและถอดเสียงได้อัตโนมัติ พร้อมรองรับสำเนียงและภาษาถิ่นมากมาย สิ่งนี้ทำให้โมเดล AI รู้จำเสียงก้าวข้ามการเป็นเครื่องมือของภาษาใดภาษาหนึ่งไปสู่การเป็นแพลตฟอร์มสื่อสารระดับโลก การทดสอบจาก Artificial Analysis ระบุว่า Gemini 3.5 Transcribe มีอัตราความผิดพลาดของคำเฉลี่ย 4.0 เปอร์เซ็นต์สำหรับการถอดเสียงแบบสตรีมมิง และ 2.6 เปอร์เซ็นต์สำหรับแบบไม่สตรีมมิง ตัวเลขนี้สะท้อนว่าการใช้เสียงเพื่อทำงานเชิงเนื้อหากลายเป็นสิ่งที่ไว้ใจได้ มากกว่าที่เคยเป็นในยุคโมเดลรุ่นก่อน ๆ
จากห้องประชุมถึงแป้นพิมพ์มือถือ AI ถอดเสียงเปลี่ยนงานเสียงให้เป็นข้อมูล
เมื่อโมเดลถอดเสียงเป็นข้อความมีความแม่นยำระดับนี้ ผลกระทบไม่ใช่แค่การพูดเพื่อพิมพ์ในช่องแชต แต่คือการเปลี่ยนทุกการสนทนาให้กลายเป็นข้อมูลที่ค้นหาและวิเคราะห์ได้ Gemini 3.5 Transcribe รองรับทั้งการสตรีมเสียงแบบเรียลไทม์และการประมวลผลไฟล์บันทึกเสียง เช่น การประชุมหรือการสนทนาทางโทรศัพท์ พร้อมระบุผู้พูดและเวลาในระดับคำ สามารถแยกเสียงพูดได้สูงสุด 3 คนในไฟล์เดียว พร้อมใส่ timestamp ให้ นี่คือการทำ speaker separation แบบอัตโนมัติที่ทำให้การทบทวนประชุมหรือการฝึกอบรมด้วยเสียงมีประโยชน์มากขึ้นหลายเท่า สำหรับผู้ใช้ทั่วไป เทคโนโลยีเสียง AI นี้เริ่มถูกฝังไว้ในเครื่องมือที่คุ้นเคยแล้ว โมเดลถูกนำไปใช้ในฟีเจอร์ Rambler บน Android และแอป Gemini บน macOS เพื่อให้ผู้ใช้เปลี่ยนคำพูดธรรมชาติเป็นข้อความที่จัดรูปแบบแล้ว แก้คำผิด และเปลี่ยนสไตล์การเขียนด้วยเสียง ที่น่าสนใจคือ Chrome เตรียมเพิ่มฟีเจอร์พูดเพื่อพิมพ์ในช่องข้อความบนเว็บไซต์ ให้ผู้ใช้ตอบข้อความ ร่างโพสต์ หรือเขียน prompt สำหรับ Gemini ด้วยเสียงได้โดยตรง เมื่อเสียงเข้าไปอยู่ทุกที่แบบนี้ งานที่เคยต้องใช้มือพิมพ์จึงเริ่มถูกแทนที่ด้วยการพูด

แพลตฟอร์มนักพัฒนาและงานใหม่บนเสียง โอกาสของแอปที่พูดได้ คิดได้ และทำงานให้เรา
จุดที่ทำให้ Gemini 3.5 Transcribe น่าสนใจเป็นพิเศษคือการเปิดให้แพลตฟอร์มนักพัฒนาใช้โมเดลนี้สร้างแอปแบบ voice first ได้จริง Google ขยายโมเดลไปยัง Gemini API ใน Google AI Studio และ Gemini Enterprise Agent Platform รองรับทั้ง Live API สำหรับสตรีมเสียงแบบสองทิศทางความหน่วงต่ำ และ Interactions API สำหรับการถอดเสียงไฟล์บันทึกพร้อมแยกผู้พูด หมายความว่านักพัฒนาสามารถสร้าง voice agent ระบบสร้างคำบรรยายแบบเรียลไทม์ หรือเครื่องมือวิเคราะห์การสนทนาหลังจบการคอล โดยไม่ต้องสร้างระบบรู้จำเสียงใหม่ตั้งแต่ต้น ฟีเจอร์อย่าง Custom Vocabulary ทำให้แอปที่ใช้คำเฉพาะ เช่น แพทย์ กฎหมาย หรือเทคโนโลยี สามารถสอนให้โมเดลเข้าใจศัพท์ของตนเองได้ดีขึ้น ขณะที่ Function Calling เปิดช่องให้เสียงกลายเป็นประตูสู่การสั่งงาน AI ขั้นสูง เช่น การส่งต่อคำสั่งสร้างภาพหรือวิเคราะห์ไฟล์ไปยังโมเดลอื่น สุดท้าย เมื่อ Gemini 3.5 Transcribe ถูกผสานเข้ากับ Gboard บน Android แอป Gemini และบริการอื่น ๆ แล้ว เรากำลังเห็นโครงสร้างพื้นฐานใหม่ของอินเทอร์เฟซเสียง ที่เปิดโจทย์ให้ผู้พัฒนาออกแบบประสบการณ์การใช้เทคโนโลยีด้วยเสียงในรูปแบบที่ไม่เคยมีมาก่อน
ข้อคิดส่งท้าย เสียงกำลังกลายเป็นภาษาหลักของการคุยกับ AI
จากภาพรวม Gemini 3.5 Transcribe ไม่ใช่แค่การอัปเกรดเรื่องความแม่นยำ แต่เป็นการประกาศว่าการสื่อสารด้วยเสียงกำลังจะขึ้นมาเป็นช่องทางหลักในการสั่งงานและคุยกับ AI โมเดลนี้จัดการเสียงรบกวน สำเนียง และการพูดที่ไม่เป็นทางการได้ดี พร้อมรองรับการประมวลผลภาษา 85 ภาษาแบบเรียลไทม์ และการแยกผู้พูดในบทสนทนาเดียวกัน ซึ่งทั้งหมดทำให้เสียงกลายเป็นอินพุตที่เชื่อถือได้ ใกล้เคียงการพิมพ์มากขึ้นทุกวัน สำหรับผู้ใช้ทั่วไป ผลกระทบคือการที่เราจะเริ่มใช้เสียงกับแทบทุกอุปกรณ์ ตั้งแต่โทรศัพท์ โน้ตบุ๊ก ไปจนถึงเบราว์เซอร์ของเรา โดยไม่รู้สึกว่ากำลังเสียความแม่นยำเหมือนยุคเก่าที่ระบบฟังผิดบ่อย สำหรับนักพัฒนา นี่คือโอกาสสร้างผลิตภัณฑ์ที่ยึดเสียงเป็นศูนย์กลางของการออกแบบ ไม่ว่าจะเป็นระบบช่วยงานลูกค้า เครื่องมือสรุปประชุม หรือผู้ช่วยส่วนตัวที่เข้าใจเราแบบพูดคุยกัน คำถามที่เหลือจึงไม่ใช่ว่าเทคโนโลยีเสียง AI พร้อมหรือยัง แต่คือเราพร้อมจะออกแบบชีวิตและการทำงานให้ใช้เสียงเป็นภาษาหลักของการคุยกับ AI หรือยัง และ Gemini 3.5 Transcribe ดูจะเป็นคำตอบแรกที่ชัดเจนว่าทิศทางนี้กำลังเดินหน้ามาเต็มตัว