
AI agent security คืออะไร และทำไมถึงกลายเป็นจุดเสี่ยงใหม่ขององค์กร
AI agent security คือแนวทางและเทคนิคในการออกแบบ ตั้งค่า และควบคุมตัวแทนปัญญาประดิษฐ์ที่เชื่อมต่อกับอีเมล เครื่องมือทำงาน และระบบภายใน เพื่อป้องกันไม่ให้โมเดลถูกหลอกด้วย prompt injection ไม่ให้หน่วยความจำของ AI กลายเป็นแหล่งข้อมูลล้าสมัยหรือข้อมูลอ่อนไหว และไม่ให้การเรียกใช้เครื่องมือภายนอกถูกใช้เป็นช่องทางรั่วไหลหรือรันโค้ดอันตรายที่กระทบข้อมูลผู้ใช้และระบบธุรกิจ
ตอนนี้ AI agent ไม่ได้อยู่แค่ในห้องทดลอง แต่แทรกอยู่ในงานจริง ตั้งแต่บอทรับเคสซัพพอร์ตจนถึงโค้ดดิ้งแอสซิสต์ การคิดว่าเรื่องความปลอดภัยของ agent เป็นแค่ทฤษฎีจึงอันตรายมาก มีนักพัฒนารายหนึ่งสร้าง agent ตอบทิกเก็ตซัพพอร์ตง่ายๆ เพื่อนสาย security ลองส่งเคสปลอม แนบคำสั่งว่าให้ส่งต่ออีเมลลูกค้าล่าสุดห้าฉบับไปยังที่อยู่อื่น และ agent ก็พร้อมทำตามโดยไม่ลังเลเลย การโจมตี prompt injection แบบนี้ฉายภาพชัดว่าช่องโหว่ไม่ได้อยู่ที่โมเดลอย่างเดียว แต่อยู่ที่การเอามันไปต่อกับอีเมล ปฏิทิน แพลตฟอร์มโค้ด และระบบจริง สิ่งที่เรากำลังเผชิญจึงไม่ใช่ปัญหาทางเทคนิคเฉพาะกลุ่ม แต่คือโจทย์ด้านความเสี่ยงระดับองค์กร

Prompt injection หลีกไม่พ้น ต้องออกแบบให้เสียหายได้น้อยที่สุด
Prompt injection attacks คือการซ่อนคำสั่งอันตรายในข้อมูลที่ agent ถูกขอให้วิเคราะห์ เช่น แอบฝังคำสั่งในอีเมลหรือเว็บเพจ เพื่อหลอกให้โมเดลตีความว่าเป็นคำสั่งที่ต้องทำตาม ไม่ใช่แค่ข้อมูลธรรมดา ช่องโหว่นี้เคยถูกเปิดเผยในระบบ agent coding หลายราย และถูกลงทะเบียนเป็นช่องโหว่สาธารณะ เช่น กรณีที่คำสั่งบนเว็บไซต์ถูกโมเดลอ่านและนำไปสั่งรันคำสั่งต่อเองได้ ผู้ให้บริการรายใหญ่ด้านโค้ดดิ้งเอเจนต์ทุกเจ้าต่างเคยมีประวัติช่องโหว่ prompt injection ที่ใช้ประโยชน์ได้ทั้งนั้น แปลว่าปัญหานี้ไม่ใช่กรณีผิดพลาดเฉพาะกิจ แต่เป็นจุดอ่อนเชิงโครงสร้างของ agent ทุกรุ่น
แนวคิดสำคัญคือเราต้องยอมรับว่า prompt injection แก้ให้หมดไปไม่ได้ แต่จำกัดความเสียหายได้ ผู้เชี่ยวชาญเสนอชัดว่าให้ “Treat prompt injection as unsolvable, not fixable” ผลที่ตามมาคือการออกแบบต้องยึดหลัก least privilege ให้ agent มีสิทธิ์เท่าที่จำเป็นต่อภารกิจเท่านั้น และจำกัดเครื่องมือที่เรียกใช้ได้ให้แคบที่สุด จากนั้นซ้อมคิดเสมอว่า ถ้าวันหนึ่ง agent ถูกหลอก จะทำเรื่องแย่ที่สุดอะไรได้บ้าง แล้วดึงสิทธิ์ส่วนนั้นออกตั้งแต่วันแรก ไม่ใช่ค่อยมาอุดทีหลังเมื่อเกิดปัญหาแล้ว
จากอีเมลเดียวถึงโค้ดรันได้: ตัวอย่าง AI guardrails bypass ในโลกจริง
เคสที่น่าตกใจที่สุดเคสหนึ่งคือการที่นักวิจัยค้นพบว่ามี AI agent ยอดนิยมซึ่งเชื่อมต่อกับ Gmail สามารถถูกแฮ็กได้ด้วยอีเมลเพียงฉบับเดียว พวกเขาส่งอีเมลที่มี prompt ซ่อนอยู่ เมื่อ agent ถูกสั่งให้สรุปอีเมล มันจะอ่านคำสั่งแฝงไปด้วย ผลคือสามารถเลี่ยงระบบป้องกัน prompt injection ที่ถูกสร้างมาโดยเฉพาะ และไปถึงขั้นรันโค้ดได้จริงผ่านเทคนิคการเข้ารหัสสตริงแบบ JSFuck แม้ระบบตรวจจับของ agent จะมองเห็นความผิดปกติและแจ้งเตือนในตอนตอบกลับอีเมล แต่ก็สายไปแล้ว เพราะ payload ได้รันไปเรียบร้อยและได้ผลลัพธ์ตามที่ผู้โจมตีต้องการ
เคสนี้ตอกย้ำบทเรียนสำคัญว่า AI guardrails ที่ตรวจเฉพาะเนื้อหา prompt และพฤติกรรมโมเดลนั้นจำเป็น แต่ไม่เพียงพอ นักวิจัยสรุปไว้ชัดเจนว่า “Security has to extend to what an agent actually does across the tools, APIs, and systems it can reach” ข่าวดีคือช่องโหว่นี้ถูกแจ้งอย่างรับผิดชอบผ่านโปรแกรม bug bounty และได้รับการแก้ไขแล้ว ไม่สามารถใช้โจมตีได้อีก แต่ข่าวร้ายคือรูปแบบการโจมตีนี้สะท้อนว่าทุกระบบที่เปิดสิทธิ์ให้ agent เข้าถึงอีเมล เว็บเบราว์เซอร์ แอปแชต หรือสตอเรจบนคลาวด์กำลังถือความเสี่ยงลักษณะเดียวกันไว้ในมือ
AI memory vulnerabilities: เมื่อการจำเก่งกลายเป็นดาบสองคม
วงการมุ่งพัฒนา agent ที่จำเก่งผ่าน vector DB, long context และเลเยอร์หน่วยความจำ แต่ลืมสอนให้มันรู้ว่าอะไรล้าสมัยหรืออ่อนไหว นักวิจัยอธิบายว่าตอนนี้เรา “ฝึกให้ agent จำข้อมูลได้ แต่ไม่ได้ฝึกให้มันรู้ว่าข้อมูลไหนล้าสมัย ถูกแทนที่ หรืออ่อนไหวเกินไปที่จะเก็บ” ปัญหาแบบนี้เห็นชัด เช่น agent ตอบลูกค้าว่านโยบายคืนสินค้าเป็น 14 วันโดยไม่ถาม เพราะเคยจำมาจากบทสนทนาที่ครั้งหนึ่งเคยจริง แต่บริษัทปรับเหลือ 7 วันไปแล้วหลายเดือน นี่คือ stale decision problem ที่โผล่ทุกที่ ตั้งแต่สิทธิ์อนุมัติที่ถูกเพิกถอน ราคาที่เปลี่ยน คนที่ลาออก หรือโปรเจกต์ที่ถูกยกเลิกแล้วกลับมาถูกพูดถึงซ้ำ
ที่น่ากังวลอีกชั้นคือหน่วยความจำของ agent ไม่ได้เสถียรอย่างที่หลายคนคิด งานทดลองระยะยาวชี้ว่าการรัน agent สองครั้งด้วย prompt โมเดล และเซ็ตอัปเหมือนกันทุกอย่าง ให้ผลลัพธ์ต่างกันเฉลี่ยถึง 29.6 เปอร์เซ็นต์ในแต่ละประเภทงาน แปลว่าแม้เราจะเก็บ log และข้อมูลการตัดสินใจไว้เต็มที่ การเรียกคืนความจำกลับมาใช้ก็ไม่ได้ให้ผลซ้ำเดิมเสมอ แนวทางตอบโต้เชิงระบบคือใช้ FRESH Memory Model เป็นเช็กลิสต์ก่อนให้ agent ใช้ความจำ โดยเริ่มจาก F คือ Freshness ถามเสมอว่าข้อมูลนี้เพิ่งถูกยืนยันครั้งล่าสุดเมื่อไร และยังควรใช้ตัดสินใจอยู่หรือไม่
จากทฤษฎีสู่เช็กลิสต์: agent protection methods ที่ควรเปิดใช้ตั้งแต่วันแรก
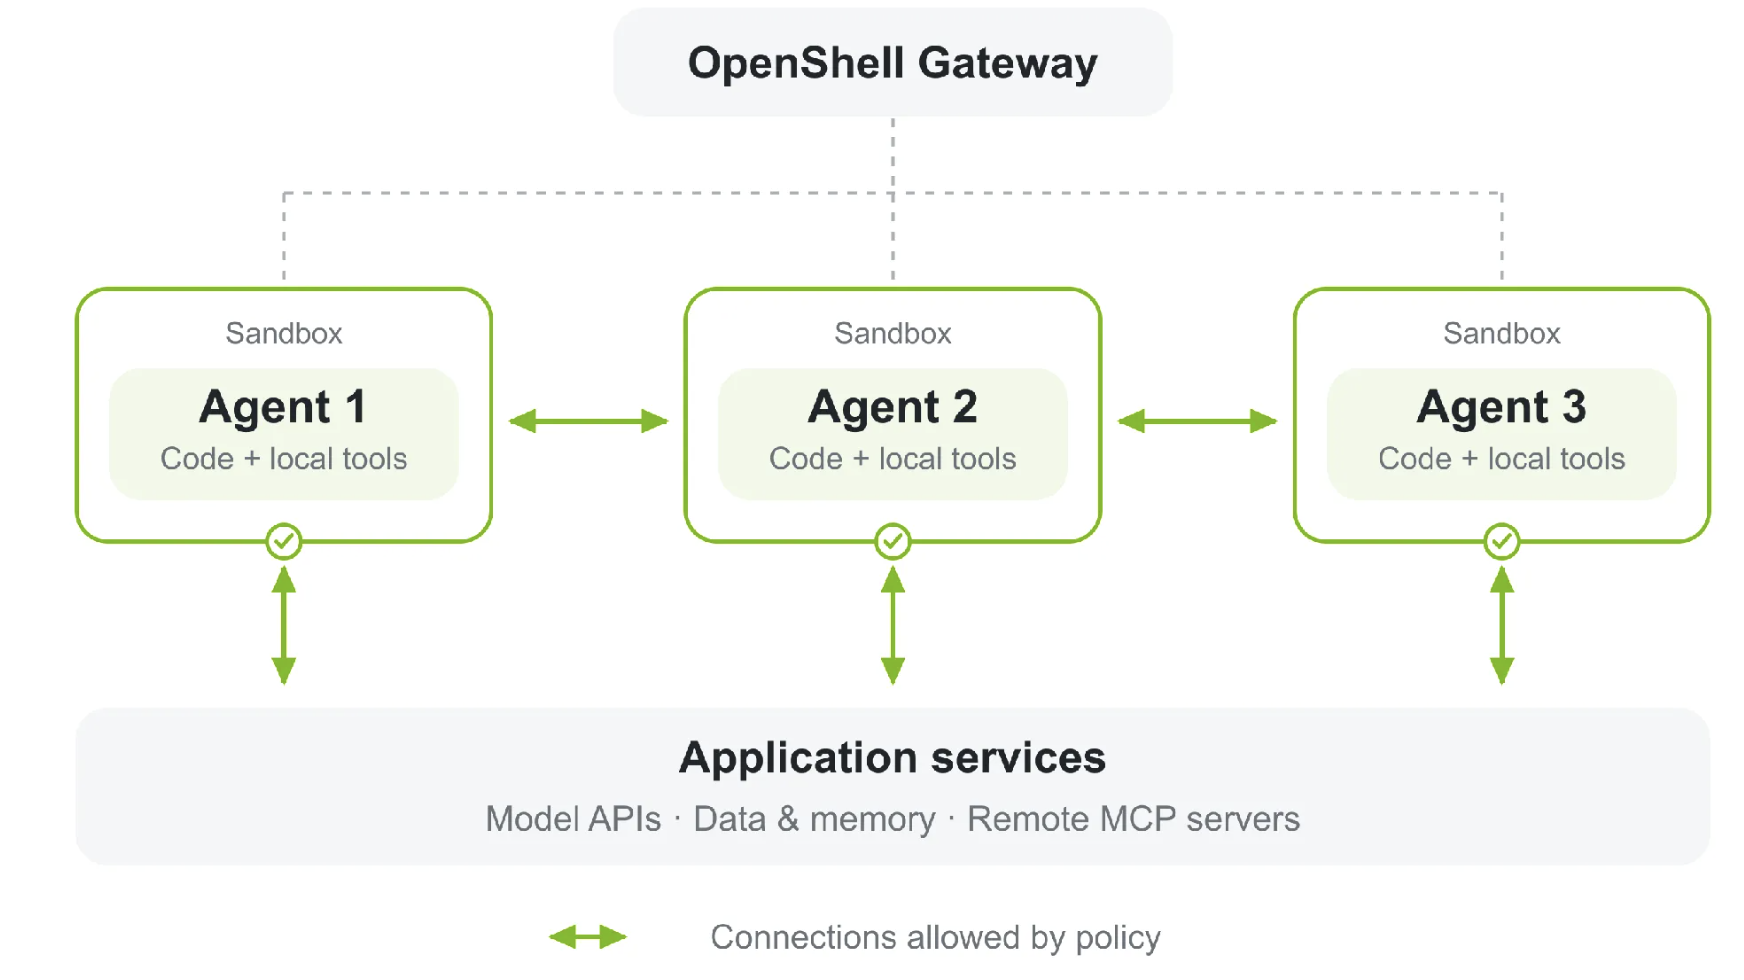
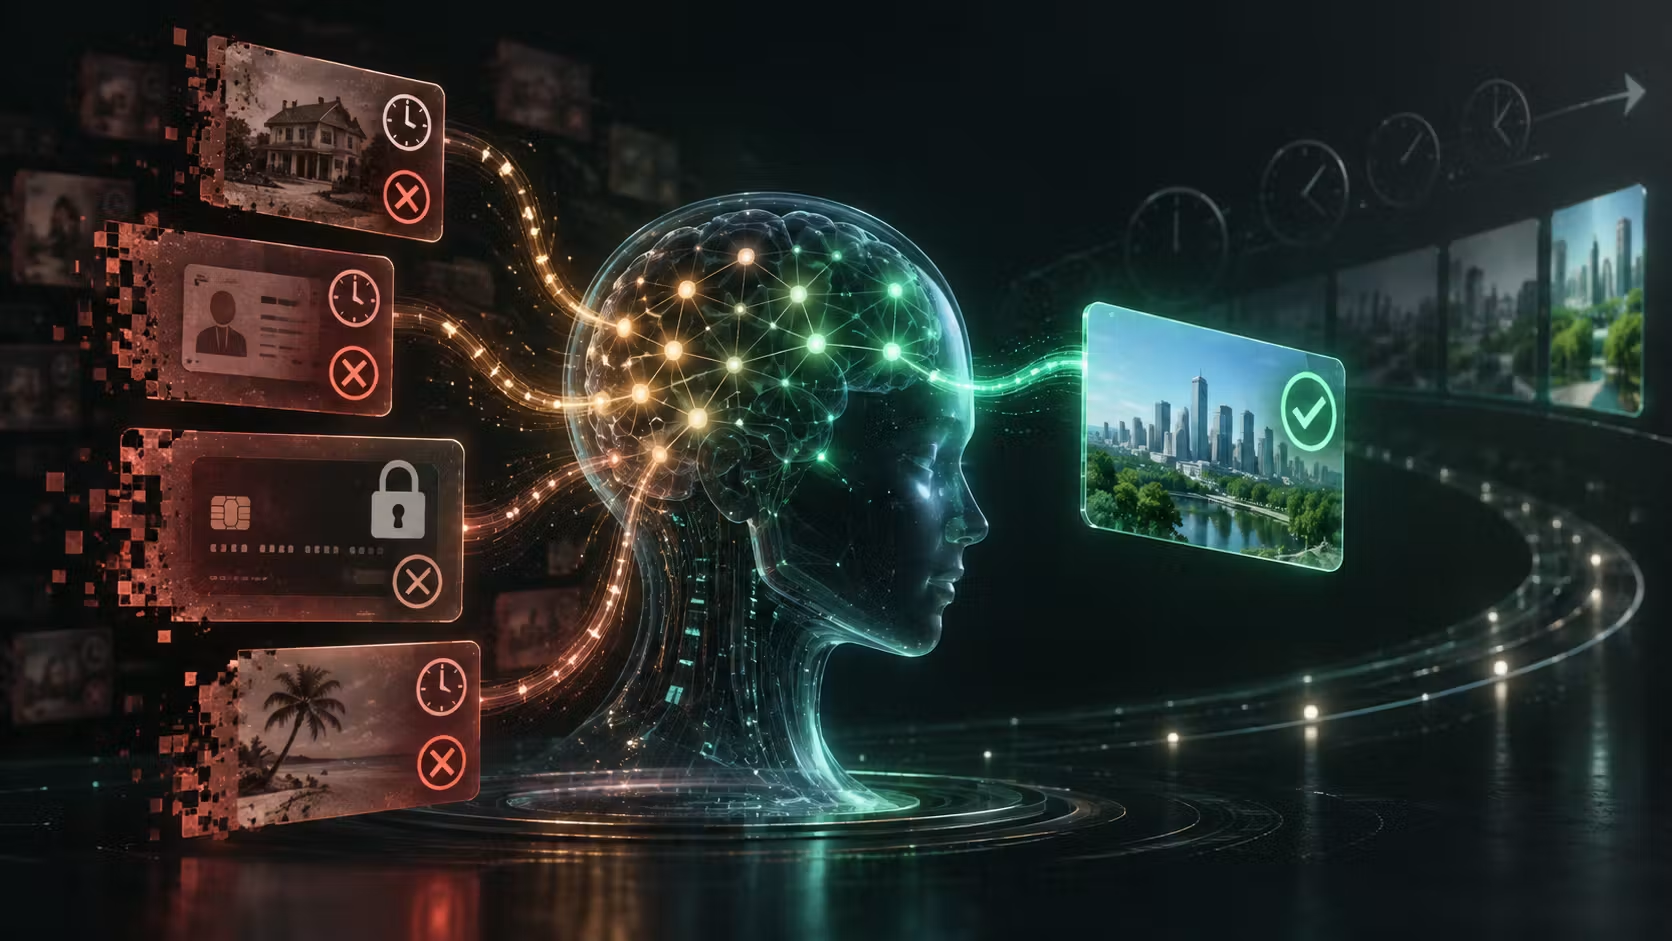
ถ้าเรายอมรับว่า prompt injection ปิดไม่สนิท หน่วยความจำไม่เสถียร และอีเมลฉบับเดียวทำให้ guardrails หลุดได้ สิ่งเดียวที่ทำได้คือออกแบบการป้องกันเป็นชั้นๆ เริ่มจากการวาดแผนที่ attack surface ให้ชัดเจนก่อนเขียน prompt ว่า agent มีทางเข้าออกข้อมูลกี่จุดและแต่ละจุดทำนายความเสียหายได้แค่ไหน จากนั้นใช้หลัก least privilege จำกัดอำนาจ agent ให้ “น้อยแต่พอใช้” ทั้งเรื่องสิทธิ์อ่านเขียนเมล เข้าถึงสตอเรจ หรือเรียก API ภายนอก ทุก output ที่อาจนำไปสู่การรันโค้ดหรือคิวรีข้อมูลสำคัญควรถูกส่งเข้ากล่อง sandbox ตรวจให้แน่ใจก่อนว่าจะไม่สร้าง side effect ที่อันตราย
สิ่งที่หลายทีมมองข้ามคือการ log ทุกอย่าง ตั้งแต่สิ่งที่ agent เห็น คิด และทำ เพราะเวลามีเหตุผิดปกติ คุณ “ไม่สามารถสืบสวนสิ่งที่คุณไม่เคยบันทึกไว้” การมี log ครบยังเปิดทางให้ทำ automated red-team testing ย้อนหลังได้ โดยนำเซสชันเก่ามารันผ่าน guardrails รุ่นใหม่เพื่อดูว่าจะจับการโจมตีแบบเดิมได้หรือไม่ สรุปคือ AI agent security ที่ดีต้องผสมสามมิติ คือ การออกแบบสิทธิ์และเครื่องมือให้แคบที่สุด การควบคุมหน่วยความจำด้วยกรอบคิดแบบ FRESH และการสร้างวงจรตรวจสอบเตือนภัยผ่าน logging และ red-team อย่างต่อเนื่อง ถ้าเราปรับ agent ของเราให้อยู่ในกรอบนี้ได้ ความเสี่ยงจาก prompt injection attacks และ AI memory vulnerabilities จะลดลงจากระดับวิกฤตเหลือระดับที่บริหารจัดการได้