
ยุคใหม่ของโมเดล AI ขนาดเล็ก ที่รันบนมือถือได้จริง
โมเดล AI ขนาดเล็กที่ประมวลผลบนอุปกรณ์คือโมเดลปัญญาประดิษฐ์ที่ถูกย่อขนาดและออกแบบให้ทำงานได้บนสมาร์ทโฟนหรืออุปกรณ์พกพาโดยไม่ต้องเชื่อมต่อคลาวด์ ช่วยลดดีเลย์ เพิ่มความเป็นส่วนตัว และเปิดโอกาสให้แอปพลิเคชันมือถือ AI ตอบสนองได้ทันทีในชีวิตประจำวันของผู้ใช้ หัวใจของการเปลี่ยนแปลงครั้งนี้คือ EmbeddingGemma 2 จาก Google ซึ่งเป็นโมเดล AI ขนาดเล็กที่รองรับเนื้อหาหลายรูปแบบและประมวลผลภายในอุปกรณ์ได้โดยไม่ต้องพึ่งพาคลาวด์จากภายนอก นั่นหมายความว่าเรากำลังก้าวจากยุคที่ทุกอย่างต้องส่งขึ้นเซิร์ฟเวอร์ ไปสู่ยุคที่สมาร์ทโฟนระดับกลางก็สามารถเป็นเครื่อง AI ส่วนตัวได้จริง การมาของ Gemma 2 Google ไม่ได้เป็นแค่การอัปเกรดเทคโนโลยี แต่เป็นการเปลี่ยนสมมติฐานของนักพัฒนาและผู้ใช้ว่า AI ต้องอยู่บนคลาวด์เสมอ
EmbeddingGemma 2 เล็กแต่โหด 740M พารามิเตอร์บนสมาร์ทโฟน
EmbeddingGemma 2 ถูกพัฒนาจากโครงสร้างของ Gemma 4 ด้วยขนาดเพียง 740 ล้านพารามิเตอร์ นี่คือจุดหักเหสำคัญ เพราะตัวเลขนี้เล็กพอให้สมาร์ทโฟนระดับกลางที่มีแรมประมาณ 8 GB รันโมเดลได้อย่างราบรื่นโดยไม่ต้องพึ่งเซิร์ฟเวอร์ภายนอก โมเดลยังรองรับบริบทเนื้อหาสูงสุด 8,000 โทเคน ทำให้จัดการข้อความยาวหรือข้อมูลซับซ้อนได้ดีในระดับหนึ่ง สิ่งที่น่าสนใจคือ EmbeddingGemma 2 ไม่ได้เป็นแค่โมเดลข้อความ แต่รองรับข้อมูลทั้งข้อความ โค้ด ภาพ เสียง และวิดีโอในตัวเดียว การรองรับหลายโหมดแบบนี้เมื่อรวมกับการประมวลผลบนอุปกรณ์ ทำให้แอปพลิเคชันมือถือ AI สามารถวิเคราะห์ไฟล์หลากหลายรูปแบบได้โดยไม่ต้องอัปโหลดขึ้นคลาวด์ ผู้ใช้จึงได้ทั้งความเร็วและความสบายใจด้านข้อมูลส่วนตัวในคราวเดียว
มัลติโหมดบนเครื่องเดียว ข้อดีด้านความเร็วและความเป็นส่วนตัว
จุดเด่นที่ทำให้ EmbeddingGemma 2 น่าสนใจเป็นพิเศษคือความสามารถแบบมัลติโหมดที่รองรับข้อมูลทั้งข้อความ โค้ด ภาพ เสียง และวิดีโอภายในตัวเดียว และยังประมวลผลภายในอุปกรณ์ได้โดยไม่ต้องพึ่งพาคลาวด์จากภายนอก นี่คือคำตอบตรงๆ ต่อปัญหาดีเลย์และความกังวลเรื่องข้อมูลที่ต้องส่งขึ้นเซิร์ฟเวอร์ โครงสร้างของโมเดลยังถูกออกแบบแบบแยกส่วน แบ่งเป็นโมเดลข้อความ 270 ล้านพารามิเตอร์ ระบบมองเห็น 170 ล้านพารามิเตอร์ และระบบเสียง 300 ล้านพารามิเตอร์ เพื่อให้เลือกใช้เฉพาะส่วนที่จำเป็น ลดการใช้ทรัพยากรของเครื่อง ผลลัพธ์คือการประมวลผลบนอุปกรณ์ที่เบาลงแต่ยังตอบสนองได้ดี โดยเฉพาะเมื่อใช้เทคนิค quantization บนสมาร์ทโฟนอย่าง Pixel 11 Pro ที่ทำให้โมเดลข้อความใช้แรมเพียง 191 MB และโมเดลเต็มรูปแบบใช้ 567 MB เท่านั้น ซึ่งเป็นตัวเลขที่แสดงให้เห็นว่าการรัน AI บนมือถือไม่ใช่เรื่องเพ้อฝันอีกต่อไป
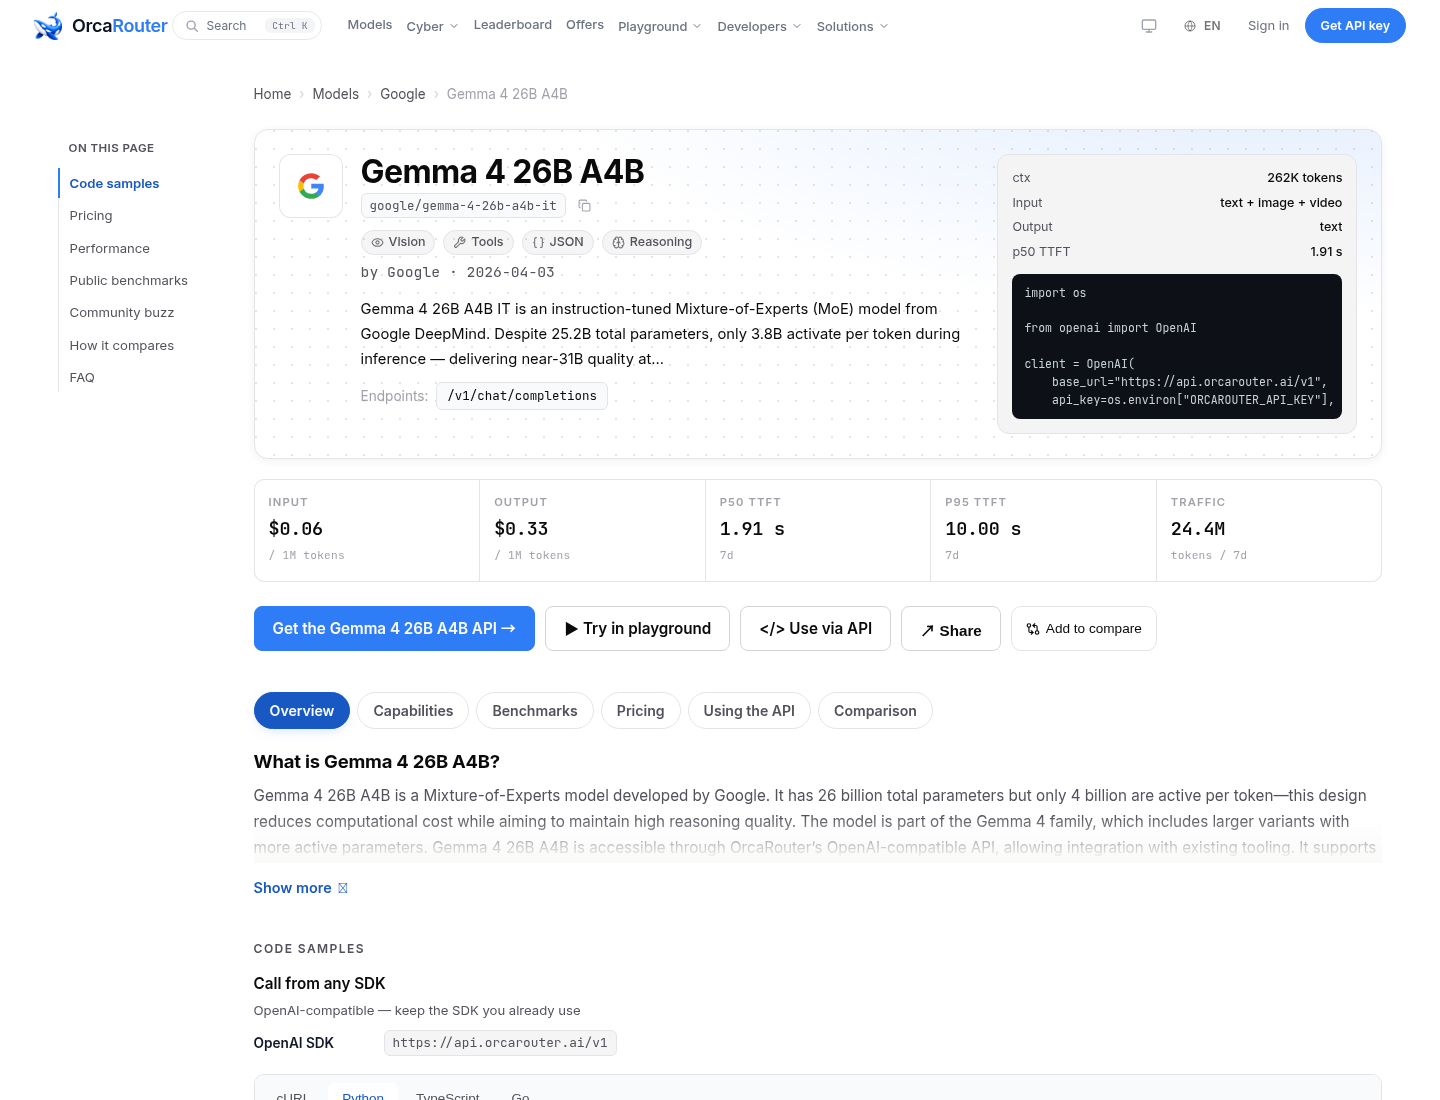
Gemma 4 ทั้งตระกูล เลือกขนาดให้ตรงฮาร์ดแวร์และงาน
EmbeddingGemma 2 จะยิ่งมีความหมายมากขึ้นเมื่อมองคู่กับตระกูล Gemma 4 ที่เป็นฐานสถาปัตยกรรมของมัน ตระกูลนี้มีห้าโมเดลแยกจากกัน ได้แก่ Gemma 4 E2B, Gemma 4 E4B, Gemma 4 12B, Gemma 4 26B A4B และ Gemma 4 31B ซึ่งกระจายอยู่บนสองสถาปัตยกรรมและสองระดับหน้าต่างบริบท แนวคิดคือให้มีตัวเลือกครอบคลุมตั้งแต่การใช้งานบนอุปกรณ์ขนาดเล็กไปจนถึงงานระดับใหญ่บนฮาร์ดแวร์แรง E2B และ E4B ถูกออกแบบมาสำหรับโทรศัพท์และอุปกรณ์ IoT โดยเฉพาะ ส่วน 12B เป็นตัวกลางที่รองรับเสียง ขณะที่ 26B A4B ใช้แนวคิดพารามิเตอร์ที่ใช้งานจริงน้อยลงเพื่อให้ inference ใกล้เคียงโมเดล 4B แต่คุณภาพใกล้ 31B และ 31B เองเป็นรุ่นท็อปแบบ dense สำหรับนักพัฒนา นี่หมายถึงการเลือกขนาดโมเดลให้เหมาะกับข้อจำกัดฮาร์ดแวร์และความต้องการของแอป ไม่ต้องฝืนใช้โมเดลใหญ่เกินจำเป็น
โอกาสใหม่ของนักพัฒนา แอปมือถือ AI ที่ไม่ต้องง้อเซิร์ฟเวอร์
เมื่อ EmbeddingGemma 2 เปิดให้ดาวน์โหลดในฐานะโอเพนซอร์ส เกมของนักพัฒนาแอปก็เปลี่ยนทันที โมเดลนี้เหมาะสำหรับการประมวลผลในอุปกรณ์ ตั้งแต่สมาร์ทโฟนระดับกลางที่มีแรมราว 8 GB โน้ตบุ๊กทำงาน เว็บเบราเซอร์ทั่วไป แว่นตาอัจฉริยะ หรือแม้แต่อุปกรณ์ IoT บางชนิดก็สามารถติดตั้งและใช้งานโมเดลนี้ได้อย่างราบรื่น นั่นหมายถึงแอปพลิเคชันมือถือ AI รุ่นใหม่สามารถออกแบบให้ตอบสนองได้ทันทีแม้ในสภาวะเน็ตไม่เสถียร หรือในพื้นที่ที่ไม่มีสัญญาณ สำหรับผู้ใช้ ผลลัพธ์คือประสบการณ์ที่เร็วขึ้นและเป็นส่วนตัวมากขึ้น เพราะข้อมูลจำนวนมากไม่ต้องออกจากเครื่อง ส่วนสำหรับนักพัฒนา การไม่ต้องพึ่งเซิร์ฟเวอร์หนักๆ ลดทั้งความซับซ้อนของโครงสร้างพื้นฐานและความเสี่ยงด้านข้อมูล การมาของ Gemma 2 Google และตระกูล Gemma 4 จึงไม่ใช่แค่การเพิ่มตัวเลือกโมเดล AI แต่เป็นการเปิดประตูสู่ยุคที่มือถือกลายเป็นแพลตฟอร์ม AI ชั้นแรก ไม่ใช่แค่หน้าบ้านของคลาวด์อีกต่อไป