
ความปลอดภัยต้องติดมากับเอเจนต์ตั้งแต่ต้น
AI Agent คือระบบปัญญาประดิษฐ์ที่รับเป้าหมายแล้วเลือกใช้เครื่องมือ เข้าถึงข้อมูล และดำเนินงานต่อเนื่องได้เอง โดยอำนาจลงมือทำนี้ทำให้ความผิดพลาดด้านความปลอดภัยมีผลไกลกว่าคำตอบที่คลาดเคลื่อนในแชต ความเห็นที่ควรยึดเป็นหลักคือ องค์กรไม่ควรเลือกระหว่างการพัฒนาให้เร็วกับการป้องกันให้รอบคอบ เพราะหากสิทธิ์และขอบเขตถูกกำหนดทีหลัง ความเร็วก็อาจกลายเป็นช่องทางสร้างความเสียหายได้
เมื่อเอเจนต์เชื่อมกับเครื่องมือซับซ้อนและข้อมูลอ่อนไหว ความปลอดภัยไซเบอร์องค์กรจึงต้องครอบคลุมวงจรทั้งหมด ตั้งแต่ค้นหาจุดอ่อนก่อนใช้งานจริง ไปจนถึงติดตามพฤติกรรมระหว่างทำงาน ซิสโก้ประกาศเพิ่ม Claude Mythos ใน Cisco AI Defense เพื่อทดสอบเจาะระบบ AI ทั้งแอปพลิเคชันและ Agent เมื่อวันที่ 11 พฤศจิกายน 2569 พร้อมผสาน Splunk Agent Observability และ Cisco IQ เพื่อให้ทีมความปลอดภัยกับทีมปฏิบัติการตรวจจับและจัดการความเสี่ยงได้ต่อเนื่อง
ทดสอบให้เหมือนผู้โจมตี แต่เฝ้าดูต่อหลังเปิดใช้
การทดสอบเจาะระบบ AI แบบปรับตัวได้มีคุณค่าเพราะไม่หยุดอยู่ที่การตรวจรายการช่องโหว่ทั่วไป แต่จำลองเส้นทางโจมตีหลายขั้นตอนที่เจาะจงกับระบบ เพื่อค้นหาจุดอ่อนซึ่งอาจเกิดจากการเชื่อมต่อเครื่องมือและข้อมูลหลายส่วน การเพิ่ม Claude Mythos เข้าในกรอบทดสอบของซิสโก้จึงเป็นการเพิ่มแรงกดดันให้ระบบก่อนนำไปใช้จริง ไม่ใช่ใบรับรองว่าจะปลอดภัยตลอดไป การทดสอบแบบนี้จะเปิดให้บางองค์กรใช้งานเร็ว ๆ นี้ ส่วนโมเดลประเมินผลและเครื่องมือปรับแต่งการประเมินเปิดให้บริการทั่วไปแล้วตั้งแต่เดือนนี้
การตรวจสอบหลังเปิดใช้งานสำคัญไม่แพ้การทดสอบก่อนเปิดตัว เพราะพฤติกรรมของเอเจนต์เปลี่ยนตามคำสั่ง ข้อมูล และสภาพแวดล้อม Splunk Agent Observability และ Cisco IQ ตั้งใจเชื่อมข้อมูลการตรวจจับภัยคุกคามกับโครงสร้างพื้นฐานที่เสี่ยง เพื่อให้ทีมเห็นสัญญาณและเร่งแก้ไขได้ การทดสอบจึงตอบคำถามว่าเอเจนต์ถูกหลอกหรือถูกเจาะได้อย่างไร ส่วนการเฝ้าระวังเอเจนต์ AI ช่วยตอบว่าในงานจริงกำลังทำอะไร หากองค์กรทำเพียงอย่างใดอย่างหนึ่ง ก็ยังเหลือช่วงว่างระหว่างผลทดสอบกับความเสี่ยงที่เกิดขึ้นจริง
โลว์โค้ดและไฮโค้ด ความเสี่ยงอยู่คนละจุด
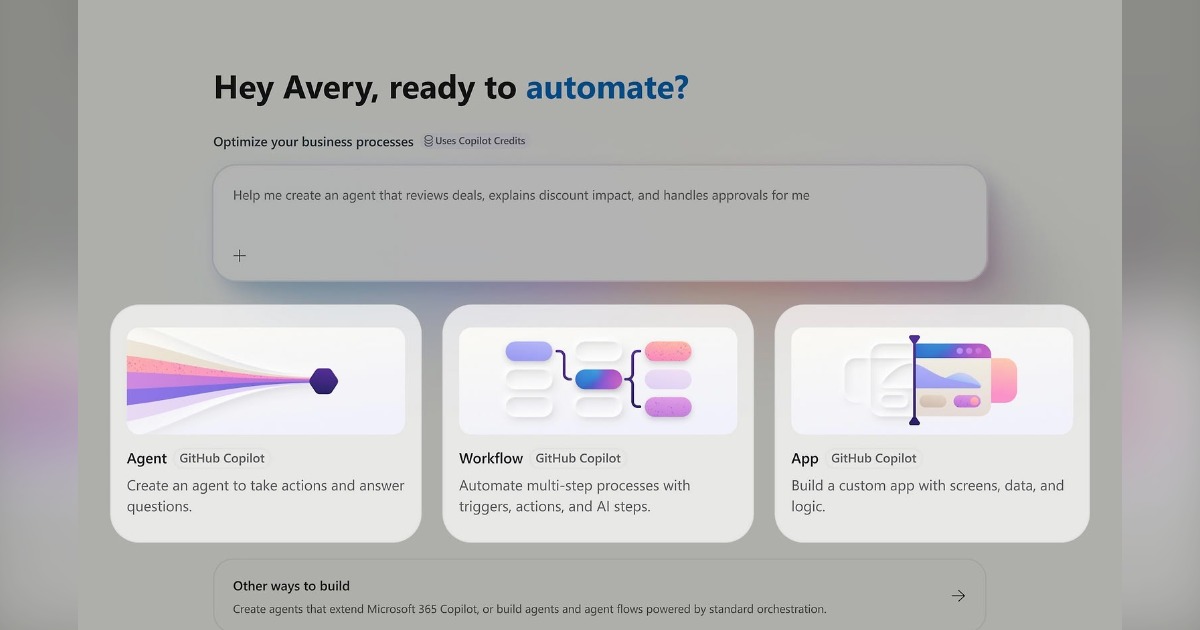
การพัฒนาแบบโลว์โค้ดช่วยให้สร้างเอเจนต์ผ่านหน้าจอและตัวเชื่อมต่อสำเร็จรูปได้เร็ว แต่ความง่ายนี้อาจทำให้ผู้สร้างมองข้ามสิทธิ์ของแพลตฟอร์มและการแชร์ข้อมูล ส่วนไฮโค้ดให้ทีมกำหนดพฤติกรรมได้ยืดหยุ่นกว่า แต่ทีมต้องรับผิดชอบสภาพแวดล้อมประมวลผล การเรียกใช้เครื่องมือ และการตรวจทานโค้ดด้วยตัวเอง กลยุทธ์ความปลอดภัย AI Agent จึงต้องผูกกับวิธีพัฒนา ไม่ใช่ใช้รายการตรวจสอบชุดเดียวแล้วคาดหวังว่าจะครอบคลุมทุกระบบ
สำหรับผู้ใช้ในองค์กร ความเสี่ยงไม่ได้จำกัดอยู่ที่ผู้เชี่ยวชาญด้านเทคโนโลยี การแชร์ในวงกว้างและการระบุผู้รับผิดชอบไม่ชัดเจนอาจเปิดเผยข้อมูล ทีมควรตรวจสอบสิทธิ์ของตัวเชื่อมต่อให้ตรงกับงานของเอเจนต์แต่ละตัว และให้สิทธิ์เท่าที่จำเป็น พร้อมตรวจว่าคำสั่งที่เปลี่ยนไประหว่างเซสชันยังอยู่ในขอบเขตเดิมหรือไม่ ความเร็วในการสร้างจึงควรมาพร้อมผู้รับผิดชอบที่ชัดเจน บันทึกที่ตรวจสอบย้อนหลังได้ และข้อจำกัดการเข้าถึงที่เหมาะกับงาน
อย่าฝากเส้นแบ่งความปลอดภัยไว้กับโมเดล
ไมโครซอฟท์เตือนว่าองค์กรไม่ควรเชื่อใจ AI Agent อย่างไร้เงื่อนไข เพราะเอเจนต์อาจตีความงานผิด ถูกเนื้อหาประสงค์ร้ายชักนำ หรือทำสิ่งที่ไม่คาดคิด แม้ไม่มีใครเจาะระบบก็ตาม ประเด็นนี้สำคัญเป็นพิเศษเมื่อเอเจนต์ได้รับสิทธิ์แตะข้อมูลลูกค้า ระบบธุรกิจ หรือกระบวนการอนุมัติ การให้โมเดลตัดสินใจเองว่าควรเข้าถึงอะไรจึงเป็นการวางมาตรการป้องกันไว้ในจุดที่อาจผิดพลาดเสียเอง
แนวทางที่เหมาะกว่าคือแยกความสามารถในการเสนอการกระทำออกจากอำนาจอนุมัติจริง โดยระบบอิสระกำหนดสิทธิ์ขั้นต่ำ จำกัดงาน และเรียกการอนุมัติจากคนเมื่อการกระทำมีความเสี่ยง Guardian Agents เป็นอีกชั้นที่คอยสังเกตเอเจนต์ ตรวจหาความผิดปกติ สืบหาสาเหตุ และเมื่อจำเป็นอาจจำกัดหรือแยกเอเจนต์ออกจากระบบ อย่างไรก็ดี ผู้กำกับดูแลก็ไม่ควรฝากความปลอดภัยไว้กับเอเจนต์อีกตัวเพียงอย่างเดียว ต้องมีนโยบายและขอบเขตสิทธิ์ที่ระบบควบคุมแยกจากโมเดล
ข้อเสนอด้านผลิตภัณฑ์ของซิสโก้สะท้อนทิศทางที่น่าจับตา ทั้ง Tokenomics ซึ่งมีกำหนดเปิดทดลองแบบส่วนตัวในเดือนธันวาคมและให้บริการทั่วไปช่วงต้นปี 2570 บน AWS Marketplace กับข้อมูล Cisco IQ ที่ครอบคลุมลูกค้ามากกว่า 17,000 รายและอุปกรณ์เกือบ 22 ล้านเครื่อง แต่เครื่องมือจำนวนมากไม่ใช่คำตอบแทนการกำกับดูแล องค์กรควรเริ่มจากทดสอบก่อนใช้ จำกัดสิทธิ์ตามงาน เฝ้าดูการทำงานจริง และกำหนดจุดหยุดที่คนหรือระบบอิสระสั่งการได้ นี่คือเงื่อนไขที่ทำให้การขยายเอเจนต์ไม่ต้องแลกกับการขยายความเสี่ยง