
ชิปเฉพาะทางคือฐานให้ AI Agent ขยายจากต้นแบบสู่การใช้งานจริง
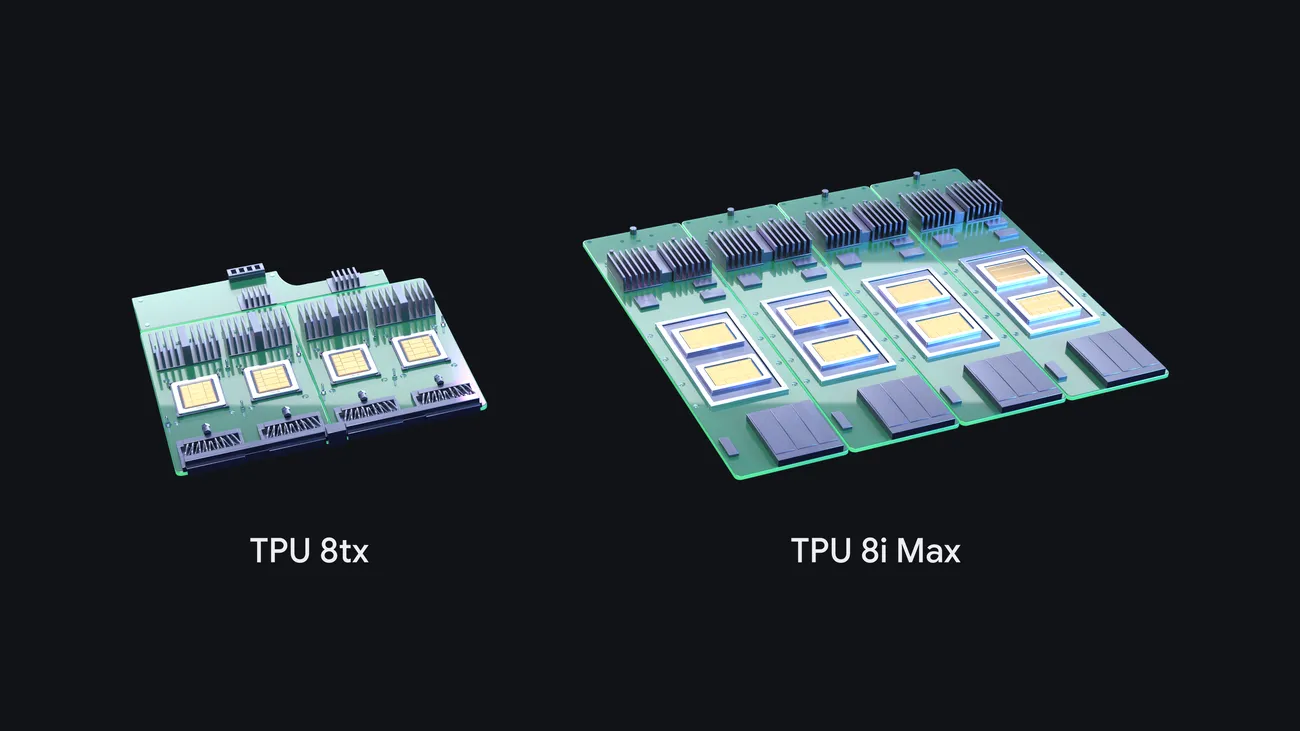
ชิป TPU Google คือหน่วยประมวลผลเฉพาะทางที่ออกแบบให้รองรับงาน AI แต่ละช่วง ตั้งแต่ฝึกโมเดล ให้เหตุผล ไปจนถึงประมวลผลข้อมูลลับและบริบทขนาดใหญ่ เพื่อให้ระบบทำงานได้ต่อเนื่องในระดับคลาวด์ Google เพิ่ม TPU 8tx และ TPU 8i Max เข้าสู่ตระกูลเจเนอเรชันที่ 8 โดยมี TPU 8t สำหรับการฝึกขนาดใหญ่ และ TPU 8i สำหรับการให้เหตุผลที่ต้องการความหน่วงต่ำ รวมเป็นสี่ระบบที่แบ่งงานตามวงจรของ AI Agent
จังหวะนี้ไม่ใช่แค่การเพิ่มชิปอีกสองรุ่น แต่เป็นการตอบโจทย์ที่เกิดขึ้นเมื่อองค์กรเริ่มนำ Agent อัตโนมัติมาใช้จริง ทั้งการคุ้มครองข้อมูลระหว่างประมวลผลและการจัดการบริบทระดับล้านโทเค็น เมื่อ Agent ต้องเรียกใช้เครื่องมือหลายขั้นตอนและรักษาสถานะระหว่างงาน โครงสร้างพื้นฐาน AI จึงต้องรองรับทั้งกำลังคำนวณ หน่วยความจำ และเครือข่าย ไม่ใช่พึ่งความเร็วของชิปเพียงอย่างเดียว
ภาพรวมของรุ่นเดิมช่วยอธิบายทิศทางนี้ได้ชัด TPU 8t เน้นเพิ่มผลลัพธ์จากการฝึกต่อพลังงานหนึ่งวัตต์ ส่วน TPU 8i มุ่งลดข้อจำกัดหน่วยความจำและความหน่วงในการสื่อสารระหว่างชิป ซึ่งมีรายงานว่าลดได้สูงสุดครึ่งหนึ่ง Google ระบุว่าประสิทธิภาพการฝึกของเจเนอเรชันนี้สูงขึ้นถึง 2.7 เท่า และความคุ้มค่าต่อราคาดีขึ้น 80% เมื่อเทียบกับรุ่นก่อนหน้า ตัวเลขเหล่านี้เป็นคำกล่าวอ้างของผู้พัฒนา แต่สะท้อนการแข่งขันที่ย้ายจากการฝึกโมเดลอย่างเดียวไปสู่การให้บริการ Agent อย่างมีประสิทธิภาพ
TPU 8tx แลกความเร็วกับการคุ้มครองข้อมูลระหว่างประมวลผล
TPU 8tx ตอบโจทย์หน่วยงานภาครัฐและองค์กรที่อยู่ภายใต้ข้อกำกับสูง ซึ่งต้องใช้โมเดลขั้นสูงหรือโมเดลเฉพาะภายในควบคู่กับข้อมูลอ่อนไหว จุดสำคัญคือการรักษาความลับในช่วงที่ข้อมูลกำลังถูกคำนวณ เพราะข้อมูลที่เข้ารหัสขณะจัดเก็บหรือส่งผ่านเครือข่ายยังต้องถูกถอดรหัสในหน่วยความจำเพื่อให้โมเดลทำงาน
ระบบนี้ใช้สถาปัตยกรรมเดียวกับ TPU 8t ทำงานร่วมกับหน่วยประมวลผลหลักจาก AMD ที่ปรับแต่งเป็นพิเศษ และเพิ่มการปกป้องระดับฮาร์ดแวร์เพื่อแยกข้อมูลสำคัญรวมถึงค่าน้ำหนักของโมเดลระหว่างประมวลผล นี่เป็นความต่างเชิงบทบาทจาก TPU 8t ซึ่งเน้นกำลังฝึกโดยตรง: รุ่น 8tx พยายามรวมการฝึกหรือปรับแต่งโมเดลเข้ากับการประมวลผลแบบรักษาความลับในระบบเดียว
อีกด้านหนึ่ง เครือข่าย Boardfly ที่มีความหน่วงต่ำช่วยให้ Agent ทำงานหลายขั้นตอนได้ต่อเนื่อง โดยลดความหน่วงลง 2 เท่าเมื่อเทียบกับ TPU 8t โดยแทบไม่กระทบประสิทธิภาพโดยรวม สำหรับธุรกิจที่ข้อมูลห้ามรั่วไหล การมีชิปที่ออกแบบมารองรับเงื่อนไขนี้อาจช่วยเปิดทางให้ใช้ Agent กับงานจริงได้มากขึ้น อย่างไรก็ตาม คุณค่าของระบบจะขึ้นอยู่กับการจัดการสิทธิ์และซอฟต์แวร์ทั้งชุด ไม่ใช่คุณสมบัติฮาร์ดแวร์เพียงข้อเดียว
TPU 8i Max เพิ่มพื้นที่ให้ Agent คิดและเก็บบริบท
TPU 8i Max มุ่งไปยังปัญหาอีกด้าน คือการรันงานที่ต้องใช้บริบทขนาดใหญ่ต่อเนื่อง เช่น Agent ที่ต้องอ่านเอกสารจำนวนมาก จดจำสถานะ และเรียกข้อมูลเดิมกลับมาใช้ รุ่นนี้เพิ่มกำลังประมวลผล หน่วยความจำ SRAM และแบนด์วิดท์ HBM เป็น 2 เท่าเมื่อเทียบกับ TPU 8i อีกทั้งรองรับการติดตั้งชิปได้มากขึ้นถึง 2 เท่าในพื้นที่แร็กขนาดเดิม จึงเน้นความหนาแน่นในการประมวลผลและการรองรับหน้าต่างบริบทมหาศาล มากกว่าการคุ้มครองข้อมูลแบบ 8tx
ความแตกต่างนี้สำคัญต่อการใช้งานจริง เพราะการฝึกโมเดลกับการให้บริการ Agent มีรูปแบบภาระงานไม่เหมือนกัน TPU 8t รองรับการฝึกขยายขนาด ส่วน TPU 8i เน้นการให้เหตุผลที่ตอบสนองเร็ว ขณะที่ 8i Max เพิ่มทรัพยากรให้การรันงานบริบทใหญ่ และ 8tx เพิ่มชั้นความลับให้การประมวลผล การมีตัวเลือกหลายแบบทำให้ลูกค้าไม่จำเป็นต้องเลือกชิปที่เก่งทุกอย่าง แต่ยังต้องออกแบบการจัดสรรงานให้เหมาะกับแต่ละขั้น
Google ยังชี้ว่าคอขวดไม่ได้อยู่ที่ชิปเท่านั้น แต่รวมถึงหน่วยความจำ พื้นที่จัดเก็บ และเครือข่าย จึงพัฒนา TPU Sync ให้จัดชั้นทรัพยากรเหล่านี้เป็นระบบเดียว และช่วยย้ายแคชบริบทขนาดใหญ่ระหว่างส่วนต่าง ๆ ของคลัสเตอร์ หาก Agent ต้องใช้บริบทระดับล้านโทเค็น การประสานข้อมูลระหว่างชิปกับระบบจัดเก็บจึงเป็นเงื่อนไขสำคัญพอ ๆ กับจำนวนหน่วยประมวลผล
ซอฟต์แวร์และการจัดการคลัสเตอร์เป็นตัวตัดสินการใช้งานวงกว้าง
การขยายชิปจะมีความหมายก็ต่อเมื่อนักพัฒนาเข้าถึงได้ Google เปิดซอร์ส TorchTPU เพื่อให้โค้ด PyTorch และโมเดลจาก Hugging Face ทำงานบน TPU ได้โดยตรง พร้อมแบ็กเอนด์สำหรับเครื่องมือให้บริการโมเดลอย่าง vLLM และ SGLang ชุดเครื่องมือ TPU Agent ซึ่งยังอยู่ในช่วงทดลอง สามารถช่วยตั้งค่าระบบ ตรวจหาคอขวด และปรับแต่งเคอร์เนลผ่านเครื่องมือเขียนโค้ดที่รองรับ นี่เป็นประโยชน์ต่อทีมพัฒนาที่ไม่ต้องเริ่มจากการเขียนระบบใหม่ทั้งหมด แต่ความง่ายในการเริ่มต้นยังต้องพิสูจน์ด้วยการใช้งานจริง
เมื่อ Agent หยุดรอฐานข้อมูล เครื่องมือภายนอก หรือคำตอบจากมนุษย์ การปล่อยทรัพยากรคำนวณให้ว่างค้างไว้ย่อมสิ้นเปลือง Google จึงมี Agent Compute Engine สำหรับพักและเรียกคืนเซสชันที่ไม่ได้ใช้งานโดยอัตโนมัติ ส่วน Cloud Pathways เปิดให้ใช้งานทั่วไปบน Google Kubernetes Engine เพื่อจัดการเวิร์กโหลด TPU ขนาดใหญ่จากตัวควบคุมเดียว ทั้งสองแนวทางชี้ว่าโครงสร้างพื้นฐาน AI สำหรับ Agent ต้องบริหารเวลาว่าง หน่วยความจำ และคลัสเตอร์ควบคู่กัน
ข้อสรุปคือ TPU 8tx และ TPU 8i Max ไม่ได้มาแทน TPU 8t หรือ TPU 8i แต่เติมช่องว่างด้านความลับและบริบทขนาดใหญ่ให้ระบบครบวงจรขึ้น การขยาย AI Agent จึงไม่ได้ขึ้นกับโมเดลที่ฉลาดกว่าเพียงอย่างเดียว หากฮาร์ดแวร์ ซอฟต์แวร์ และการจัดการทรัพยากรไม่สอดคล้องกัน Agent ก็ย่อมติดคอขวดก่อนสร้างประโยชน์ได้เต็มที่