
Gemini Live คืออะไร และใครควรใช้
Gemini Live คือชุดโมเดลเสียงต่อเสียงที่เปิดให้ใช้ผ่าน Gemini Live voice API สำหรับสร้าง real-time audio applications ที่ผู้ใช้สนทนาด้วยเสียงกับปัญญาประดิษฐ์ได้อย่างต่อเนื่อง โดยสามารถเลือกเสียงระบบ กำหนด system prompt และเริ่มสนทนาผ่านเบราว์เซอร์ได้ทันที รวมถึงหยุดการพูดของโมเดลระหว่างทางเพื่อแทรกคำถามใหม่ได้ด้วย เหมาะกับนักพัฒนาหรือ power user ที่ต้องการทำ voice conversation AI สำหรับงานประชุม งานบริการลูกค้า หรือเครื่องมือช่วยเรียนรู้แบบโต้ตอบ โดยไม่ต้องเขียนระบบเสียงซับซ้อนเอง
จุดเด่นคือตัวโมเดล Gemini 3.8 Live และ 3.8 Live Extended Thinking ที่ถูกเพิ่มเข้ามาใน Gemini API เพื่อช่วยให้สร้างประสบการณ์ผลิตภัณฑ์แบบเน้นเสียงและเรียลไทม์ได้ โมเดล 3.8 Live เป็นโมเดล speech-to-speech ที่สามารถทำงานและรักษาบทสนทนาไปพร้อมกัน ในขณะที่โหมด Extended Thinking ถูกออกแบบมาสำหรับคำขอที่ซับซ้อน ให้การคิดวิเคราะห์ลึกขึ้นและติดอันดับบนตารางเปรียบเทียบด้าน speech-to-speech จึงตอบโจทย์คนที่อยากให้แอปเสียงของตนรองรับคำถามยากหรือกระบวนการหลายขั้นตอน
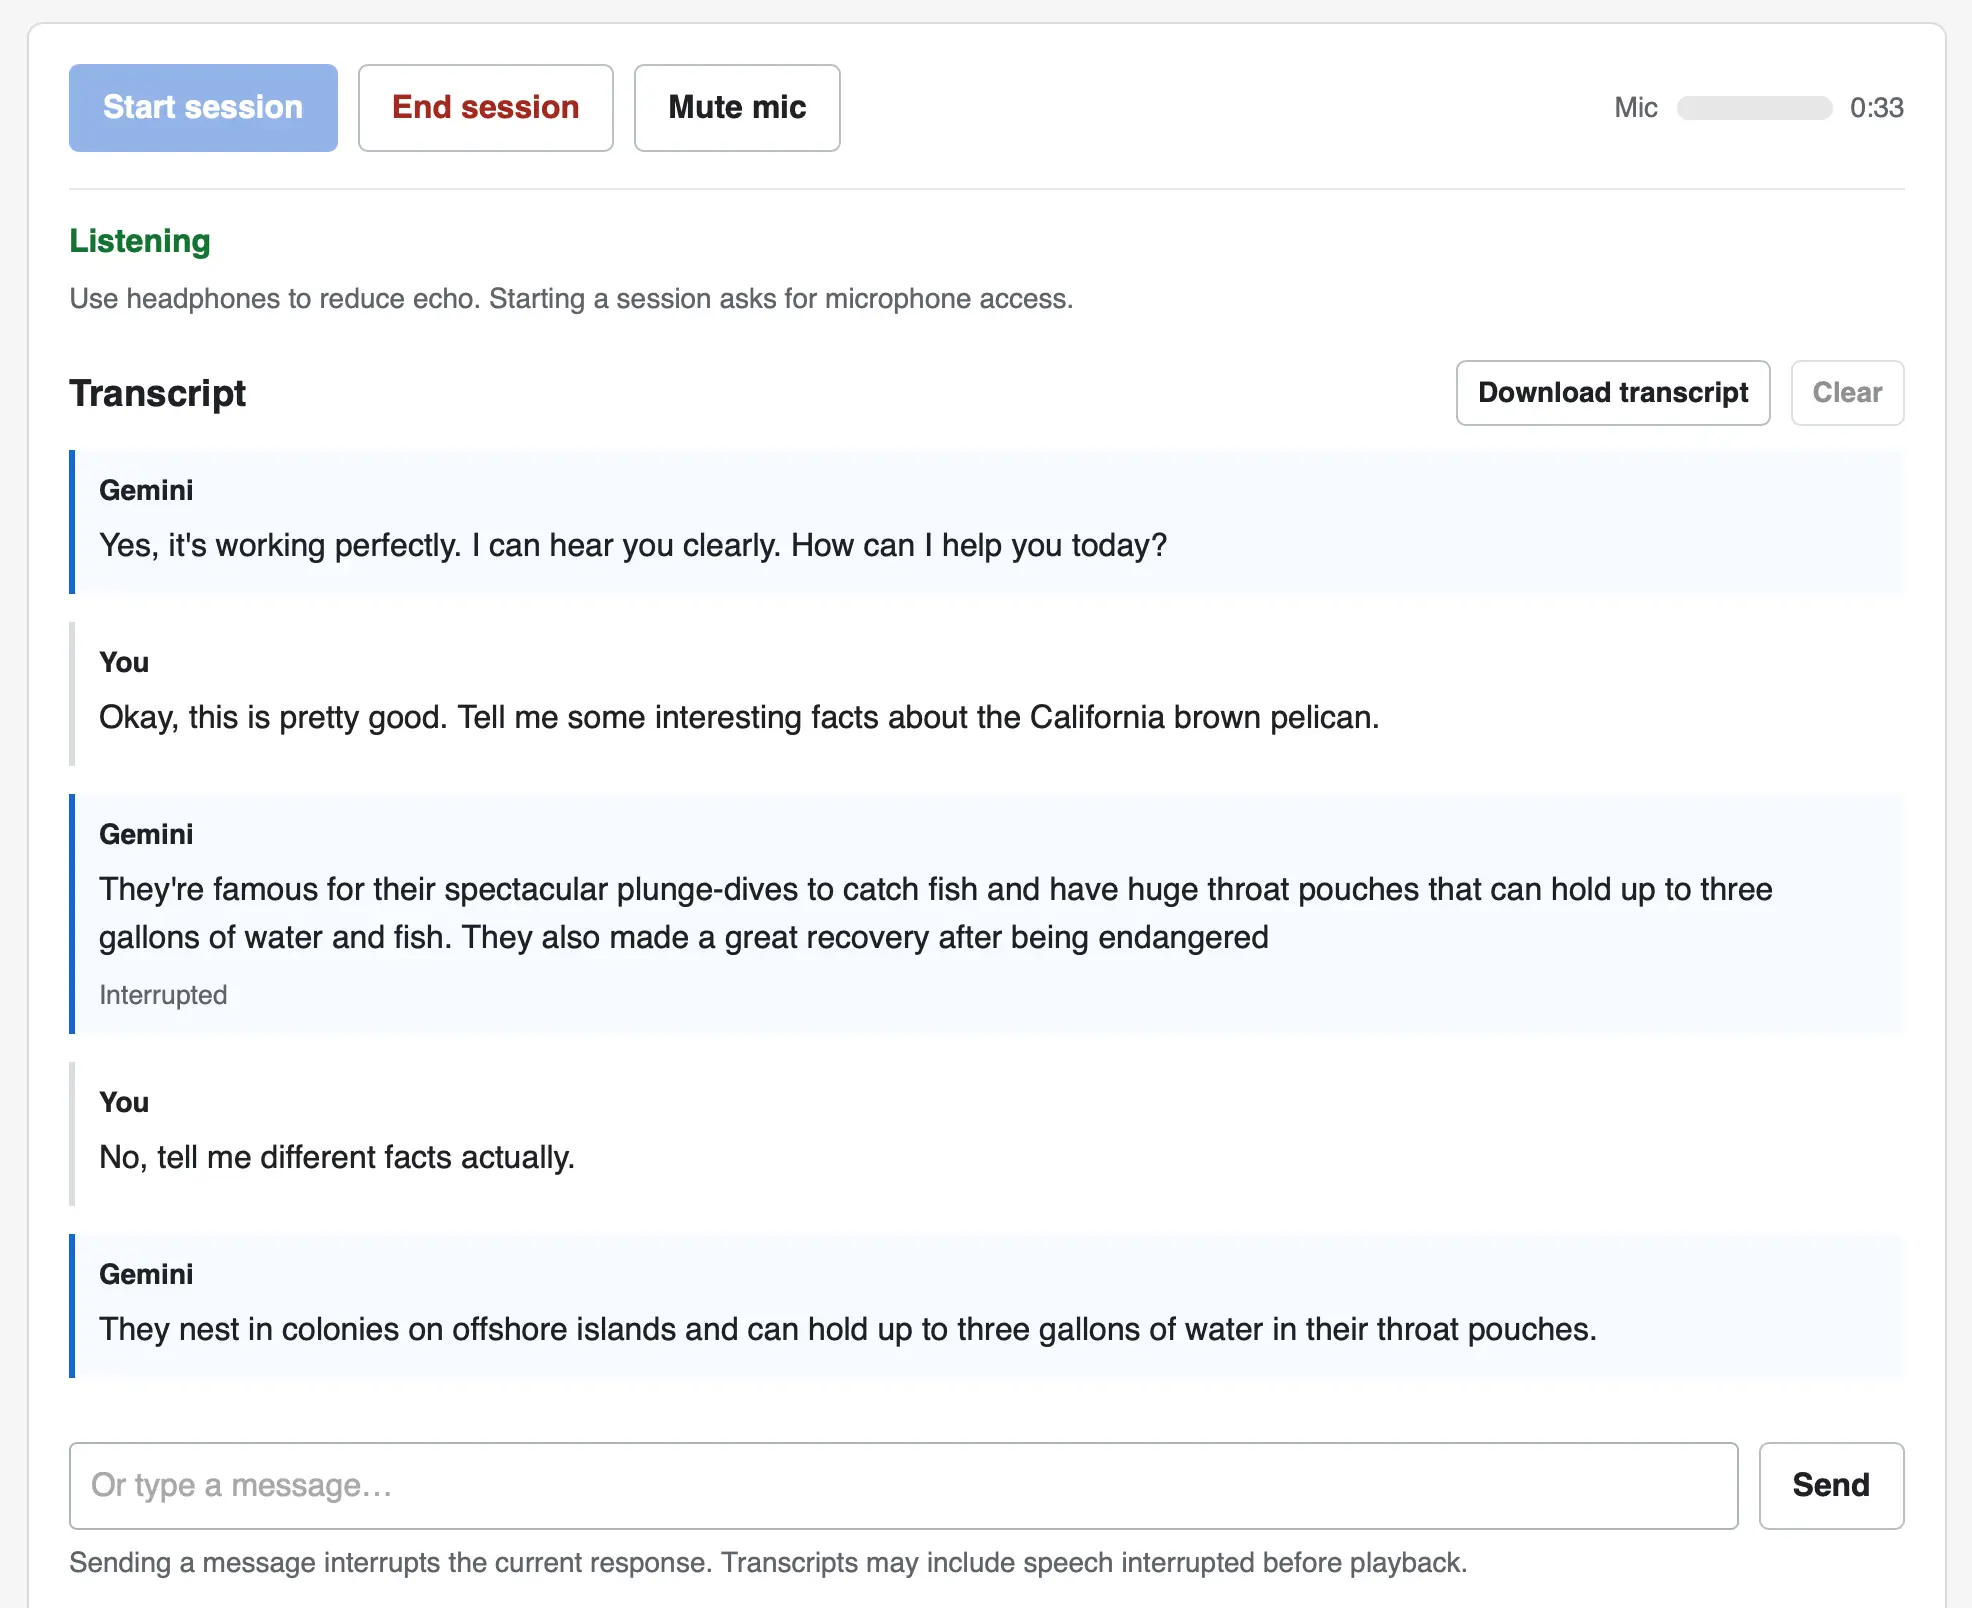
ทำความเข้าใจกับ Gemini Live voice API และโครงสร้างระบบเสียง
ก่อนเริ่มลงมือเขียนโค้ด ควรเข้าใจว่า Gemini Live voice API ทำงานอย่างไรในภาพรวม API นี้เปิดให้เชื่อมต่อผ่าน WebSocket ไปยังปลายทาง wss ของบริการ generative language เมื่อเชื่อมต่อแล้วฝั่งไคลเอนต์จะส่งข้อมูลเสียงขึ้นไปและรับเสียงตอบกลับจากโมเดลแบบสองทางในช่องทางเดียว ทำให้เหมาะมากสำหรับ voice conversation AI ที่ต้องตอบโต้เร็วและต่อเนื่องโดยไม่ต้องสร้างเซสชันหลายเส้นทางเอง
ตัวอย่างการใช้งานหนึ่งในบทความอธิบายว่าเว็บไคลเอนต์ที่ทดลองโมเดล Gemini Live เชื่อมต่อกับปลายทาง WebSocket wss://generativelanguage.googleapis.com/ws/google.ai.generativelanguage.v1alpha.GenerativeService.BidiGenerateContent?key=... และใช้ Web Audio API ผ่าน AudioContext สำหรับรับเสียงจากไมโครโฟนและเล่นเสียงตอบกลับ หมายความว่าหากคุณพัฒนาเว็บ คุณสามารถทำทุกอย่างได้ด้วย JavaScript และ Web Audio API โดยไม่ต้องดึงไลบรารีเสียงภายนอก สิ่งที่ต้องเตรียมคือคีย์สำหรับ Gemini API และความเข้าใจพื้นฐานเรื่อง WebSocket
ขั้นตอนสร้างเว็บสนทนาด้วยเสียงแบบเรียลไทม์ด้วย Gemini Live
ในส่วนนี้จะเป็นขั้นตอนลงมือทำทีละข้อในมุมของนักพัฒนาที่ต้องการสร้างแอปสนทนาด้วยเสียงผ่านเว็บ สิ่งที่ควรระวังคือการจัดการสตรีมเสียงให้ตรงกับอัตราตัวอย่าง การดูแลการเชื่อมต่อ WebSocket และการออกแบบประสบการณ์ผู้ใช้ให้สามารถขัดจังหวะโมเดลระหว่างตอบได้ เพราะหนึ่งในจุดขายคือผู้ใช้สามารถแทรกคำถามใหม่ระหว่างที่โมเดลกำลังพูดอยู่ หากไม่ออกแบบฝั่งไคลเอนต์ให้ดี ฟีเจอร์สำคัญนี้อาจใช้ได้ไม่ลื่น
- ขอและตั้งค่า API key สำหรับ Gemini API จากนั้นเตรียมค่า key และตั้งค่าด้านความปลอดภัยให้เก็บ key ไว้ฝั่งเซิร์ฟเวอร์แล้วส่ง token ชั่วคราวไปให้เว็บไคลเอนต์ใช้เชื่อมต่อ
- สร้างหน้าเว็บพื้นฐานด้วย HTML และ JavaScript พร้อมปุ่มเริ่มสนทนา ปุ่มหยุด และตัวเลือกโมเดล เช่น Gemini 3.8 Live หรือ 3.8 Live Extended Thinking ตามความซับซ้อนของงานที่ต้องการ
- ใน JavaScript เปิดการเชื่อมต่อ WebSocket ไปยังปลายทาง wss ของบริการ generative language โดยแนบ token หรือ key ที่เตรียมไว้ และเตรียม handler สำหรับเหตุการณ์เปิด ปิด และรับข้อความจากเซิร์ฟเวอร์
- ใช้ Web Audio API สร้าง AudioContext เพื่อรับเสียงจากไมโครโฟนผ่าน getUserMedia แล้วเข้ารหัสเสียงให้อยู่ในรูปแบบที่สอดคล้องกับโปรโตคอลของ Gemini Live ก่อนส่งแพ็กเก็ตเสียงผ่าน WebSocket
- เมื่อได้รับข้อมูลตอบกลับจาก WebSocket ให้ตรวจแยกส่วนที่เป็นเสียงและข้อความ จากนั้นใช้ AudioContext อีกอินสแตนซ์หรือ node ที่เกี่ยวข้องในการเล่นเสียงตอบกลับ และหากมีข้อความก็แสดงบนหน้าจอเพื่อเป็น subtitle
- เพิ่มปุ่มหรือ gesture สำหรับหยุดการพูดของโมเดล เช่น ปุ่ม interrupt หรือการกดคีย์ลัด เมื่อผู้ใช้กดให้ส่งสัญญาณผ่าน WebSocket ไปยุติการสร้างเสียงของโมเดล เพื่อเปิดทางให้ผู้ใช้พูดประโยคใหม่ทันที
- ทดสอบกรณีเครือข่ายหลุดหรือดีเลย์ และปรับกลยุทธ์ reconnection รวมถึงการแจ้งผู้ใช้เมื่อการสนทนาถูกขัดจังหวะ เพื่อให้ real-time audio applications ของคุณเชื่อถือได้ในสภาพแวดล้อมจริง
แม้ขั้นตอนจะดูตรงไปตรงมา แต่จุดที่มักสะดุดคือการจัดแพ็กเก็ตเสียงให้ตรงกับสิ่งที่เซิร์ฟเวอร์คาดหวัง และการจัดการสถานะเมื่อผู้ใช้ interrupt โมเดลกลางคัน เพื่อให้เสียงไม่ซ้อนหรือหลุดเฟรม การทดสอบหลายรอบด้วยรูปแบบคำถามต่างกันและความยาวประโยคต่างกันจะช่วยให้คุณได้แอปที่สนทนาได้ลื่นและตอบสนองได้ใกล้เคียงการพูดคุยกันจริง
ใช้ Extended Thinking กับงานซับซ้อน และมุมมองด้านการออกแบบประสบการณ์
เมื่อคุณต้องรองรับคำถามที่มีหลายเงื่อนไขหรือหลายขั้นตอน เช่น การวางแผนงาน การช่วยตัดสินใจ หรือการสรุปประเด็นยาว การใช้โหมด 3.8 Live Extended Thinking จะช่วยเปิดทางให้โมเดลคิดวิเคราะห์ลึกขึ้นสำหรับคำขอที่ซับซ้อน โดยโหมดนี้ถูกอธิบายว่าให้การให้เหตุผลที่ลึกมากขึ้นและขึ้นอันดับหนึ่งบนตารางเปรียบเทียบ speech-to-speech ของ Artificial Analysis การเลือกใช้โหมดนี้จึงเหมาะกับสถานการณ์ที่คุณยอมแลกทรัพยากรประมวลผลกับคุณภาพการตอบที่คิดมากขึ้น
ในมุมการออกแบบประสบการณ์ผู้ใช้ ควรคิดว่าการสนทนาด้วยเสียงต่างจากข้อความอย่างไร เสียงช่วยลดแรงเสียดทานในการใช้งานเมื่อผู้ใช้กำลังขับรถ ทำงานบ้าน หรืออยู่ในสถานการณ์ที่พิมพ์ข้อความไม่สะดวก ในขณะเดียวกันเสียงก็ต้องจัดการกับสภาพแวดล้อมจริง เช่น เสียงรบกวน การพูดแทรก และการเปลี่ยนหัวข้อกะทันหัน คุณจึงควรออกแบบสถานะของการสนทนา เช่น การแจ้งเตือนเมื่อโมเดลกำลังคิดใน Extended Thinking การบอกผู้ใช้เมื่อระบบหยุดฟัง หรือเมื่อการเชื่อมต่อ WebSocket หลุด เพื่อให้ผู้ใช้รู้สึกว่ากำลังพูดคุยกับตัวช่วยที่ควบคุมได้ ไม่ใช่กล่องดำ
สรุป: คุ้มค่าหรือไม่ และสิ่งที่ควรจับตา
การใช้ Gemini Live voice API ช่วยให้นักพัฒนาสามารถสร้างแอปสนทนาด้วยเสียงแบบเรียลไทม์บนเว็บได้โดยไม่ต้องสร้างโครงสร้างพื้นฐานเสียงเอง คุณมีโมเดล Gemini 3.8 Live ที่รองรับการสนทนาต่อเนื่องและทำงานไปพร้อมกัน และโหมด Extended Thinking สำหรับงานที่ซับซ้อนมากขึ้น ในขณะเดียวกันฝั่งไคลเอนต์เพียงเชื่อม WebSocket ไปยังปลายทางของบริการ generative language และใช้ Web Audio API ผ่าน AudioContext เพื่อรับและเล่นเสียง ผลลัพธ์คือ voice conversation AI ที่เริ่มจากเบราว์เซอร์ทั่วไป และเปิดพื้นที่ไปสู่แอปประชุม แอปบริการลูกค้า หรือเครื่องมือเรียนรู้แบบเสียงที่ตอบสนองได้ทันที
สิ่งที่ควรจับตาคือการเปลี่ยนแปลงของโปรโตคอล WebSocket และตัวเลือกโมเดลใน Gemini API รวมถึงการเพิ่มเติมเครื่องมืออย่าง Gemini Live tutorial ที่ช่วยให้เข้าใจ API ได้ชัดขึ้น หากคุณเริ่มลงมือทดลองตั้งแต่ตอนนี้ คุณจะมีเวลาออกแบบประสบการณ์เสียงและปรับแต่งแอปให้เหมาะกับผู้ใช้กลุ่มของคุณ ก่อนที่โลกของ real-time audio applications จะกลายเป็นมาตรฐานในหลายบริการดิจิทัล