
LFM3 ทำให้การประมวลผลบนอุปกรณ์ใกล้ตัวขึ้น
โมเดล AI ขนาดเล็ก คือโมเดลที่ลดจำนวนพารามิเตอร์และความต้องการทรัพยากรลง เพื่อให้ทำงานได้บนอุปกรณ์ทั่วไป แทนการพึ่งพาระบบประมวลผลขนาดใหญ่เพียงอย่างเดียว โดยยังรองรับงานเฉพาะด้านได้
Liquid AI เปิดตัว LFM3 เมื่อวันที่ 27 ตุลาคม 2026 โดยเป็น open-weight model จำนวน 6 รุ่นในกลุ่มพารามิเตอร์ 2B ซึ่งต่อยอดจากโครงข่ายหลักเดียวกัน รุ่นต่าง ๆ ครอบคลุมข้อความ ภาพ วิดีโอ และเสียง ตั้งแต่โมเดลข้อความ ไปจนถึง LFM3-Omni-2B ที่รับข้อความ ภาพ วิดีโอ และเสียง แล้วตอบกลับได้ทั้งข้อความและเสียงพูด จุดขายสำคัญคือโมเดลข้อความมีพารามิเตอร์ 1.73B ใช้หน่วยความจำประมาณ 1 GB เมื่อทำงานที่ความละเอียด 4 บิต และรองรับบริบท 256K โทเคน นี่คือแนวทาง multimodal edge device ที่มุ่งให้ประมวลผลบนอุปกรณ์ได้จริง ไม่ใช่แค่ลดขนาดโมเดลบนกระดาษ
เหตุผลที่การเปิดตัวครั้งนี้น่าสนใจคือทีมพัฒนาออกแบบสถาปัตยกรรมโดยทดสอบร่วมกับฮาร์ดแวร์ เพื่อรองรับงานตัวแทนอัจฉริยะและบริบทยาว พร้อมระบุว่า LFM3-1.7B ทำผลงานเหนือกว่า LFM2.5-2.6B โดยใช้พารามิเตอร์น้อยลง 35% โมเดลรองรับการปรับแต่งด้วยข้อมูลเฉพาะทางบน GPU เพียงตัวเดียว และออกแบบให้ติดตั้งบนอุปกรณ์ได้ รวมถึงมีการจับคู่กับอุปกรณ์และระบบประมวลผล 14 รูปแบบ นี่ทำให้ LFM3 ดูเป็นเครื่องมือที่นักพัฒนานำไปทดลองกับงานจริงได้ มากกว่าเป็นเพียงโมเดลสาธิต
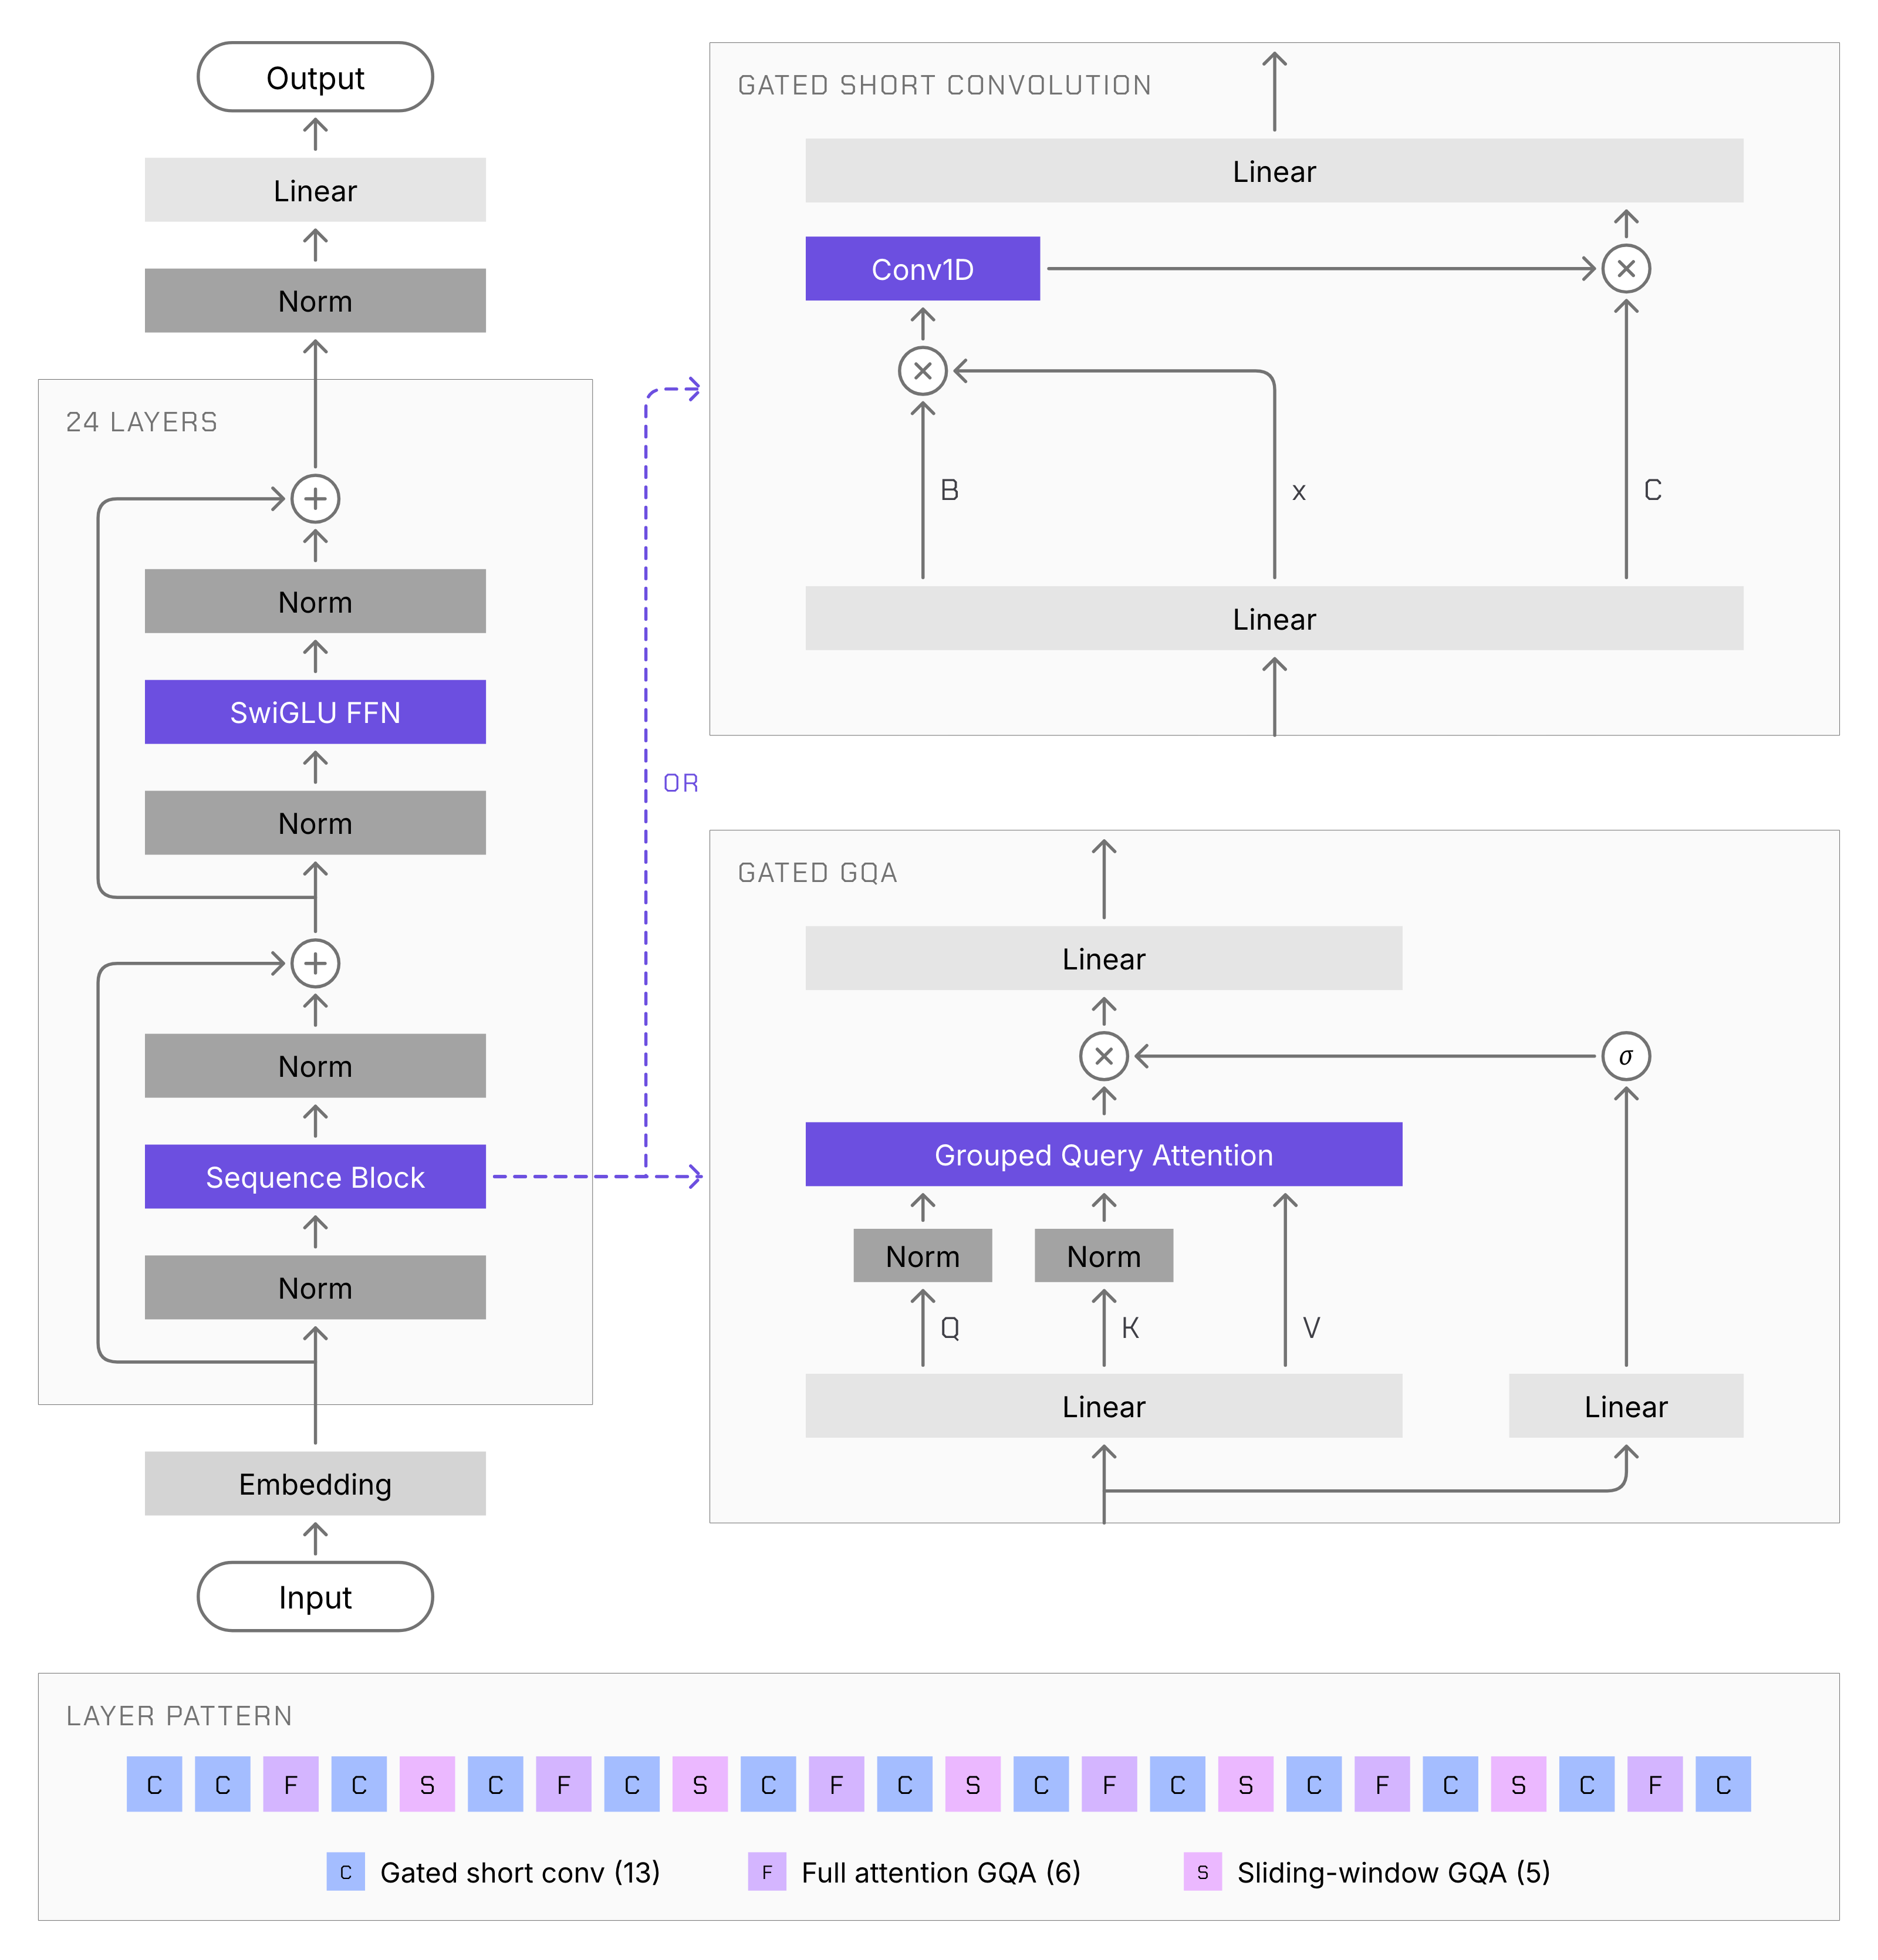
d3-ultra เน้นตัดสินใจ ไม่ได้แข่งเป็นโมเดลขนาดจิ๋ว
d3-ultra ของทีม vLLM Semantic Router เป็น open-weight model ขนาด 27B ภายใต้สัญญาอนุญาต Apache-2.0 ออกแบบมาเพื่อการตัดสินใจจากข้อมูลหลายรูปแบบ ไม่ใช่การสร้างข้อความทั่วไป ระบบรับสถานะที่เป็นข้อความหรือข้อมูล JSON พร้อมภาพหรือวิดีโอ แล้วประเมินชุดคำถามด้วยการส่งค่าความน่าจะเป็นสำหรับคำตอบ วิธีอ่านอินพุตครั้งเดียวแล้วตอบหลายคำถามเหมาะกับงานจัดหมวดหมู่ การกำหนดเส้นทางคำขอ การระบุตำแหน่งในภาพ และการตรวจวิดีโอ จึงมีบทบาทต่างจาก LFM3 ที่เน้นการนำความสามารถหลากหลายไปใช้บนอุปกรณ์ขนาดเล็ก
การเทียบสองรุ่นนี้จึงต้องแยกคำว่าโมเดลขนาดเล็กออกจากโมเดลหลายรูปแบบ d3-ultra มีบริบท 131,072 โทเคน แต่ข้อมูลการทดสอบระบุการใช้การ์ดประมวลผล AMD Instinct MI325X หนึ่งตัวกับน้ำหนักแบบ BF16 และยังไม่มีการระบุรุ่นที่ผ่านการบีบอัดอย่างเป็นทางการ ตัวเลขเหล่านี้ชี้ว่า d3-ultra มีความสามารถด้านการตัดสินใจที่น่าสนใจ แต่ไม่ควรเหมารวมว่าเป็นโมเดลสำหรับอุปกรณ์ทรัพยากรต่ำแบบเดียวกับ LFM3 การวางบทบาทให้ถูกงานสำคัญกว่าการดูเพียงคำว่า multimodal
เดิมพันที่แท้จริงคือเลือกขนาดให้ตรงงาน
LFM3 แสดงให้เห็นทิศทางของ AI ประหยัดต้นทุนในแง่การลดข้อกำหนดด้านหน่วยความจำและเปิดทางให้ปรับแต่งโมเดลด้วย GPU เพียงตัวเดียว ขณะที่ตัวเข้ารหัสภาพของโมเดล LFM VL ใช้การประมวลผลน้อยกว่า SigLIP2 ถึง 3 เท่า อย่างไรก็ดี ข้อมูลนี้ไม่ได้แปลว่าทุกงานจะทำงานได้ดีบนอุปกรณ์ทุกรุ่น ผู้ใช้ยังต้องเลือกโมเดลให้ตรงกับข้อมูลนำเข้าและข้อจำกัดของอุปกรณ์ จุดแข็งของ open-weight model คือเปิดให้ทีมพัฒนาปรับใช้และทดสอบกับข้อมูลของตน โดยไม่ต้องเริ่มจากการฝึกโมเดลขนาดใหญ่ทั้งระบบ
ภาพรวมจึงไม่ใช่การแข่งขันว่าโมเดลใดเก่งที่สุด แต่เป็นการแบ่งงานให้เหมาะกับทรัพยากร LFM3 เหมาะกับผู้ที่ต้องการประมวลผลบนอุปกรณ์และเลือกความสามารถด้านข้อความ ภาพ หรือเสียงตามโจทย์ ส่วน d3-ultra เหมาะกับงานตัดสินใจที่ต้องอ่านภาพหรือวิดีโอร่วมกับข้อความ และให้ผลเป็นคะแนนความน่าจะเป็น การมีโมเดลให้เลือกหลายระดับเป็นพัฒนาการที่มีคุณค่า แต่ผู้ใช้ควรพิจารณาความต้องการด้านหน่วยความจำและการประมวลผลจริงก่อนนำไปใช้งาน ข้อสรุปคือ LFM3 เป็นก้าวที่ชัดเจนของโมเดลขนาดเล็กสำหรับอุปกรณ์ ส่วน d3-ultra เป็นเครื่องมือเฉพาะทางที่มีขนาดและภาระประมวลผลอีกระดับ