
เลือกรุ่นที่ทำงานไหว ไม่ใช่รุ่นที่ใหญ่ที่สุด
โมเดล AI ขนาดเล็กคือโมเดลภาษาที่ใช้ทรัพยากรน้อยพอให้ทำงานบนคอมพิวเตอร์ส่วนตัว แต่ยังตอบโจทย์งานที่กำหนดได้สม่ำเสมอ โดยเหลือหน่วยความจำและกำลังประมวลผลให้เครื่องใช้งานด้านอื่นต่อไปได้ด้วย นี่คือเกณฑ์ที่มีประโยชน์กว่าการถามว่าโมเดลเล็กแค่ไหน เพราะตัวเลขพารามิเตอร์เพียงอย่างเดียวไม่ได้บอกว่าจะรันได้เร็วหรือเหลือพื้นที่ให้โปรแกรมอื่นหรือไม่
หากมีการ์ดจอสำหรับ AI ระดับเริ่มต้น การพยายามยัดโมเดลแทน ChatGPT ลงเครื่องมักเป็นเป้าหมายที่ผิด แล็ปท็อปที่มีแรมการ์ดจอ 4 GB และแรมระบบ 16 GB ไม่เหมาะกับการทำสำเนาประสบการณ์แบบนั้น แต่ยังอาจรันผู้ช่วยขนาดเล็กเพื่อจัดการคำขอทั่วไปโดยไม่ส่งทุกอย่างขึ้นคลาวด์ได้ การรัน LLM ในเครื่องจึงควรเริ่มจากงานเฉพาะ เช่น แปลงข้อมูลเป็นรูปแบบที่กำหนด เรียกใช้เครื่องมือ หรือช่วยงานประจำ มากกว่าคาดหวังให้ตอบได้รอบด้านเท่าโมเดลขนาดใหญ่
ประเมินจากหน่วยความจำและงานจริง
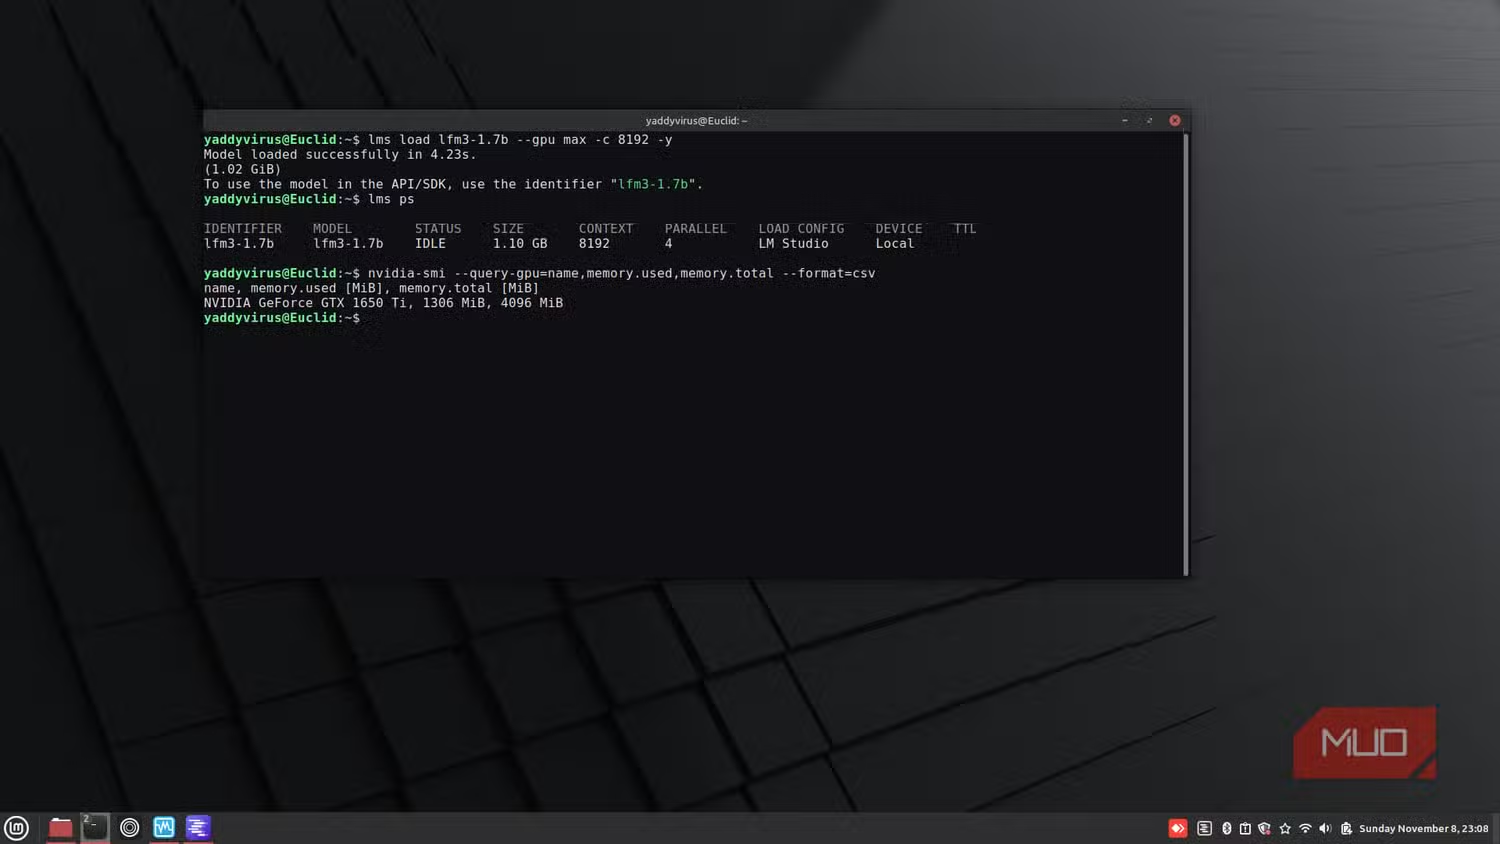
ก่อนดาวน์โหลด ให้ดูขนาดไฟล์หลังควอนไทซ์ ไม่ใช่แค่จำนวนพารามิเตอร์ และเผื่อพื้นที่ให้แคช หน้าต่างบริบท และโปรแกรมที่เปิดพร้อมกันด้วย โมเดลที่น้ำหนักเกือบเต็มหน่วยความจำการ์ดจอตั้งแต่ต้นอาจโหลดได้ แต่ใช้งานจริงช้า หรือทำให้เครื่องอึดอัด จุดหมายไม่ใช่การใช้พื้นที่ให้เต็ม หากเป็นการเหลือพื้นที่พอให้ระบบตอบสนองได้
เริ่มจาก LFM3-1.7B สำหรับงานที่ต้องส่งออกข้อมูลมีโครงสร้าง โดยไฟล์ Q4_K_M มีขนาดประมาณ 1.1 GB และตัวโมเดลออกแบบมาสำหรับเอเจนต์ การเรียกใช้เครื่องมือ และงานเฉพาะทาง ไม่ใช่แชตบอตที่รู้ทุกเรื่อง แต่ไม่ควรเลือกไปทำงานเขียนโค้ดแบบหลายขั้นตอนหรือคำถามที่พึ่งความรู้รอบด้าน ส่วน MiniCPM5-2B เป็นตัวเลือกถัดไปเมื่ออยากได้การช่วยคิดหรือเขียนโค้ดในงานที่ตีกรอบชัด โดยน้ำหนัก Q4_K_M อยู่ราว 1.56 GB ตัวเลขคะแนนที่ผู้พัฒนารายงานไม่รับประกันผลเดียวกันกับรุ่นควอนไทซ์บนเครื่องของคุณ
- ใช้คำสั่งเดิมกับทุกรุ่น แล้วตรวจความถูกต้องของข้อเท็จจริงและรูปแบบ JSON
- ทดสอบให้โค้ดที่ได้ทำงานจริง พร้อมจับเวลาและบันทึกหน่วยความจำสูงสุด
- เลือกงานที่มีขอบเขตชัด และตรวจคำตอบด้วยวิธีที่เชื่อถือได้
- เพิ่มขนาดรุ่นหรือความสามารถในการคิดเมื่อคุณภาพของรุ่นเล็กไม่ผ่านเกณฑ์เท่านั้น
NVIDIA Dory 4B แสดงให้เห็นว่าขนาดไม่ใช่ต้นทุนทั้งหมด
NVIDIA Dory 4B เป็นตัวอย่างที่ชัดว่าการประเมินโมเดลไม่ได้จบที่ไฟล์น้ำหนัก ผู้ทดสอบใช้ไฟล์ GGUF รุ่น Q5_K_M ขนาด 3.7 GB และสร้าง llama-server จาก commit เฉพาะใน branch ที่รองรับ Dory เพราะการรองรับใน llama.cpp ขณะนั้นยังเป็นร่างคำขอเปลี่ยนแปลง ไม่มีรุ่นสำเร็จรูปที่โหลดโมเดลนี้ได้ การลองตามจึงมีภาระเพิ่มทั้งการสร้างซอฟต์แวร์และตรวจสอบสภาพแวดล้อม ไม่ใช่แค่ดาวน์โหลดแล้วเปิดใช้งาน
จุดเด่นของ Dory คือการเพิ่มจำนวนลูปผ่านเลเยอร์เพื่อใช้การคำนวณต่อโทเคนมากขึ้น โดยไม่เพิ่มพารามิเตอร์ และใช้ checkpoint เดียวในระดับงบคำนวณ 4 ระดับ นั่นเปิดทางให้ปรับสมดุลระหว่างความเร็วกับคุณภาพ แต่ลูปที่มากขึ้นย่อมมีต้นทุนการประมวลผลเพิ่ม การทดสอบที่มีประโยชน์จึงต้องวัดความเร็วการถอดรหัสทุกระดับ พร้อมเปรียบเทียบผลประเมิน GSM8K แบบจับคู่ ทั้งความแม่นยำ ความยาวคำตอบ และเวลาต่อคำถาม รวมถึงผลของการใช้แคชลูปสุดท้ายที่มีต้นทุนต่ำกว่า ข้อมูลที่ให้มายังไม่ระบุตัวเลขผลทดสอบ จึงไม่ควรสรุปว่าการเพิ่มลูปคุ้มเสมอ
ตัดสินจากเกณฑ์ผ่านงาน ไม่ใช่ความประทับใจ
การเลือกรุ่นที่เล็กพอควรเป็นการทดลองแบบเดียวกันทุกตัว เริ่มจาก LFM3-1.7B สำหรับงานมีโครงสร้าง MiniCPM5-2B สำหรับการให้เหตุผลที่ตีกรอบไว้ และพิจารณารุ่นอื่น เช่น Granite ที่ปรับระดับการคิดได้ หรือ Qwen เมื่อความสามารถที่กว้างขึ้นคุ้มกับภาระทรัพยากร จากนั้นใช้พรอมป์ต์จริงชุดเดียวกัน ตรวจความถูกต้อง รูปแบบผลลัพธ์ โค้ดที่ใช้งานได้ เวลาตอบสนอง และหน่วยความจำสูงสุด อย่าให้คำตอบที่อ่านลื่นกลบข้อผิดพลาด
ข้อสรุปคือเลือกโมเดลที่ผ่านเกณฑ์คุณภาพของงานซ้ำได้ และยังเหลือทรัพยากรให้เครื่องใช้งานตามปกติ หากต้องค้นข้อเท็จจริงจำนวนมาก ให้เสริมการค้นคืนข้อมูลแทนการคาดหวังให้โมเดลเล็กจำทุกเรื่อง หากต้องการผู้ช่วยในเครื่องสำหรับงานประจำ รุ่นเล็กอาจเป็นทางเลือกที่คุ้มกว่าไล่ซื้อฮาร์ดแวร์เพื่อรันโมเดลใหญ่ แต่ถ้าผลทดสอบบนงานของคุณไม่ผ่าน การลดขนาดต่อไปก็ไม่ใช่การประหยัดที่ดี