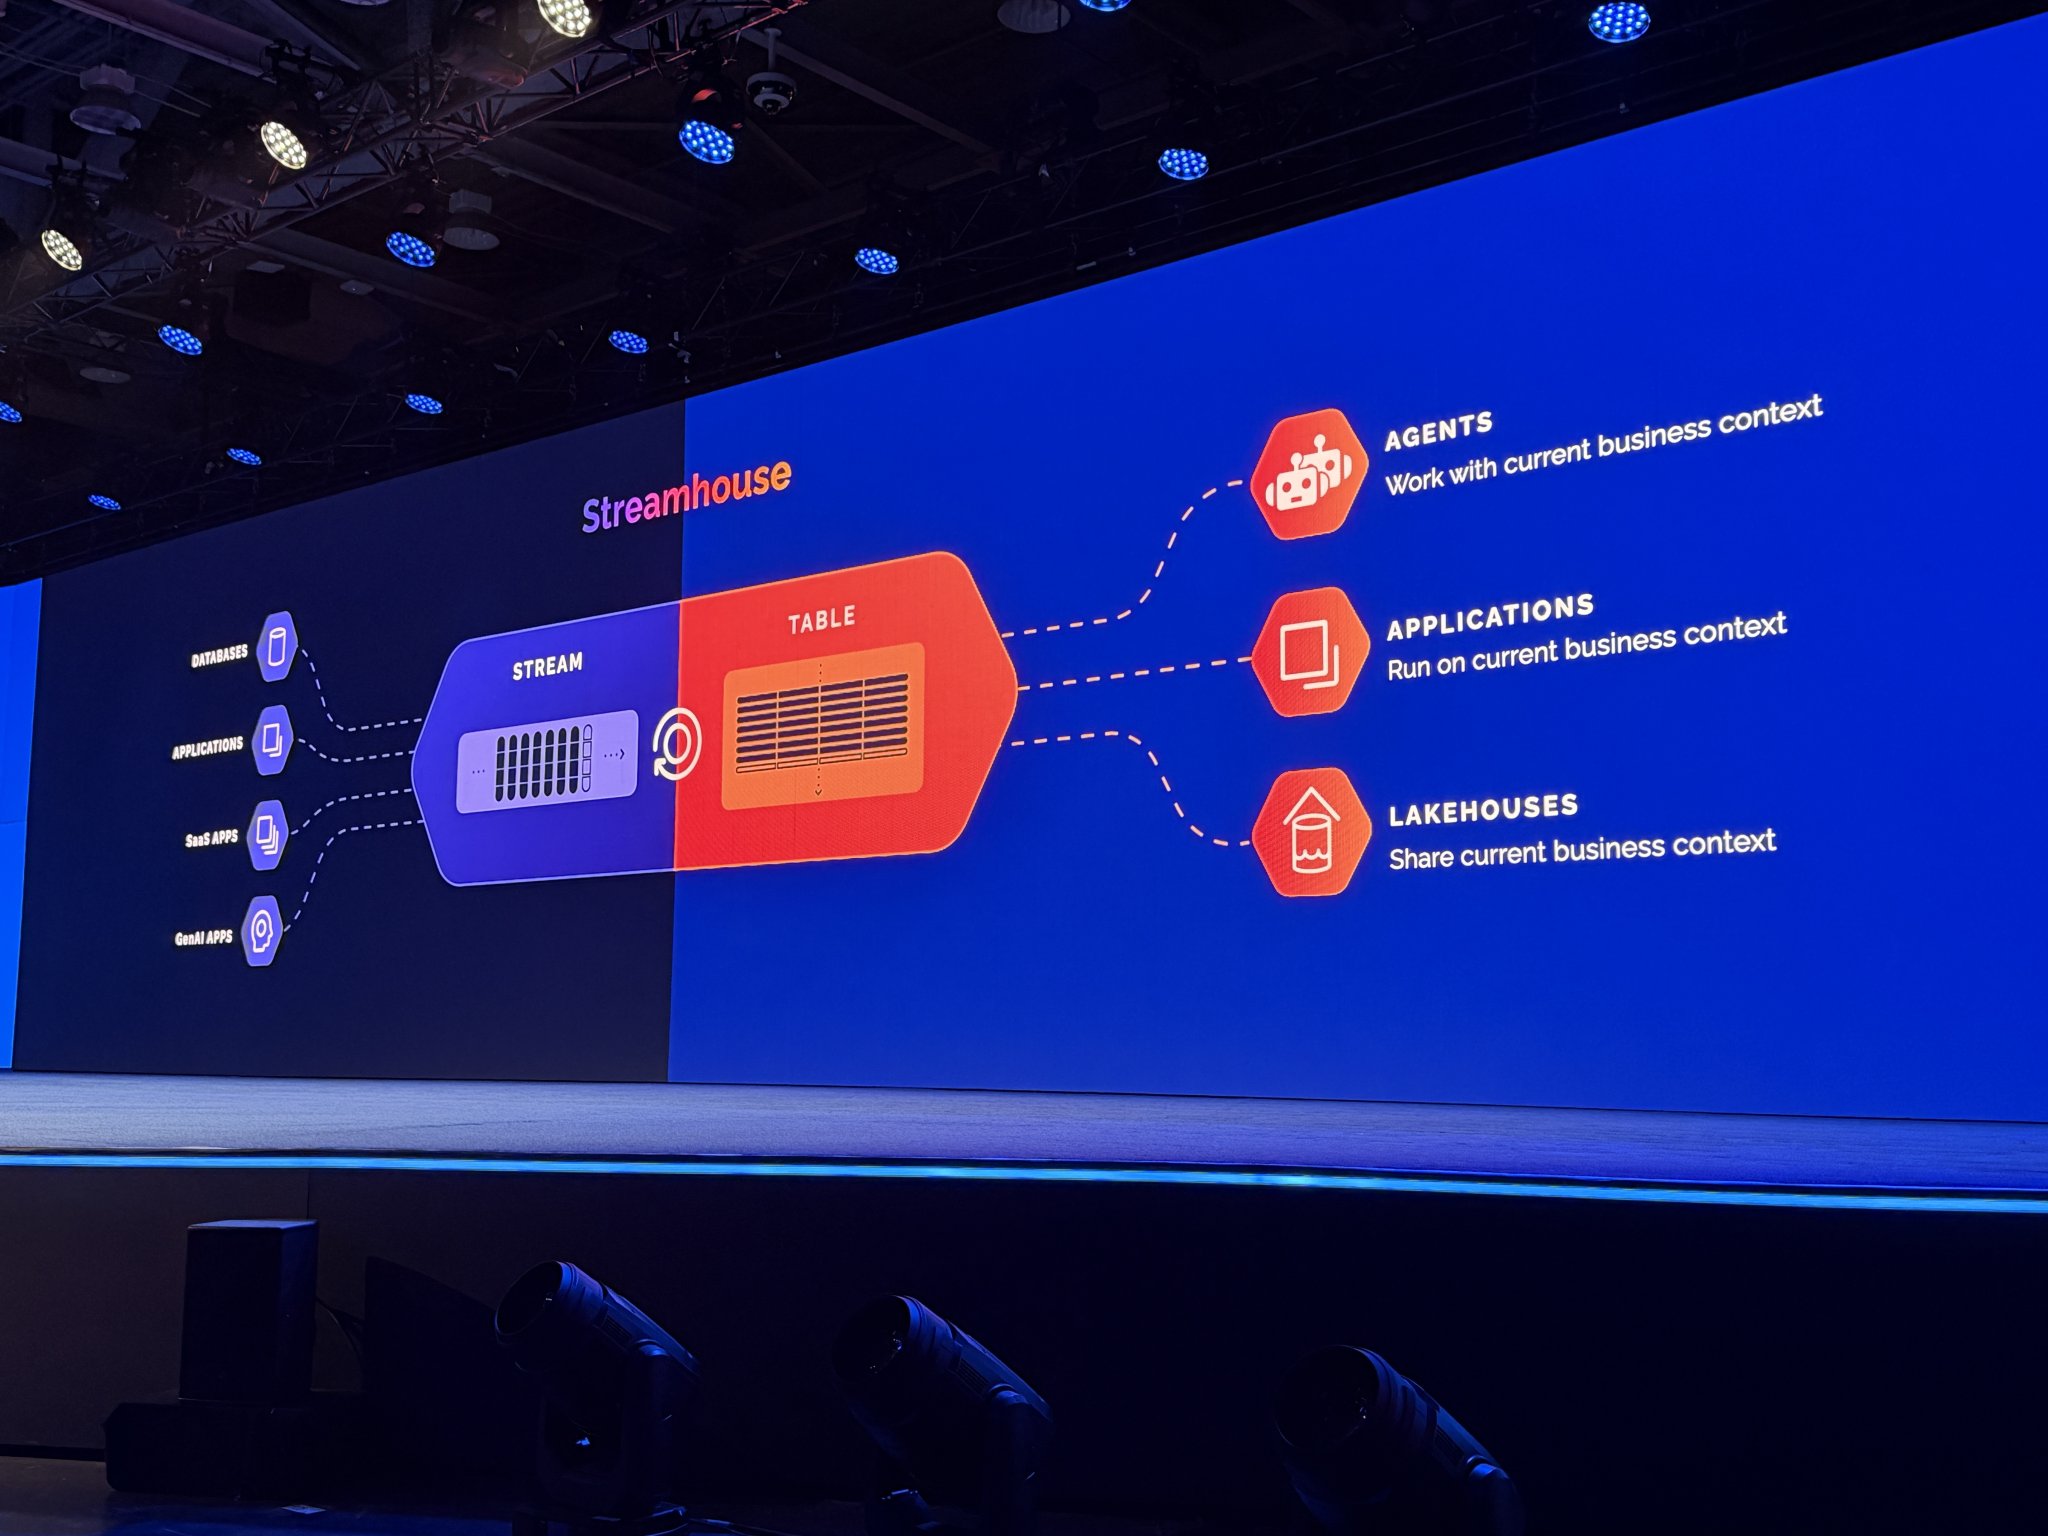

ข้อมูลที่สดใหม่ทำให้การพยากรณ์มีประโยชน์
โมเดลอนุกรมเวลา คือโมเดลที่เรียนรู้รูปแบบจากข้อมูลตัวเลขซึ่งบันทึกตามช่วงเวลา เพื่อนำไปคาดการณ์แนวโน้มและระบุเหตุการณ์ผิดปกติขณะที่ข้อมูลใหม่เข้ามา ไม่ใช่รอให้ข้อมูลสะสมครบแล้วจึงค่อยวิเคราะห์ภายหลัง IBM และ Confluent กำลังนำโมเดล Time-series เข้าใกล้ข้อมูลธุรกิจที่ไหลต่อเนื่อง โดยฝังความสามารถไว้ใน Confluent บนสถาปัตยกรรม Streamhouse การขยับนี้ตอบโจทย์ปัญหาที่พบได้จริง: ข้อมูลจากเครื่องจักร การขาย การชำระเงิน หรือสินค้าคงคลังมีคุณค่าก็ต่อเมื่อทีมตัดสินใจได้ก่อนสัญญาณจะหมดความสดใหม่ หากรอจนจบกระบวนการผลิต การพยากรณ์อาจมาช้าเกินกว่าจะเปลี่ยนผลลัพธ์ทางธุรกิจ จุดสำคัญจึงไม่ใช่แค่มีโมเดลที่เก่งขึ้น แต่คือการทำให้การวิเคราะห์ข้อมูลเรียลไทม์เกิดขึ้นตรงจุดที่ข้อมูลกำลังไหล แทนการส่งข้อมูลไปประมวลผลเป็นรอบแล้วค่อยรอผล
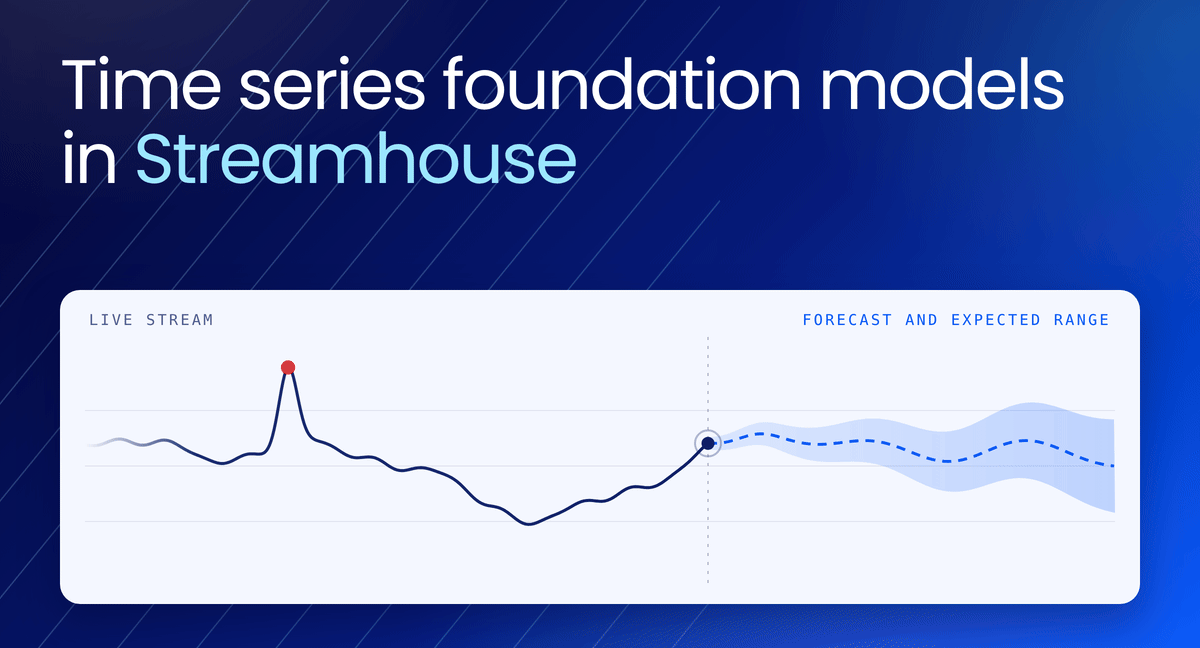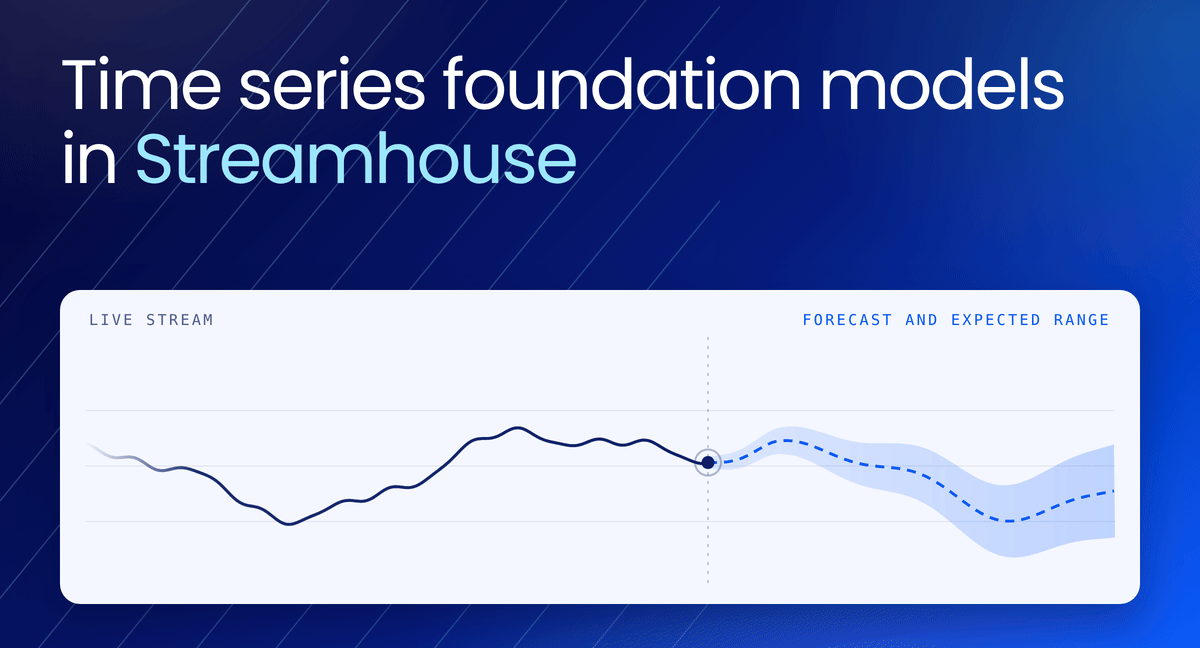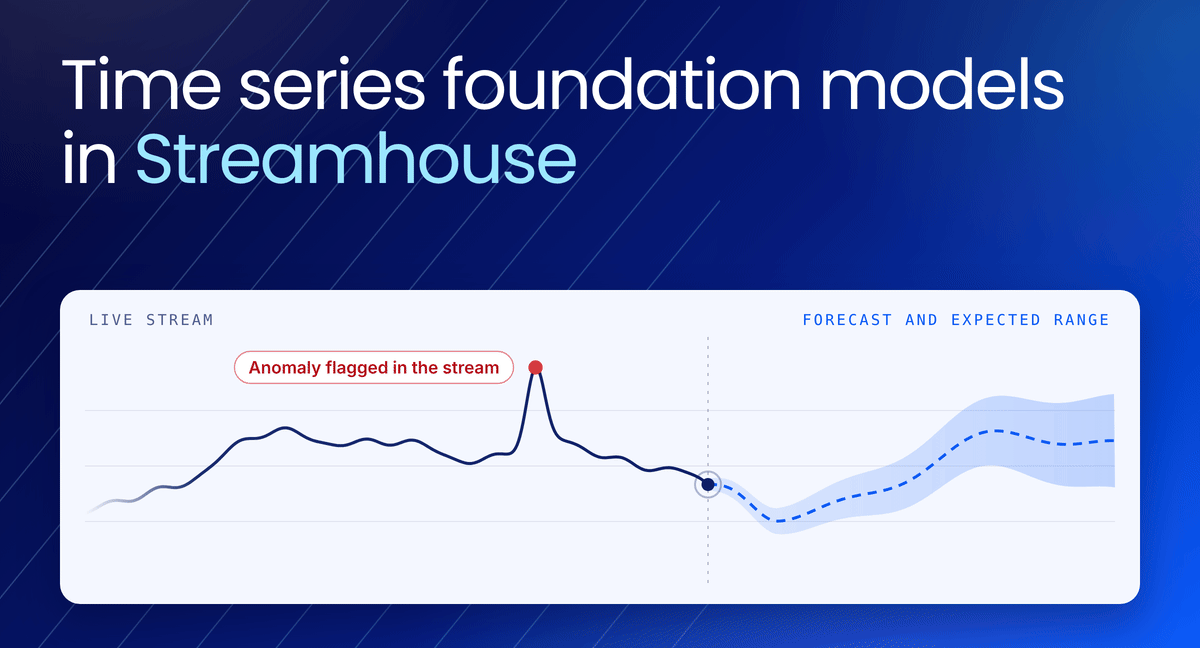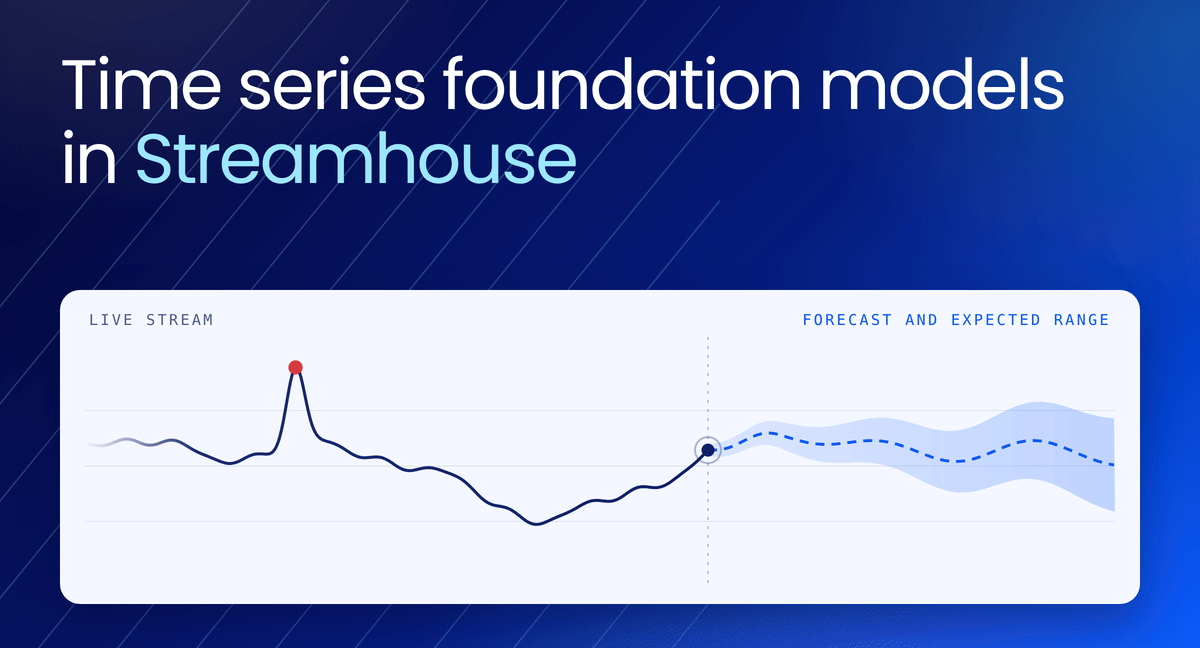
ความฉลาดอยู่ในกระแสข้อมูล ไม่ใช่ปลายทาง
โมเดล Time-series ของ IBM มียอดดาวน์โหลดมากกว่า 50 ล้านครั้ง และขณะนี้ทำงานแบบ Native ใน Confluent ในรูปฟังก์ชันสำเร็จรูป ทั้งบนคลาวด์และระบบที่ติดตั้งในองค์กร จุดนี้ลดช่องว่างระหว่างข้อมูลสตรีมมิงกับการนำผลวิเคราะห์ไปใช้ เพราะ Apache Flink เรียกใช้การพยากรณ์ การตรวจจับความผิดปกติ และการวิเคราะห์ความหมายของข้อมูลได้ระหว่างที่เหตุการณ์กำลังเข้ามา โดยใช้ SQL ผลลัพธ์จึงส่งต่อให้แอปพลิเคชันและผู้รับผิดชอบได้ทันที แทนที่จะเป็นรายงานที่มาถึงหลังเหตุการณ์ผ่านไปแล้ว สำหรับธุรกิจค้าปลีก ฟังก์ชันตรวจจับความผิดปกติสามารถเฝ้าดูยอดขายสินค้าหลายพันรายการโดยไม่ต้องกำหนดเกณฑ์ตายตัวทุกชิ้น ส่วนงานควบคุมการผลิตก็มีโอกาสเห็นสัญญาณผิดปกติก่อนปัญหาจะลุกลาม ข้อได้เปรียบของแนวทางนี้คือโมเดลเริ่มต้นจากรูปแบบที่เรียนรู้มาแล้ว ไม่จำเป็นต้องฝึกโมเดลแยกสำหรับทุกชุดข้อมูลตั้งแต่ต้น แม้องค์กรยังปรับแต่งให้เข้ากับกฎธุรกิจเฉพาะได้
รันบน CPU ช่วยให้เข้าถึงการใช้งานจริงได้ง่ายขึ้น
โมเดลทำงานบน CPU มาตรฐานโดยไม่จำเป็นต้องใช้ GPU และรองรับทั้ง Confluent Cloud กับ Confluent Platform สำหรับ Apache Flink ในระบบภายในองค์กร นี่เป็นรายละเอียดที่มีน้ำหนักในทางปฏิบัติ เพราะการนำการพยากรณ์ไปไว้ใกล้ข้อมูลไม่ควรแลกกับการต้องสร้างโครงสร้างพื้นฐานเฉพาะทางทุกครั้ง เมื่อระบบประมวลผลเหตุการณ์ได้ต่อเนื่อง ธุรกิจสามารถเปลี่ยนข้อมูลให้เป็นการตัดสินใจที่นำไปลงมือทำได้ ตัวอย่างเช่น เมื่อสต็อกต่ำกว่าเกณฑ์ ตัวแทน AI อาจร่างใบสั่งซื้อให้คนตรวจสอบ หรือเมื่อข้อมูลการขายเบี่ยงจากรูปแบบปกติ ระบบอาจแจ้งทีมที่เกี่ยวข้องได้ขณะยังมีโอกาสตรวจสอบสาเหตุ การใช้ SQL ยังช่วยให้ทีมทำงานกับข้อมูลสตรีมมิงผ่านเครื่องมือที่คุ้นเคย อย่างไรก็ดี ผลลัพธ์ที่เร็วไม่ได้รับประกันว่าการตัดสินใจจะถูกเสมอ คุณภาพของข้อมูล การกำกับดูแล และการออกแบบขั้นตอนให้มนุษย์ตรวจสอบกรณีสำคัญยังจำเป็น
Streamhouse แก้ปัญหาข้อมูลคนละชุดคนละเวลา
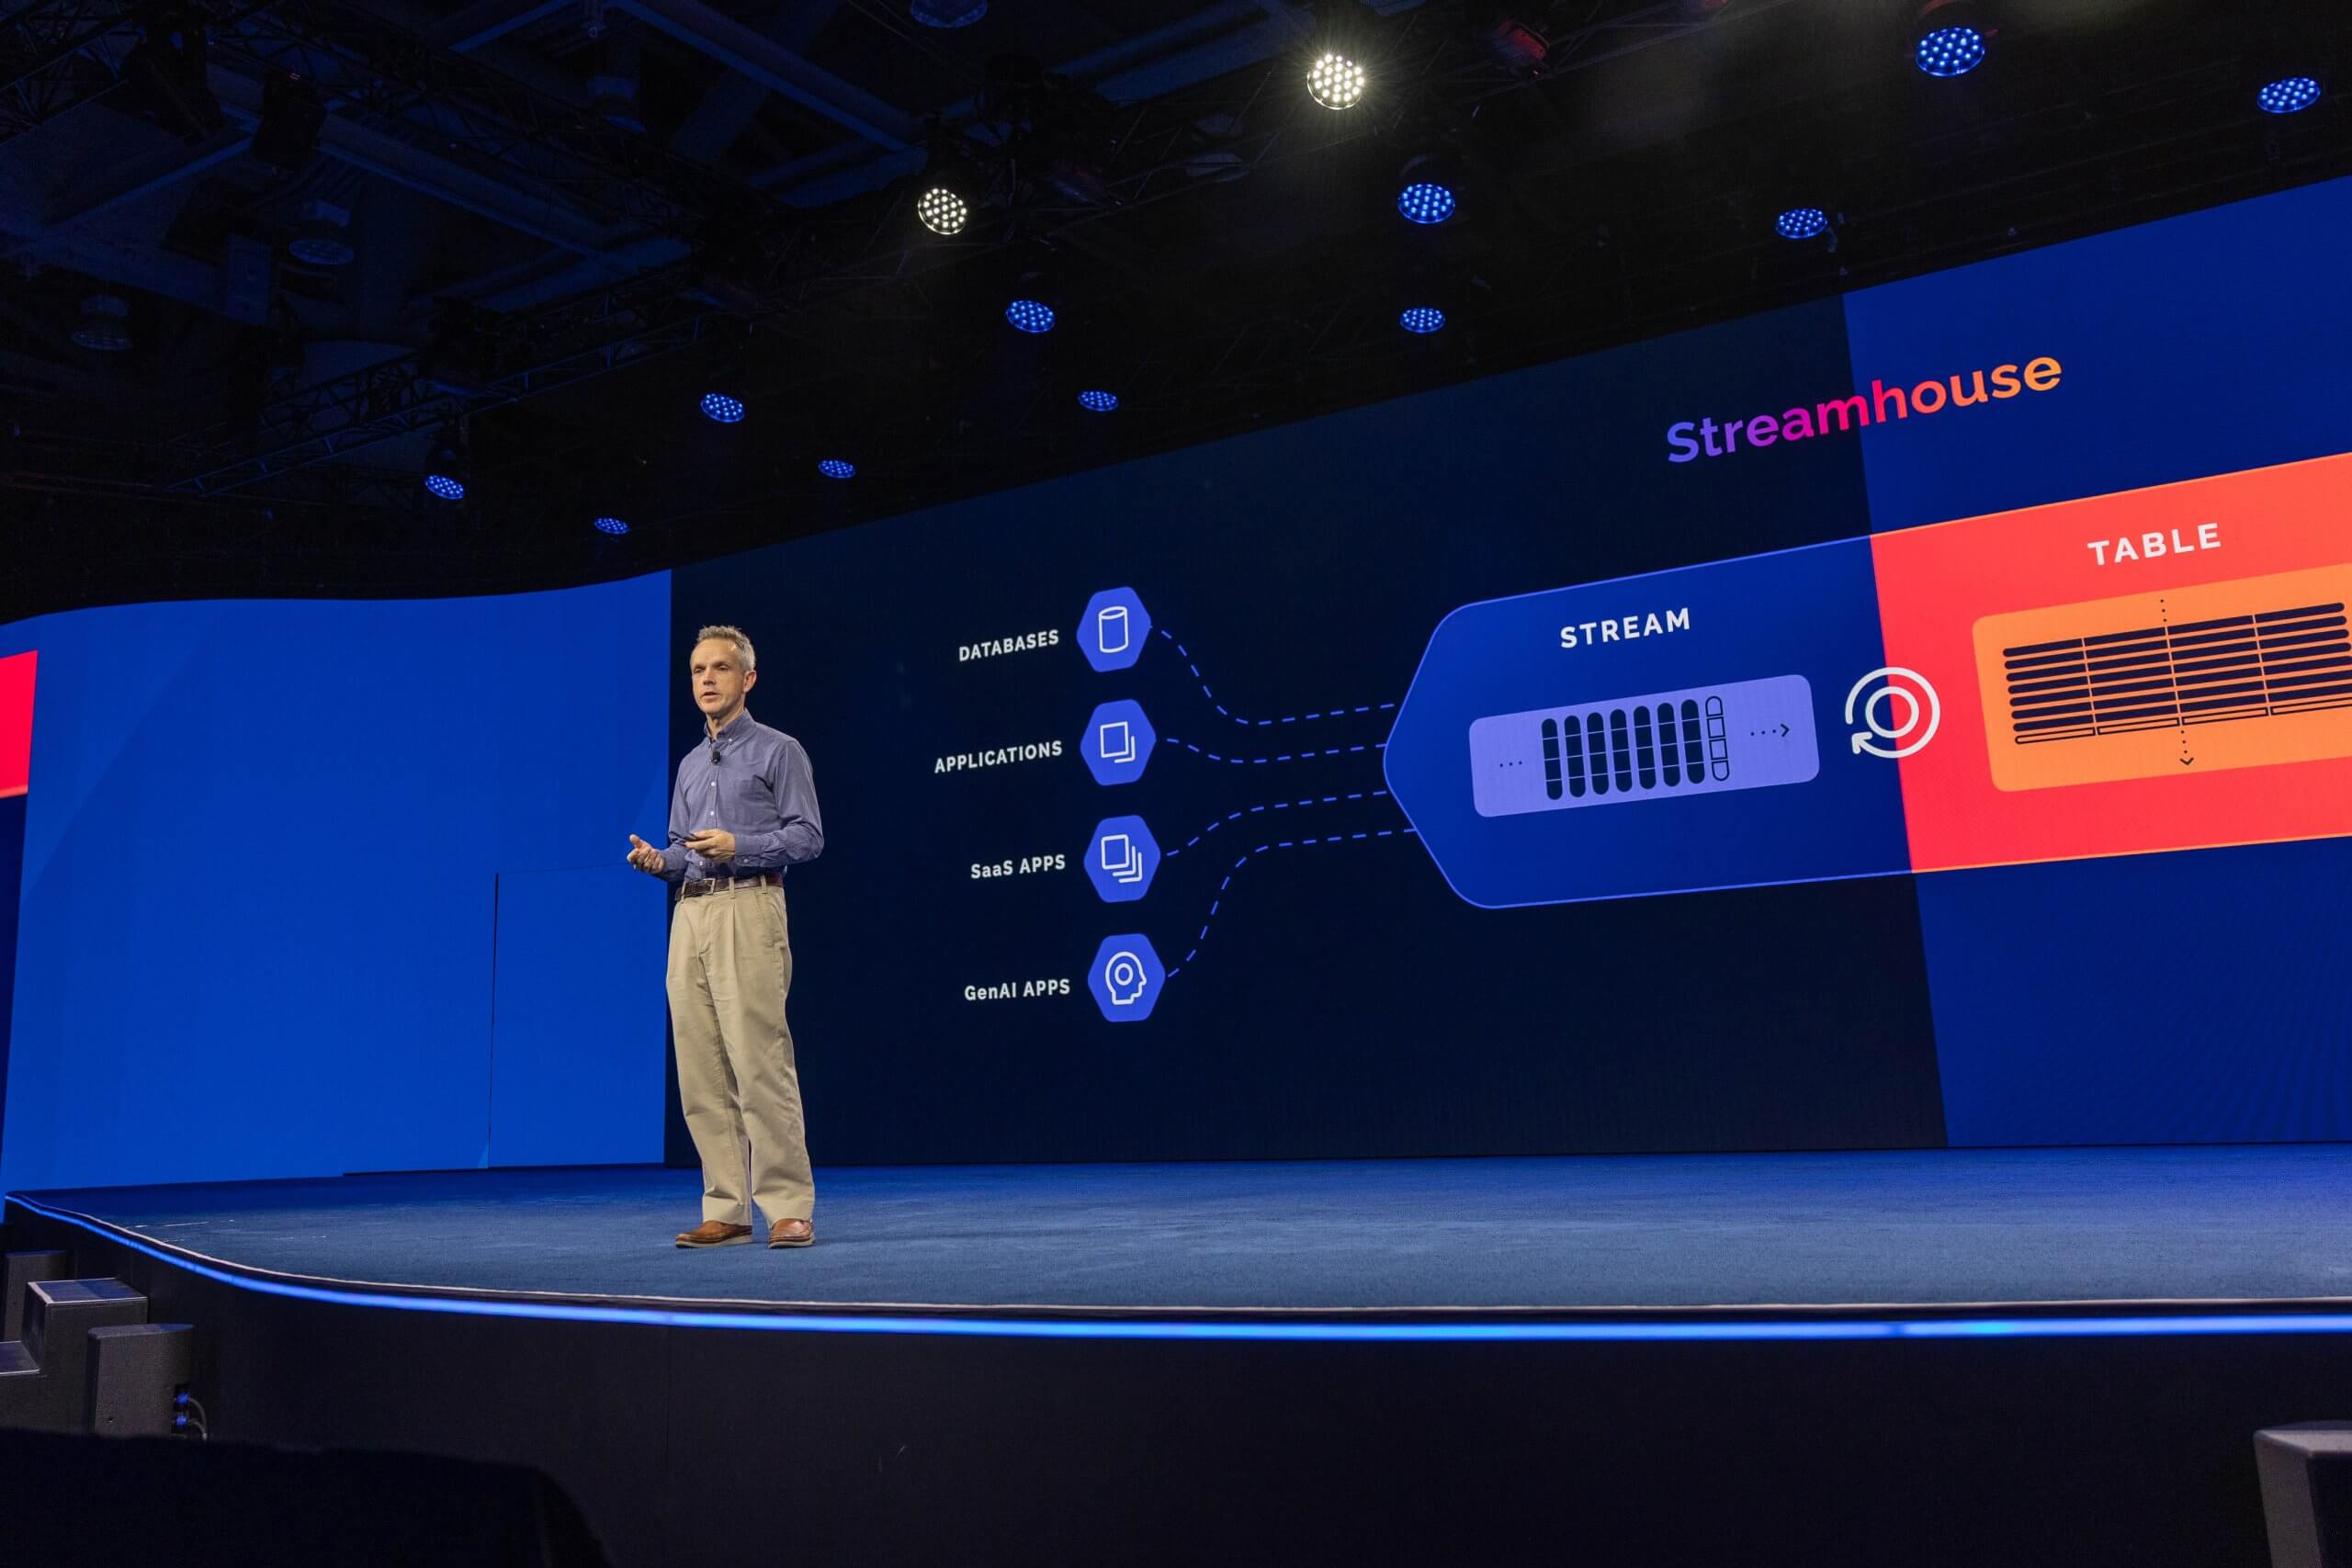
Confluent ซึ่งเป็นบริษัทในเครือ IBM ประกาศความสามารถใหม่เพื่อพัฒนา Streamhouse พร้อมเปิดให้บริการ Lightning Tables อย่างเป็นทางการบน AWS แนวคิดของ Streamhouse คือรวบรวม ประมวลผล กำกับดูแล และเปิดใช้บริบทธุรกิจที่อัปเดตต่อเนื่อง ให้ระบบวิเคราะห์ แอปพลิเคชัน และตัวแทน AI เข้าถึงภาพสถานะเดียวกัน แทนการอาศัยข้อมูลจากหลายระบบที่อัปเดตไม่พร้อมกัน ปัญหานี้เห็นชัดในกรณีเที่ยวบินยกเลิก หากข้อมูลตำแหน่งเครื่องบิน ตารางเที่ยวบิน และที่นั่งว่างไม่ตรงกัน ระบบจองอัตโนมัติอาจเสนอแผนที่ใช้ไม่ได้จริง การส่งทุกการเปลี่ยนแปลงเข้าสู่กระแสข้อมูลช่วยให้ผู้เกี่ยวข้องตรวจสอบบริบทล่าสุดก่อนตัดสินใจ ข้อมูลจากการทดสอบภายในของ Confluent ระบุว่า Lightning Tables ให้บริการข้อมูลใหม่ได้ภายในประมาณ 100 มิลลิวินาทีหลังข้อมูลถูกสร้าง มีความหน่วงในการคิวรี 10–100 มิลลิวินาที และรองรับมากกว่า 1,000 คิวรีต่อวินาที ตัวเลขนี้ชี้ว่าการวิเคราะห์และการเข้าถึงข้อมูลสดอาจทำงานร่วมกันได้ใกล้เวลาจริง
คุณค่าที่แท้จริงคือเวลาตัดสินใจที่ไม่สูญเปล่า
การฝังโมเดลไว้ในแพลตฟอร์มสตรีมมิงทำให้การพยากรณ์ไม่ใช่กิจกรรมแยกส่วนอีกต่อไป แต่เป็นส่วนหนึ่งของวงจรที่เริ่มจากเหตุการณ์ทางธุรกิจ ไปสู่การวิเคราะห์ แล้วส่งผลให้ระบบหรือคนตอบสนองได้ทันเวลา สำหรับองค์กรที่กำลังเพิ่มบทบาทให้ AI Agent ประเด็นนี้สำคัญ เพราะข้อมูลที่ล้าสมัยหรือขัดแย้งกันอาจทำให้ระบบทำงานต่อบนสมมติฐานที่ผิด ประสบการณ์ของ Accenture ที่นำ Streamhouse มาเชื่อมข้อมูลทั่วองค์กรระบุว่า เวลาจากการรวบรวมข้อมูลจนได้ข้อมูลเชิงลึกลดจากหลายเดือนเหลือเพียงไม่กี่วัน นี่เป็นตัวอย่างของผลจากการลดงานเชื่อมต่อและการประมวลผลที่ล่าช้า แม้ไม่ได้หมายความว่าทุกองค์กรจะได้ผลลัพธ์เท่ากัน ข้อสรุปคือ CPU และการทำงานแบบ Native ช่วยลดอุปสรรคในการนำโมเดลอนุกรมเวลาไปใช้กับข้อมูลจริง แต่ความสำเร็จยังขึ้นกับการเลือกสัญญาณที่มีความหมายและกำหนดวิธีตอบสนองให้เหมาะสม เมื่อข้อมูลสดและผลพยากรณ์มาถึงผู้ตัดสินใจพร้อมกัน ธุรกิจจึงมีโอกาสลงมือก่อนที่ความผิดปกติจะกลายเป็นความเสียหาย