
AI governance ไม่ได้เริ่มที่นโยบาย แต่เริ่มที่สถาปัตยกรรมข้อมูล
AI governance enterprise คือแนวทางการกำกับ ดูแล และควบคุมการใช้ระบบ AI ในองค์กรตั้งแต่ระดับข้อมูล โมเดล ไปจนถึงพฤติกรรมในสภาพแวดล้อมจริง เพื่อให้การตัดสินใจของ AI มีความโปร่งใส ตรวจสอบได้ สอดคล้องกฎหมาย และลดผลกระทบต่อผู้ใช้และธุรกิจ การกำกับนี้ครอบคลุมทั้งโครงสร้างข้อมูล คุณภาพข้อมูล การควบคุมสิทธิ์เข้าถึง รวมถึงการติดตามผลลัพธ์และการตัดสินใจที่ระบบ AI สร้างขึ้นในทุกช่องทางที่องค์กรใช้งาน AI ปัญหาคือผู้บริหารจำนวนมากให้เวลากับการถามว่าเอเจนต์ AI พร้อมเข้าระบบผลิตหรือยัง แต่เริ่มผิดจุด เพราะเอเจนต์ไม่ได้ทำงานในสุญญากาศ การตัดสินใจของมันขึ้นกับคุณภาพข้อมูลที่ใช้เป็นหลัก หากองค์กรยังไม่มีการกำกับอินพุต การควบคุมการเข้าถึง และการเก็บบันทึกผลลัพธ์อย่างเป็นระบบ ต่อให้โมเดลปลอดภัยและมีประสิทธิภาพก็ไม่สามารถชดเชยการควบคุมข้อมูลที่อ่อนแอได้ เมื่อให้เอเจนต์ใช้ข้อมูลลูกค้าล้าสมัย ระเบียนซ้ำซ้อน หรือเอกสารที่ไม่เคยจัดหมวดหมู่ มันก็จะตัดสินใจผิดบนธุรกรรมจำนวนมากอย่างรวดเร็ว ส่งผลกระทบตรงถึงลูกค้าและผู้ใช้ปลายทาง ที่สำคัญ ช่องว่างระหว่างการนำ AI ไปใช้กับการกำกับกำลังถ่างกว้าง เพราะองค์กรเร่งนำเอเจนต์เข้าระบบผลิตโดยยังไม่ได้แก้ปัญหาข้อมูล ทำให้โครงการ AI ส่วนใหญ่แทบไม่สร้างผลตอบแทนใดๆ ดังนั้น หัวใจของ AI governance ที่ไม่ค่อยพูดถึงคือการออกแบบสถาปัตยกรรมข้อมูลระดับองค์กร ตั้งแต่การจัดการแหล่งข้อมูล การกำกับ metadata การกำหนดมาตรฐาน data quality control ไปจนถึงกระบวนการบันทึก การตรวจสอบ และการป้องกันไม่ให้ AI เปลี่ยนข้อมูลที่จัดการผิดเป็นวิกฤตทั้งบริษัทเมื่อเข้าสู่ระบบผลิต
เมื่อช่องว่าง data quality กลายเป็นอุปสรรคหลักของการตรวจจับภัยและบริหารความเสี่ยง
ทุกความล้มเหลวของระบบ AI หากไล่ย้อนกลับไปจนถึงต้นตอ มักเป็นปัญหาข้อมูลเสมอ ไม่ใช่แค่โมเดล รายงานการสำรวจทีม threat hunting ระดับองค์กรชี้ว่า 50% ของผู้ตอบแบบสอบถามมองว่า “คุณภาพหรือปริมาณข้อมูลไม่เพียงพอ” คืออุปสรรคหลักของประสิทธิภาพการล่าภัยคุกคาม เป็นครั้งแรกที่ปัจจัยนี้แซง “ขาดบุคลากรที่มีทักษะ” ซึ่งอยู่ที่ 45% ขณะที่ “ข้อจำกัดด้านงบประมาณ” อยู่ลำดับสามที่ 42% นี่เป็นคำเตือนชัดเจนว่าปัญหาหลักไม่ใช่คน แต่คือข้อมูลและการควบคุมข้อมูล ผู้สอนของสถาบันด้านความปลอดภัยชี้ให้เห็นว่า ต่อให้บุคลากร threat hunting เก่งแค่ไหน หากข้อมูลเทเลเมทรีไม่ครบถ้วน ไม่สอดคล้องกัน หรือกระจัดกระจายอยู่ในเครื่องมือหลายชุดที่เข้าถึงและประมวลผลได้ยาก ก็ยังไม่สามารถค้นพบภัยคุกคามได้ สำหรับผู้ใช้ทั่วไป สิ่งนี้แปลว่าเหตุการณ์ข้อมูลรั่วไหล การโจมตี ransomware หรือการเข้ายึดระบบสำคัญอาจไม่ถูกตรวจพบหรือถูกตอบสนองช้าลงอย่างมีนัยสำคัญ เพราะระบบตรวจจับขององค์กรตาบอดจากข้อมูลที่ขาดและไม่สะอาด ความท้าทายยิ่งรุนแรงเมื่อองค์กรขยายการใช้ AI เข้าสู่โครงสร้างพื้นฐานแบบไฮบริดและคลาวด์หลายเจ้าซึ่งซับซ้อนขึ้นเรื่อยๆ ทำให้ระบบที่รองรับบริการสำคัญเชื่อมต่อกันมากขึ้น ขณะที่ความต้องการด้านความทนทาน การดำเนินงานอย่างมีประสิทธิภาพ และ compliance risk management ก็เพิ่มขึ้นตามไปด้วย หากไม่มีการควบคุมข้อมูลแบบบูรณาการ ทั้งการล่าภัย การตรวจจับความเสี่ยง และการบริหารความเสี่ยงด้าน AI จะถูกจำกัดโดยช่องว่าง data quality และ data quality control ที่ไม่เคยถูกแก้จากราก
เมื่อระบบ AI เข้าสู่โปรดักชันโดยไม่มีการตรวจสอบข้อมูล การล้มเหลวด้าน compliance จะสะสมจนกลายเป็นระเบิดเวลา
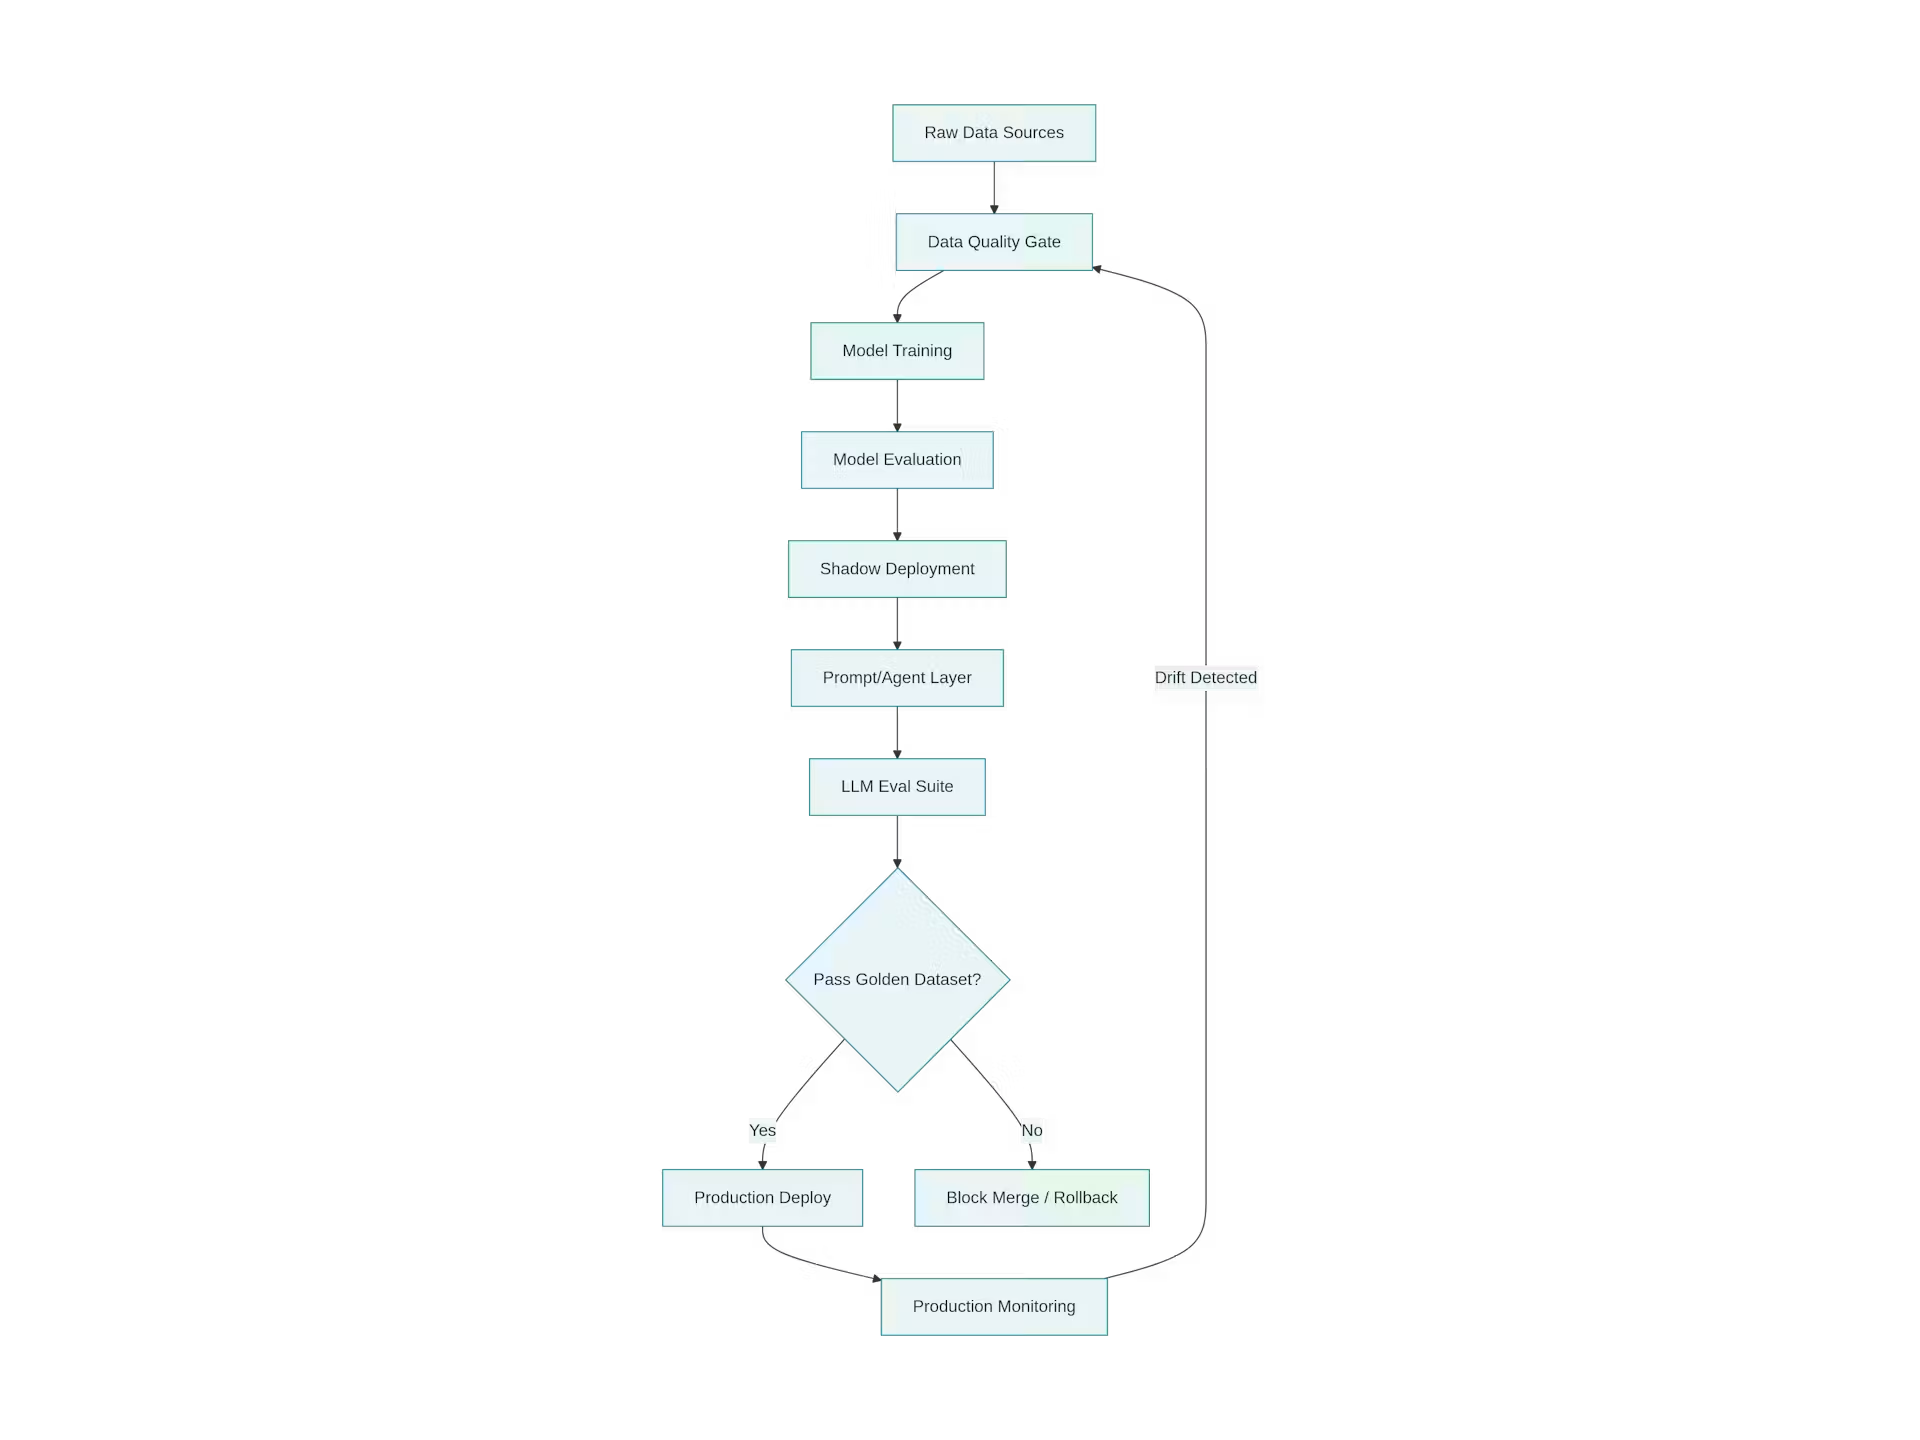
การนำแอปพลิเคชัน AI ขององค์กรเข้าสู่ระบบผลิตกำลังดันนโยบาย compliance และ governance ที่มีอยู่ให้ถึงขีดจำกัด และความล้มเหลวด้านการกำกับที่เกี่ยวกับ AI กำลังเริ่มสะสมมากขึ้นเรื่อยๆ ข้อมูลที่เกี่ยวกับ AI กำลังกลายเป็นหลักฐานสำคัญในคดีฟ้องร้อง การตรวจสอบ compliance และข้อร้องเรียนจากลูกค้า สร้างแรงกดดันใหม่ให้กับทีมบริหารความเสี่ยงและฝ่ายกฎหมาย ปัญหาไม่ได้เกิดจากโมเดลเพียงอย่างเดียว แต่จากการที่องค์กรปล่อยให้ระบบ AI เข้าสู่โปรดักชันโดยไม่มีวงจร data validation และการติดตาม drift ในสภาพแวดล้อมจริง เมื่อไม่มีการตรวจสอบข้อมูลแบบต่อเนื่อง โมเดล AI จะค่อยๆ เสื่อมคุณภาพแบบเงียบๆ เมื่อข้อมูลจริงเบี่ยงไปจากข้อมูลที่ใช้ฝึก ซึ่งทำให้การตัดสินใจเริ่มมีอคติ ผิดมาตรฐาน หรือขัดกับข้อบังคับ แต่ถูกค้นพบช้าเกินไป กรอบ AI governance ที่ยังคิดแบบซอฟต์แวร์เดิมว่าระบบ “เสร็จแล้ว” หลังดีพลอย เป็นความเข้าใจผิดร้ายแรง วงจร AI ควรถูกออกแบบให้ drift ที่ตรวจพบในโปรดักชันเรียกย้อนให้เริ่มต้นกระบวนการตรวจสอบข้อมูลใหม่ และเมื่อจำเป็นก็ทำการฝึกใหม่และประเมินใหม่ เพื่อปิดลูปคุณภาพแทนการรอรอบปล่อยเวอร์ชันครั้งถัดไป หากองค์กรละเลยวงจรนี้ การตัดสินใจของ AI จะเคลื่อนออกจากกรอบกฎหมายและนโยบายอย่างช้าๆ จนกลายเป็นหิมะถล่มของเหตุการณ์ compliance ที่ยากจะแก้ย้อนหลังและกระทบผู้ใช้ตรง
ทำไมองค์กรต้องลงทุนใน AI observability systems และการดีพลอยทีละขั้น
เมื่อแอปพลิเคชันสำคัญล้ม ระบบไอทีไม่ต้องการการโต้เถียงว่าใครผิด แต่ต้องการคำตอบว่ารากเหตุคืออะไร เพราะทุกนาทีที่ใช้ตามหาต้นตอคือเวลาที่บริการสำคัญยังใช้งานไม่ได้ ในสภาพแวดล้อมองค์กรที่ซับซ้อน ซึ่งแต่ละทีมยังใช้เครื่องมือมอนิเตอร์รุ่นเก่าแยกส่วนกัน การหา root cause จึงกินเวลามากและปล่อยให้ผู้ใช้ปลายทางรับผลกระทบจากการหยุดชะงักของบริการ งานวิจัยหนึ่งสะท้อนให้เห็นช่องว่างด้านการสังเกตการณ์อย่างมีนัยสำคัญ ระหว่างสิ่งที่คณะกรรมการเชื่อว่าตัวเองรู้เกี่ยวกับสภาพแวดล้อมไอทีขององค์กร กับสิ่งที่ผู้ปฏิบัติงานด่านหน้ารับรู้จริง ทางออกไม่ใช่การเพิ่มเครื่องมือมอนิเตอร์อีกตัว แต่คือต้องสร้าง AI observability systems แบบ agentic observability ที่รวมเทเลเมทรีแบบเรียลไทม์จากแอปพลิเคชัน คลาวด์ โครงสร้างพื้นฐาน เน็ตเวิร์ก และระบบ AI เข้าด้วยกัน เพื่อให้ทั้งมนุษย์และเอเจนต์ AI ได้ภาพรวมเดียวกันในการเร่งวิเคราะห์และแก้ไขเหตุการณ์ ในฝั่งโมเดล เทคนิคอย่าง shadow deployment ซึ่งให้โมเดลตัวใหม่รันคู่กับโมเดลโปรดักชันบนทราฟฟิกจริงโดยยังไม่กระทบผลลัพธ์ที่ผู้ใช้เห็น ช่วยให้ทีมสามารถเปรียบเทียบประสิทธิภาพจริงก่อนสลับโมเดลได้ ขณะที่ perturbation testing ใช้การปรับอินพุตเล็กน้อยอย่างมีแบบแผน เช่นใส่ noise หรือค่าขาดหาย เพื่อดูว่าโมเดลตอบสนองอย่างมีเสถียรภาพในขอบเขตที่ควบคุมได้หรือไม่ แนวทางการดีพลอยทีละขั้นแบบนี้จับคู่กับ observability แบบเรียลไทม์ จะช่วยป้องกันไม่ให้การเปลี่ยนโมเดลหรือเอเจนต์ทำให้บริการสำคัญล่ม หรือทำให้ AI governance แตกสลายกลางโปรดักชันโดยไม่มีใครมองเห็น
บทสรุปสำหรับผู้นำองค์กร สร้างกรอบ QE บูรณาการ ที่ตรวจทั้งข้อมูล โมเดล และพฤติกรรมในโปรดักชัน
ในช่วงไม่กี่ปีที่ผ่านมา QE แบบดั้งเดิมที่เคยเชื่อว่าระบบจะให้ผลลัพธ์เดียวกันเสมอเมื่อรับอินพุตเดียวกัน กำลังถูกท้าทายโดยระบบ AI และ ML ที่มีธรรมชาติไม่เป็นเชิงกำหนด สถิติ และเปลี่ยนแปลงต่อเนื่อง การทดสอบ AI จึงไม่ใช่แค่ขยาย QA เดิม แต่คือวินัยใหม่ที่ต้องผสมความรู้ด้าน data engineering สถิติ และการดำเนินงาน ML เข้าด้วยกัน โดยยังยึดภารกิจเดิมของ QE คือสร้างความเชื่อมั่นก่อนปล่อยสู่โปรดักชัน กรอบ QE ที่ใช้ได้จริงต้องมองคุณภาพ AI แบบสามชั้นเชื่อมถึงกัน ได้แก่ ชั้นข้อมูล ชั้นโมเดล และชั้น prompt หรือเอเจนต์ โดยแต่ละชั้นต้องมีวิธีตรวจเฉพาะ เช่น การตรวจ schema ความครบถ้วน การแจกแจง และอคติในข้อมูลฝึกและอินพุต การประเมินโมเดลด้วยชุดทดสอบหลากหลาย รวมถึง regression suite สำหรับเอเจนต์และการทดสอบ end-to-end จุดออกแบบสำคัญคือการสร้างลูป feedback จากการมอนิเตอร์ในโปรดักชันย้อนกลับไปยัง gate คุณภาพข้อมูล เมื่อมีการเปลี่ยนข้อมูลฝึก ปรับ prompt หรือพบสัญญาณ drift ในโปรดักชัน ลูปนี้ต้องกระตุ้นให้เริ่มตรวจสอบตั้งแต่ต้นใหม่ ไม่ใช่รอรอบปล่อยครั้งหน้า รายงานหนึ่งสะท้อนว่าการวางแผนใช้ AI ในงาน threat hunting ขององค์กรกำลังกลับมาเป็นเชิงปฏิบัติมากขึ้น มี 39% ที่มองว่าการนำ AI หรือ ML มาใช้คือหัวข้อปรับปรุงสำคัญสำหรับอนาคต ลดลงจากปีก่อนที่ 48% แสดงให้เห็นว่าทีม threat hunting กำลังทดสอบ AI แบบลงมือใช้จริง แทนที่จะคาดหวังว่า AI จะมาเติมช่องว่างข้อมูลอย่างวิเศษ สำหรับผู้นำองค์กร นี่คือสัญญาณชัดว่าการลงทุนที่สำคัญไม่ใช่การซื้อโมเดลเพิ่ม แต่คือการสร้างฐานข้อมูลที่ยืนยันได้ QE แบบบูรณาการ และ AI observability systems ที่ทำให้ data quality control compliance risk management และ production ML validation เป็นส่วนเดียวกันของ AI governance enterprise ตั้งแต่วันแรกของการออกแบบ ไม่ใช่ภาคผนวกท้ายโครงการ