
M3.1 Flash คืออะไร และทำไมเรื่องต้นทุนจึงสำคัญกว่าโมเดลใหญ่
MiniMax M3.1 Flash คือเวอร์ชันอัปเดตของโมเดลภาษาขนาดใหญ่ M3 ที่ออกแบบมาให้ประมวลผลได้รวดเร็วขึ้นในต้นทุนที่ต่ำลง โดยมุ่งตอบโจทย์งานเอเจนต์ AI ที่ต้องเรียกใช้โมเดลหลายสิบครั้งต่อหนึ่งงาน ทำให้การลดต้นทุนต่อการประมวลผลและการเพิ่มความเร็วอินเฟอเรนซ์กลายเป็นหัวใจสำคัญของการออกแบบโมเดลรุ่นนี้ เพื่อให้การพัฒนาและใช้งานเอเจนต์ AI สามารถขยายสเกลได้จริงในสภาพแวดล้อมที่ทรัพยากรจำกัด และลดภาระค่าใช้จ่ายของนักพัฒนาและธุรกิจที่ต้องการนำ AI ไปใช้ในเวิร์กโฟลว์ที่ซับซ้อน ประเด็นที่ควรจับตาไม่ใช่แค่ความเป็นโมเดล AI ขนาดเล็กหรือใหญ่ แต่คือการที่ MiniMax เลือกปรับสมดุลระหว่างประสิทธิภาพและความสามารถให้เหมาะกับงานเอเจนต์โดยตรง การเปิดตัว M3.1 Flash ถูกระบุชัดว่าเป็นการสำรวจความสมดุลนี้อย่างต่อเนื่อง โดยตั้งเป้าลดต้นทุนในการใช้งานเอเจนต์ AI ซึ่งเดิมมีต้นทุนสูงจากการเรียกโมเดลซ้ำจำนวนมาก นี่คือสัญญาณว่าตลาดกำลังขยับจากการแข่งขันด้านขนาดโมเดล ไปสู่การแข่งขันด้านต้นทุนพัฒนา AI และความคุ้มค่าในการใช้งานจริงมากขึ้น
ตัวเลขที่เขย่าเกมต้นทุนพัฒนา AI: 70% และความเร็วเกือบสามเท่า
จุดแข็งของ MiniMax M3.1 Flash อยู่ที่ตัวเลขที่กระทบต้นทุนพัฒนา AI อย่างตรงไปตรงมา งานที่ใช้เอเจนต์มีต้นทุนการประมวลผลลดลงถึง 70% เมื่อเทียบกับโมเดลรุ่นก่อนหน้า ขณะที่ความเร็วอินเฟอเรนซ์เพิ่มขึ้นเกือบสามเท่า โดยมีเอาต์พุตในช่วงเวลาที่มีการใช้งานสูงสุดมากกว่า 200 โทเคนต่อวินาที นี่ไม่ใช่การอัปเกรดเชิงสเปกเพื่อการตลาด แต่คือการปรับรูปทรงโมเดลให้ตอบโจทย์เวิร์กโหลดเอเจนต์ที่ต้องการทั้งความเร็วและต้นทุนต่ำ แม้ขนาดพารามิเตอร์รวมยังอยู่ที่ 428 พันล้านพารามิเตอร์ใกล้เคียง M3 เดิม แต่การใช้เทคนิค Sparsity ที่เข้มข้นขึ้นในขั้นตอนอินเฟอเรนซ์ทำให้โมเดลสามารถให้เหตุผลได้ในทุกคำขอ โดยนักพัฒนาปรับระดับ reasoning_effort ได้ห้าระดับตั้งแต่ต่ำถึงสูงสุด การออกแบบเช่นนี้สะท้อนแนวคิดใหม่ของโมเดล AI ขนาดเล็กในเชิงต้นทุน คือไม่จำเป็นต้องลดพารามิเตอร์ลงอย่างมาก หากสามารถจัดการการใช้ทรัพยากรให้ฉลาดขึ้นในระดับอินเฟอเรนซ์
Inferact ในฐานะพันธมิตร API และความหมายต่อ AI agent deployment
สองวันหลังจาก M3.1 Flash เปิดให้ใช้งานทั่วไป บัญชี X ของ MiniMax ระบุชื่อ Inferact เป็นพันธมิตรการเปิดตัว API สำหรับโมเดลนี้ โดยยกย่องความเชี่ยวชาญด้าน vLLM และอธิบายความร่วมมือว่าเป็นการสร้างโครงสร้างพื้นฐานการให้บริการสำหรับเวิร์กโหลดเอเจนต์ที่ซับซ้อน นี่คือจุดที่เรื่องการให้บริการกลายเป็นประเด็นสำคัญพอ ๆ กับตัวโมเดลเอง เพราะการเคลมว่าเร็วขึ้นสามเท่าไม่อาจเกิดขึ้นได้หากเลเยอร์การให้บริการไม่รองรับ สิ่งที่น่าสนใจคือความร่วมมือนี้ถูกประกาศผ่านโพสต์โซเชียลมีเดียหลังโพสต์เปิดตัวอย่างเป็นทางการ ซึ่งไม่ได้กล่าวถึง Inferact หรือ vLLM เลย ช่องว่างดังกล่าวบอกเราว่านี่คือพันธมิตรที่งานยังอยู่ระหว่างดำเนินการมากกว่าผลลัพธ์ที่เสร็จสมบูรณ์ และยังไม่มีตัวเลขประสิทธิภาพเฉพาะสำหรับ M3.1 Flash บนสแต็กของ Inferact ณ วันที่มีการตรวจสอบ สำหรับนักพัฒนาที่สนใจ AI agent deployment ประเด็นนี้หมายความว่าควรเฝ้ารอตัวเลขชุดแรกจาก Inferact ก่อนตัดสินใจผูกเวิร์กโหลดเอเจนต์ขนาดใหญ่กับสแต็กนี้อย่างเต็มตัว
รูปทรงเวิร์กโหลดเอเจนต์ของ M3.1 Flash และสิ่งที่นักพัฒนาต้องเตรียม
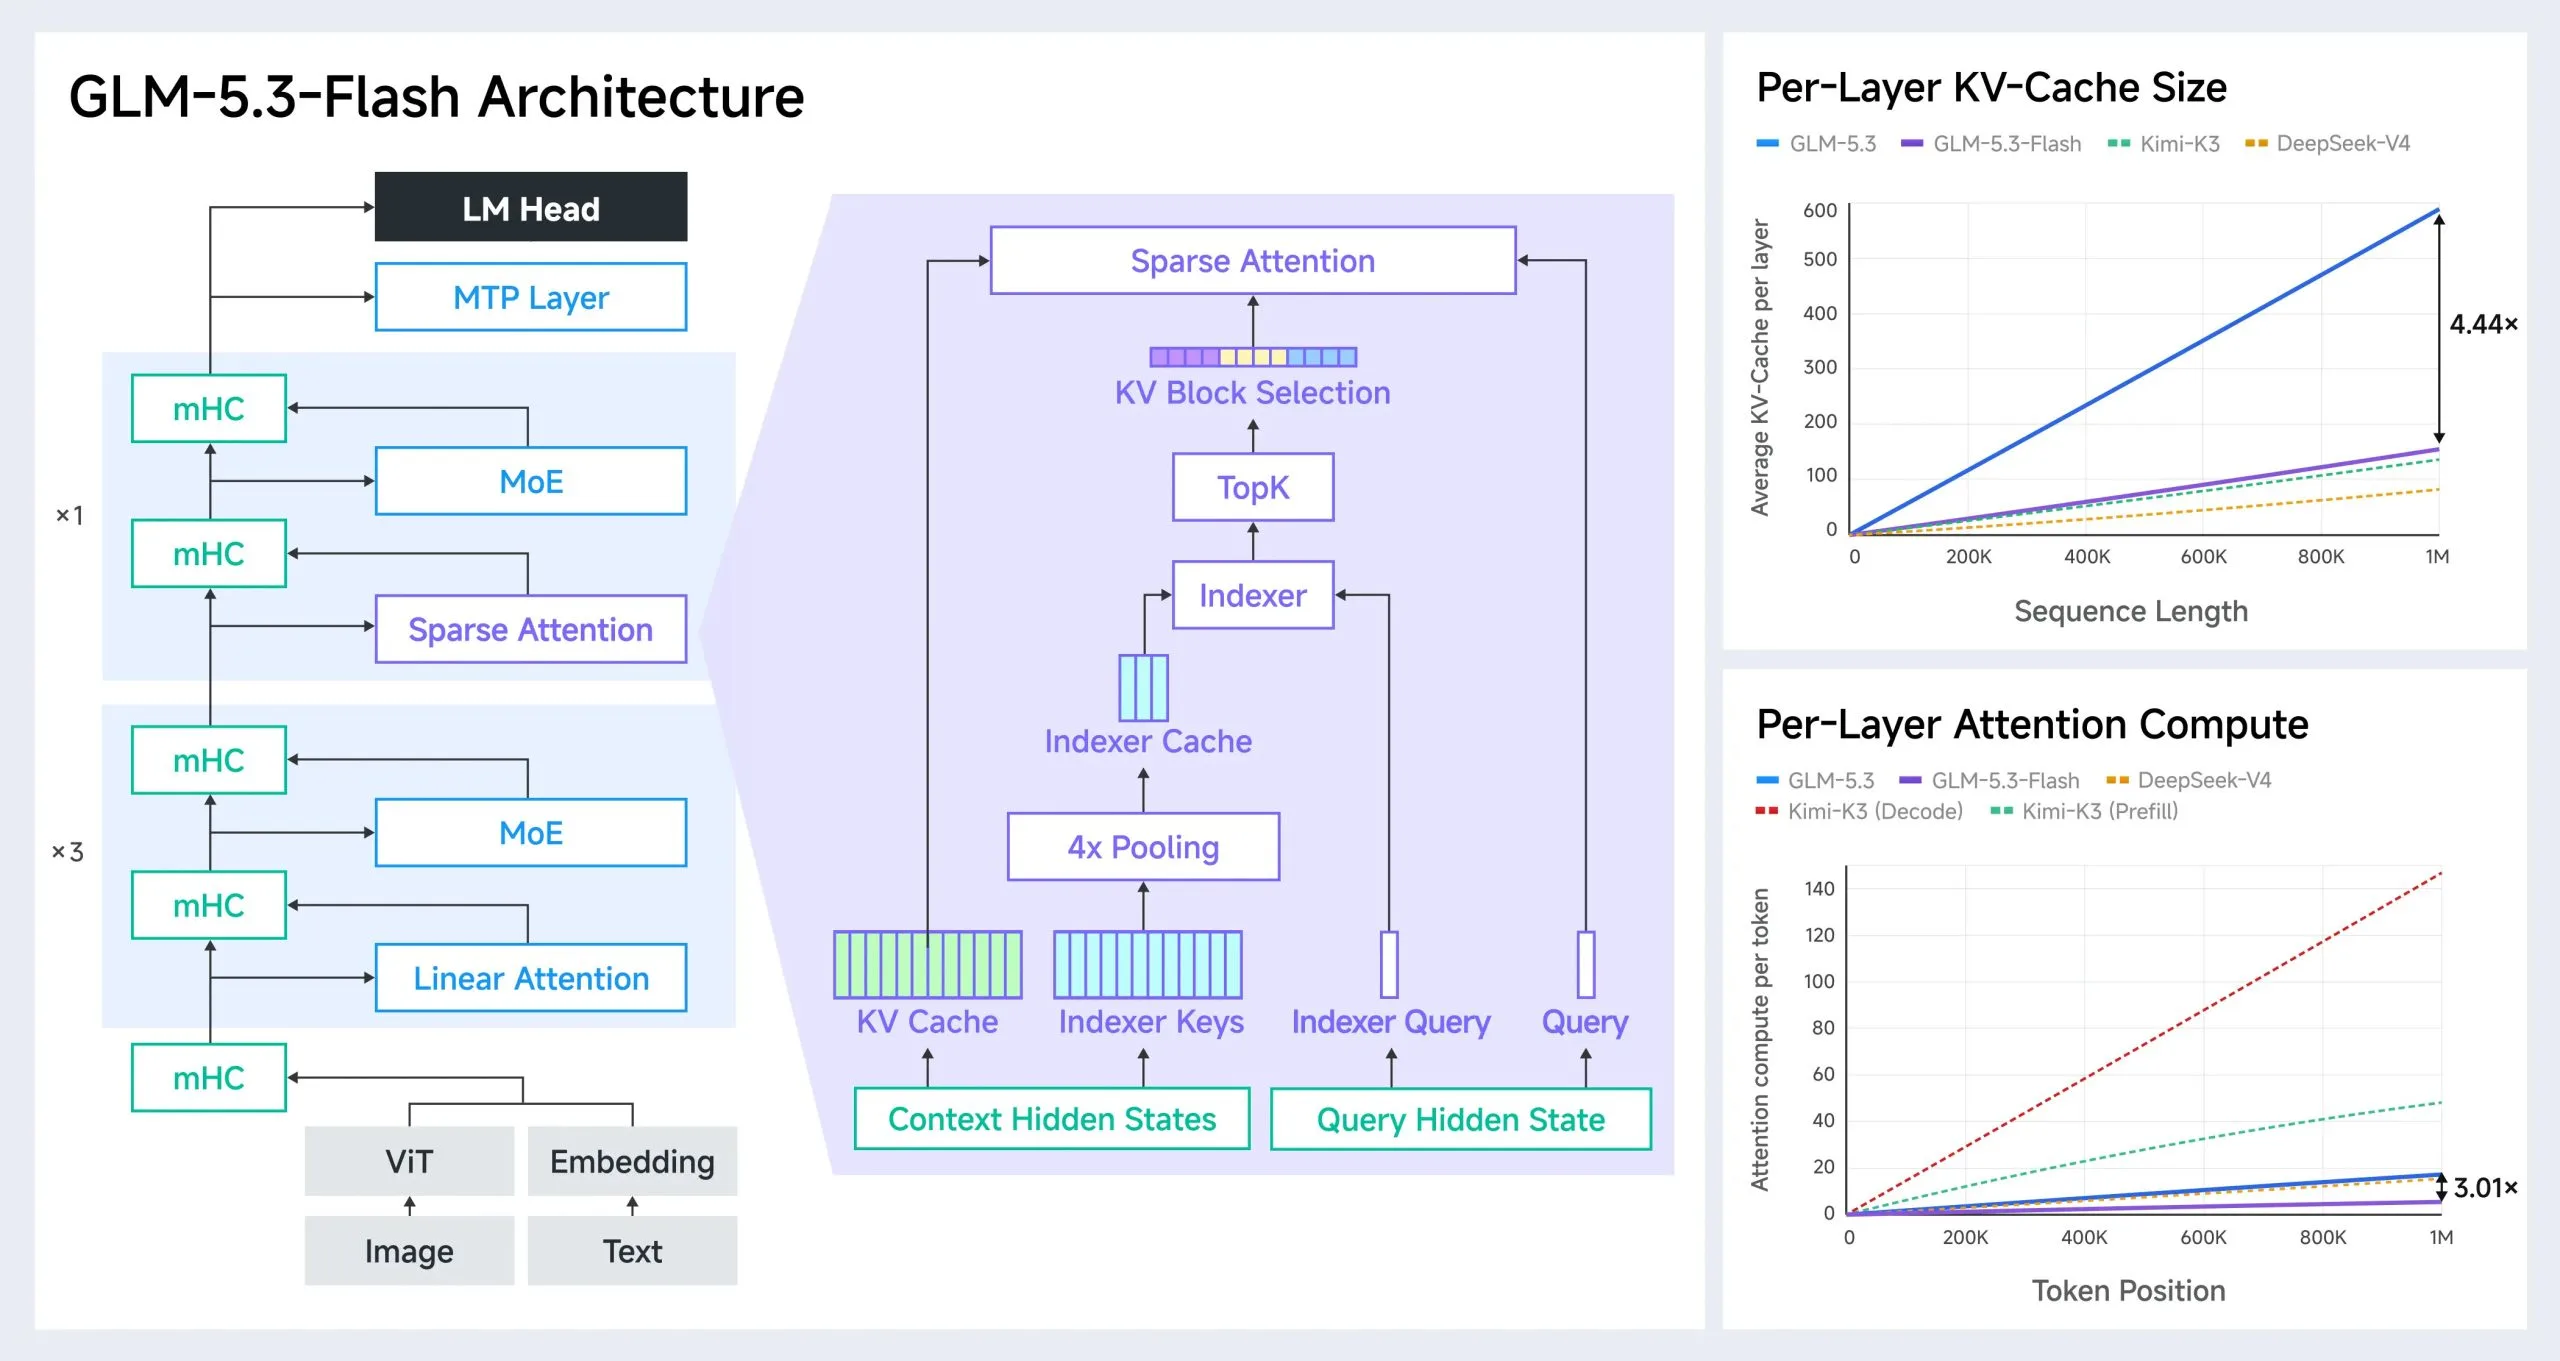
MiniMax M3.1 Flash มีรูปทรงเวิร์กโหลดที่ไม่ธรรมดาสำหรับโมเดลราคาถูก และรูปทรงนี้เองที่ทำให้คำถามเรื่องการให้บริการมีน้ำหนักสำคัญ เอกสารอ้างอิง API ระบุว่าโหมดการให้เหตุผลหรือ thinking เปิดอยู่เสมอ การตั้งค่า reasoning_effort แบบ none ถูกปฏิเสธ ทำให้นักพัฒนามีตัวควบคุมเพียงลำดับห้าระดับจาก low ถึง max และการไม่ระบุฟิลด์หมายถึงค่ามากสุด นั่นหมายความว่าเวิร์กโหลดเอเจนต์จะเป็นภาระที่ถูกจำกัดด้วยการถอดรหัสอย่างชัดเจน หน้าต่างบริบทขนาด 1,000,000 โทเคนทำให้หน่วยความจำ KV-cache เป็นข้อจำกัดสำคัญต่อจำนวนเซสชันเอเจนต์ที่ทำงานพร้อมกันในหนึ่งโหนด ขณะที่ลูปของเอเจนต์มักใช้คำนำหน้าขนาดใหญ่ซ้ำ เช่น พรอมต์ระบบ สคีมาของเครื่องมือ และบริบทไฟล์เดิมในทุกขั้นตอน ดังนั้นการแคชคำนำหน้าและการจัดการแบตช์อย่างต่อเนื่องจึงไม่ใช่ทางเลือก แต่เป็นสิ่งจำเป็นสำหรับ AI agent deployment ที่ต้องการทั้งความเร็วและต้นทุนต่ำ นักพัฒนาที่มอง M3.1 Flash เป็นทางออกด้านต้นทุนพัฒนา AI จึงต้องคิดถึงสถาปัตยกรรมการให้บริการไปพร้อมกัน ไม่ใช่แค่การเรียก API แบบดั้งเดิม
จากต้นทุนสู่กลยุทธ์: ก้าวต่อไปของ M3.1 Flash สำหรับนักพัฒนา
MiniMax ระบุว่าจะเปิดเผยค่าน้ำหนักของรุ่น Flash ในภายหลัง และจะมีโมเดลรุ่น Pro ที่มีความสามารถสูงกว่าตามออกมาในอนาคต นี่คือสัญญาณว่ารุ่น Flash ถูกวางตำแหน่งเป็นฐานสำหรับงานเอเจนต์ที่ต้องการต้นทุนต่ำและความเร็วสูง ขณะที่รุ่น Pro จะเติมเต็มช่องว่างด้านความสามารถเพิ่มเติม สำหรับนักพัฒนา การวางแผนสถาปัตยกรรมจึงควรมอง M3.1 Flash เป็นชั้นงานเอเจนต์หลัก และเตรียมช่องทางเชื่อมต่อไปยังโมเดลที่มีความสามารถสูงกว่าเมื่อจำเป็น ในทางปฏิบัติ สิ่งที่ควรทำต่อจากนี้คือรอข้อมูลประสิทธิภาพจาก Inferact ที่เฉพาะเจาะจงกับโมเดลนี้ ทดสอบเวิร์กโหลดเอเจนต์ของตนเองกับหน้าต่างบริบท 1 ล้านโทเคนและโหมด reasoning ที่เปิดตลอดเวลา และออกแบบการแคชคำนำหน้าให้เหมาะกับลูปเอเจนต์ที่ใช้พรอมต์ซ้ำ หากทำได้ดี นักพัฒนาจะได้ประโยชน์จากการลดต้นทุนการประมวลผลลงอย่างมาก โดยไม่ต้องแลกกับการลดคุณภาพการให้เหตุผลของโมเดล สรุปแล้ว M3.1 Flash ไม่ได้แค่ลดต้นทุนพัฒนา AI แต่กำลังบังคับให้ทุกคนคิดใหม่เรื่องสถาปัตยกรรมการให้บริการเอเจนต์ตั้งแต่ต้นน้ำ