
ภาพใหญ่: โมเดล AI เปิดน้ำหนักไม่ใช่ของเล่นอีกต่อไป
โมเดล AI เปิดน้ำหนัก คือโมเดลปัญญาประดิษฐ์ที่ผู้พัฒนาสามารถดาวน์โหลดน้ำหนักพารามิเตอร์ไปติดตั้งและปรับแต่งเองบนโครงสร้างพื้นฐานขององค์กรได้ ต่างจากโมเดลปิดที่ให้ใช้ผ่าน API เท่านั้น การเปิดน้ำหนักช่วยให้ควบคุมข้อมูล ความปลอดภัย และต้นทุนระยะยาวได้มากขึ้น แต่ต้องแลกกับการลงทุนฮาร์ดแวร์และทีมวิศวกรที่เข้าใจการรันโมเดลขนาดใหญ่ในระดับศูนย์ข้อมูล
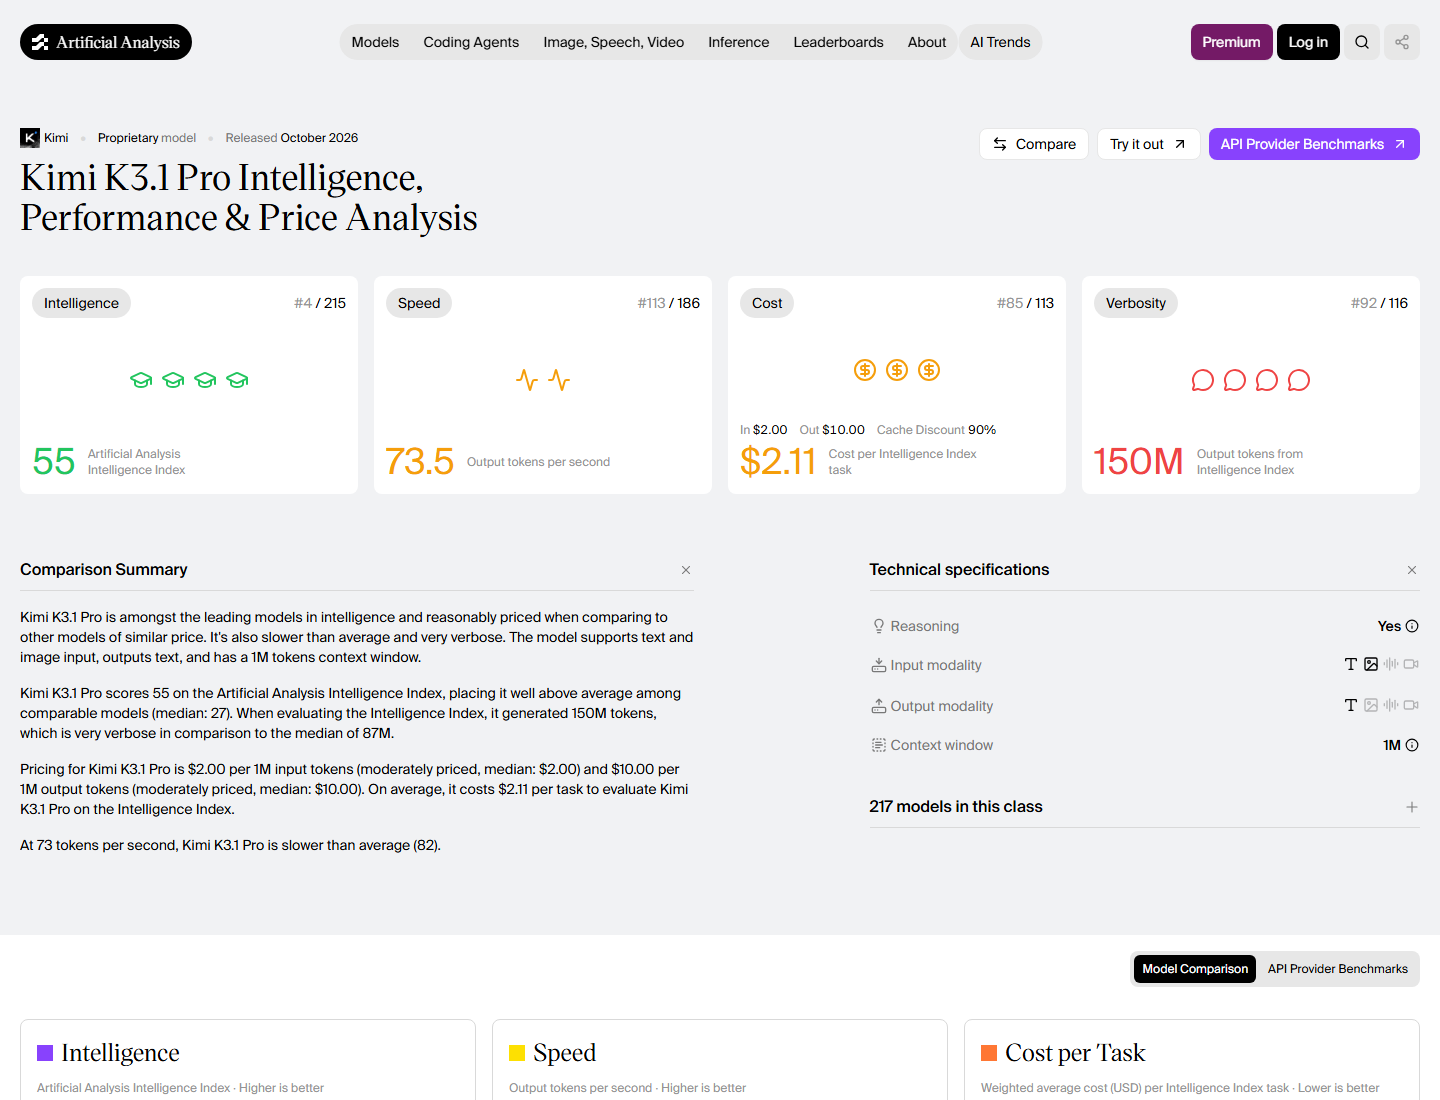
ประเด็นสำคัญของช่วงนี้คือ โมเดล AI เปิดน้ำหนักเริ่มไล่ระดับความสามารถโมเดลปิดทันจนต้องมองใหม่ว่าอะไรคือทางเลือกที่คุ้มค่ากว่าสำหรับองค์กร Kimi K3.1 Pro จาก Moonshot AI เปิดตัวเมื่อวันที่ 23 ตุลาคม พร้อมรุ่น K3.1 Pro Highspeed ที่เร็วขึ้น 2–3 เท่า และทำคะแนนบน Intelligence Index v4.3 ได้ 55.1 คะแนน ลดช่องว่างกับโมเดลปิดชั้นนำเหลือเพียงไม่กี่แต้ม ด้าน MiniMax M3.1 Flash ก็ปล่อยน้ำหนักให้ดาวน์โหลดได้แล้วในรูปแบบโมเดลเปิดน้ำหนักบนแพลตฟอร์มสาธารณะโดยไม่ต้องขอสิทธิ์ก่อน ภาพรวมคือยุคที่โมเดลเปิดน้ำหนักเริ่มมีสิทธิ์นั่งโต๊ะเดียวกับโมเดลปิดในงานระดับองค์กร
| Spec | Kimi K3.1 Pro | MiniMax M3.1 Flash |
|---|---|---|
| คะแนนหลักจาก Artificial Analysis | 55.1 บน Intelligence Index v4.3 | ไม่มีคะแนนชุดเดียวกันในแหล่งเดียวกัน |
| ขนาดโมเดลรวม | ประมาณ 2.8T พารามิเตอร์ ใช้งานจริง 104B | ประมาณ 428B พารามิเตอร์ ใช้งานจริง 23B ต่อโทเคน |
| context สูงสุด | 1M โทเคน | 1M โทเคน รองรับข้อความ ภาพ วิดีโอ |
Kimi K3.1 Pro: โมเดล API วันนี้ โมเดลเปิดน้ำหนักพรุ่งนี้
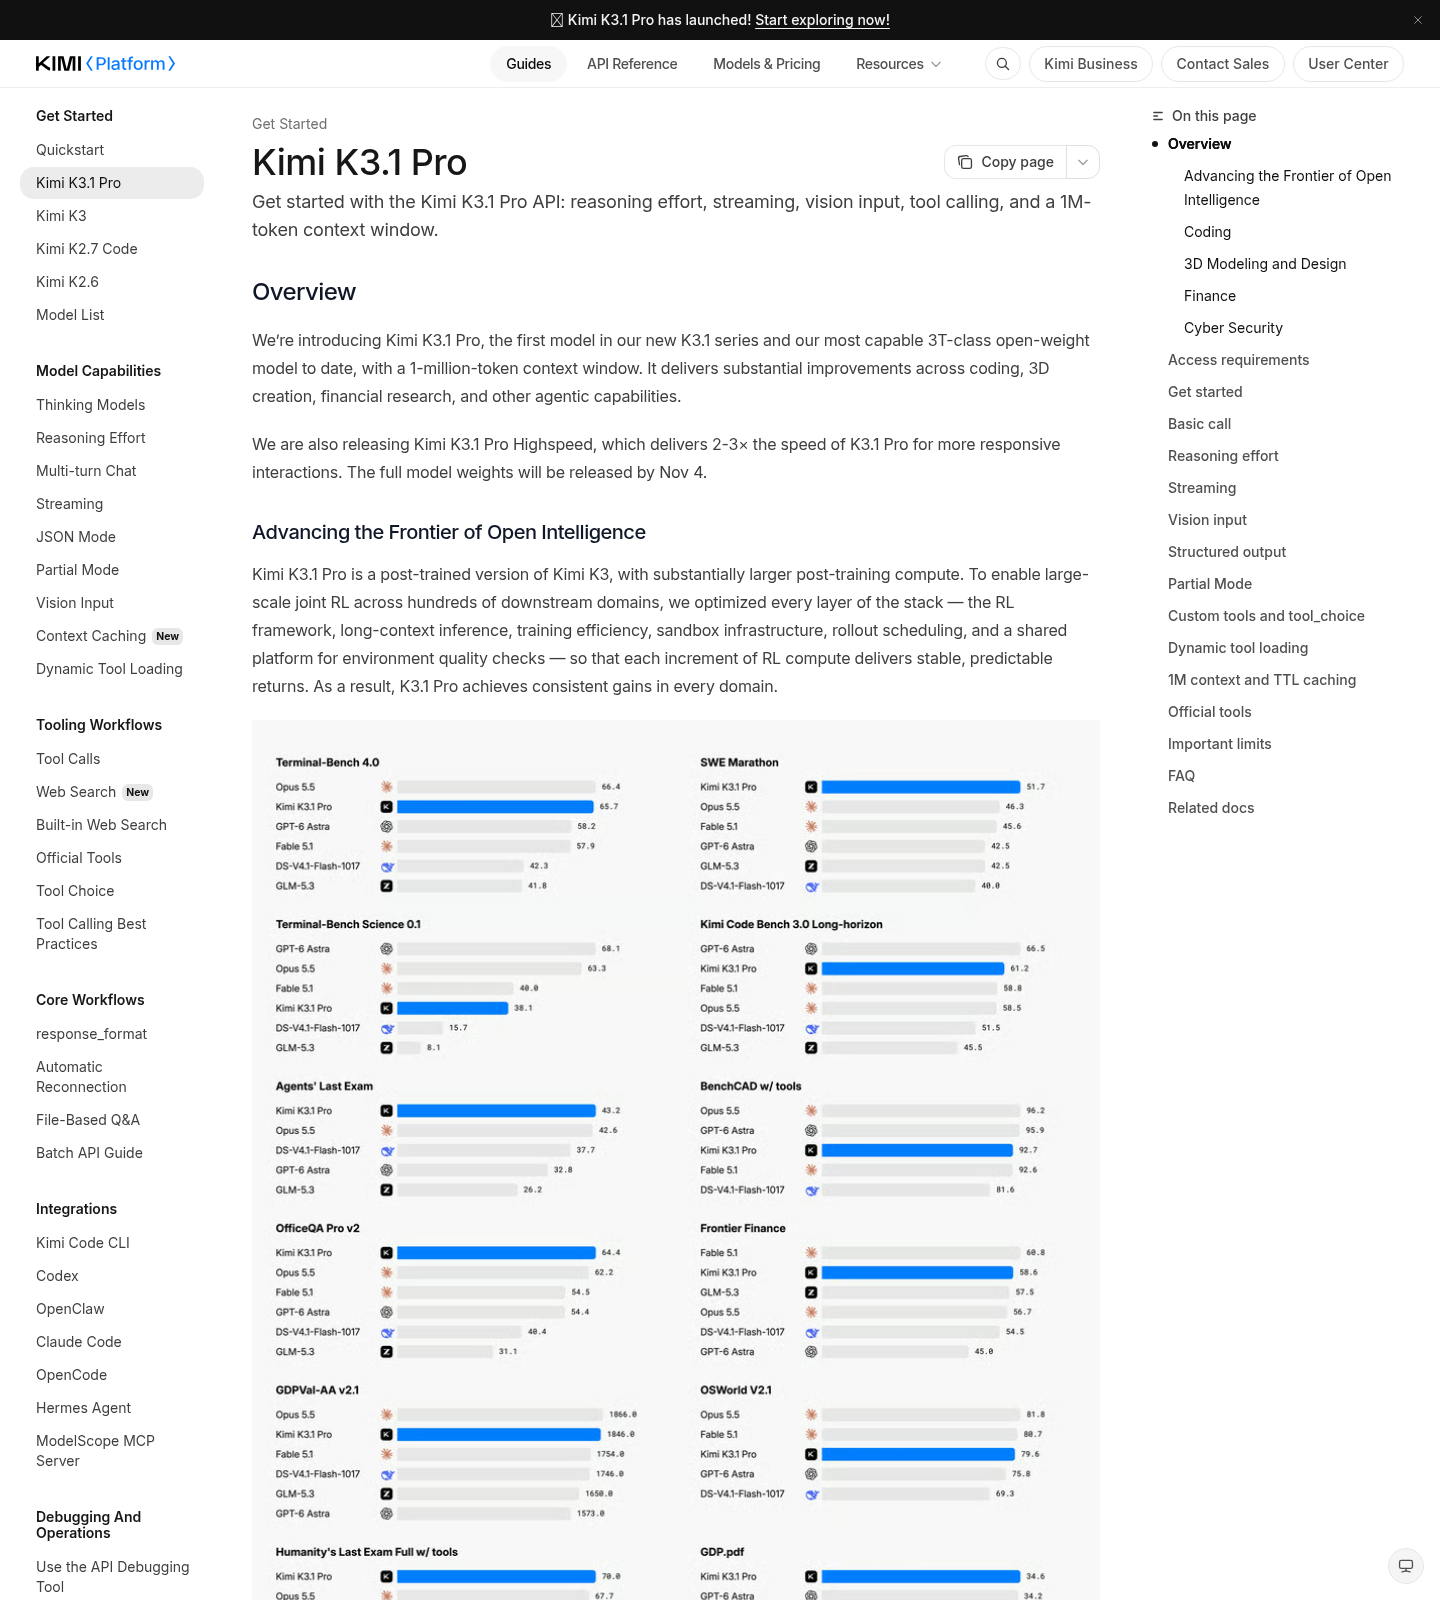
Kimi K3.1 Pro เป็นตัวอย่างชัดเจนว่าความสามารถโมเดล AI เปิดน้ำหนักกำลังไล่ทันโมเดลปิดอย่างจริงจัง Moonshot ระบุว่าเป็น “a post-trained version of Kimi K3, with substantially larger post-training compute” คือไม่เปลี่ยนสถาปัตยกรรมหลัก แต่เพิ่มการเทรนหลังด้วย RL ข้ามหลายร้อยโดเมน ปรับทั้งเฟรมเวิร์ก RL ระบบ inference สำหรับ context ยาว และ sandbox การรันงาน ผลคือโมเดลเดิมที่ถูกขัดเกลาให้คิดลึกขึ้นและจัดการงานยาวได้ดีขึ้น
ในเชิงตัวเลข K3.1 Pro ถูกบันทึกไว้ที่ขนาดประมาณ 2.8T พารามิเตอร์ ใช้งานจริง 104B และรองรับ context สูงสุด 1M โทเคนเท่ารุ่นก่อน แต่คะแนนบน Artificial Analysis กระโดดไปที่ 55.1 คะแนน ซึ่งถ้า Moonshot ปล่อยน้ำหนักตามที่สัญญา โมเดลเปิดน้ำหนักที่ดีที่สุดจะขยับขึ้นทีเดียวประมาณ 9 แต้มจากระดับเดิม คำพูดที่ควรจดคือ “ถ้าน้ำหนักออกมาจริงภายใน 4 พฤศจิกายน เท่ากับว่าโมเดลที่ดาวน์โหลดไปรันเองได้จะตามโมเดลปิดอันดับหนึ่งอยู่ราว 2–3 แต้ม และนำ GPT-6 Astra ด้วยซ้ำ” นี่คือจุดเปลี่ยน เพราะเมื่อต้นปีช่องว่างนี้ยังวัดกันเป็นรุ่นๆ อยู่เลย
ด้าน benchmark ที่ Moonshot เลือกโชว์ก็สะท้อนภาพเดียวกัน Terminal-Bench 4.0 อยู่ที่ 65.7 เปอร์เซ็นต์ สูงกว่า GPT-6 Astra ที่ 58.2 เปอร์เซ็นต์ และตามหลัง Claude Opus 5.5 ที่ 66.4 เปอร์เซ็นต์เพียงเล็กน้อย BenchCAD ที่ใช้เครื่องมือทำงานได้ 92.7 เปอร์เซ็นต์ ใกล้เคียงโมเดลปิดระดับบน และ OfficeQA Pro v2 ถูกอ้างว่าเป็นสถิติใหม่ จุดอ่อนคือหลายตัวเลขมาจาก benchmark ภายในและการเปรียบเทียบที่ไม่ได้วัดใหม่ทั้งหมด แต่ภาพรวมยังชัดว่า K3.1 Pro ไม่ใช่แค่รุ่นย่อยของ K3 แต่เป็นก้าวกระโดดด้านความสามารถโมเดล AI ที่ทำให้โลกโมเดลเปิดน้ำหนักน่าเชื่อถือขึ้นมาก
MiniMax M3.1 Flash: เปิดน้ำหนักแล้ว แต่ต้องมีคลัสเตอร์จริงถึงจะใช้ได้
ฝั่ง MiniMax M3.1 Flash เป็นอีกเสาหลักของกระแสโมเดล AI เปิดน้ำหนักรุ่นใหญ่ เดิมเปิดตัวแบบ API-only พร้อมคำสัญญาว่า “Model weights will be released later” ตอนนี้น้ำหนักถูกปล่อยบนแพลตฟอร์มสาธารณะในรูปแบบไม่ gated แล้ว ทำให้ผู้พัฒนาดาวน์โหลดไปติดตั้งเองได้ทันที การ์ดโมเดลระบุชัดว่ามีขนาดประมาณ 428B พารามิเตอร์ ใช้งานจริง 23B ต่อโทเคน รองรับอินพุตทั้งข้อความ ภาพ และวิดีโอ พร้อม context สูงสุด 1M โทเคน นี่คือสเปกที่ชัดเจนว่าตั้งใจเล่นในลีกงานองค์กรและงานมัลติโหมดเต็มรูปแบบ
อย่างไรก็ตาม M3.1 Flash ไม่ได้ให้ทุกอย่างแบบโมเดลเปิดน้ำหนักสายวิจัย น้ำหนักที่ปล่อยออกมาเป็น NVFP4 จากการเทรนแบบ quantization-aware ไม่มี BF16 เต็มความละเอียด และไฟล์รวมทั้ง repo มีขนาดราว 252GB การรันตามสูตรของ vLLM ต้องใช้ฮาร์ดแวร์ระดับศูนย์ข้อมูล เช่น NVIDIA Blackwell รุ่น GB200 GB300 B200 หรือ B300 จำนวน 4 ใบในโหมด TP4 หรือ NVIDIA Hopper อย่าง H100 หรือ H200 เต็ม node 8 ใบในโหมด TP8 นั่นหมายความว่าแม้จะเป็นโมเดลเปิดน้ำหนัก แต่ผู้ใช้ทั่วไปหรือเครื่องเดสก์ท็อปยังแทบไม่มีทางรันได้ ต้องเป็นองค์กรที่มีคลัสเตอร์ GPU หรือเช่าโหนดระดับ data center เท่านั้น
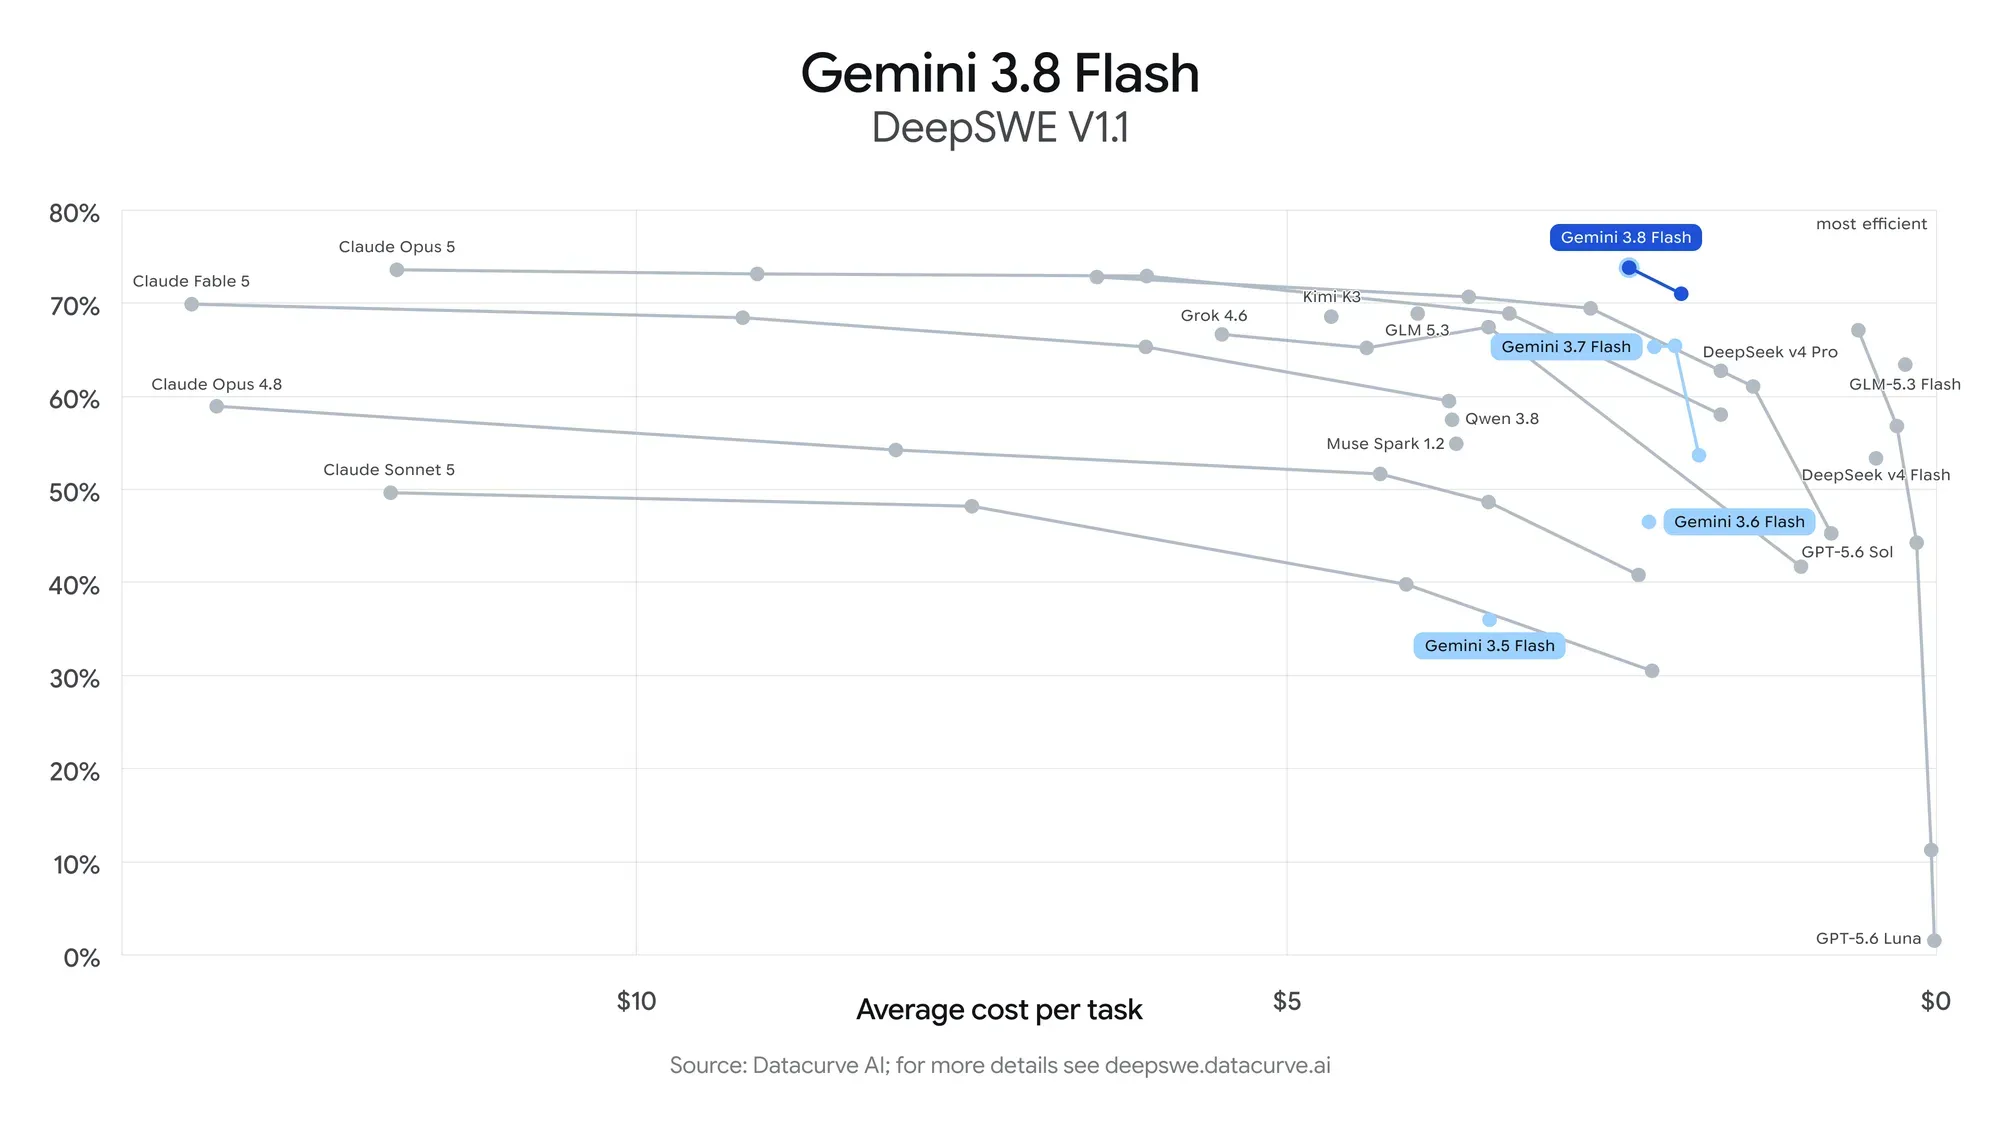
ในด้านความสามารถโมเดล AI MiniMax ใช้ชุด benchmark ที่วัดเอง เช่น DeepSWE v1.1 ที่ 73.7 OSWorld 2.0 ที่ 61.7 CyberGym 82.2 และ BankerToolBench 76.2 การ์ดยังระบุว่า “Results are for the official weights; third-party quantizations may differ” เพื่อกันความคาดหวังผิดถ้ามีคนไปแปลงน้ำหนักเอง ที่น่าสนใจคือในตารางของ MiniMax เอง DeepSeek V4.1 Flash-1017 ซึ่งเป็นโมเดลเปิดน้ำหนักเหมือนกันยังทำคะแนนได้สูงกว่าในบางชุดทดสอบ แสดงว่าการเปิดน้ำหนักไม่ได้แปลว่าต้องเป็นโมเดลที่เก่งที่สุดเสมอ แต่เป็นการให้สิทธิ์ผู้ใช้เลือกว่าจะแลกความยืดหยุ่นกับคะแนน benchmark แค่ไหน
ข้อดีข้อเสียสำหรับนักพัฒนา: API สะดวกกว่า แต่เปิดน้ำหนักคุมเกมได้มากกว่า
เมื่อมองจากมุมทีมพัฒนา โมเดล AI เปิดน้ำหนักอย่าง Kimi K3.1 Pro และ MiniMax M3.1 Flash กำลังสร้างสมดุลใหม่ระหว่างความสะดวกและการควบคุม K3.1 Pro วันนี้ยังเป็นโมเดลแบบ API เท่านั้นเหมือน M3.1 Flash ตอนเปิดตัว แต่บล็อกเปิดตัวเขียนชัดว่า “Full model weights will be released by Nov 4, 2026” ถ้าน้ำหนักออกมาตามสัญญา โมเดลที่ดาวน์โหลดไปรันเองได้จะตามโมเดลปิดอันดับหนึ่งอยู่ราว 2–3 แต้ม และนำ GPT-6 Astra ด้วย นั่นทำให้คำถามใหญ่ไม่ใช่ว่าเปิดน้ำหนักดีหรือไม่ แต่คือองค์กรพร้อมจะรับภาระการรันโมเดลเองหรือยัง
ข้อดีของโมเดลเปิดน้ำหนัก
- ควบคุมข้อมูลและความเป็นส่วนตัวได้ดีกว่า เพราะรันบนโครงสร้างพื้นฐานของตัวเอง
- ปรับแต่งโมเดลให้เข้ากับโดเมนงานเฉพาะได้ลึกกว่า ทั้งการ fine-tune และการต่อยอดเครื่องมือ
- ลดการผูกติดกับผู้ให้บริการ API รายเดียว โดยเฉพาะเมื่อมีการเปลี่ยนรุ่นหรือเลิกให้บริการ เช่นกรณี K2 series ที่จะปลดระวางภายในสิ้นเดือนธันวาคม
- เมื่อคะแนนความสามารถโมเดล AI ใกล้เคียงโมเดลปิด ช่องว่างด้านคุณภาพไม่ใช่ข้ออ้างใหญ่ในการไม่เปิดน้ำหนักอีกต่อไป
ข้อเสียและข้อจำกัด
- ต้องลงทุนฮาร์ดแวร์ระดับ B200 หรือ H100 คลัสเตอร์ตามสูตรของ vLLM สำหรับโมเดลอย่าง M3.1 Flash
- ต้องมีทีมวิศวกรที่เข้าใจการรันโมเดลขนาดใหญ่ การจัดการหน่วยความจำ และการอัปเดตเวอร์ชันอย่างสม่ำเสมอ
- บางโมเดลเปิดน้ำหนักไม่ได้ให้ไฟล์ความละเอียดเต็ม เช่น M3.1 Flash ที่มีเฉพาะ NVFP4 จากการเทรนแบบ quantization-aware
- สัญญาการปล่อยน้ำหนักยังเป็นความเสี่ยง ถ้าเลยกำหนดหรือเปลี่ยนนโยบายกลางทาง องค์กรที่วางแผนรออาจต้องปรับกลยุทธ์ใหม่
ฝั่ง API ยังมีข้อดีเรื่องความเร็วในการเริ่มใช้และการไม่ต้องดูแลโครงสร้างพื้นฐานเอง ตัวอย่างคือ K3.1 Pro Highspeed ที่เร็วกว่า 2–3 เท่าและเปิดให้ใช้ผ่าน API ทันที แต่ก็มีรายละเอียดที่นักพัฒนาต้องระวัง เช่นการตั้งค่า reasoning_effort ที่ค่าเริ่มต้นเป็นระดับสูงสุด ทำให้การเรียกแต่ละครั้งใช้ compute มากกว่าที่คิด ภาพรวมคือยุคที่ทีมพัฒนาต้องอ่านเอกสารให้ลึกกว่าชื่อรุ่น และคิดทั้งเรื่องสัญญาเปิดน้ำหนักและต้นทุนการรันจริงไปพร้อมกัน
บทสรุป: ช่องว่าง 9 แต้มที่เปลี่ยนเกมของโมเดลเปิดน้ำหนัก
ตัวเลขที่สำคัญที่สุดในข่าวนี้คือช่องว่างประมาณ 9 แต้มบน Artificial Analysis เมื่อเทียบ Kimi K3.1 Pro กับโมเดล AI เปิดน้ำหนักที่ดีที่สุดก่อนหน้า ช่องว่างที่เคยกว้างจนต้องเลือกโมเดลปิดโดยไม่คิดมากกำลังหดเหลือระดับที่ต้องชั่งน้ำหนักใหม่ระหว่างความสามารถโมเดล AI กับสิทธิ์ในการควบคุมระบบเอง ถ้าน้ำหนักของ K3.1 Pro ออกมาตามกำหนด 4 พฤศจิกายน โมเดลที่ดาวน์โหลดไปรันเองได้จะเข้าใกล้โมเดลปิดอันดับหนึ่งในระยะไม่กี่แต้ม และแซง GPT-6 Astra ตามตัวเลขที่มีอยู่ นี่ไม่ใช่แค่ชัยชนะของค่ายใดค่ายหนึ่ง แต่เป็นสัญญาณว่าโมเดลเปิดน้ำหนักกำลังกลายเป็นตัวเลือกหลักในโลกองค์กร
ฝั่ง MiniMax M3.1 Flash ก็ปิดคำถามว่าคำว่า “open-weight” ในหน้า release notes เป็นจริงหรือไม่ด้วยการปล่อยน้ำหนักบนแพลตฟอร์มสาธารณะโดยไม่ gated แม้จะมีข้อจำกัดเรื่องรูปแบบน้ำหนัก NVFP4 และฮาร์ดแวร์ระดับสูงที่ต้องใช้ แต่ก็แสดงให้เห็นว่าค่ายใหญ่เริ่มกล้าเปิดโมเดลระดับเรือธงให้ผู้ใช้แตะต้องได้มากขึ้น ความท้าทายต่อไปคือการทำให้โมเดลเปิดน้ำหนักเหล่านี้เข้าถึงได้ง่ายขึ้นทั้งด้านเครื่องมือและโครงสร้างพื้นฐาน เพื่อให้ทีมพัฒนาขนาดกลางสามารถใช้ประโยชน์ได้จริง ไม่ใช่แค่บริษัทที่มีคลัสเตอร์ GPU ขนาดใหญ่เท่านั้น ส่วน M3.1 Pro ที่ถูกบอกว่าจะตามมาในอนาคตยังไม่มีวี่แววและต้องรอดูว่าจะเดินตามแนวทางเปิดน้ำหนักมากน้อยแค่ไหน
สำหรับผู้อ่านที่กำลังวางแผนระบบ AI ระดับองค์กร ข้อเสนอแนะตรงไปตรงมาคืออย่ามองโมเดลเปิดน้ำหนักเป็นตัวเลือกสำรองอีกต่อไป ให้เริ่มออกแบบสถาปัตยกรรมที่รองรับทั้งการใช้ API และการรันโมเดลเอง เตรียมคำตอบว่าข้อมูลใดควรอยู่ในระบบที่ควบคุมเอง และงานใดยอมให้โมเดลปิดประมวลผลผ่านคลาวด์ได้ เมื่อช่องว่างด้านคะแนนและความสามารถโมเดล AI แคบลง การตัดสินใจจะย้ายจากคำถามว่า “โมเดลไหนเก่งสุด” ไปสู่คำถามว่า “โมเดลไหนเข้ากับกลยุทธ์ข้อมูลและโครงสร้างพื้นฐานของเราได้ดีที่สุด” ซึ่งเป็นคำถามที่สำคัญกว่ามากในระยะยาว