
คะแนนสองชุดที่ตอบคนละคำถาม
Kimi K3.1 Pro คือโมเดลปัญญาประดิษฐ์ของ Moonshot ที่เปิดตัวเมื่อ 23 ตุลาคม 2026 ในฐานะรุ่นต่อยอดจาก Kimi K3 โดยเน้นการฝึกเพิ่มเติมสำหรับงานเอเจนต์และงานวิชาชีพ คะแนนทดสอบ AI ของมันจึงควรอ่านแยกตามผู้ประเมินและวิธีทดสอบ ไม่ใช่นำตัวเลขทุกชุดมาวางเรียงแล้วสรุปว่าใครเก่งกว่าในภาพรวม ประเด็นสำคัญคือ Artificial Analysis ให้ 55 คะแนนบน Intelligence Index ส่วนตารางของ Moonshot ระบุ 65.7% บน Terminal-Bench 4.0 ตัวเลขหนึ่งเป็นดัชนีรวมการประเมินสิบรายการ ขณะที่อีกตัวเป็นผลของเบนช์มาร์กเฉพาะทาง จึงนำมาเทียบกันตรง ๆ ไม่ได้
ผู้อ่านที่เห็น 65.7 แล้วสรุปว่าโมเดลนี้เหนือคู่แข่งทั้งหมดกำลังอ่านเกินกว่าที่หลักฐานรองรับ เช่นเดียวกับการเห็น 55 แล้วมองข้ามผลด้านการเขียนโค้ดหรือการทำงานแบบเอเจนต์ คะแนนมีประโยชน์เมื่อรู้ว่ามันวัดอะไรและใครเป็นคนตั้งสนามทดสอบ
ผลอิสระกับตารางจากผู้พัฒนา
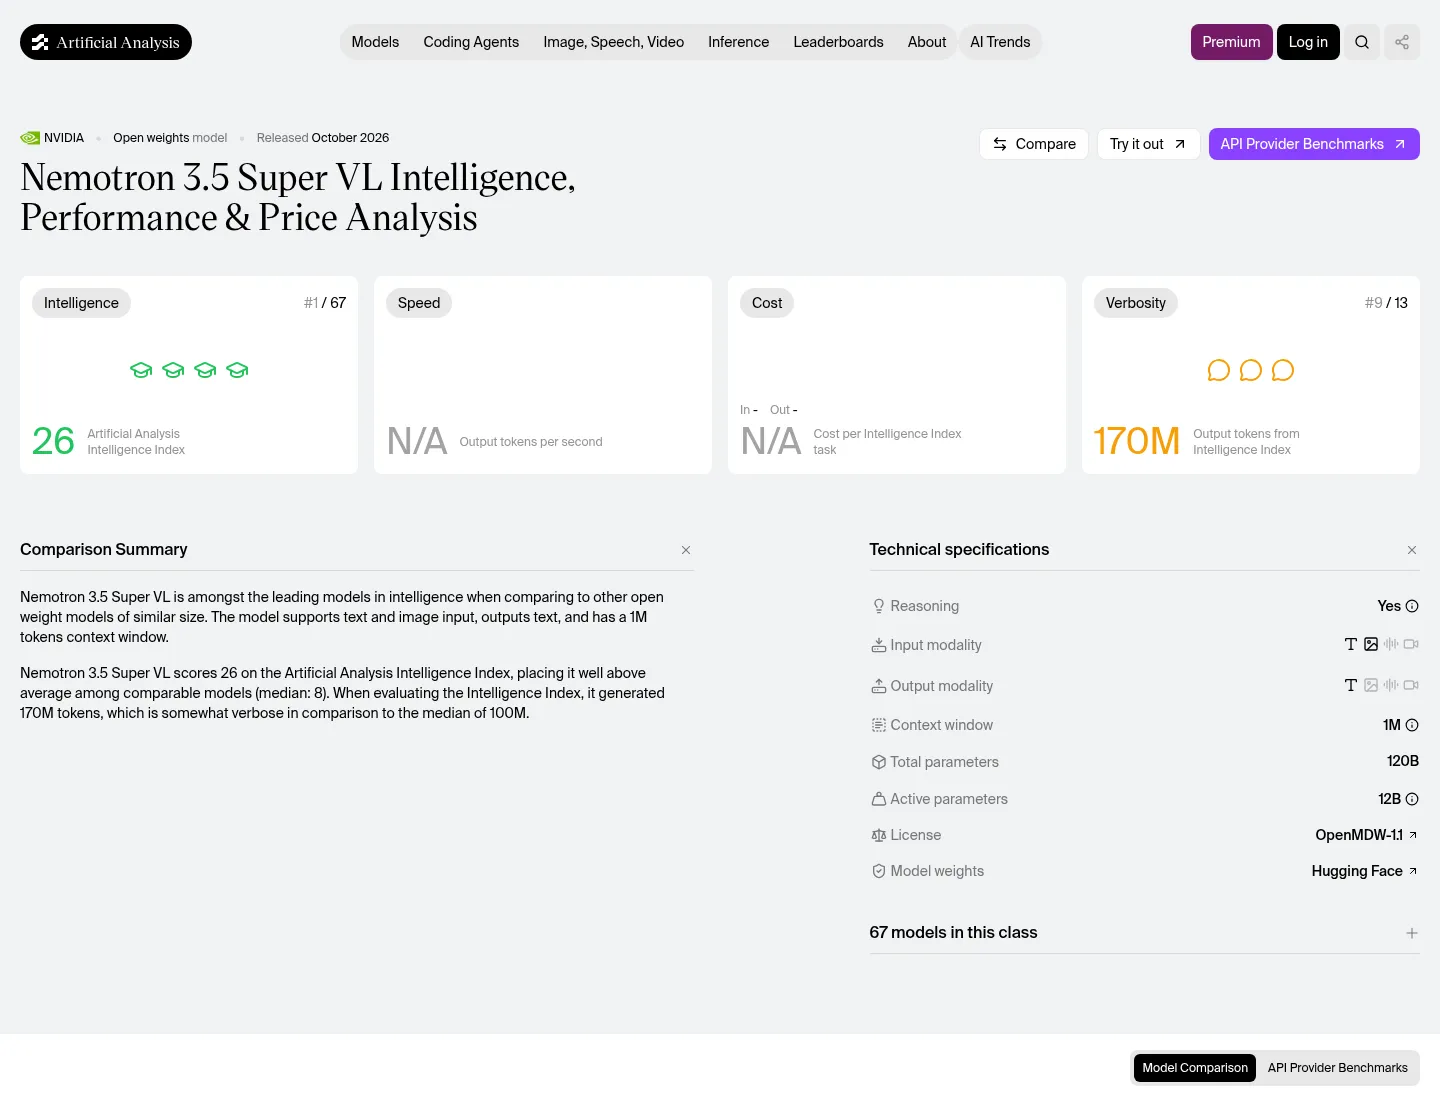
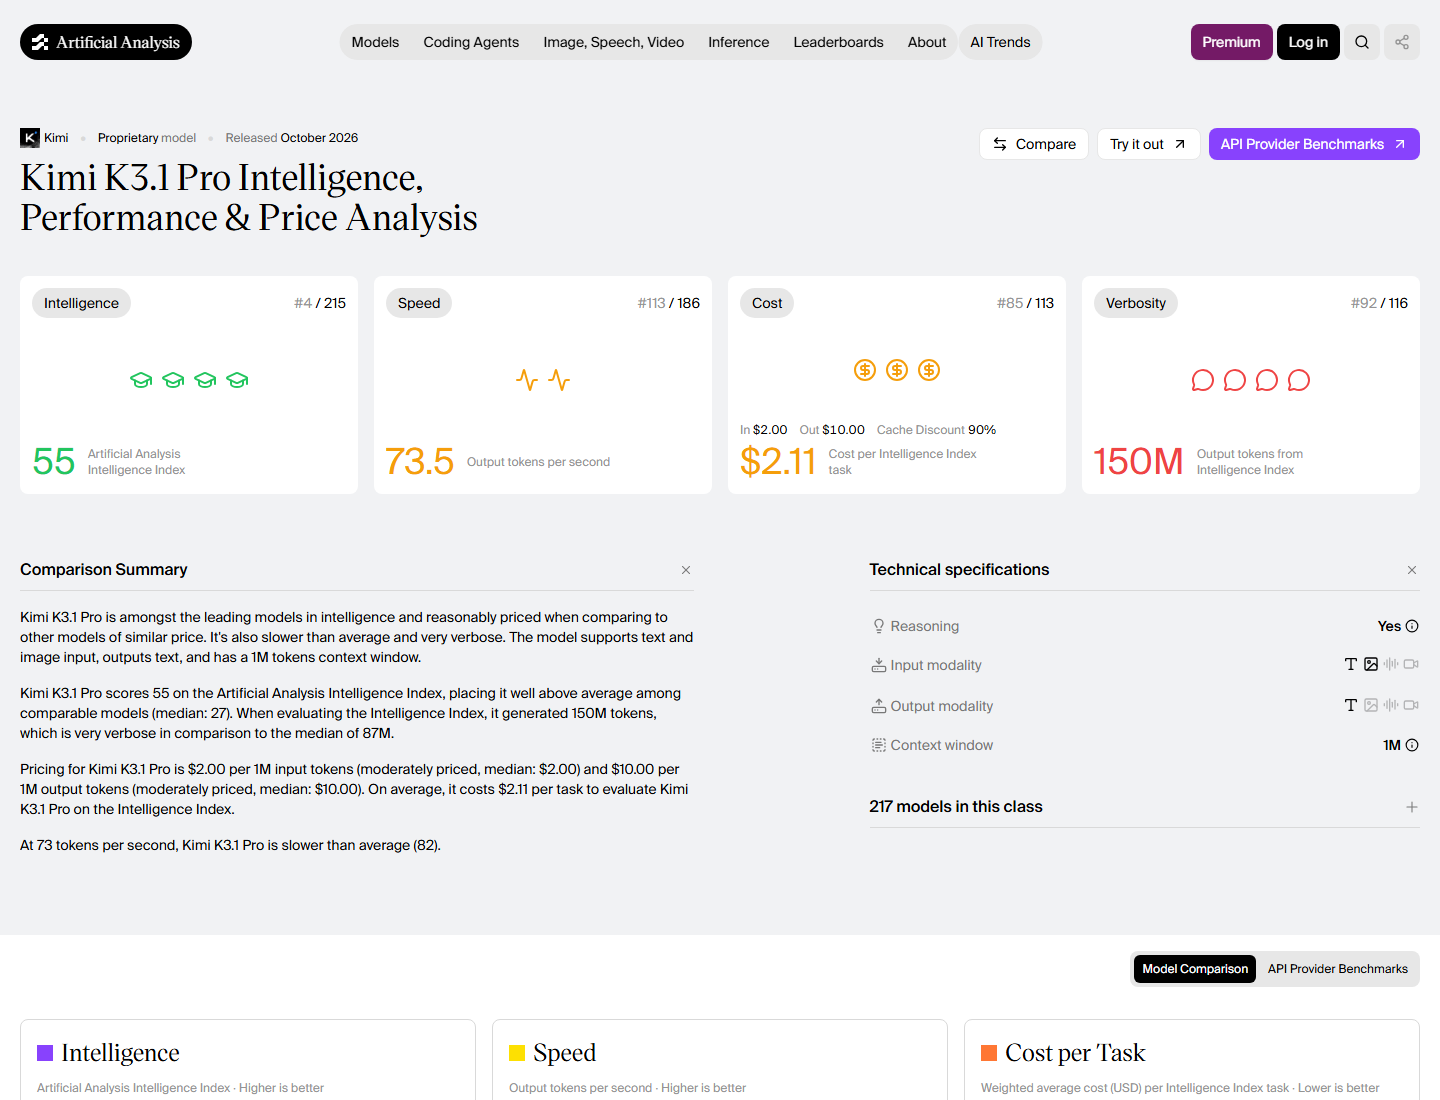
Artificial Analysis ใช้ดัชนีเวอร์ชัน 4.3.2 รวมการประเมินสิบรายการเป็น Intelligence Index และให้ Kimi 55 คะแนน อยู่อันดับสี่จาก 215 โมเดล ค่ามัธยฐานของกลุ่มอยู่ที่ 27 ส่วน GPT-6 Astra ได้ 53 และ Claude Opus 5.5 ได้ 58 บนดัชนีเวอร์ชันเดียวกัน จุดแข็งของตัวเลขนี้คือมีกรอบประเมินของผู้ประเมินรายเดียวกัน จึงเหมาะกับการเทียบโมเดลที่อยู่ในดัชนีเดียวกัน มากกว่าการนำไปเทียบกับเปอร์เซ็นต์จากเบนช์มาร์กอื่น
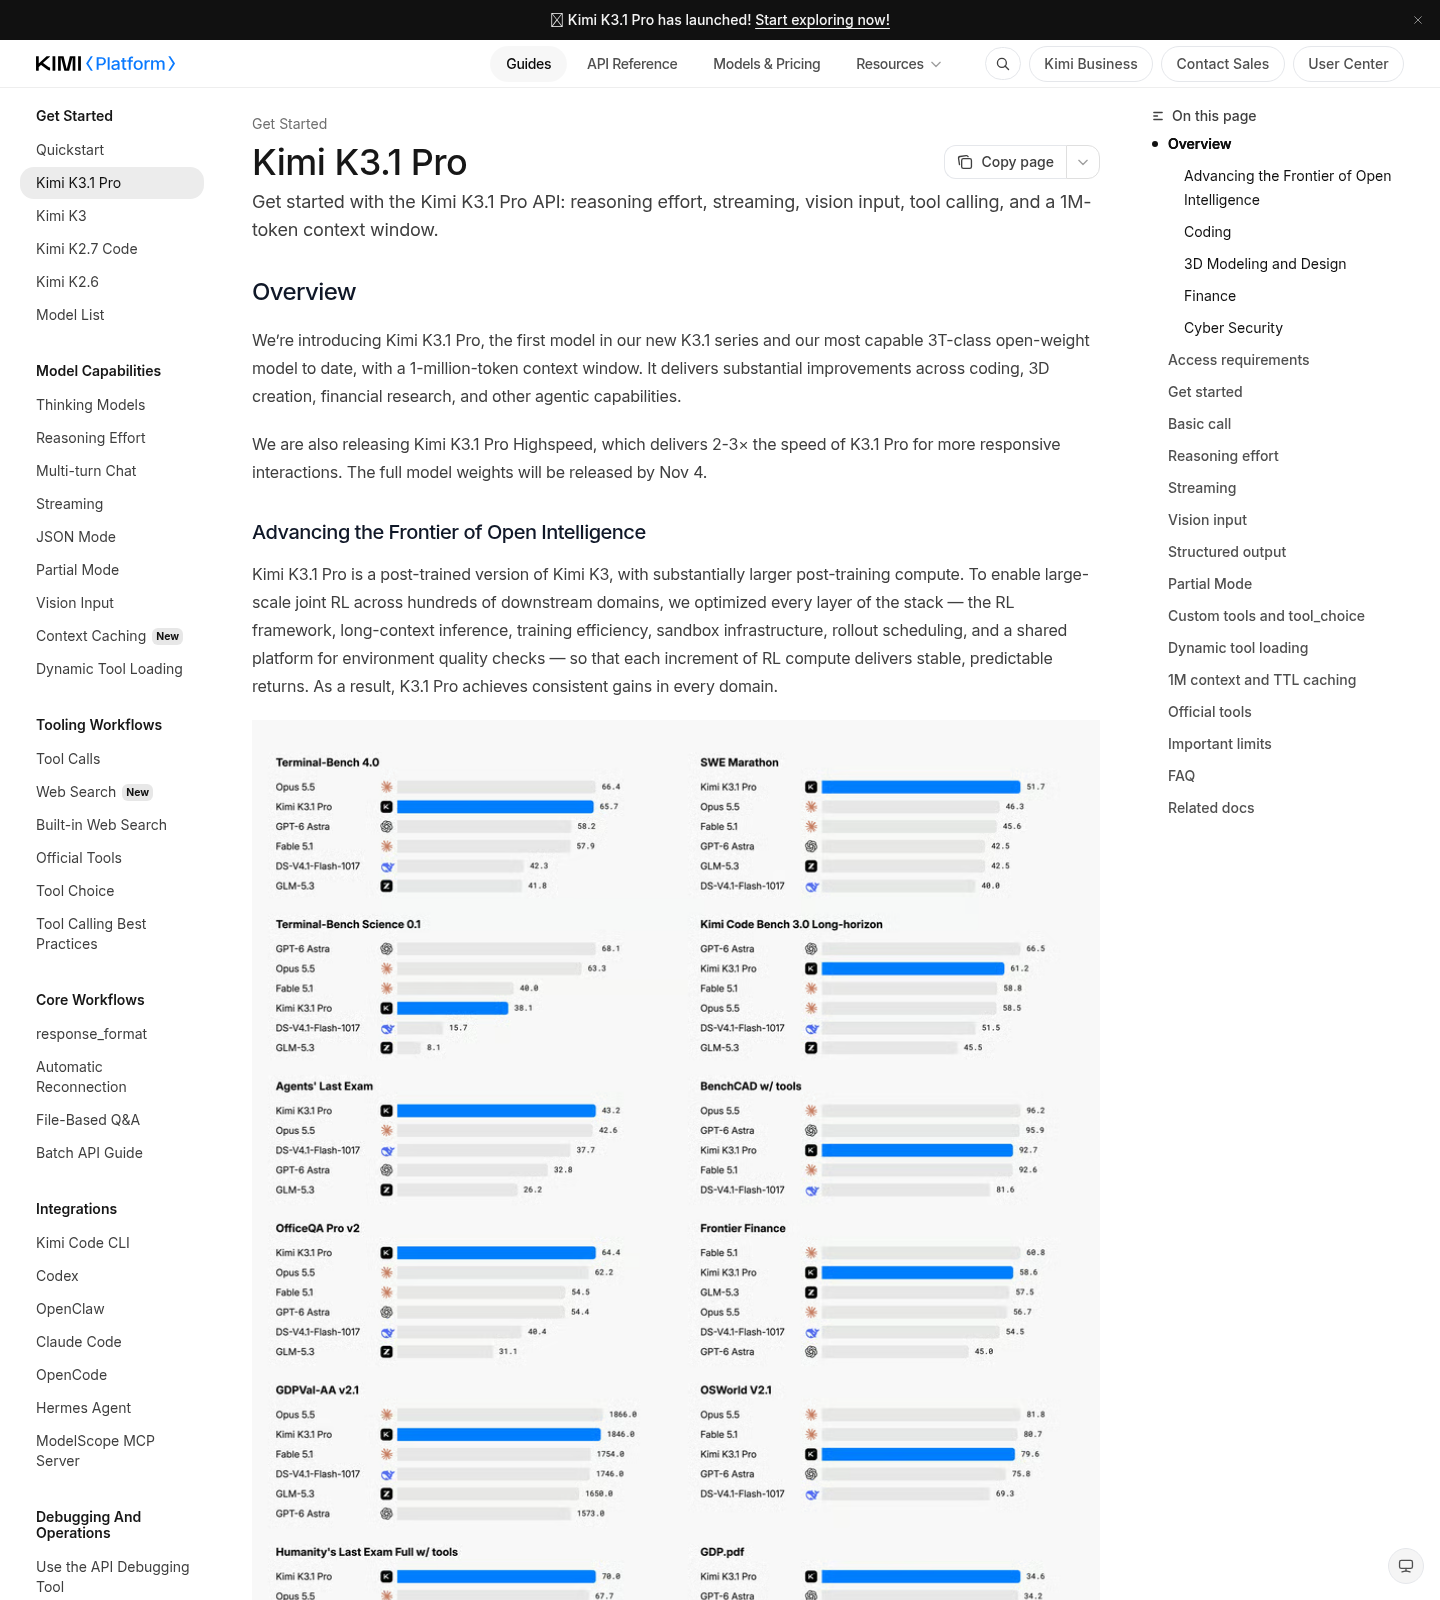
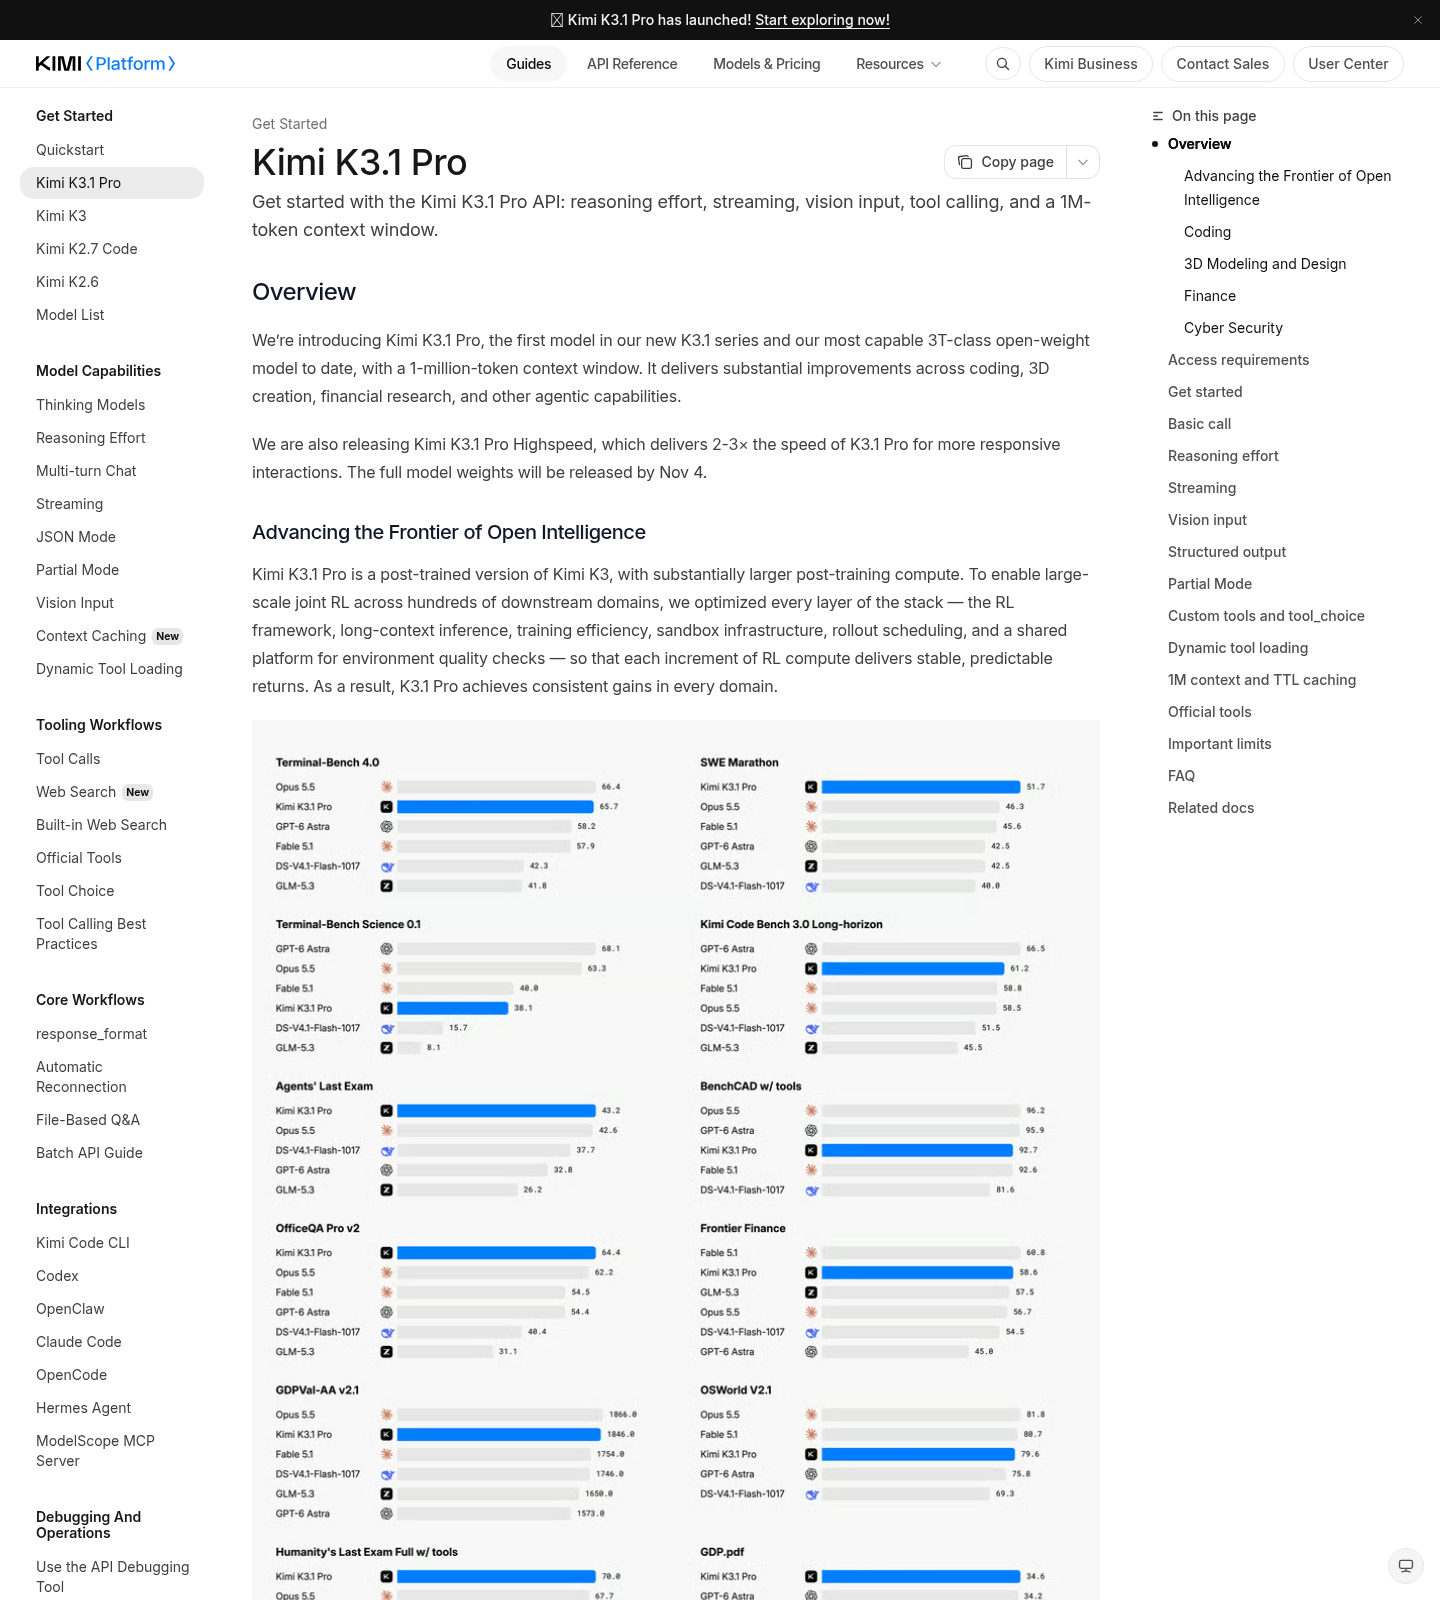
ส่วน Terminal-Bench 4.0 ในตารางของ Moonshot ให้ Kimi 65.7% เทียบกับ Claude Opus 5.5 ที่ 66.4% และ GPT-6 Astra ที่ 58.2% แต่คะแนนของ Claude ใช้ระดับความพยายาม xhigh ซึ่งสูงกว่าค่าเริ่มต้นหนึ่งระดับ ขณะที่ Kimi ใช้ค่าปริยาย max และทั้งสองผลมาจากฮาร์เนสคนละชุด นี่จึงเป็นเบาะแสจากผู้พัฒนาที่ชวนสนใจ ไม่ใช่การตัดสินแบบควบคุมเงื่อนไขครบถ้วน ตารางเบนช์มาร์กบอกทั้งความสามารถของโมเดลและผลของวิธีทดสอบ
| ชุดคะแนน | ผลของ Kimi K3.1 Pro | ที่มาและสิ่งที่วัด |
|---|---|---|
| Artificial Analysis Intelligence Index | 55 คะแนน | ดัชนีเวอร์ชัน 4.3.2 รวมการประเมินสิบรายการ |
| Terminal-Bench 4.0 | 65.7% | ตารางที่ Moonshot รายงานเอง ใช้ฮาร์เนสและเงื่อนไขการรันของผู้พัฒนา |
ช่องว่างในตารางก็เป็นข้อมูล
ตารางของ Moonshot มีแถวที่ช่วยชี้ความสามารถเฉพาะด้าน แต่ก็มีข้อมูลไม่ครบพอสำหรับข้อสรุปกว้าง ๆ Kimi Code Bench 3.0 ระยะยาวให้ 61.2% เทียบกับ 55.95% ของ Kimi K3 ซึ่งเป็นการเทียบกับรุ่นก่อนที่พอมีน้ำหนัก เพราะผู้พัฒนาควบคุมทั้งชุดทดสอบและฮาร์เนสเอง อย่างไรก็ดี การควบคุมโดยผู้พัฒนาไม่ได้แทนการประเมินอิสระ
ข้อจำกัดที่เห็นชัดคือ Terminal-Bench-Science 0.1 ซึ่งประกาศเพียงว่า Kimi สูงกว่า K3 แต่ไม่ให้คะแนน ส่วน SWE-bench ซึ่งหลายทีมใช้พูดถึงความสามารถเอเจนต์เขียนโค้ด ก็มีการเอ่ยชื่อ DeepSWE v1.1 และ SWE-Marathon v1.1 ในเชิงอรรถโดยไม่มีคะแนนเผยแพร่ ขณะที่ OfficeQA Pro v2 แสดง 64.4 แต่ไม่มีคะแนนจากผู้ขายรายอื่นในแถวเดียวกัน แถวว่างไม่ได้พิสูจน์ว่าโมเดลทำได้ไม่ดี แต่ทำให้ผู้อ่านตรวจสอบและเปรียบเทียบคำกล่าวอ้างได้ยากขึ้น
เลือกคะแนนที่เทียบกันได้ ก่อนเลือกโมเดล
หลักที่ใช้ได้จริงคือเทียบผลจากชุดทดสอบเดียวกัน ผู้ประเมินเดียวกัน และการตั้งค่าใกล้เคียงกันก่อน คะแนน 55 ของ Artificial Analysis มีประโยชน์สำหรับจัดวาง Kimi ในดัชนีเดียวกับโมเดลอื่น ส่วน 65.7% บน Terminal-Bench ช่วยบอกผลในงานที่เบนช์มาร์กนั้นกำหนด แต่ไม่ควรนำสองค่านี้มาหักลบหรือจัดอันดับข้ามกัน การจัดอันดับจากคนละฮาร์เนสอาจตอบคนละคำถาม ไม่ได้แปลว่าฝ่ายใดต้องผิด
สำหรับผู้ใช้ทั่วไป คะแนนรวมไม่บอกประสบการณ์ทั้งหมด หากงานสร้างโค้ดยาว ร่างเอกสาร หรือลูปเอเจนต์สร้างข้อความจำนวนมาก ความเยิ่นเย้อมีผลต่อปริมาณเอาต์พุตและเวลาที่ต้องรอด้วย ในการทดสอบของ Artificial Analysis โมเดลสร้างเอาต์พุต 150 ล้านโทเค็น เทียบกับค่ามัธยฐาน 87 ล้านโทเค็น และทำความเร็วได้ 73.5 โทเค็นเอาต์พุตต่อวินาที โดยมีเวลามัธยฐานถึงโทเค็นแรก 7.15 วินาที ก่อนย้ายงานจริง ควรทดลองกับทราฟฟิกของตนเองและระดับความพยายามหลายแบบ น้ำหนักโมเดลมีกำหนดเปิดภายใน 4 พฤศจิกายน 2026 หากเป็นไปตามแผนที่ประกาศไว้