
สรุปก่อนเลือก: คะแนนเสมอไม่ได้แปลว่าค่าใช้จ่ายเท่ากัน
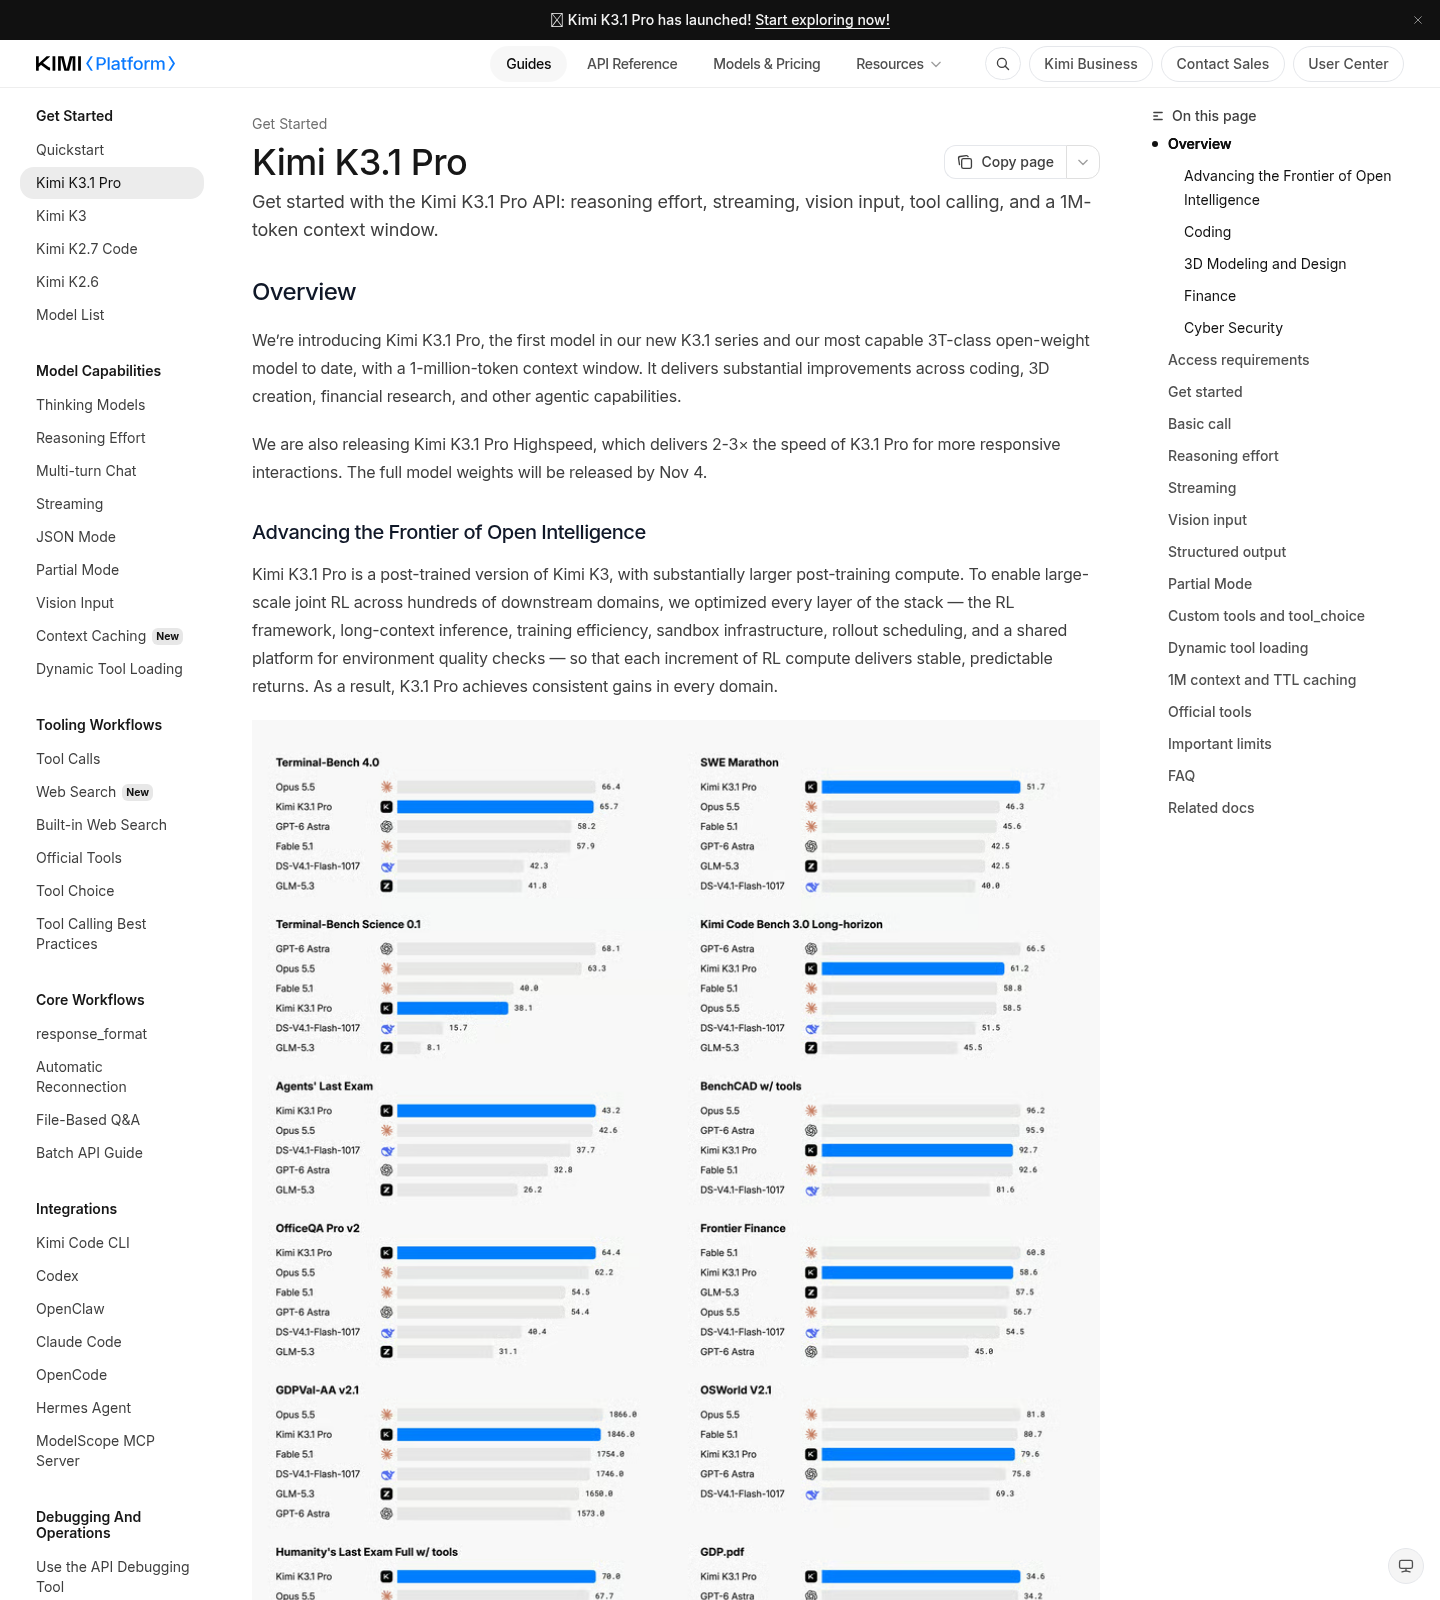
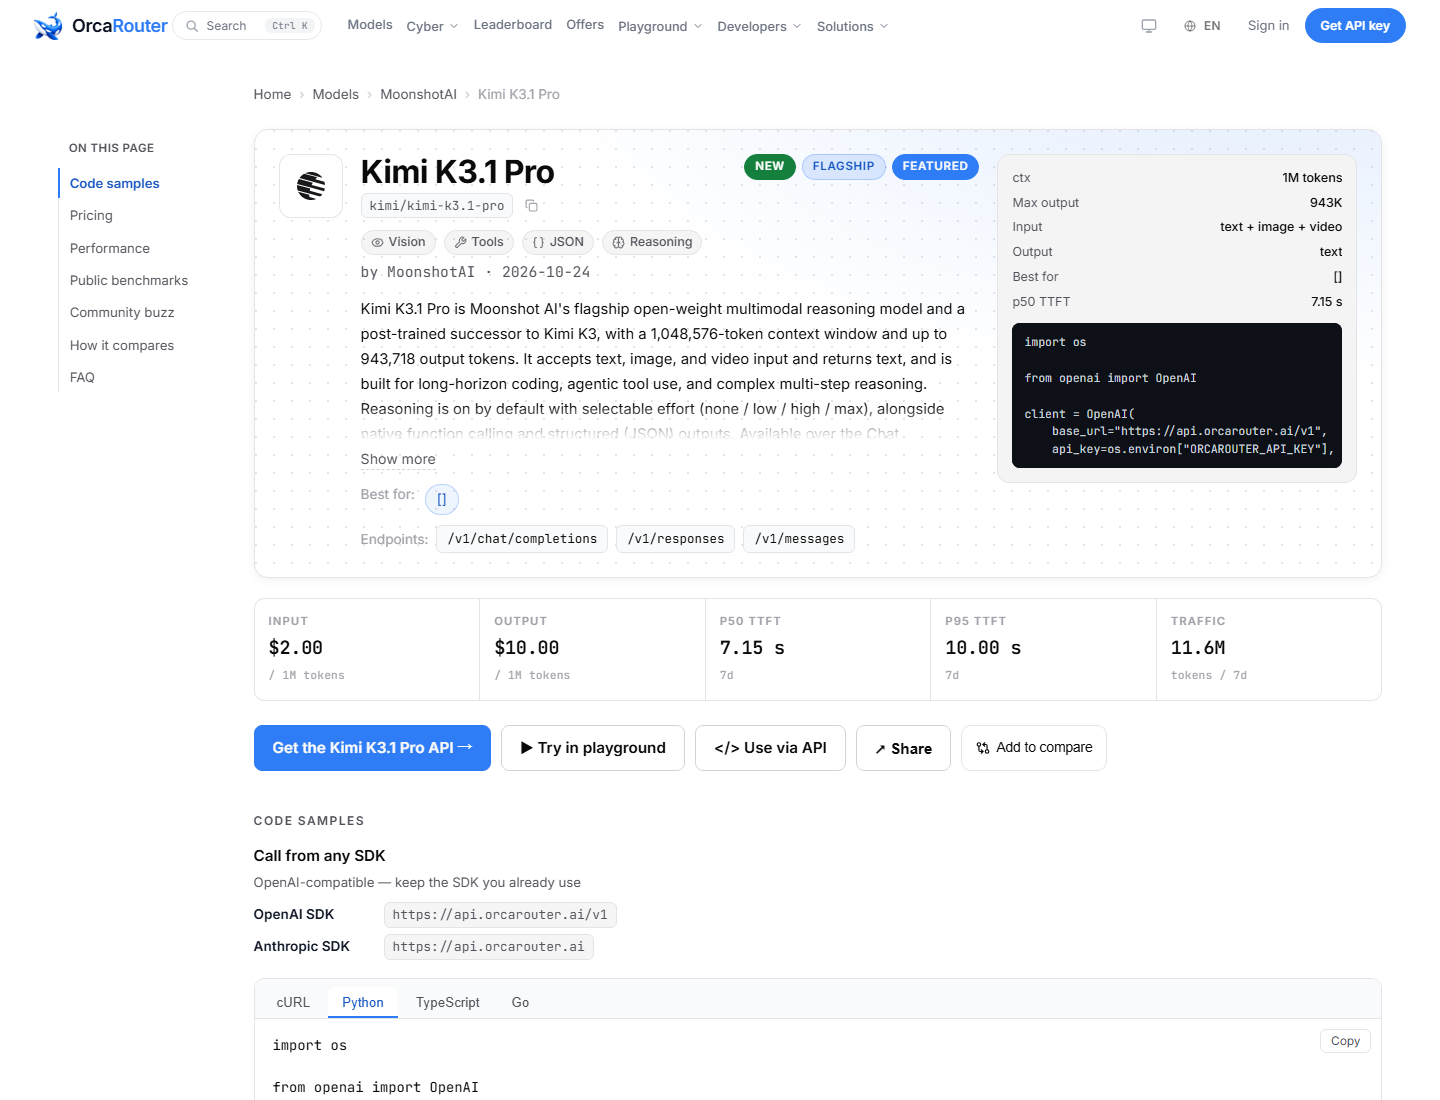
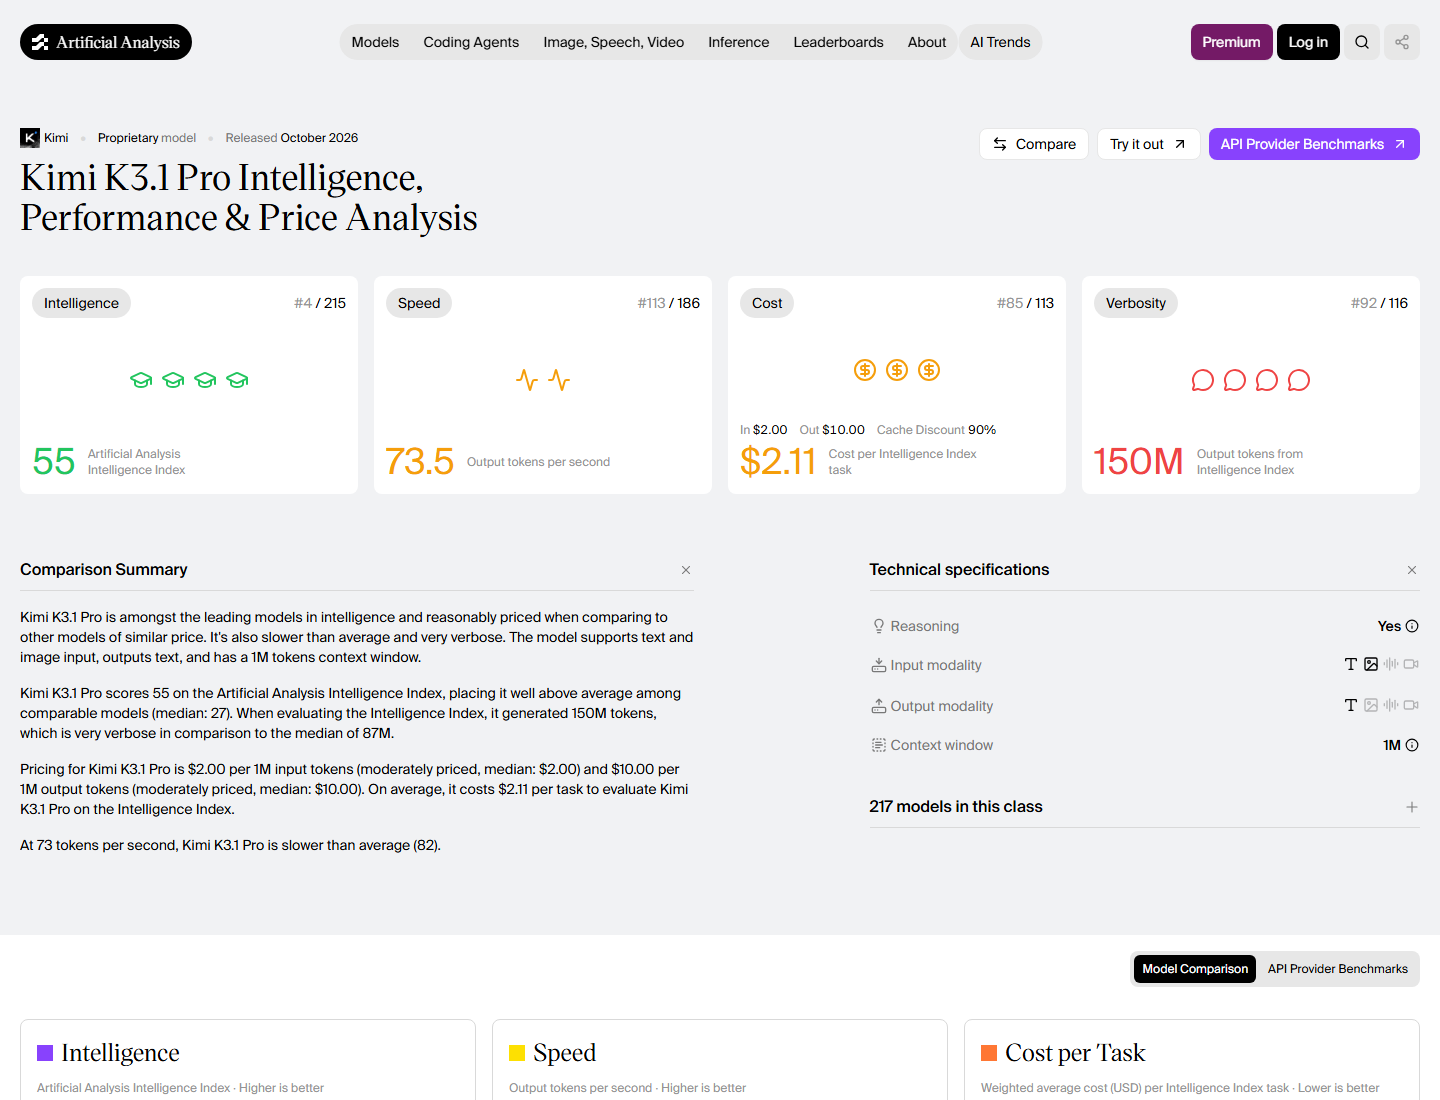
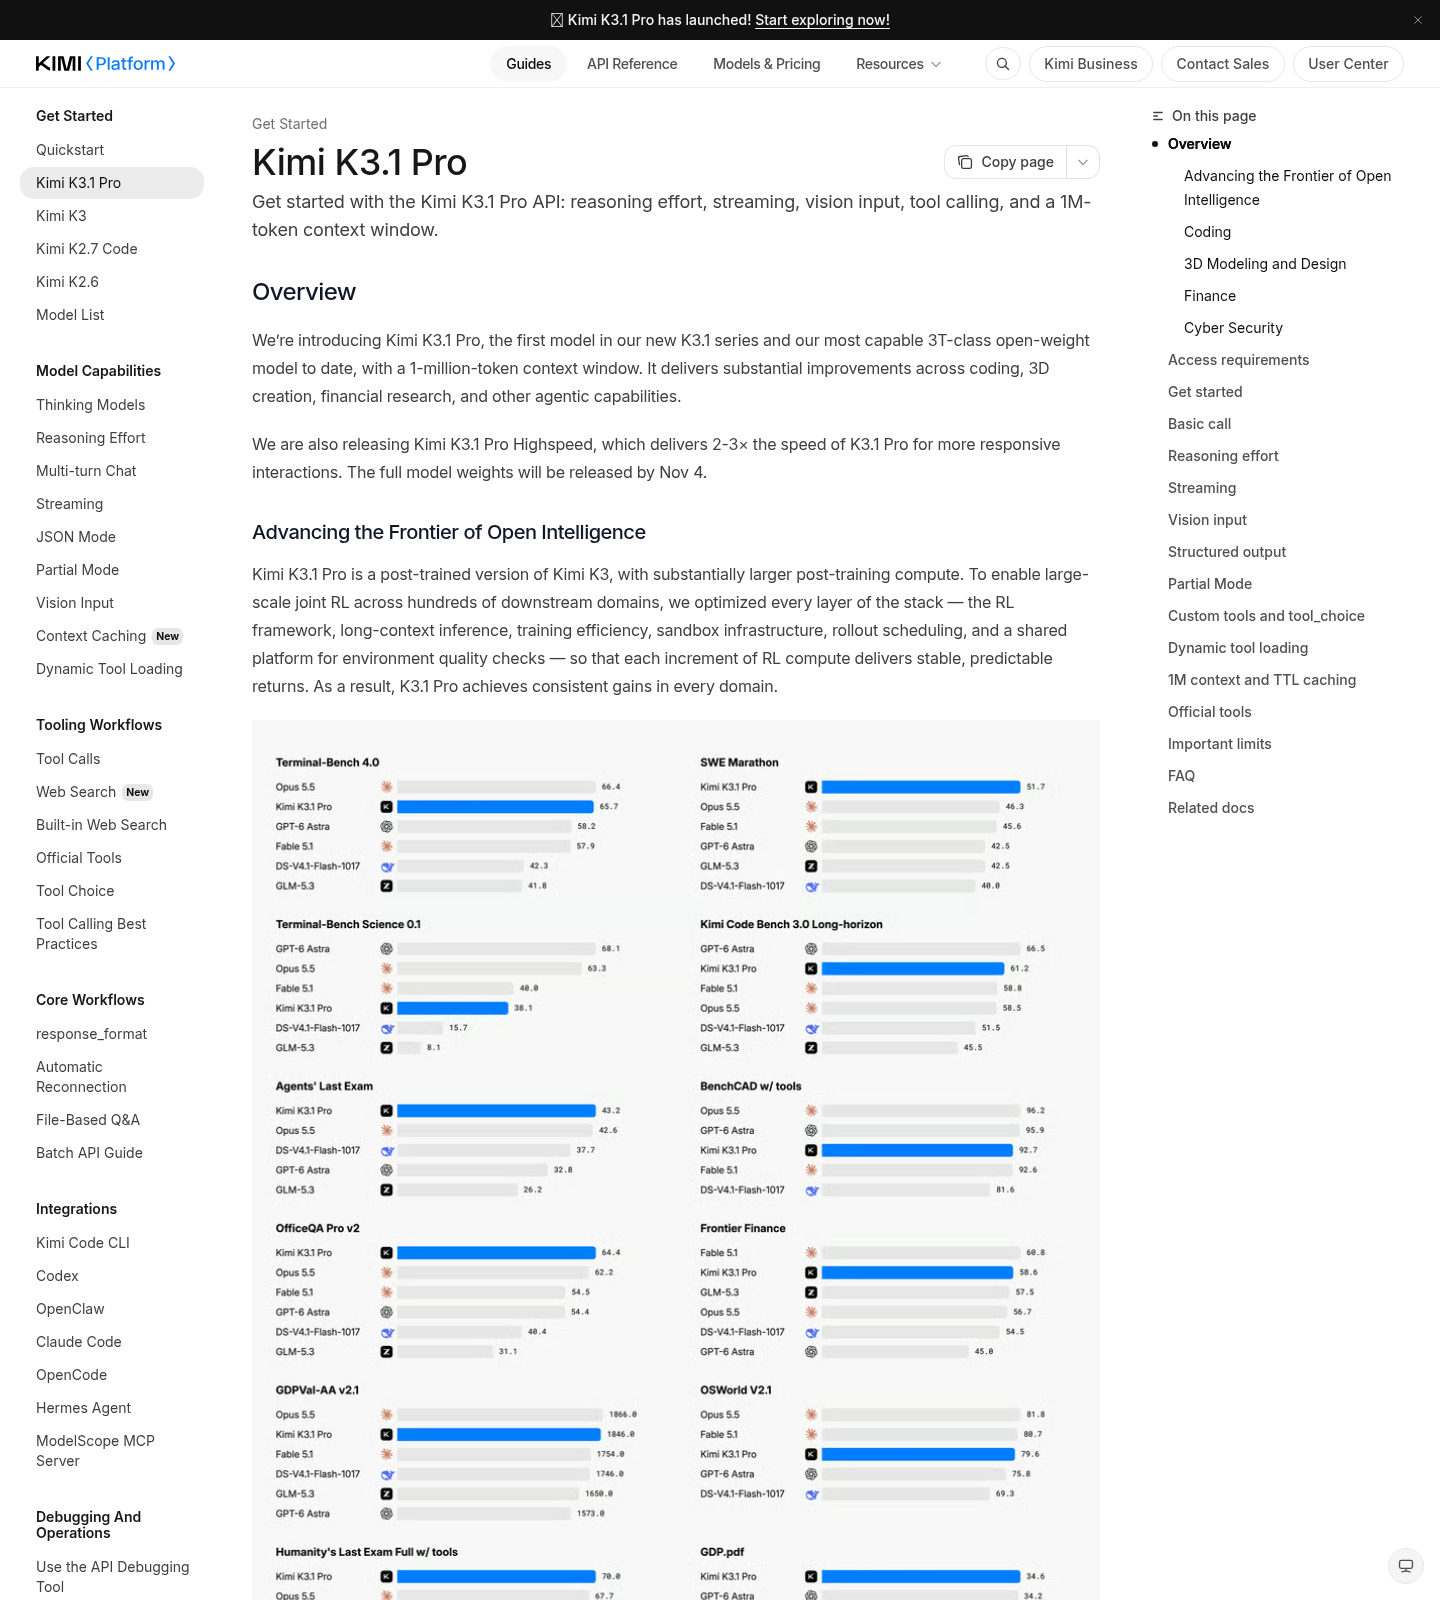
การเปรียบเทียบ AI model คือการดูทั้งความสามารถในงานจริงและต้นทุนที่เกิดจากการเรียกใช้ ไม่ใช่ตัดสินจากคะแนนทดสอบหรือราคาต่อโทเคนเพียงด้านเดียว เมื่อนำ Kimi K3.1 Pro มาเทียบกับ Grok 4.7 ผลทดสอบวิเคราะห์ข้อมูลชุดหนึ่งออกมาเสมอกัน แต่ค่าใช้จ่ายของแต่ละงานอาจสลับกันตามปริมาณอินพุต เอาต์พุต และการนำบริบทเดิมกลับมาใช้ ถ้าต้องการหน้าต่างบริบทยาวและแคชอินพุตที่ประหยัดกว่า Kimi น่าสนใจกว่า ส่วน Grok ได้เปรียบด้านอัตราเอาต์พุตในคำขอที่ไม่เกินเกณฑ์บริบทยาว และยังมีผลทดสอบบัญชีที่สูงกว่าเล็กน้อย ดังนั้น ประสิทธิภาพ AI เท่ากันเป็นข้อสรุปที่ใช้ได้กับการทดสอบชุดหนึ่ง ไม่ใช่คำตอบว่าโมเดลทั้งสองทำได้เหมือนกันทุกงาน ตารางนี้ช่วยให้เห็นเงื่อนไขหลักก่อนเลือก
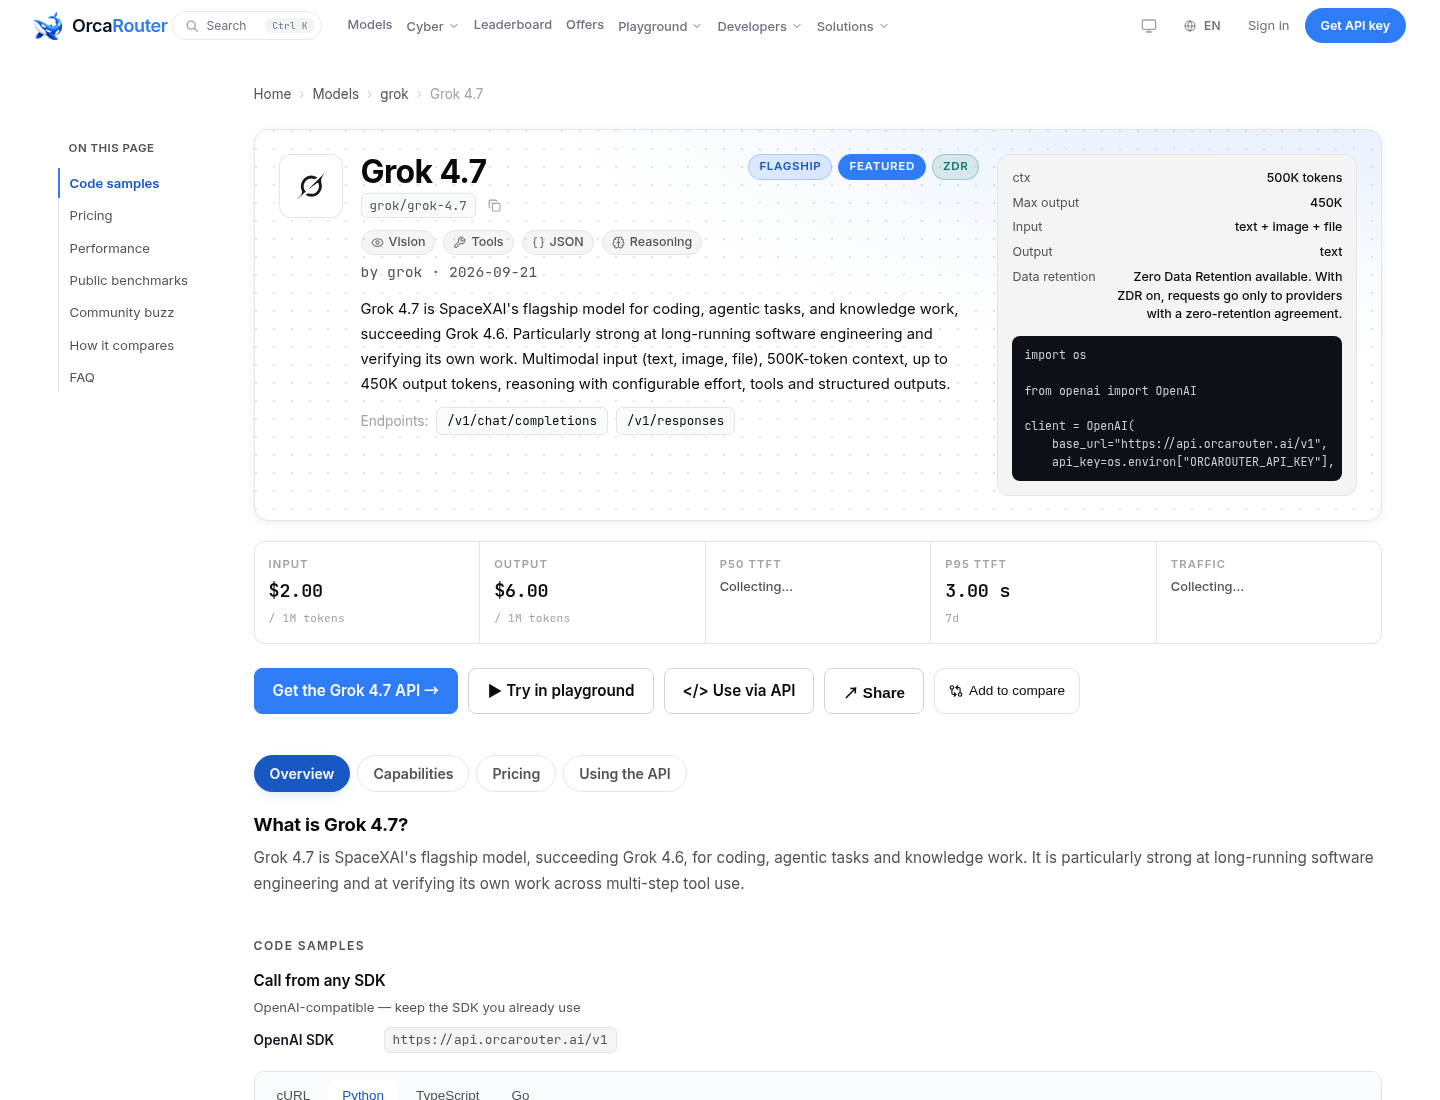
| คุณสมบัติ | Kimi K3.1 Pro | Grok 4.7 |
|---|---|---|
| บริบทสูงสุด | 1,048,576 โทเคน | 500,000 โทเคน |
| อินพุต | ข้อความ ภาพ และวิดีโอ | ข้อความ ภาพ และไฟล์ |
| ค่าใช้จ่ายอินพุต | อัตราอินพุตเท่ากัน และแคชมีต้นทุนต่ำกว่า | อัตราอินพุตเท่ากัน แต่แคชมีต้นทุนสูงกว่า |
| ค่าใช้จ่ายเอาต์พุต | อัตราสูงกว่า Grok ในคำขอที่ไม่เกินเกณฑ์บริบทยาว | อัตราต่ำกว่าในคำขอไม่เกิน 200K โทเคน และเพิ่มเมื่อเกินเกณฑ์ |
| การเข้าถึงโมเดล | มีแผนเปิดน้ำหนักโมเดล | ให้ใช้งานผ่าน API |
ผลทดสอบบอกอะไร และบอกอะไรไม่ได้
การทดสอบวิเคราะห์ข้อมูลแบบส่วนตัวของ Plotly ใช้คำถาม 43 ข้อกับคลังข้อมูลฟาร์มกังหันลมสังเคราะห์ ซึ่งโมเดลไม่เคยเห็นมาก่อน Kimi K3.1 Pro และ Grok 4.7 ทำได้ 42 ข้อเท่ากัน จึงเป็นหลักฐานตรงที่ดีว่าทั้งคู่ใกล้เคียงกันในงานวิเคราะห์ชุดนั้น แต่ไม่ควรยกระดับผลครั้งเดียวให้เป็นข้อสรุปว่าโมเดลใดแม่นยำกว่าในทุกสถานการณ์ รายละเอียดของคำตอบก็มีความหมาย Kimi พบรูปแบบที่ซ่อนอยู่ครบและระบุปัญหาคุณภาพข้อมูลได้ ขณะที่พลาดเพียงเรื่องการจัดประเภทข้อมูลบริเวณขอบเขต ส่วนการทดสอบบัญชีของ DualEntry ให้ Grok อยู่ที่ 88.1% และ Kimi ที่ 86.1% พร้อมกับ Kimi ใช้เวลานานกว่าในการทดสอบดังกล่าว ผลสองชุดจึงสนับสนุนการเลือกตามลักษณะงาน มากกว่าการยึดป้ายว่าโมเดลหนึ่งชนะขาด
ต้นทุนจริงขึ้นกับรูปแบบการเรียกใช้
การมองหา ต้นทุน AI ต่ำ ต้องแยกอัตราค่าบริการต่อโทเคนออกจากค่าใช้จ่ายของงานหนึ่งครั้ง Kimi K3.1 Pro ปรับอัตราค่าบริการลงจากรุ่นก่อน พร้อมคงบริบทระดับหนึ่งล้านโทเคนไว้ จุดเด่นด้านต้นทุนอยู่ที่การแคชอินพุต ซึ่งเหมาะกับเอเจนต์ที่ต้องอ่านรีโพซิทอรีหรือคำสั่งเดิมซ้ำหลายรอบ ส่วน Grok คิดค่าเอาต์พุตในอัตราต่ำกว่าเมื่อคำขอไม่เกินเกณฑ์บริบทยาว แต่ค่าใช้จ่ายเพิ่มเมื่อพรอมต์เกิน 200K โทเคน ที่สำคัญ ในการรันคลังข้อมูลของ Plotly ซึ่งเป็นการเปรียบเทียบแบบเดียวกัน ค่าใช้จ่ายของ Kimi สูงกว่า Grok แม้คะแนนจะเสมอกัน ตัวอย่างนี้เตือนว่าความคุ้มค่าไม่ได้ตัดสินจากอัตราต่อโทเคนเพียงอย่างเดียว ต้องดูความยาวคำตอบ จำนวนครั้งที่เรียกใช้ การแคช และเวลาที่ใช้ด้วย หากงานของคุณสร้างเอาต์พุตยาวหรือทำงานซ้ำบ่อย ควรทดสอบด้วยพรอมต์จริงก่อนย้ายระบบ
Buy if / Skip if
- Buy the Kimi K3.1 Pro if งานของคุณต้องใช้บริบทยาว อ่านข้อมูลภาพหรือวิดีโอ และเรียกข้อมูลเดิมซ้ำจนได้ประโยชน์จากแคช
- Skip the Kimi K3.1 Pro if งานส่วนใหญ่สร้างเอาต์พุตจำนวนมากและคุณยังไม่ได้ทดสอบต้นทุนจริง เพราะอัตราเอาต์พุตอาจทำให้บิลสูงกว่า Grok ในคำขอทั่วไป
- Buy the Grok 4.7 if งานของคุณเน้นเอาต์พุตและพรอมต์มักไม่เกิน 200K โทเคน หรือให้ความสำคัญกับผลทดสอบบัญชีที่ทำได้ดีกว่าเล็กน้อย
- Skip the Grok 4.7 if ระบบต้องป้อนบริบทเกิน 200K โทเคนบ่อย หรืออ่านข้อมูลเดิมซ้ำหลายเทิร์น เพราะเงื่อนไขเหล่านี้อาจลดความคุ้มค่า
- Buy the Kimi K3.1 Pro or Grok 4.7 if คะแนนในงานนำร่องของคุณใกล้กัน แล้วเลือกตัวที่มีต้นทุนต่อชุดงานต่ำกว่าเมื่อวัดจากการใช้งานจริง