
ผลล่าสุดสะท้อนช่องว่างที่ Google ต้องเร่งปิด
Android Bench คือเกณฑ์ทดสอบของ Google ที่ประเมินว่าโมเดล AI ช่วยนักพัฒนาเขียนโค้ด Android ได้ดีเพียงใด โดยพิจารณางานเฉพาะทางและแนวปฏิบัติในการพัฒนาแอป ไม่ใช่เพียงความสามารถเขียนโปรแกรมทั่วไป
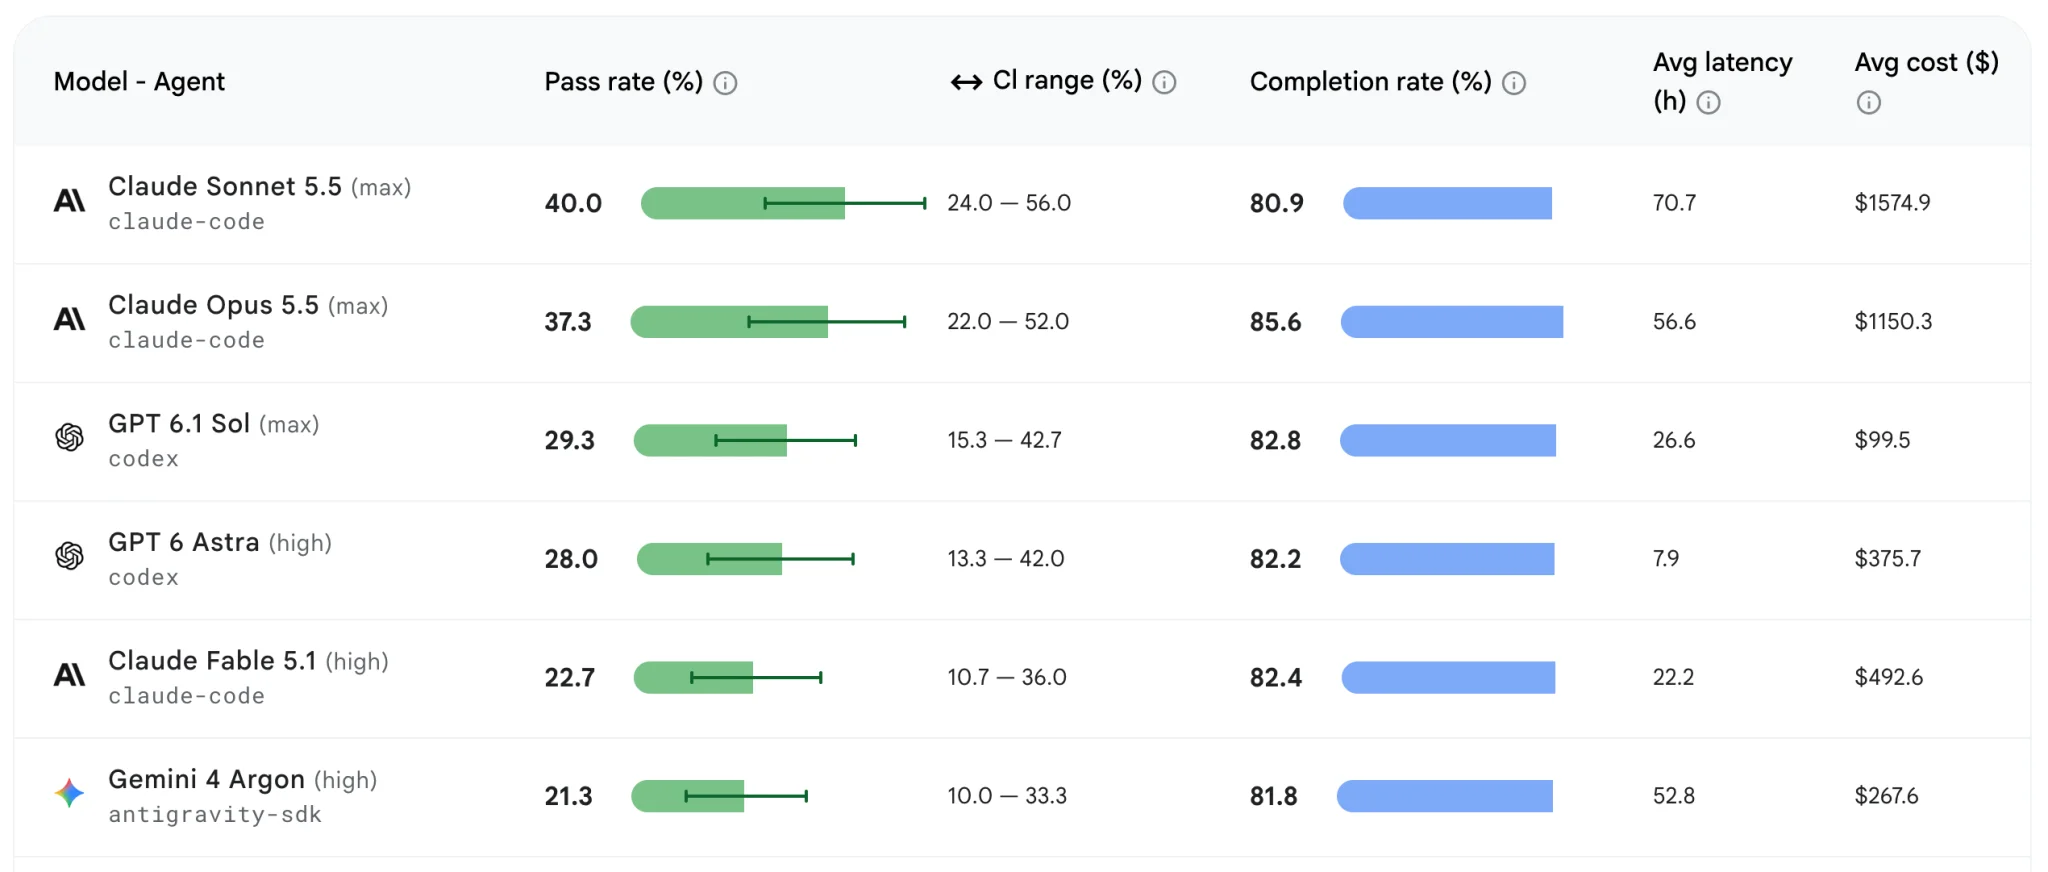
เมื่อ Google อัปเดตตารางเมื่อวันที่ 26 ตุลาคม พร้อมเพิ่มระดับการใช้เหตุผลและผลของ GPT-6 Sol, GPT-6.1 Sol, Claude Sonnet 5, Claude Sonnet 5.5 และ Gemini 4 Argon ผลที่ออกมาทำให้โมเดลของเจ้าของชุดทดสอบเองเป็นฝ่ายเสียเปรียบ Gemini 4 Argon อยู่ลำดับ 5 ตามหลังโมเดลคู่แข่ง โดยมีอัตราผ่าน 21.3% และอัตราทำงานสำเร็จ 81.8% ตัวเลขนี้ชี้ว่าการมีชื่อ Google อยู่หลังโมเดลไม่ได้รับประกันความเป็นผู้นำในงาน Android และนักพัฒนาควรดูผลของงานเฉพาะทาง มากกว่าตัดสินจากชื่อเสียงหรือคำประกาศเปิดตัว
คะแนนผ่านสำคัญกว่าการทำงานให้จบ
Claude Sonnet 5.5 ครองอันดับหนึ่ง ด้วยอัตราผ่าน 40% และอัตราทำงานสำเร็จ 80.9% ตัวเลขสองชุดนี้ควรอ่านควบคู่กัน เพราะการทำงานจนจบไม่ได้แปลว่าโค้ดผ่านเกณฑ์หรือทำตามแนวปฏิบัติ Android ได้ดีเสมอไป เมื่อเทียบกัน Gemini 4 Argon ทำงานสำเร็จ 81.8% ซึ่งสูงกว่าเล็กน้อย แต่มีอัตราผ่านเพียง 21.3% จึงยังมีช่องว่างด้านคุณภาพตามเกณฑ์ทดสอบ
ผลยังชี้ว่ารุ่นของโมเดลไม่ใช่คำตอบทั้งหมด Claude Opus 5.5 อยู่ที่อันดับสอง ส่วน Claude Fable 5.1 อยู่เหนือ Gemini 4 Argon เช่นกัน ภาพรวมจึงไม่ควรอ่านว่าโมเดลใดทำงานได้ทุกแบบ แต่บอกได้ว่าภายใต้โจทย์ Android Bench รุ่นใดทำผลงานผ่านเกณฑ์ได้ดีกว่า การเลือกผู้ช่วยเขียนโค้ดควรมองทั้งความแม่นยำและลักษณะงานที่ต้องส่งมอบ ไม่ใช่ดู completion rate เพียงค่าเดียว
เลือกโมเดลจากงานและงบ ไม่ใช่จากอันดับอย่างเดียว
การใส่ต้นทุนเฉลี่ยลงใน Android Bench ช่วยให้นักพัฒนาชั่งน้ำหนักระหว่างผลงานกับค่าใช้จ่ายได้ตรงขึ้น โดยเฉพาะทีมที่ต้องเรียกใช้โมเดลซ้ำในงานประจำ อย่างไรก็ตาม ตารางเป็นเพียงจุดเริ่มต้นสำหรับคัดตัวเลือก ไม่ใช่ใบรับรองว่าโมเดลอันดับสูงสุดจะเข้ากับโค้ดเบส เครื่องมือ หรือขั้นตอนตรวจงานของทุกทีม
สำหรับงาน Android จริง ควรลองโจทย์ที่ใกล้กับงานของตัวเอง เช่น การแก้บั๊ก การปรับหน้าจอ หรือการเปลี่ยนโค้ดเดิม แล้วตรวจทั้งความถูกต้อง การทำตามแนวทางแพลตฟอร์ม และปริมาณงานแก้มือ คะแนนทดสอบช่วยจำกัดตัวเลือกและตั้งความคาดหวังได้ แต่การทดลองในสภาพแวดล้อมจริงยังจำเป็น โดยเฉพาะเมื่อ Gemini 4 Argon ทำอันดับห้า ผลนี้เป็นเหตุผลให้ตรวจสอบก่อนเลือกใช้ ไม่ใช่ข้อสรุปว่าใช้ไม่ได้กับทุกกรณี
บทสรุป: ใช้คะแนนเป็นเข็มทิศ ไม่ใช่คำตัดสิน
ผล Android Bench รอบนี้ให้สัญญาณชัดว่า Gemini 4 Argon ยังตามหลัง Claude และ GPT-6 ในการช่วยเขียนโค้ด Android ตามเกณฑ์ของ Google ขณะที่ Claude Sonnet 5.5 เป็นผู้นำด้วยอัตราผ่าน 40% ส่วนอันดับของ Gemini และอัตราผ่าน 21.3% ทำให้ยังไม่มีเหตุผลพอจะเลือกเพียงเพราะเป็นโมเดลของ Google
ข้อสรุปที่ใช้ได้จริงคือเริ่มจากผลทดสอบเพื่อคัดโมเดล แล้วทดลองกับงานและข้อกำหนดของทีมก่อนตัดสินใจ Android Bench มีประโยชน์ต่อการเปรียบเทียบ แต่คะแนนหนึ่งชุดไม่อาจแทนการตรวจโค้ดและทดสอบแอปจริงได้