
AI agent failures production ไม่ใช่แค่บั๊ก แต่คือการตัดสินใจผิดที่ทำสำเร็จ
AI agent failures production คือชุดความล้มเหลวที่เกิดขึ้นเมื่อเอเจนต์ใช้โมเดลและชุดเครื่องมือไปตัดสินใจลงมือทำงานในระบบจริง แต่ผลลัพธ์ทางธุรกิจหรือความปลอดภัยกลับผิดไปจากเจตนาของผู้ใช้ แม้ทุกคำสั่งในระดับโค้ดและอินฟราสตรักเจอร์จะสำเร็จและถูกต้องตามสเปก การล้มเหลวเหล่านี้จึงไม่แสดงออกเป็น error code ทั่วไป แต่แฝงตัวในคำตอบที่ดูดี มีสถานะสำเร็จ และอาจถูกนำไปใช้ต่อโดยไม่มีใครรู้ตัว จนกระทบลูกค้า ข้อมูล และความเชื่อมั่นต่อระบบทั้งหมด
ภาพที่น่ากลัวที่สุดคือเอเจนต์ที่เรียก API คืนเงินอย่างถูกต้อง ได้รับ HTTP 200 OK และธุรกรรมทำงานตรงตามแบบ แต่กลับคืนเงินให้ลูกค้าผิดคน ในสายตา observability แบบเดิมทุกอย่างเขียว สัญญาณทั้งหมดบอกว่า “สำเร็จ” ทั้งที่ผลลัพธ์ทางธุรกิจผิดอย่างสิ้นเชิง นี่คือจุดที่ทีมพัฒนาต้องยอมรับว่าชั้นความสำเร็จแบบใหม่คือ “intent success” ว่าการกระทำนั้นตรงกับเจตนาของผู้ใช้จริงหรือไม่ หากยังมองแค่สถานะ 2xx ระบบที่ดูปลอดภัยสามารถทำร้ายองค์กรได้เองอย่างเงียบๆ
ตั้งด่านระหว่างเหตุผลกับการเปลี่ยนข้อมูล: intent tracking และ postcondition verification
ปัญหาของ AI agents ในโปรดักชันไม่ใช่การเรียก API พลาด แต่คือการเลือกเครื่องมือถูกแล้วใช้กับเป้าหมายผิด เมื่อให้โมเดลเลือกว่าจะใช้ lookupCustomer หรือ issueRefund และกำหนดพารามิเตอร์เอง เรากำลังปล่อยให้มันตัดสินใจเชิงธุรกิจแทนมนุษย์ ทางออกไม่ใช่ห้ามมันทำงาน แต่ต้องเพิ่มชั้นตรวจสอบระหว่าง reasoning กับการเปลี่ยนข้อมูลจริง เอเจนต์ไม่ควรเป็นคนฟันธงว่าการกระทำของตัวเองถูกต้อง ควรมีระบบภายนอกช่วยยืนยัน
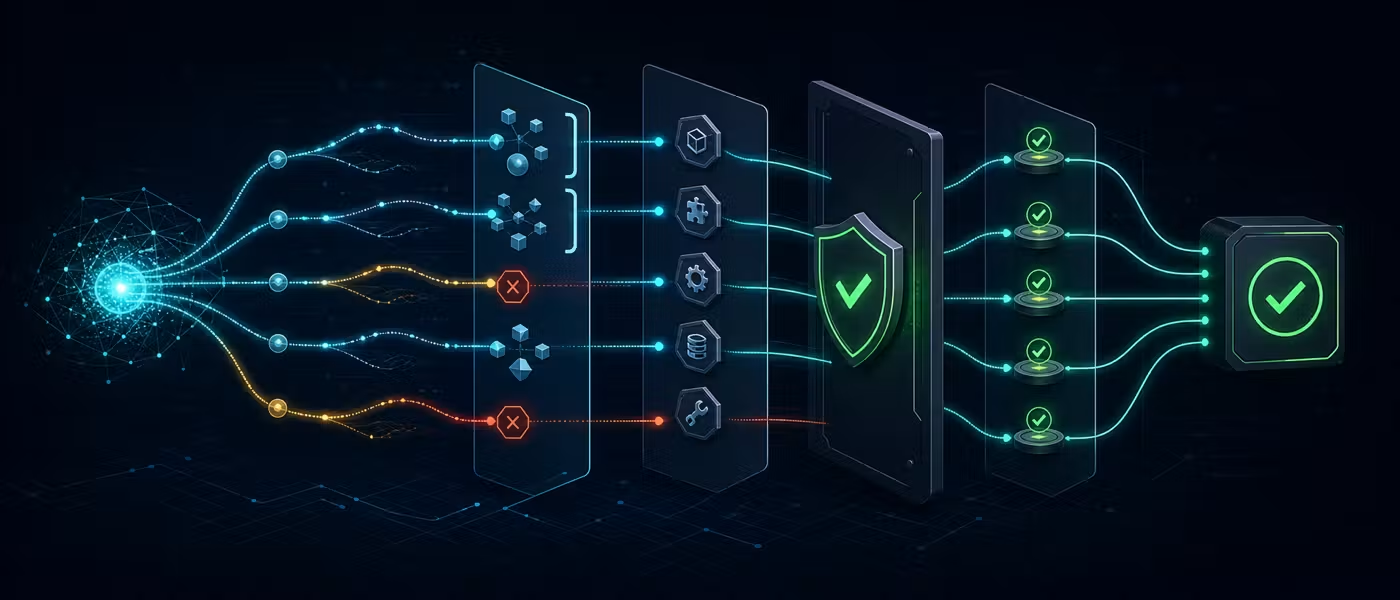
แนวทางที่ใช้งานได้คือกำหนด intent tracking ให้เอเจนต์ต้องสร้างแบบจำลองเจตนาผู้ใช้ที่ชัดเจนก่อน เช่น โครงสร้าง intent ที่บังคับให้ตอบว่าใคร คือเป้าหมาย อะไรคือผลลัพธ์ที่ต้องการ ก่อนเรียกเครื่องมือ จากนั้นผูกการเรียกฟังก์ชันสำคัญกับ preconditions และ postconditions แบบตรวจสอบเชิงดีเทอร์มินิสติก เช่น ต้องแน่ใจว่ารหัสลูกค้าตรงกับคำสั่งล่าสุด และหลังเรียก API ต้องตรวจว่าผลลัพธ์สอดคล้องกับ intent ที่ล็อกไว้ก่อนหน้า ด่านเล็กๆ ระหว่างการคิดกับการลงมือทำนี้ช่วยเปลี่ยนความล้มเหลวเงียบให้กลายเป็นเคสที่ถูกบล็อกหรือยกธงเตือนแทน
agent handoff coordination: จุดต่อที่ระบบล้ม ไม่ใช่ตัวเอเจนต์
ในระบบหลายเอเจนต์ ความน่าสนใจทางวิศวกรรมไม่ได้อยู่ที่ตัวโมเดล แต่คือช่องแคบระหว่างกันที่เรียกว่า agent handoff การส่งไม้ต่อคือการส่งงานที่เหลืออยู่ บริบทที่ต้องใช้ และสิทธิ์ในการลงมือทำจากเอเจนต์หนึ่งไปอีกตัว ความจริงที่เจ็บปวดคือระบบแบบนี้มักไม่ได้ล้มเหลวเพราะเอเจนต์ตัวใดตัวหนึ่งทำงานแย่ แต่ล้มที่ “รอยต่อ” ระหว่างกันมากกว่า เมื่อ payload ถูกออกแบบแย่ ข้อผิดพลาดเล็กๆ ต้นสายสามารถบานปลายเป็นคำตอบมั่นใจผิดปลายทางได้ง่าย
งานวิจัยด้าน handoff ชี้ว่ามีห้าโหมดล้มเหลวหลักที่ต้องออกแบบรับมือ ได้แก่ context flooding ที่ทำให้ latency และต้นทุนสูงขึ้นทุก hop และคุณภาพตกลงปลายสาย context starvation ที่ทำให้เอเจนต์ปลายทางอธิบายเหตุผลไม่ได้ silent authority ที่เอเจนต์ได้รับสิทธิ์ทำสิ่งที่ไม่มีใครอนุญาต error propagation ที่ทำให้ผลลัพธ์ผิดอย่างมั่นใจตลอดสาย และ lost provenance ที่ทำให้ย้อนรอยหาแหล่งผิดพลาดไม่ได้ ทางแก้คือบีบ payload ให้เหลือสี่ฟิลด์หลัก objective state evidence boundary และใส่ metadata แหล่งที่มาให้ครบ แล้วต้องมีการวัดคุณภาพ handoff อย่างต่อเนื่อง ไม่เช่นนั้น multi-agent workflow จะกลายเป็นโรงงานผลิตความมั่นใจปลอม
หยุด code hallucinations ด้วย adversarial pipeline ก่อนแตะ main branch
เมื่อทีมพึ่ง AI coding agents มากขึ้น ปัญหาไม่ได้อยู่ที่โค้ดเขียนไม่ติด แต่คือ code hallucinations ที่หน้าตาถูกต้องแต่ตรรกะผิดอย่างแนบเนียน โค้ดจำนวนมากคอมไพล์ผ่านและผ่าน linter แต่ไปทำลาย boundary ของโมดูล ทำ state machine พัง หรือฝ่าฝืนกฎสถาปัตยกรรมโดยที่ไม่มีใครเห็นจนเข้าระบบจริง ดูเหมือนเรากำลังส่งมอบ pull request ที่เต็มไปด้วย “AI slop” ให้รุ่นพี่ตามเช็ด ซึ่งทั้งเหนื่อยและเสี่ยง
แนวทางที่น่าใช้คือสร้าง adversarial pipeline ให้ทำงานตั้งแต่เครื่องโลคัล ก่อน developer จะเปิด pull request ต้องกดรันรีวิวหนักแบบ multi-agent ที่ทำตัวเหมือนศาลไต่สวนคุณภาพโค้ด มีเอเจนต์กลุ่ม Prosecutors ที่สแกน diff ทั้งหมดหาบั๊กตรรกะ สถานะที่ไม่ได้ทดสอบ และการละเมิด convention ด้วยความไวสูง จากนั้น Refuter agents จะพยายามโต้แย้งและพิสูจน์ว่าข้อหานั้นฟังขึ้นจริง โดยต้องอ้างบรรทัด diff ที่ชัดเจน และหากพิสูจน์ไม่ได้ก็ต้องลบออก ข้อสำคัญคือเอเจนต์เหล่านี้ไม่แตะโค้ดเอง แต่ส่งรายงานสัญญาณสูงให้มนุษย์ตัดสินใจสุดท้ายเท่านั้น นี่คือวิธีแยกความเร็วของ AI ออกจากอำนาจ merge main branch
prompt injection defense และ durable execution framework: สองฐานรากของเอเจนต์ที่ปลอดภัยและทนล้ม
เมื่อเอเจนต์เริ่มอ่านอีเมล หน้าเว็บ หรือ ticket จริง ช่องโหว่ด้านความปลอดภัยจะไม่ใช่ทฤษฎีอีกต่อไป ตัวอย่างคือกรณีที่มีคนส่งคำสั่งแฝงในเนื้อหา ticket เพื่อกระตุ้นให้เอเจนต์ส่งต่ออีเมลลูกค้าหลายฉบับออกไปภายนอก เอเจนต์มองว่าเป็นคำสั่งที่ถูกต้องและลงมือทำทันที บทเรียนจากช่องโหว่ prompt injection ในเครื่องมือโค้ดหลายเจ้า คือเราไม่มีทาง “ปิด” การโจมตีชนิดนี้ได้สนิท สิ่งที่ควรทำคือออกแบบการป้องกันแบบชั้นๆ หรือ defense-in-depth ตั้งแต่แยกระดับความเชื่อถือของข้อมูล ให้สิทธิ์น้อยที่สุดที่จะทำงานได้ ควบคุมเครื่องมือที่เอเจนต์เรียก ใช้ sandbox กับทุก output และบันทึก log พร้อมเปิดให้ทีม red-team ทดสอบอย่างจริงจัง
อีกด้านหนึ่งคือความทนต่อการล้มของเอเจนต์ งานวิจัยด้าน durable execution ชี้ให้เห็นว่าหากบันทึกผลของแต่ละ step ทันทีที่เสร็จ การล้มของเอเจนต์จะทำให้เสียหายแค่ขั้นที่กำลังรัน ไม่ใช่ชั่วโมงของ API calls ก่อนหน้า โครงสร้างอย่าง LangGraph DBOS Inngest และ Temporal ต่างออกแบบมาให้สามารถ resume เอเจนต์ที่ล้มได้ โดยบันทึก state ของ workflow ด้วยวิธีต่างกันและนำกลับมา replay เมื่อระบบฟื้น ในการทดลองหนึ่ง เอเจนต์ค้นคว้าข้อมูลเดินถึง step 38 ก่อน pod ถูก evict และเมื่อเริ่มใหม่การค้นหาให้หน้าเว็บชุดใหม่ ทำให้เส้นทางเหตุผลเปลี่ยน สิ่งที่ framework เหล่านี้ทำคือช่วยให้เรารู้ชัดว่าขั้นไหนถูกบันทึก ขั้นไหนต้องรันใหม่ และในกรณีของ Temporal ยังบันทึกทุกการตัดสินใจของ workflow ไว้ใน event history แล้ว replay โค้ดเทียบกับประวัติเดิมเพื่อตรวจความสอดคล้อง สำหรับทีมที่จริงจังกับ AI agent failures production การเลือก durable execution framework จึงไม่ใช่เรื่องหรู แต่เป็นฐานรากของความรับผิดชอบ