
ภาพรวม: จะเลือกโมเดล AI เปิดอย่างไรให้ไม่เปลืองเครื่อง
การเลือกโมเดล AI เปิดคือการตัดสินใจระหว่างขนาดโมเดล หน่วยความจำ VRAM ความเร็วอินเฟอเรนซ์ และรูปแบบงานที่ต้องการรองรับ ผู้ใช้ต้องมองทั้งสถาปัตยกรรมภายใน เช่น dense หรือ mixture-of-experts ระดับการ Quantization โมเดล AI อย่าง 2 บิตหรือ 16 บิต รวมถึงว่าต้องการมัลติโมดัลหรือข้อความล้วน การเข้าใจข้อจำกัดของเครื่องที่มีและประเภทงาน เช่น เอเจนต์บนเครื่อง การวิเคราะห์ข้อมูลชุดใหญ่ หรือการสนทนามัลติโมดัล จะช่วยให้เลือกโมเดล AI เปิดที่สมดุลระหว่าง VRAM ประหยัด AI ความเร็ว และคุณภาพคำตอบได้ดีขึ้น
ในภาพรวม Nemotron 3.5 Bolt 74B เหมาะกับคนที่ต้องการโมเดลใหญ่ที่บีบอัดลงเครื่อง GPU เดียวได้ ส่วนตระกูล Gemma 4 เด่นเรื่องความหลากหลายของขนาดและใบอนุญาต Apache 2.0 ที่เหมาะกับงานเชิงพาณิชย์ ขณะที่ Granite Switch 4.1 8B กับ Gemma 4 12B เป็นตัวอย่างสองแนวทางมัลติโมดัลที่ต่างกันชัดเจน ใครที่ต้องการโมเดลตัดสินใจแบบไม่คิดค่าโทเคนผลลัพธ์อาจมองไปที่โมเดลแนว decision โดยเฉพาะ และทั้งหมดนี้ต้องผูกกับคำถามหลักของคุณว่า งานจริงที่ต้องรันคืออะไร ไม่ใช่แค่ตัวเลขพารามิเตอร์
| Spec | A | B |
|---|---|---|
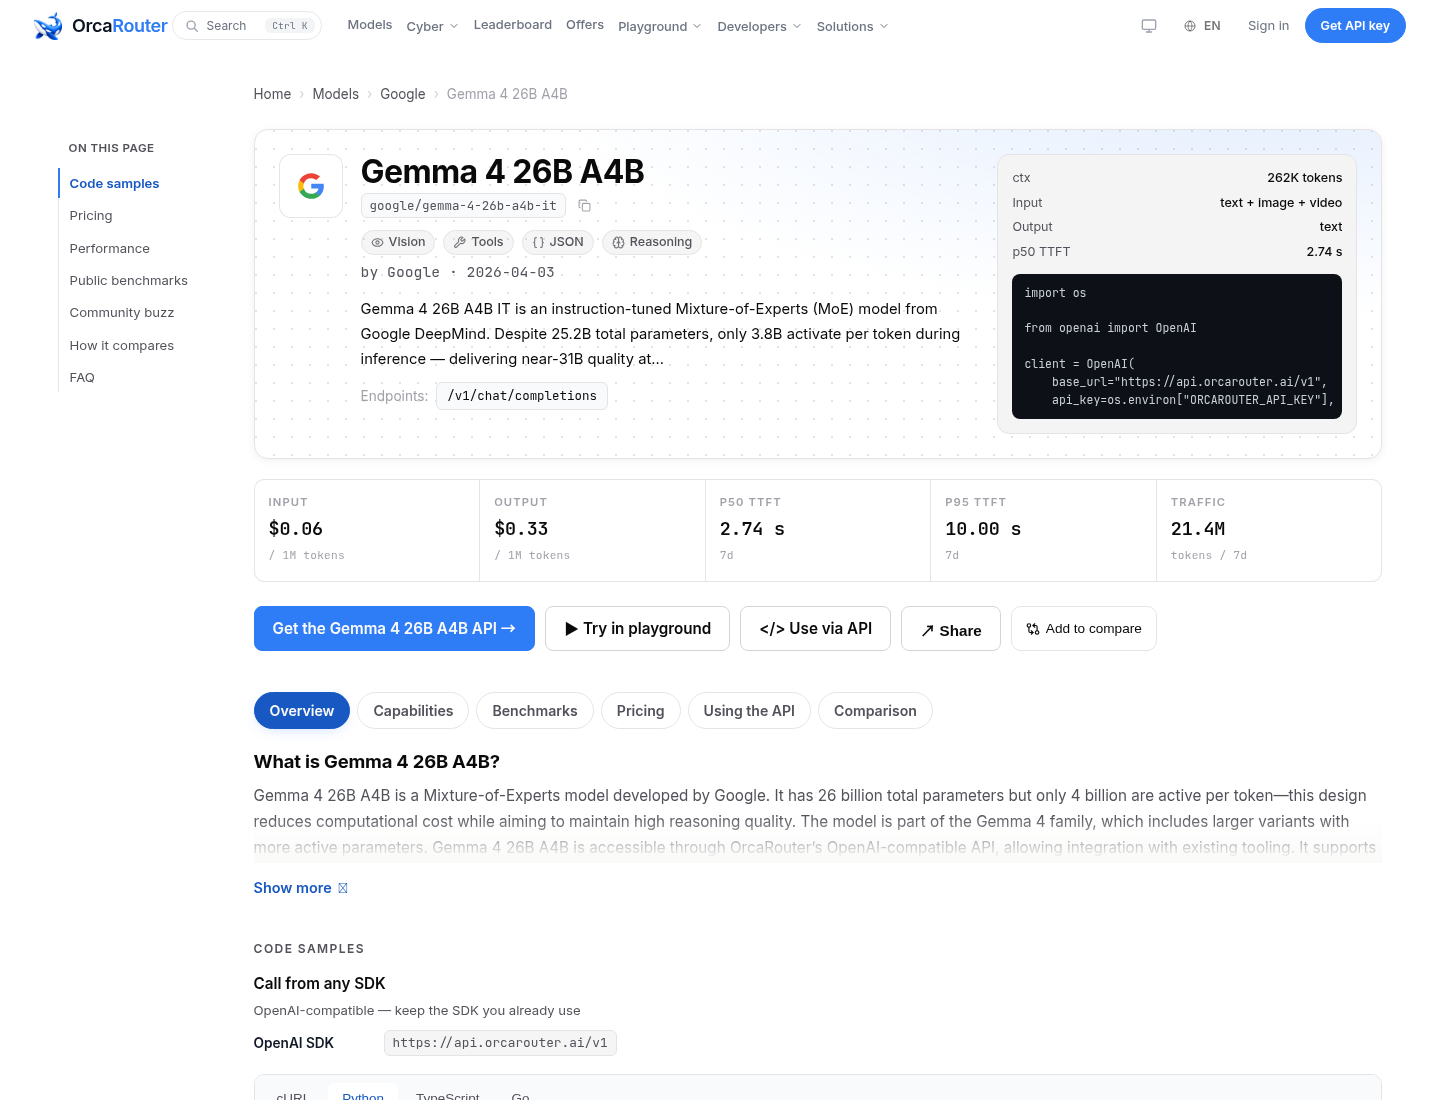
| สถาปัตยกรรม | Nemotron 3.5 Bolt 74B-A9B 24GB แบบ MoE ใช้ 2.0625 บิตต่อน้ำหนักผู้เชี่ยวชาญ | Gemma 4 26B A4B แบบ MoE ใช้ BF16 ตามการเปรียบเทียบของ NVIDIA |
| บริบทสูงสุด | Bolt รองรับบริบทยาวและงานให้เหตุผลตามเบนช์มาร์กของ Artificial Analysis | Gemma 4 26B A4B มีหน้าต่างบริบท 262,000 โทเคน ตามการ์ดโมเดลบน OrcaRouter |
| พารามิเตอร์รวม | Nemotron 3.5 Bolt 74B มี 74 พันล้านพารามิเตอร์ โดยมี 9 พันล้านที่ใช้งานต่อโทเคน | Gemma 4 26B A4B มีประมาณ 25.2 พันล้านพารามิเตอร์รวม และ 3.8 พันล้านที่ใช้งานต่อโทเคน |
| การจัดเก็บบนเครื่อง | เช็กพอยต์ Bolt ถูกบีบอัดให้พอดีไฟล์ขนาด 24GB ด้วยการ Quantization ลึกระดับ 2 บิต | Gemma 4 26B A4B ถูกใช้เป็น baseline ในการรัน BF16 ที่ต้องใช้ VRAM มากกว่า |
| ใบอนุญาต | Nemotron เผยแพร่บน Hugging Face ภายใต้เงื่อนไขของ NVIDIA สำหรับโมเดลเปิดน้ำหนัก | ทุกขนาดของ Gemma 4 ใช้ Apache 2.0 ที่อนุญาตการใช้งานเชิงพาณิชย์ตามการ์ดโมเดลของ DeepMind |
Nemotron 3.5 Bolt 74B: บีบโมเดลใหญ่ลง 24GB เพื่อ VRAM ประหยัด
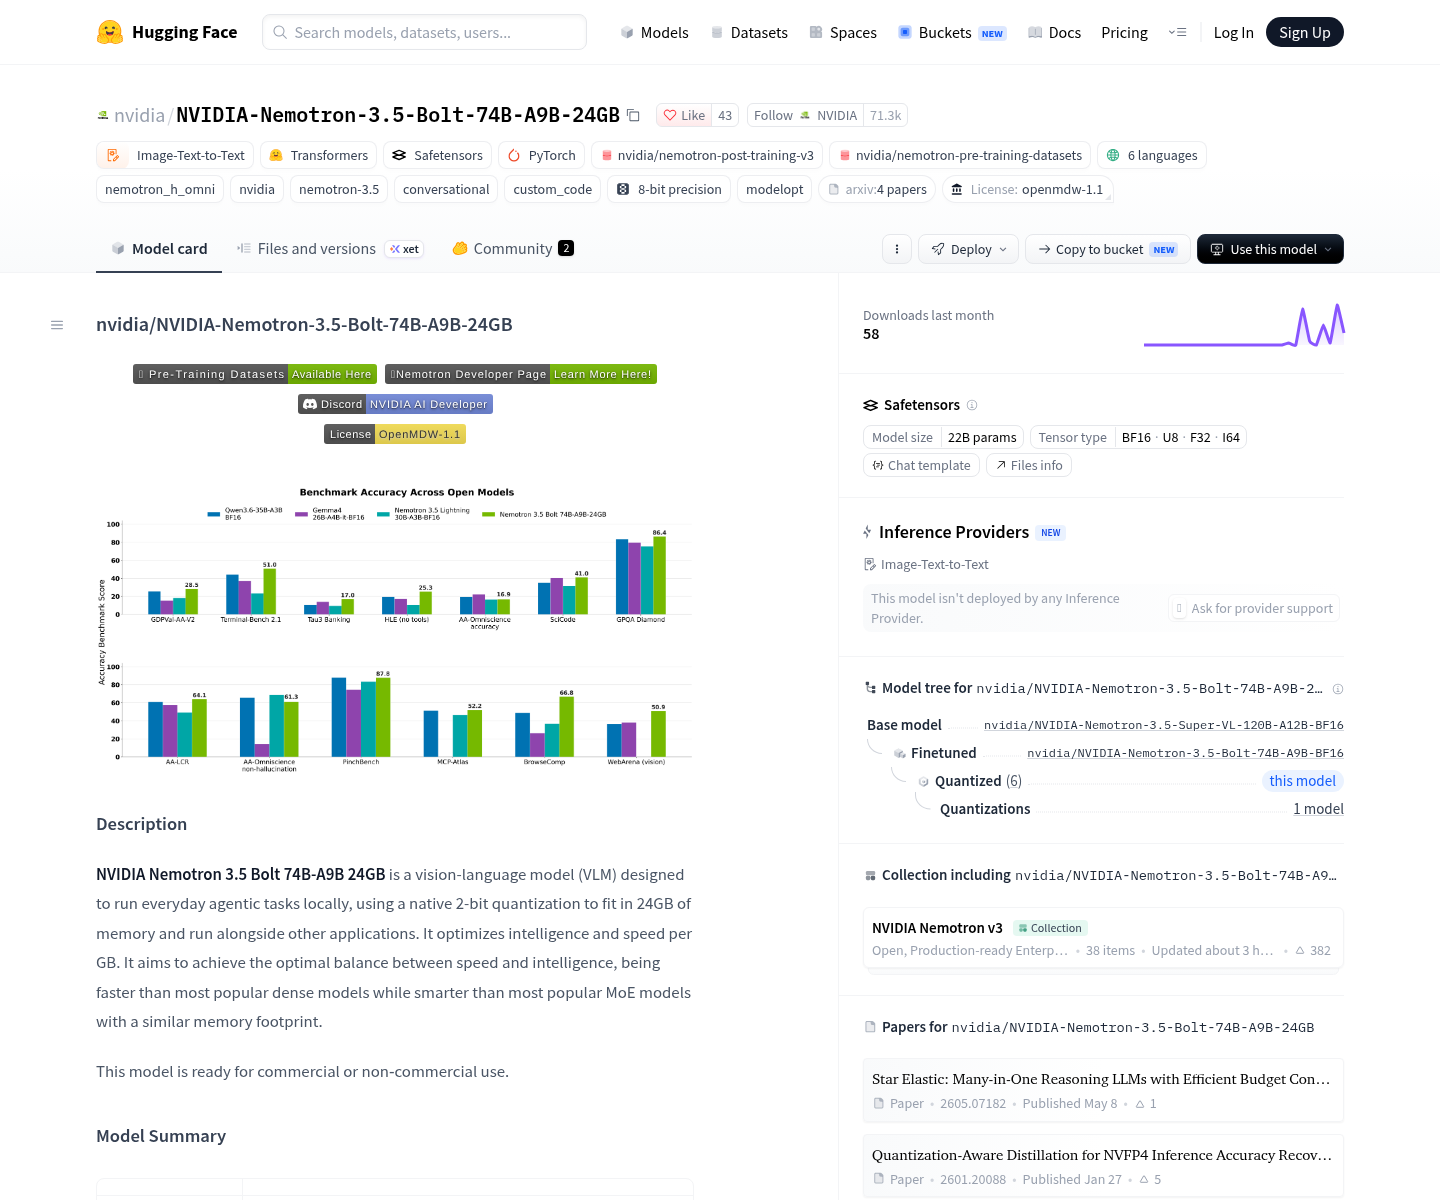
Nemotron 3.5 Bolt 74B ถูกออกแบบมาเพื่อตอบโจทย์คนที่อยากรันเอเจนต์บนเครื่องของตัวเองโดยไม่ต้องเช่าเซิร์ฟเวอร์ขนาดใหญ่ แนวคิดคือเอาโมเดลขนาด 74 พันล้านพารามิเตอร์มาบีบอัดด้วย Quantization โมเดล AI ระดับประมาณ 2.0625 บิตต่อน้ำหนักผู้เชี่ยวชาญ ทำให้เก็บในไฟล์ 24GB และพอดีกับ GPU 24GB ตามการ์ดโมเดลของ NVIDIA Bolt เป็น mixture-of-experts ที่มี 9 พันล้านพารามิเตอร์ทำงานต่อโทเคน จึงให้ความสามารถคิดเหตุผลสูงโดยไม่ต้องโหลดทุกพารามิเตอร์ขึ้น VRAM พร้อมกัน เหมาะกับงานที่ต้องการคุณภาพการให้เหตุผลและบริบทยาวบนเครื่องเดียว
เมื่อเทียบกับ Gemma 4 26B A4B ในตารางเบนช์มาร์กของ NVIDIA Bolt ชนะในเกือบทุกคอลัมน์ เช่น GDPVal-AA-V2 จาก 15.33 เป็น 28.47 และ Terminal-Bench 2.1 จาก 37.22 เป็น 50.98 ขณะที่ Artificial Analysis วัดค่า Bolt ได้ 21 บน Intelligence Index เทียบกับ 17 ของ Gemma 4 26B A4B ตัวเลขเหล่านี้ชี้ว่า ถ้าคุณยอมรับการบีบอัด 2 บิตเพื่อ VRAM ประหยัด AI Bolt ให้สมดุลที่ดีระหว่างความแม่นยำและความสามารถรันบนเครื่องเดี่ยว แต่ต้องแลกกับการตั้งค่าที่ซับซ้อนขึ้นและการพึ่งพา Quantization ลึกซึ่งอาจไม่เหมาะกับงานที่ต้องการความเที่ยงตรงเชิงตัวเลขสูงมาก
ตระกูล Gemma 4 และ Granite Switch: เลือกแนวทางมัลติโมดัลให้ตรงงาน
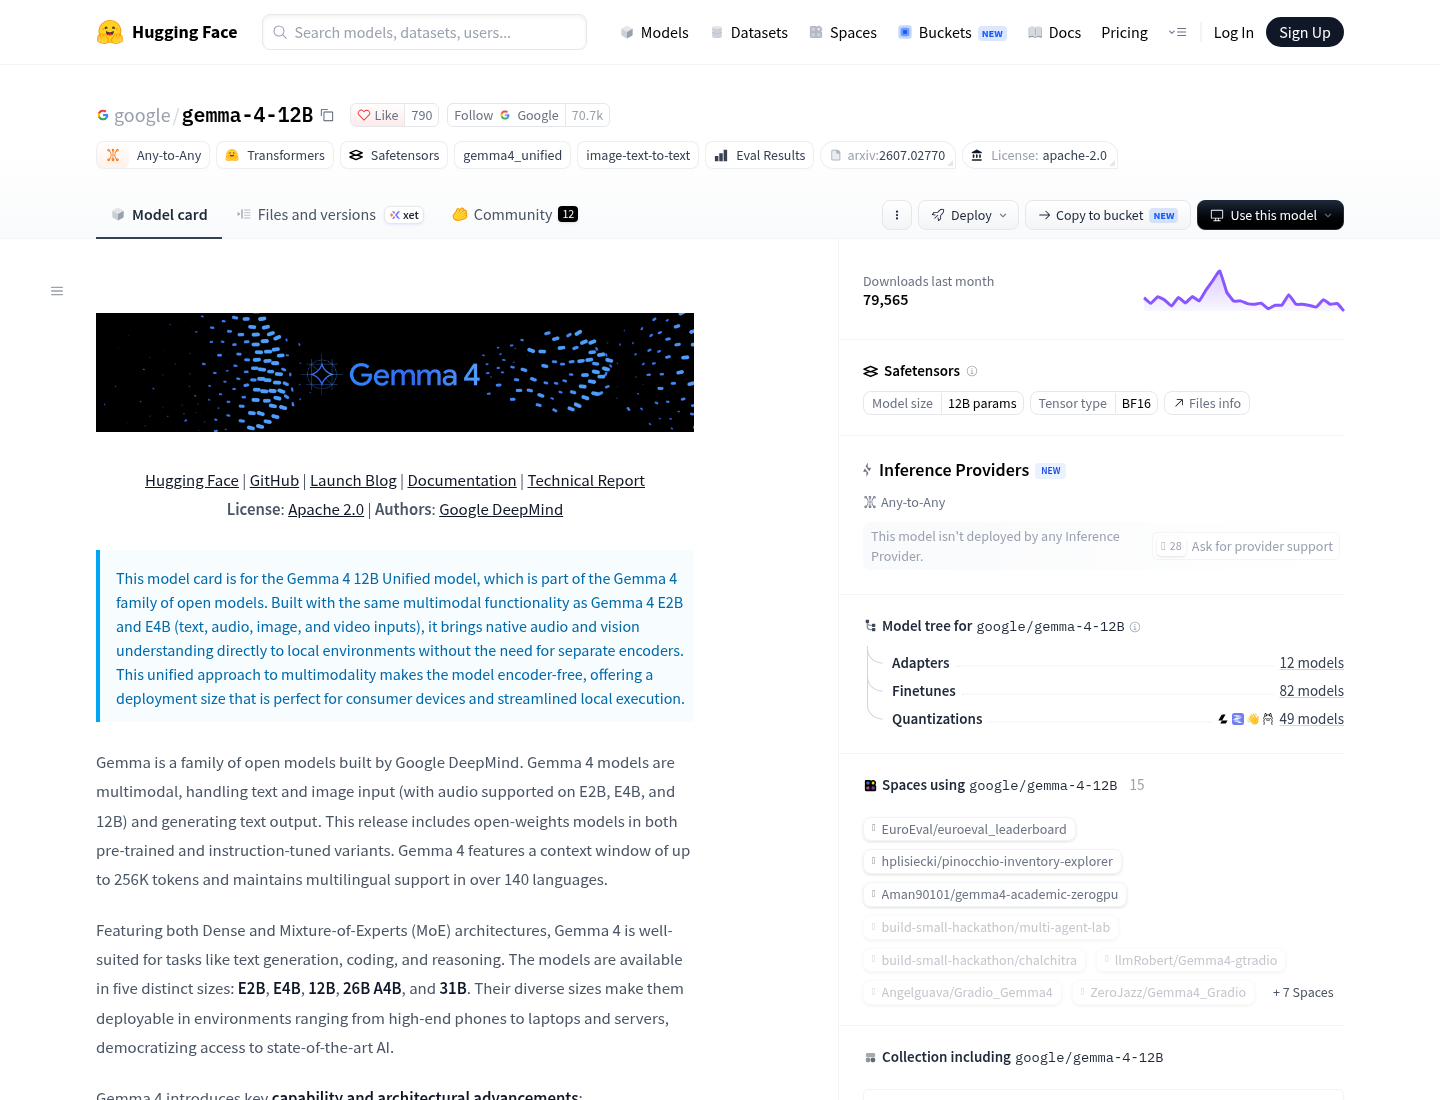
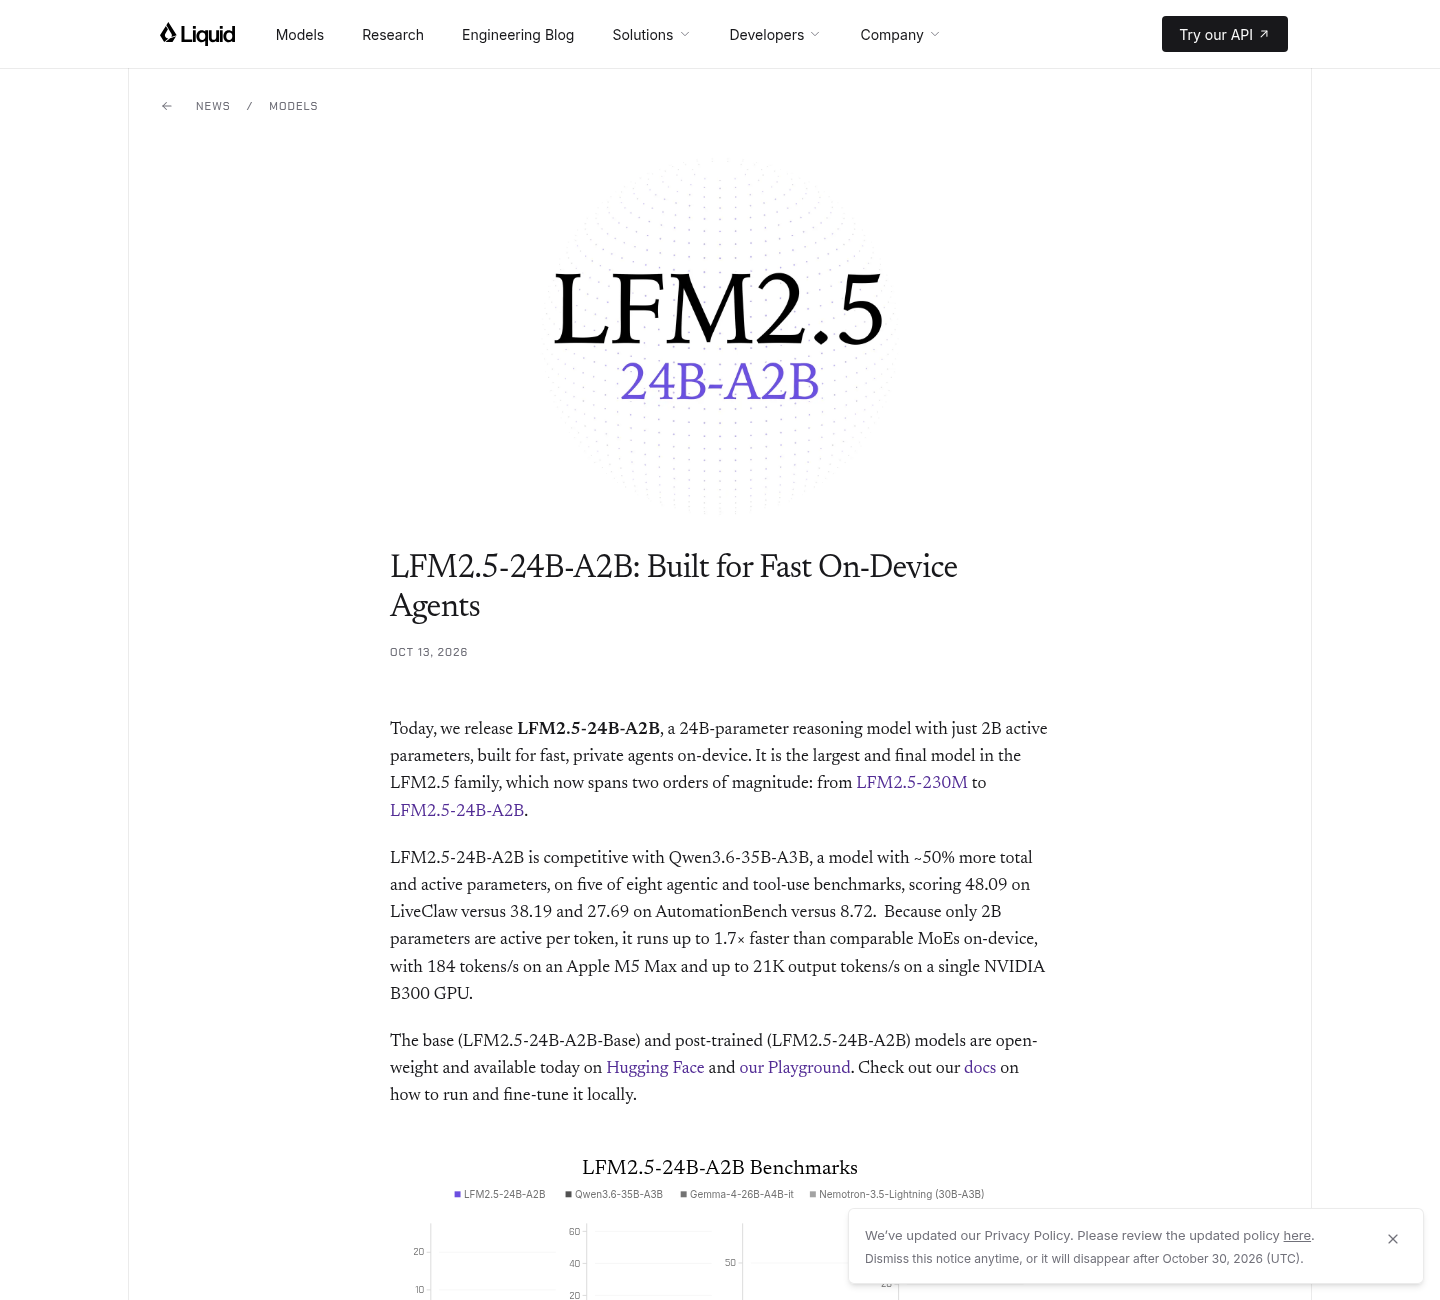
ตระกูล Gemma 4 เป็นตัวเลือกหลักสำหรับคนที่ต้องการโมเดล AI เปิดพร้อมใบอนุญาต Apache 2.0 ใช้งานเชิงพาณิชย์ได้ทุกขนาด ตั้งแต่รุ่นเล็กอย่าง E2B และ E4B ไปจนถึง Gemma 4 12B 26B A4B และ 31B แต่ละรุ่นไม่ได้เป็นแค่การปรับสเกลของกันและกัน เช่น E2B และ E4B ใช้เทคนิค Per-Layer Embeddings ที่ทำให้จำนวนพารามิเตอร์มีประสิทธิผลต่ำกว่าพารามิเตอร์รวม ส่วนรุ่นใหญ่แบบ MoE อย่าง 26B A4B มี 25.2 พันล้านพารามิเตอร์รวมและ 3.8 พันล้านที่ใช้งานต่อโทเคน รองรับบริบท 262,000 โทเคน และมัลติโมดัลทั้งข้อความ ภาพ และวิดีโอ เหมาะกับงานที่ต้องมองเห็นและใช้เครื่องมือภายนอก
Granite Switch 4.1 8B กับ Gemma 4 12B แสดงสองแนวทางมัลติโมดัลที่ต่างกัน Granite ใช้โมเดลข้อความขนาด 8B ที่แช่แข็งไว้แล้วติดอะแดปเตอร์ activated-LoRA สลับได้ เช่น guardian-core และ decision รวมถึง Granite Speech 5.0 TurboCTC สำหรับเสียง ทำให้พารามิเตอร์รวมเพิ่มขึ้นเพียงราว 4.72 เปอร์เซ็นต์ เหมาะกับงานที่ต้องตัดสินใจหรือรันปลายทางเดียวแบบเฉพาะทาง ในทางตรงกันข้าม Gemma 4 12B เป็นโมเดลเดียวที่ฝึกตั้งแต่ต้นให้เข้าใจข้อความ ภาพ และเสียงโดยไม่มีเอนโคเดอร์แยก จึงเหมาะกับงานที่ต้องการเส้นทางมัลติโมดัลที่ฝึกมาจริงและฐานผู้ใช้ขนาดใหญ่ที่ติดตั้งมานาน
LFM2.5 24B A2B และโมเดลตัดสินใจ: เมื่อความเร็วสำคัญกว่าขนาด
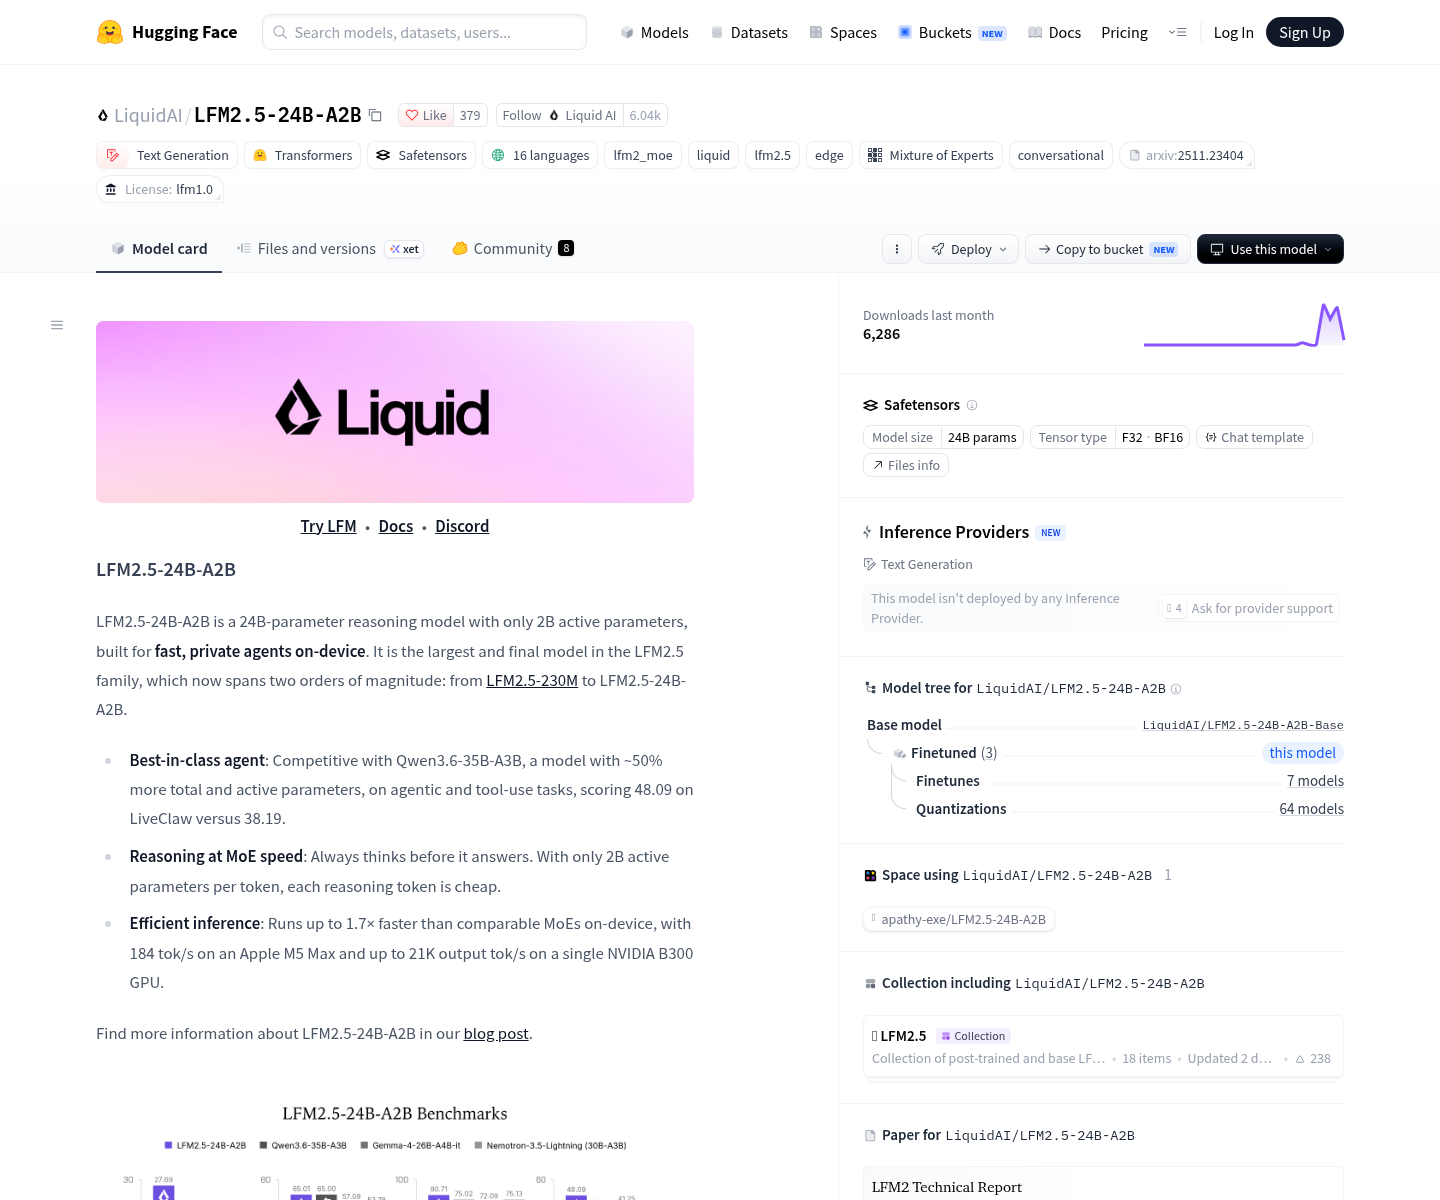
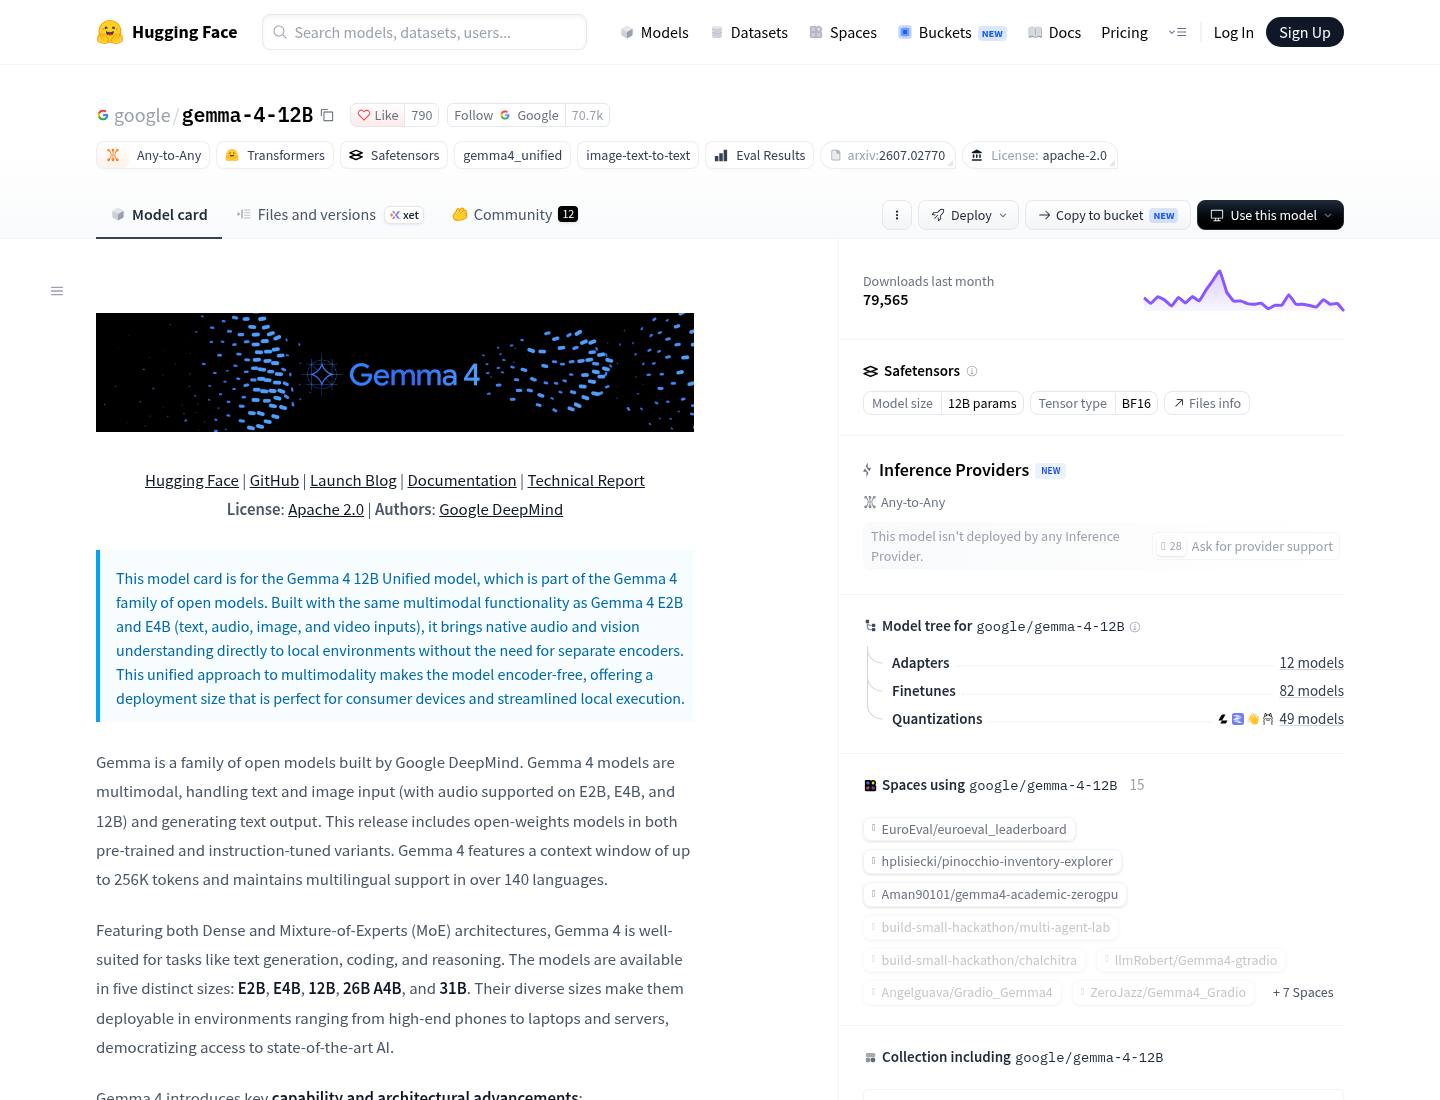
Liquid AI LFM2.5 24B A2B เป็นอีกคำตอบต่อข้อจำกัดเดียวกับ Nemotron Bolt คืออยากได้เอเจนต์บนเครื่อง แต่เลือกทางตรงกันข้าม โมเดลนี้ถูกออกแบบให้เล็กตั้งแต่โทเคนแรก ใช้ทรัพยากรไปกับความเร็วมากกว่าขนาด เป็น MoE ที่มี 24 พันล้านพารามิเตอร์รวม แต่มีเพียง 2.45 พันล้านที่ใช้งานต่อโทเคน ใช้สแต็กการสังวัตนาเป็นหลัก มี 40 เลเยอร์ และ top-4 routing จากผู้เชี่ยวชาญ 64 คนต่อบล็อก ทำให้รองรับบริบท 131,072 โทเคน โดยยังรักษาความเร็วอินเฟอเรนซ์สูง เหมาะกับเอเจนต์ที่ต้องตอบเร็วบนเครื่อง เช่น การช่วยงานออฟฟิศหรือการวิเคราะห์ข้อมูลแบบโต้ตอบ
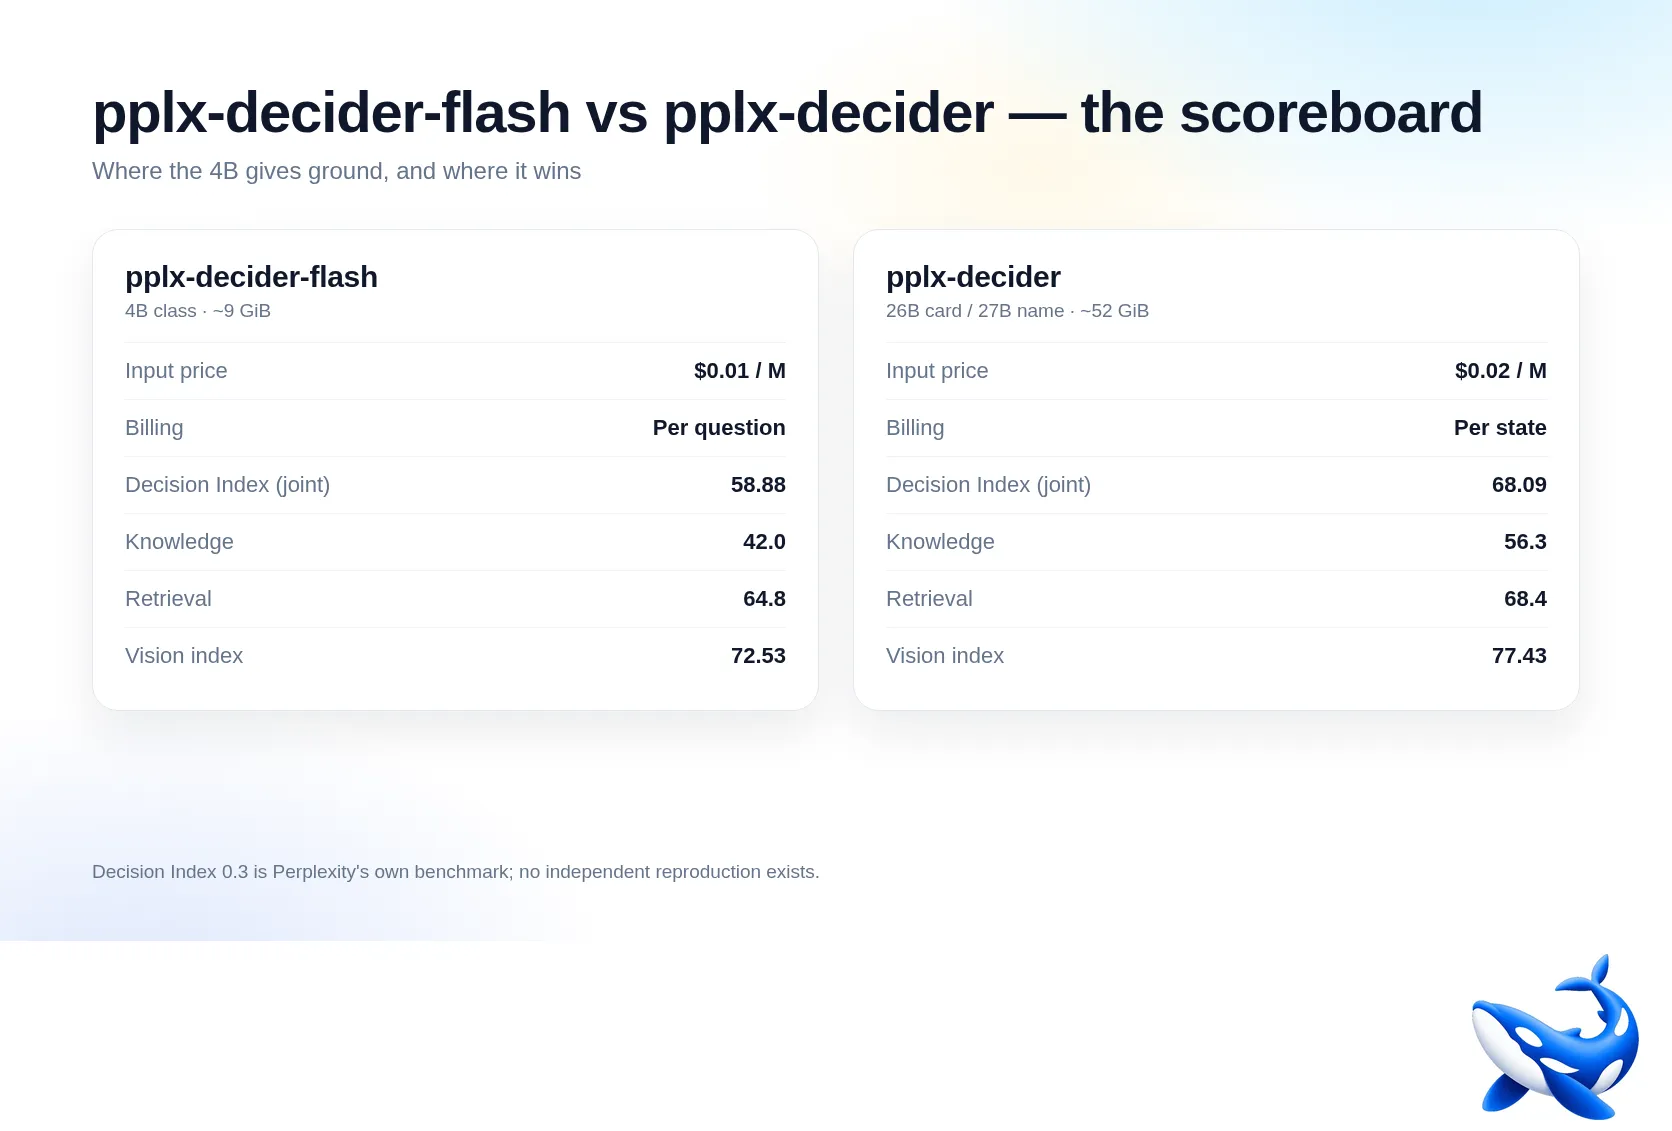
โพสต์เปิดตัวของ Liquid AI ระบุว่า LFM2.5-24B-A2B ทำคะแนน LiveClaw ได้ 48.09 เทียบกับ 38.19 ของ Qwen3.6-35B-A3B และให้ throughput 184 โทเคนต่อวินาทีบน Apple M5 Max ซึ่งสะท้อนจุดขายด้านความเร็วและการคิดเหตุผลต่อโทเคน สำหรับงานที่ต้องตัดสินใจซ้ำ ๆ หรือประเมินความเสี่ยง โมเดลแนว decision เช่น Microsoft-Decision-1 มีข้อดีตรงที่คืนค่าความน่าจะเป็นแบบปรับเทียบโดยไม่คิดค่าโทเคนผลลัพธ์ ทำให้เหมาะกับระบบที่ต้องรันการตัดสินใจจำนวนมากโดยไม่ต้องสร้างข้อความยาว การเลือกจึงขึ้นกับว่าคุณต้องการคำอธิบายเป็นข้อความหรือแค่ผลตัดสินใจที่คำนวณได้
กลยุทธ์ Quantization และการประมวลผลเป็นชุด: เลือกให้ตรงงานวิเคราะห์ใหญ่
เมื่อพูดถึงงานวิเคราะห์ข้อมูลชุดใหญ่หรือการสร้างรายงานอัตโนมัติ ปัจจัยสำคัญคือความลึกของ Quantization โมเดล AI และความสามารถในการประมวลผลเป็นชุด โมเดลที่ใช้ 2 บิตอย่าง Nemotron 3.5 Bolt 74B สามารถบีบลง VRAM 24GB ได้ ทำให้รันงาน batch ขนาดใหญ่บนเครื่องเดียวได้มากขึ้น แต่ต้องยอมรับว่าการบีบอัดอาจกระทบความละเอียดของตัวเลขบางประเภท ในทางตรงกันข้ามโมเดลที่รันที่ความแม่นยำสูงกว่า เช่น BF16 ใน Gemma 4 26B A4B จะใช้ VRAM มากกว่าแต่ให้ความเที่ยงตรงที่ดีสำหรับงานวิทยาศาสตร์หรือการเงินที่ต้องการตัวเลขเป๊ะ
สำหรับการประมวลผลเป็นชุด โมเดลที่มีพารามิเตอร์ใช้งานต่อโทเคนน้อยกว่า เช่น LFM2.5 24B A2B ที่มี 2.45 พันล้านพารามิเตอร์ใช้งานต่อโทเคน หรือ Gemma 4 26B A4B ที่มี 3.8 พันล้านพารามิเตอร์ใช้งานต่อโทเคน จะช่วยให้ throughput ต่อวินาทีสูงขึ้นเมื่อรันหลายคำขอพร้อมกัน เหมาะกับระบบรายงานหรือแดชบอร์ดที่ต้องตอบหลายผู้ใช้พร้อมกัน ในทางกลับกัน ถ้างานของคุณคือเอเจนต์คิดลึกทีละเคส การเลือกโมเดลที่มีพารามิเตอร์ใช้งานต่อโทเคนมากขึ้นอย่าง Bolt จะให้คุณภาพการให้เหตุผลที่ดีกว่า การตัดสินใจจึงต้องมองทั้ง VRAM ประหยัด AI ความเร็ว และรูปแบบการใช้งานจริง
- Buy the Nemotron 3.5 Bolt 74B if คุณต้องการโมเดลใหญ่ที่บีบอัดลง GPU 24GB เพื่อรันเอเจนต์คิดเหตุผลบนเครื่องเดียว
- Skip the Nemotron 3.5 Bolt 74B if งานของคุณต้องการความเที่ยงตรงเชิงตัวเลขสูงมากและไม่อยากเสี่ยงกับผลของการ Quantization ลึก
- Buy the Gemma 4 26B A4B if คุณต้องการมัลติโมดัลเต็มรูปแบบพร้อมใบอนุญาต Apache 2.0 สำหรับงานเชิงพาณิชย์และบริบทยาวมาก
- Skip the Gemma 4 26B A4B if เครื่องของคุณมี VRAM จำกัดและต้องรันงาน batch หนักบน GPU เดียว
- Buy the Gemma 4 12B if คุณต้องการโมเดลมัลติโมดัลตัวเดียวที่ฝึกมาจริง เหมาะกับงานที่ต้องมองเห็นและถอดเสียงบน GPU เดียว
- Skip the Gemma 4 12B if งานของคุณเน้นการตัดสินใจเฉพาะทางที่อาจใช้ Granite Switch 4.1 8B พร้อมอะแดปเตอร์ decision ได้คุ้มกว่า
- Buy the Granite Switch 4.1 8B if คุณต้องการแกนข้อความ 8B เดียวแล้วสลับอะแดปเตอร์สำหรับความปลอดภัย การตัดสินใจ และเสียงตามงาน
- Skip the Granite Switch 4.1 8B if คุณต้องการเส้นทางมัลติโมดัลที่ฝึกมารวมกันตั้งแต่ต้นและฐานผู้ใช้ขนาดใหญ่
- Buy the LFM2.5 24B A2B if คุณต้องการเอเจนต์บนเครื่องที่เน้นความเร็วอินเฟอเรนซ์และ throughput สูงสำหรับงานคิดเหตุผลต่อเนื่อง
- Skip the LFM2.5 24B A2B if คุณต้องการมัลติโมดัลหรือการมองเห็นภาพ เพราะโมเดลนี้รองรับเฉพาะข้อความล้วน