
ภาพรวมเปรียบเทียบ AI โมเดล Gemma 4, Qwen 3.8 และ Granite Switch 4.1
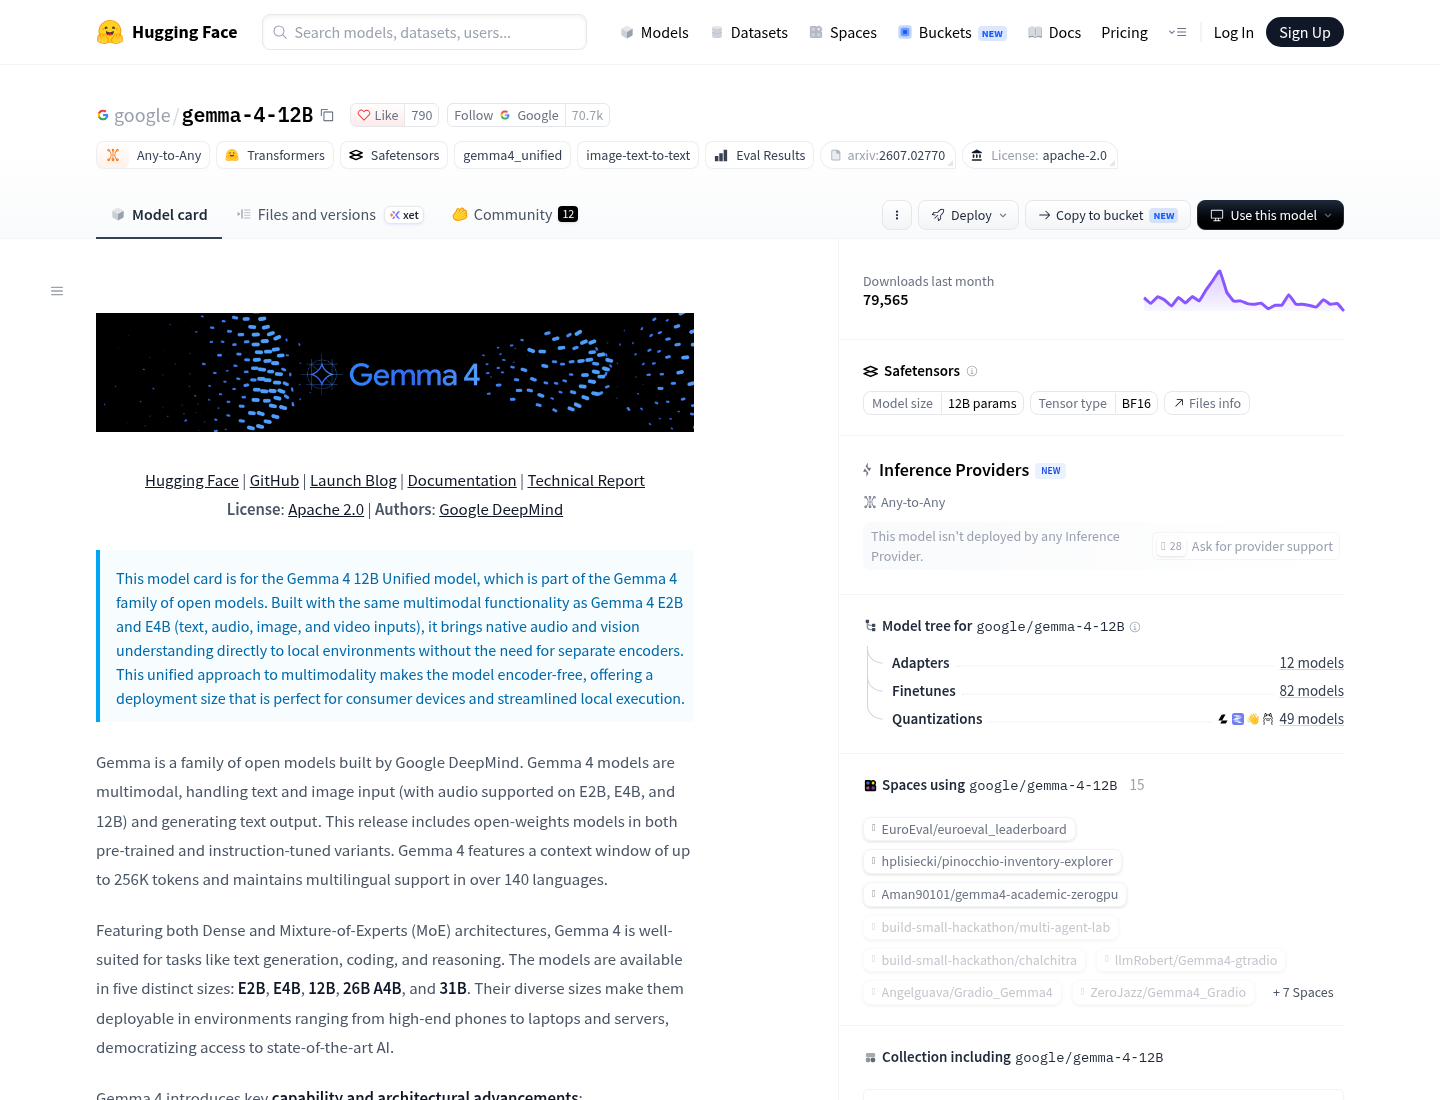
การเปรียบเทียบ AI โมเดลแบบโอเพนซอร์สอย่าง Gemma 4, Qwen 3.8 และ Granite Switch 4.1 คือการดูพร้อมกันทั้งขนาดโมเดล สถาปัตยกรรม การเปิดน้ำหนัก ลิขสิทธิ์ AI โมเดล และความต้องการ RAM เพื่อให้ผู้ใช้เลือกโมเดลที่รันได้จริงบนฮาร์ดแวร์ของตัวเองและเหมาะกับงาน เช่น การสร้างข้อความ การวิเคราะห์ภาพ หรือการตัดสินใจเชิงเอเจนต์ โดยไม่ติดข้อจำกัดด้านสิทธิการใช้งานและทรัพยากรคอมพิวเตอร์ที่มีอยู่ ถ้าต้องสรุปสั้น ๆ Gemma 4 เหมาะกับคนที่อยากได้โมเดลโอเพนซอร์สแบบเปิดน้ำหนัก ใช้งานได้กว้างและรันบนเครื่องตัวเอง Qwen 3.8 เหมาะกับคนที่รับได้กับการเรียกผ่าน API แลกกับความสามารถด้านภาพ วิดีโอ และงานเอเจนต์ระดับสูง ส่วน Granite Switch 4.1 เหมาะกับทีมที่อยากควบคุมการตัดสินใจและความปลอดภัยด้วยอะแดปเตอร์เฉพาะทางบนโมเดลขนาดไม่ใหญ่เกินไป Gemma 4 เป็นตระกูลโมเดลของ Google DeepMind ที่เปิดน้ำหนักให้ดาวน์โหลดได้ห้าขนาด ภายใต้สัญญาอนุญาต Apache 2.0 ครอบคลุมตั้งแต่ Gemma 4 E2B, E4B, 12B ไปจนถึง 26B A4B และ 31B จุดเด่นคือเป็นโมเดลโอเพนซอร์สที่ผู้ใช้สามารถนำไปปรับแต่งและรันบนฮาร์ดแวร์ของตัวเองได้อย่างยืดหยุ่น Qwen 3.8 จากฝั่ง Alibaba เป็นตระกูลโมเดลที่มีทั้งเวอร์ชันเปิดน้ำหนักและแบบให้บริการผ่าน API Qwen3.8-27B เป็นเช็กพอยต์แบบ dense ที่เปิดภายใต้ Apache 2.0 และรองรับทั้งข้อความและภาพ ส่วนรุ่น Max และ Flash เน้นให้ใช้งานผ่านเอนด์พอยต์ ทำให้ผู้ใช้ที่ไม่อยากดูแลโครงสร้างพื้นฐานเองสามารถใช้ความสามารถระดับสูงได้ แต่ต้องยอมรับข้อจำกัดด้านลิขสิทธิ์และการพึ่งพาโฮสต์ Granite Switch 4.1 8B ของ IBM เป็นอีกแนวทางหนึ่งในโลกโมเดลโอเพนซอร์ส ใช้โมเดลข้อความ Granite 4.1 8B เป็นแกนหลักแล้วติดอะแดปเตอร์ activated-LoRA สำหรับความปลอดภัย การตัดสินใจ และเข้ารหัสเสียงเข้ามาเพิ่ม ภายใต้ Apache 2.0 เช่นกัน ทำให้เหมาะกับงานที่ต้องการควบคุมพฤติกรรมโมเดลอย่างละเอียดโดยไม่ต้องเพิ่มขนาดพารามิเตอร์มากนัก เมื่อมองจากมุมผู้ใช้ที่มี GPU เดียวและความต้องการ RAM จำกัด การเลือกโมเดลจึงไม่ใช่แค่ Gemma vs Qwen แต่ต้องคิดรวม Granite Switch 4.1 ด้วย ว่าต้องการโมเดล unified ที่ฝึกทุกโมดัลลิตีร่วมกันแบบ Gemma 4 หรือโมเดลที่เน้นภาพและงานเอเจนต์ผ่าน API แบบ Qwen 3.8 หรือโมเดลที่ต่ออะแดปเตอร์เพื่อเสริมความปลอดภัยและการตัดสินใจแบบ Granite
| Spec | A | B |
|---|---|---|
| ขนาดพารามิเตอร์โดยประมาณ | Granite Switch 4.1 8B รวมอะแดปเตอร์ 8.78B | Gemma 4 12B 11.95B |
| หน้าต่างบริบท | Granite 131,072 โทเคน | Gemma 256,000 โทเคน |
| รูปแบบข้อมูลเข้า | Granite ข้อความและเสียง | Gemma ข้อความ รูปภาพ เสียง และวิดีโอ |
| สถาปัตยกรรม | Granite ฐาน 8B ติดอะแดปเตอร์ guardian-core และ decision บวก Granite Speech 5.0 TurboCTC | Gemma สแต็ก unified เดียว gemma4_unified ไม่มี encoder แยก |
| ลิขสิทธิ์ | ทั้งคู่ Apache 2.0 เปิดน้ำหนัก | ทั้งคู่ Apache 2.0 เปิดน้ำหนัก |
Gemma 4 ตระกูลเดียวหลายขนาด เหมาะกับใคร
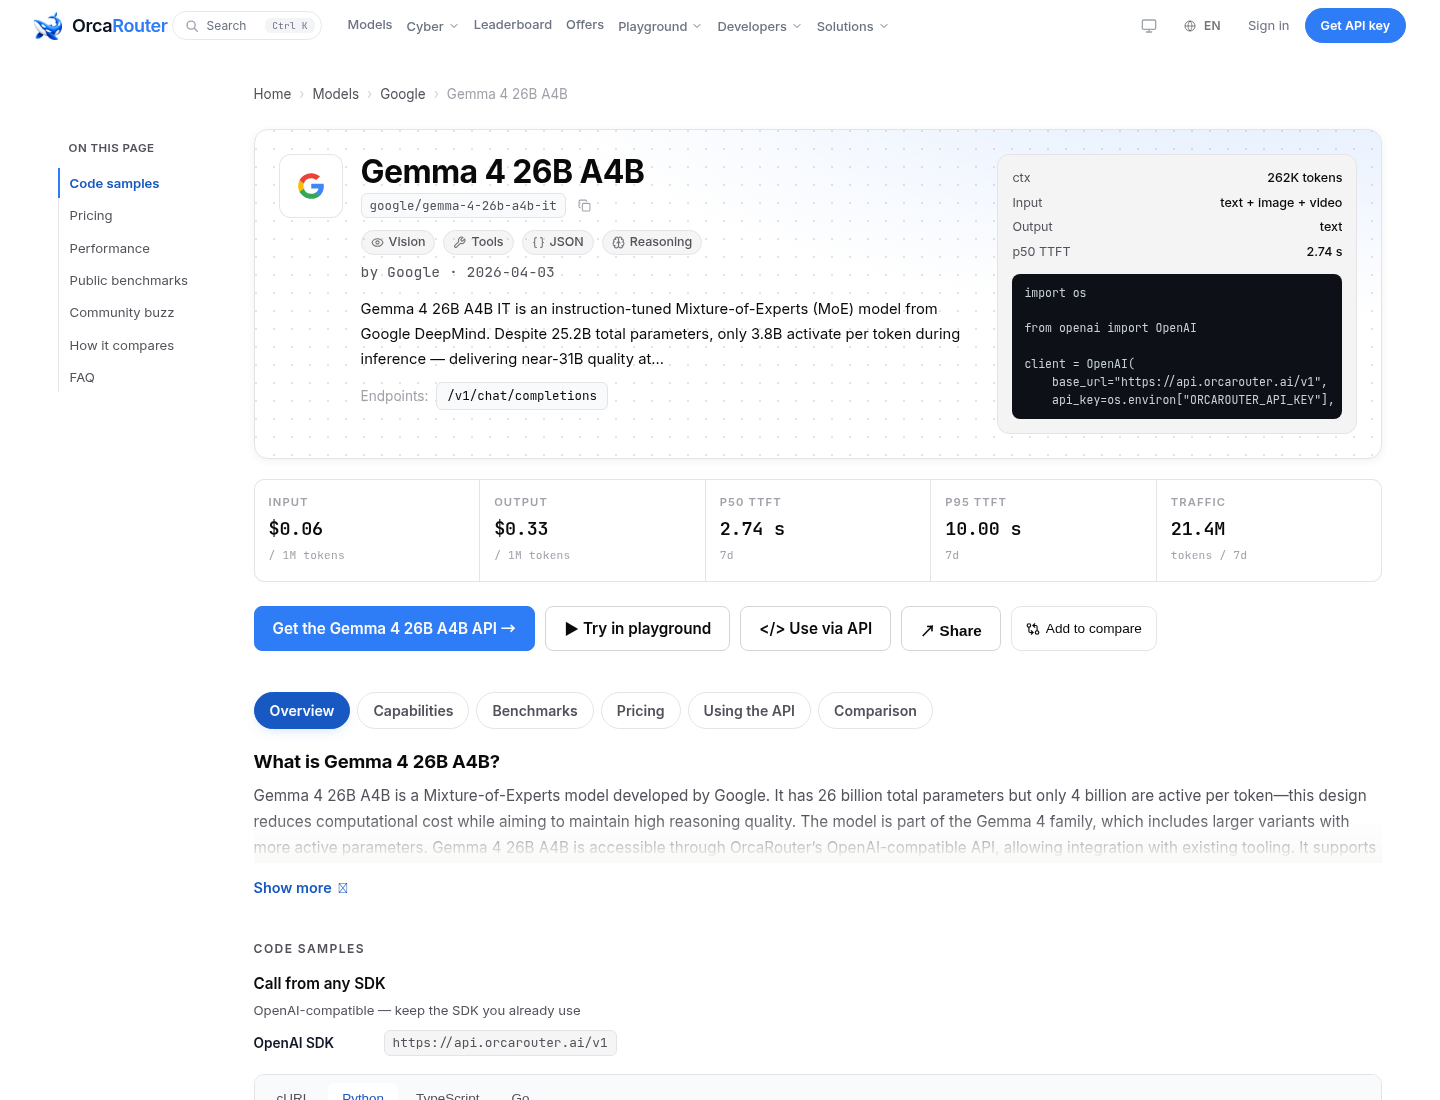
Gemma 4 เป็นตัวเลือกที่ชัดเจนสำหรับคนที่ต้องการโมเดลโอเพนซอร์สแบบเปิดน้ำหนักครบชุด ทั้งห้าขนาดตั้งแต่ E2B, E4B, 12B, 26B A4B ไปจนถึง 31B อยู่ภายใต้ Apache 2.0 ทำให้เหมาะกับการนำไปใช้เชิงพาณิชย์หรือปรับแต่งในองค์กรโดยไม่ติดข้อจำกัดลิขสิทธิ์ AI โมเดลมากนัก ในแง่สถาปัตยกรรม Gemma 4 12B ใช้แนวทาง unified เดียว gemma4_unified รวมข้อความ รูปภาพ เสียง และวิดีโอไว้ในคลังคำศัพท์ 262,144 โทเคน ไม่มี vision tower หรือ audio tower แยกต่างหาก ทำให้การรันมัลติโมดัลมีความสอดคล้องกันทั้งสแต็ก According to OrcaRouter Gemma 4 26B A4B IT เป็นโมเดล mixture-of-experts ที่มีพารามิเตอร์รวม 25.2B แต่เปิดใช้งานประมาณ 3.8B ต่อโทเคนและรองรับบริบท 256K จุดแข็งของ Gemma 4 คือความสมดุลระหว่างขนาดโมเดลและความสามารถมัลติโมดัล เหมาะกับผู้ใช้ที่มี GPU เดียวแต่ต้องการให้โมเดลมองเห็นภาพหรือวิดีโอร่วมกับข้อความ โดยเฉพาะเวอร์ชัน 12B และ 26B A4B ที่ออกแบบมาให้รันระดับโฮสต์เองได้ หากคุณมีความต้องการ RAM ระดับกลางถึงสูงและอยากควบคุมการดีพลอยเอง Gemma 4 มักเป็นคำตอบแรก ข้อแลกเปลี่ยนคือยิ่งเลือกขนาดใหญ่ เช่น 26B หรือ 31B ก็ยิ่งต้องคิดเรื่องความต้องการ RAM และ VRAM มากขึ้น แม้จะมีทางเลือกการปรับขนาดเช่นการ quantize เป็น 4-bit หรือ 8-bit แต่ผู้ใช้ที่มี GPU 16GB อาจต้องเลือกขนาดเล็กกว่าและยอมลดประสิทธิภาพบางส่วน ขณะที่ผู้มี GPU 24GB ขึ้นไปจะมีพื้นที่ให้ลองรุ่นใหญ่และบริบทยาวเต็มที่
Qwen 3.8 โมเดลสาย API หนัก เหมาะกับงานภาพ วิดีโอ และเอเจนต์
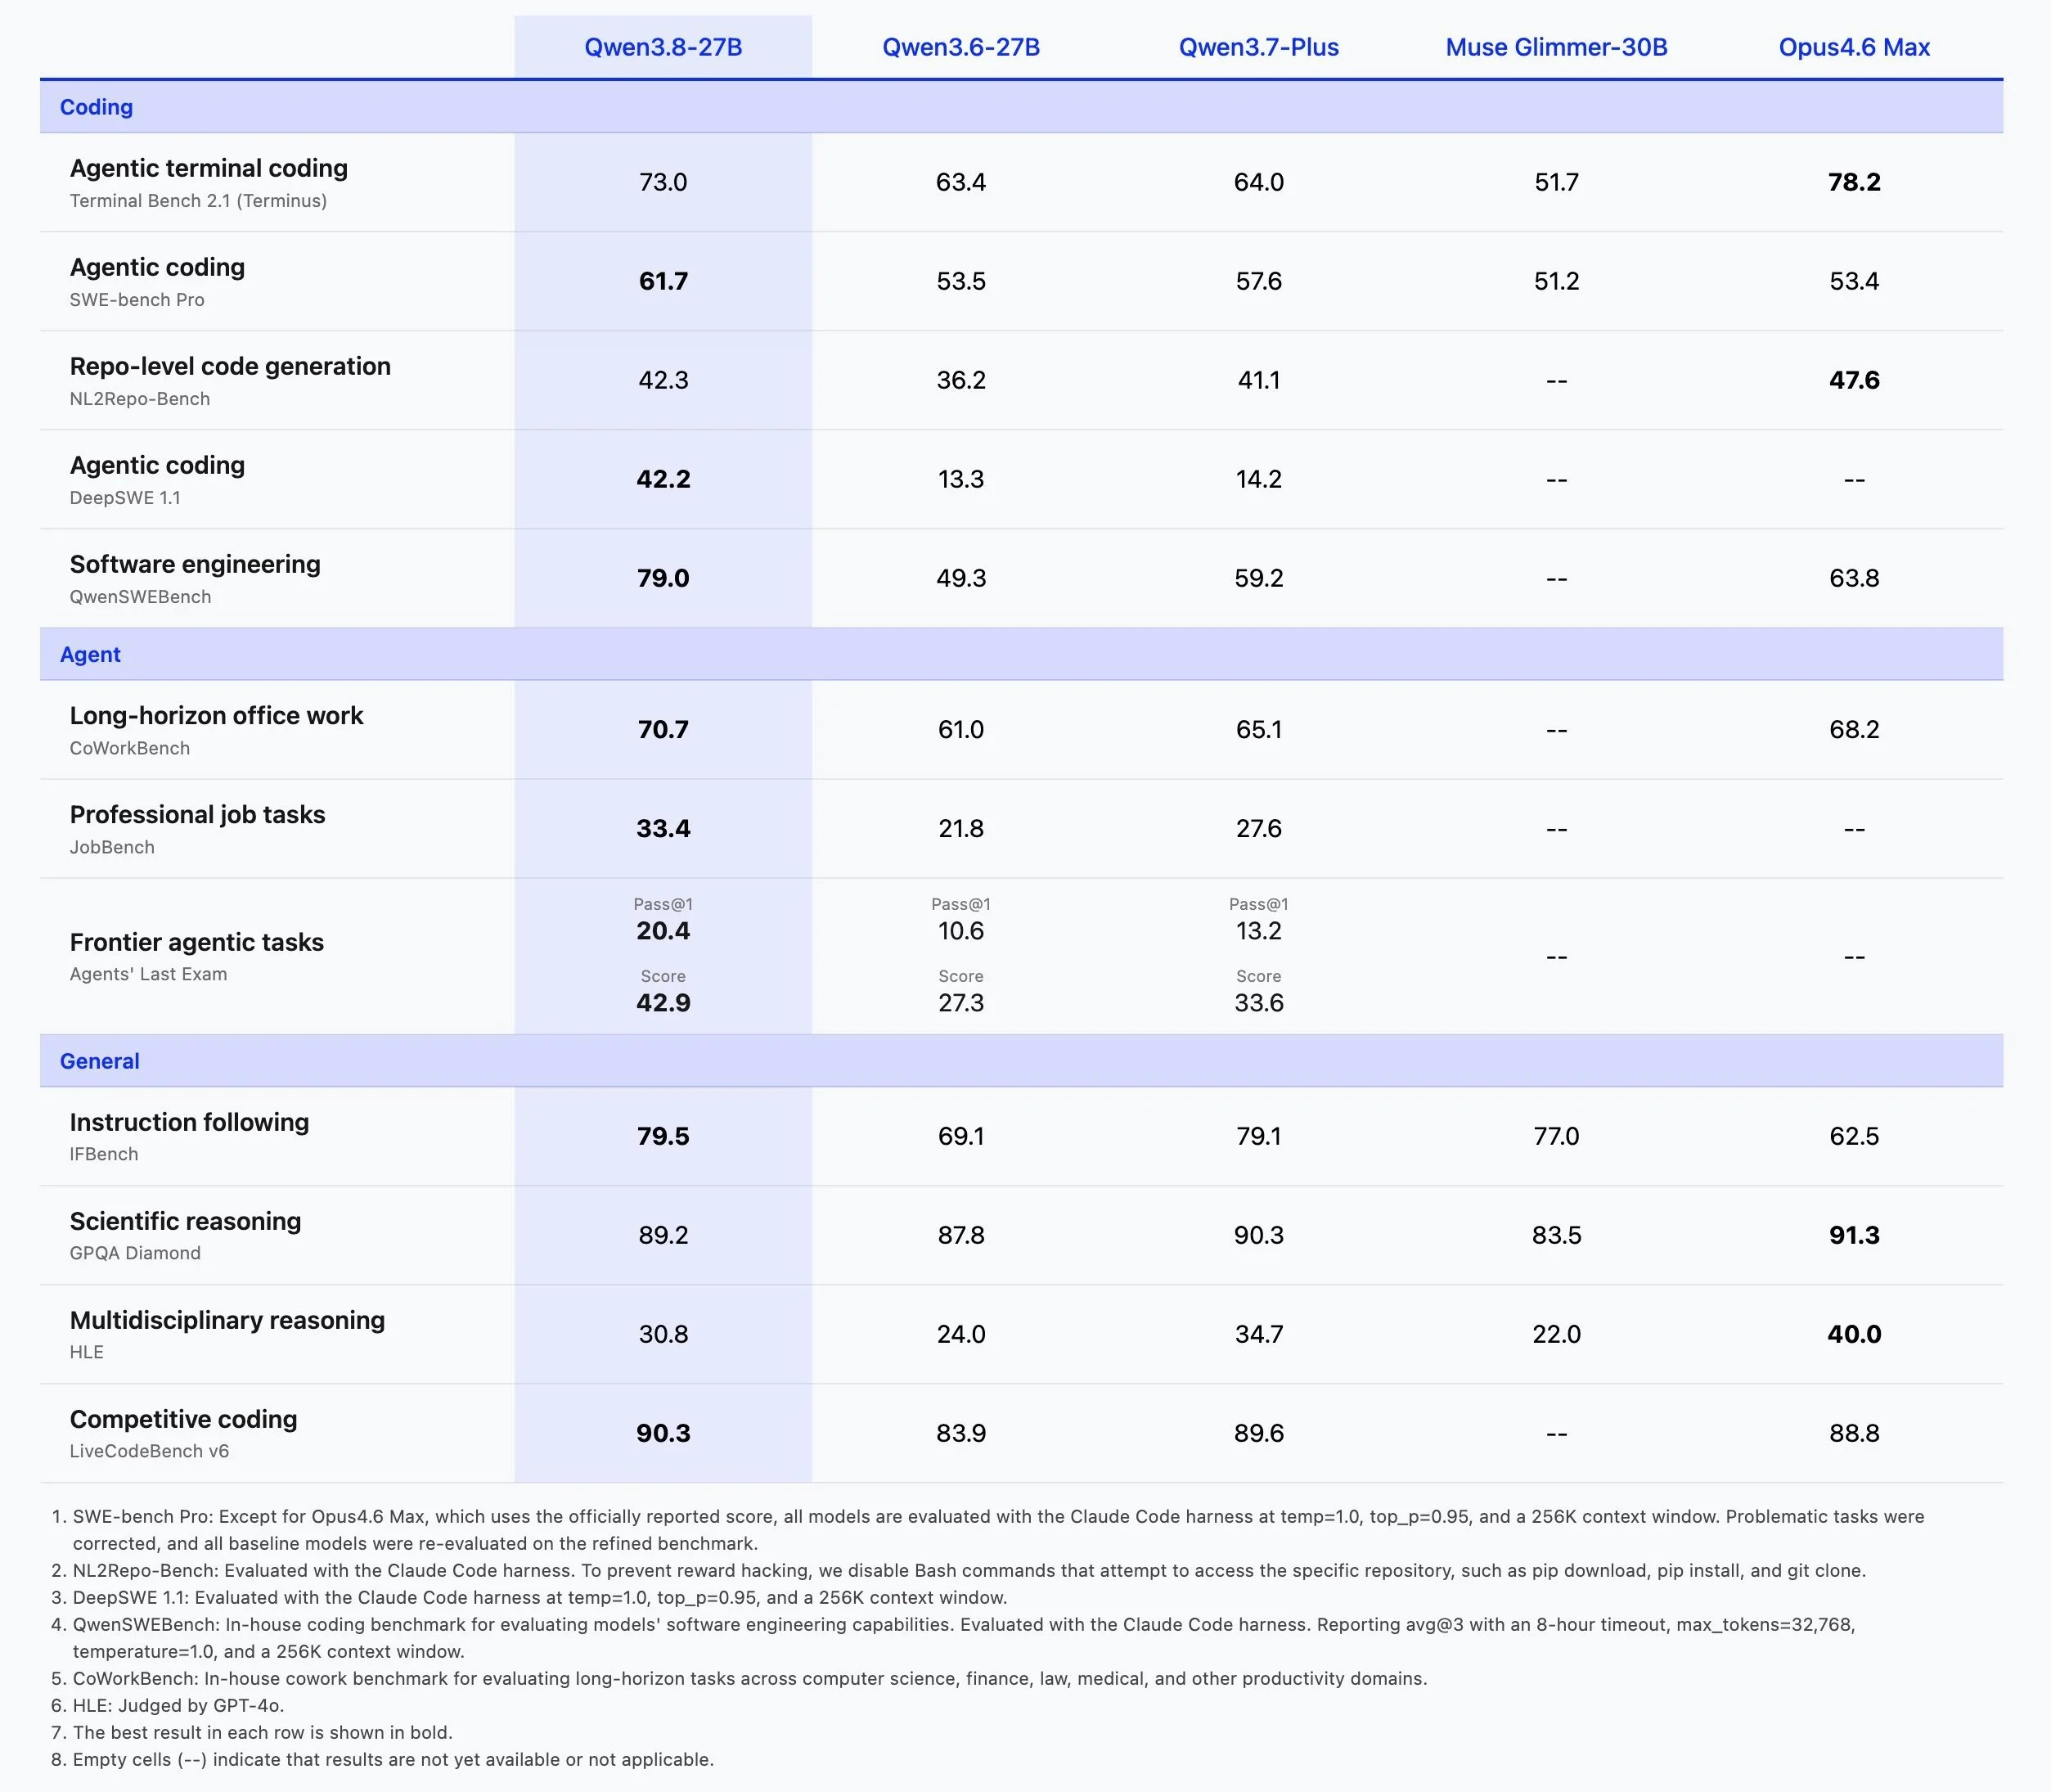
Qwen 3.8 ถูกออกแบบมาให้เป็นตระกูลที่ตอบโจทย์ผู้ใช้หลายกลุ่ม แต่โครงสร้างเน้นการให้บริการผ่าน API มากกว่าเปิดน้ำหนักให้ดาวน์โหลดทุกตัว Qwen3.8-27B เป็นสมาชิกหลักที่ผู้ใช้ถือครองได้ เป็นโมเดล dense ขนาด 27 พันล้านพารามิเตอร์ หรือ 27.8B เมื่อรวม vision tower รองรับทั้งข้อความและภาพ ภายใต้ Apache 2.0 สำหรับเวตต์ ส่วน Qwen3.8-Max และ Qwen3.8-Flash เป็นสมาชิกแบบโฮสต์ที่ให้บริการเฉพาะผ่านเอนด์พอยต์ การ์ดโมเดลของ Alibaba อธิบาย Qwen3.8-27B ว่าเป็นโมเดลที่เข้าใจทั้งภาพและภาษาโดยกำเนิด รองรับแผนภาพ เอกสาร STEM และวิดีโอระดับชั่วโมง มีโหมดคิดที่ยืดหยุ่นและออกแบบมาเพื่อพางานที่ซับซ้อนและมีหลายขั้นตอนให้เสร็จได้อย่างเชื่อถือมากขึ้น จุดเด่นคือความสามารถด้านการเขียนโค้ด งานวิชาชีพ งานวิจัย และงานแบบเอเจนต์ที่ต้องวางแผนระยะยาว สำหรับคนที่อยากรันโมเดลบนฮาร์ดแวร์ตัวเอง Qwen3.8-27B คือสมาชิกที่ควรโฟกัส เพราะเป็น open-weight ภายใต้ Apache 2.0 แต่ขนาด 27B ทำให้ความต้องการ RAM และ VRAM สูงกว่า Gemma 4 12B อย่างชัดเจน จึงเหมาะกับผู้ใช้ที่มี GPU 24GB หรือมากกว่า หรือพร้อมรันบนเซิร์ฟเวอร์ที่รองรับโมเดลใหญ่ ในทางกลับกัน ผู้ใช้ที่ไม่อยากดูแลฮาร์ดแวร์เองสามารถใช้ Qwen3.8-Max, Flash, Omni-Flash หรือ LiveTranslate ผ่าน API เพื่อรับความสามารถด้านภาพ เสียง และการแปลแบบพร้อมกัน แต่ต้องยอมรับข้อจำกัดด้านลิขสิทธิ์ที่แตกต่างจาก Apache 2.0 เช่น Qwen Community License 1.0 สำหรับ Qwen3.8-Flash-Next และข้อตกลงแบบกำหนดเองสำหรับ Qwen3.8-2.4T-A95B
Granite Switch 4.1 8B แนวทางอะแดปเตอร์สำหรับงานตัดสินใจและความปลอดภัย
Granite Switch 4.1 8B เป็นตัวอย่างชัดเจนของโมเดลโอเพนซอร์สที่ใช้แนวทางอะแดปเตอร์แทนการฝึก unified เดียวเหมือน Gemma 4 แกนหลักคือ Granite 4.1 8B โมเดลข้อความ 40 เลเยอร์ ขนาดฮิดเดน 4,096 มี 32 เฮดคิวรีเทียบกับ 8 เฮด KV หน้าต่างบริบท 131,072 โทเคน และคำศัพท์ 100,352 โทเคน จากนั้น IBM ติด activated-LoRA สองตัวคือ guardian-core แรงก์ 16 เหนือโปรเจกชันแอตเทนชัน และ decision แรงก์ 64 ครอบคลุมเจ็ดรายการ บวก Granite Speech 5.0 TurboCTC ขนาด 470M พารามิเตอร์สำหรับอินพุตเสียง รวมแล้ว Granite Switch 4.1 8B มี 8,776,400,896 พารามิเตอร์ เพิ่มขึ้น 4.72% จากฐาน 8,380,551,168 จุดแข็งของแนวทางนี้คือผู้ใช้สามารถรันโมเดลข้อความขนาด 8B บน GPU เดียวได้ง่ายกว่าโมเดล 12B หรือ 27B แต่ยังได้หัวเฉพาะทางสำหรับการตัดสินใจและตัวจำแนกความปลอดภัยที่ผ่านการคาลิเบรต ทำให้เหมาะกับงานที่ต้องควบคุมการตอบสนอง เช่น ระบบช่วยตัดสินใจในองค์กร หรือแอปพลิเคชันที่ต้องกรองเนื้อหาก่อนตอบผู้ใช้ เมื่อเปรียบเทียบกับ Gemma 4 12B ซึ่งไม่มีหัวเฉพาะทางด้านความปลอดภัยหรือการตัดสินใจ Granite Switch 4.1 จะเด่นในงานที่ต้องการเส้นทางตัดสินใจชัดเจนและการแยกส่วนโมดูล ส่วน Gemma 4 จะเด่นในงานมัลติโมดัลที่ต้องเห็นภาพและวิดีโอร่วมกับข้อความ ผู้ใช้ที่มีความต้องการ RAM จำกัดและเน้นข้อความกับเสียงจึงมักมอง Granite เป็นตัวเลือกที่คุ้มกว่า อย่างไรก็ตาม การใช้โมเดลแบบประกอบด้วยอะแดปเตอร์หมายความว่าประสิทธิภาพด้านการเข้าใจภาพจะไม่เทียบเท่า Gemma 4 unified ที่ฝึกทุกโมดัลลิตีร่วมกันตั้งแต่ต้น หากงานหลักของคุณคือการสร้างข้อความจากภาพหรือวิดีโอ Granite Switch 4.1 อาจไม่ใช่คำตอบ แต่ถ้าเน้นการตัดสินใจและความปลอดภัยบนข้อความและเสียงเป็นหลัก มันจะเหมาะมาก
Buy if / Skip if
- Buy the Gemma 4 12B if คุณต้องการโมเดลโอเพนซอร์สแบบ unified ที่รองรับข้อความ รูปภาพ เสียง และวิดีโอบน GPU เดียวและต้องการลิขสิทธิ์ Apache 2.0 สำหรับการใช้งานเชิงพาณิชย์
- Skip the Gemma 4 12B if ฮาร์ดแวร์ของคุณมีความต้องการ RAM จำกัดมากและเน้นเฉพาะข้อความกับเสียงโดยไม่ต้องการความสามารถด้านภาพหรือวิดีโอ
- Buy the Gemma 4 26B A4B if คุณมี GPU ระดับสูงและต้องการบริบทยาว 256K พร้อม mixture-of-experts ที่เปิดใช้งานเพียงประมาณ 3.8B ต่อโทเคนเพื่อรันงาน reasoning หนัก
- Skip the Gemma 4 26B A4B if คุณใช้เครื่องเดสก์ท็อปหรือเซิร์ฟเวอร์ที่มี VRAM ต่ำกว่า 24GB และไม่พร้อมจัดการความต้องการ RAM ของโมเดลขนาดใหญ่
- Buy the Qwen3.8-27B if คุณต้องการโมเดลที่เข้าใจทั้งภาพและภาษาโดยกำเนิด มีความสามารถด้านโค้ด งานวิชาชีพ และงานเอเจนต์ และมีฮาร์ดแวร์รองรับโมเดล 27B
- Skip the Qwen3.8-27B if คุณต้องการรันโมเดลบน GPU เดียวขนาดกลางหรือเล็ก และไม่พร้อมรับภาระด้านความต้องการ RAM ของโมเดล dense ขนาดใหญ่
- Buy the Qwen 3.8 Max API family if คุณโอเคกับการเรียกผ่าน API เพื่อแลกกับความสามารถด้านภาพ วิดีโอ เสียง และงานเอเจนต์ขั้นสูง โดยไม่ต้องดูแลโครงสร้างพื้นฐานเอง
- Skip the Qwen 3.8 Max API family if คุณต้องการควบคุมเวตต์เองเต็มที่ ต้องการดีพลอยแบบออฟไลน์ หรือมีข้อจำกัดด้านลิขสิทธิ์ที่ต้องใช้ Apache 2.0 เท่านั้น
- Buy the Granite Switch 4.1 8B if คุณต้องการโมเดลขนาด 8B ที่รันบน GPU เดียวได้ง่าย มีอะแดปเตอร์ guardian-core และ decision เพื่อเสริมความปลอดภัยและการตัดสินใจ พร้อมรองรับเสียงผ่าน Granite Speech 5.0 TurboCTC
- Skip the Granite Switch 4.1 8B if งานหลักของคุณคือการประมวลผลภาพหรือวิดีโอเชิงลึก เพราะสถาปัตยกรรมแบบอะแดปเตอร์ของมันไม่ได้ออกแบบมาเป็นมัลติโมดัลเต็มรูปแบบเหมือน Gemma 4