
นิยามใหม่ของการตรวจสอบโมเดล ML ในโลกการเงิน
การตรวจสอบโมเดล ML คือกระบวนการประเมินตั้งแต่ข้อมูลที่ใช้ฝึก โมเดลที่ได้ ไปจนถึงผลกระทบทางธุรกิจของการตัดสินใจที่โมเดลสร้างขึ้น โดยไม่มองแค่คะแนนความแม่นยำในการทำนายหรือผลแบ็กเทสต์ แต่ต้องพิสูจน์ว่าพฤติกรรมของโมเดลมีคุณค่าเชิงเศรษฐกิจ สร้างผลลัพธ์ที่ทำซ้ำได้ และไม่อาศัยข้อมูลที่รั่วไหลจากอนาคต การตรวจสอบที่ดีจึงเชื่อมโยงตั้งแต่การออกแบบงานวิจัย การทดสอบระบบ AI แบบสถิติ ไปจนถึงการเฝ้าระวังในโปรดักชัน เพื่อรองรับการจัดการความเสี่ยงขององค์กรการเงินและธุรกิจขนาดใหญ่ ในโลกการเงิน โมเดลที่ดูดีบนกระดาษอาจไร้ค่าในตลาดจริง เพราะคะแนนความแม่นยำในการทำนายไม่ได้สะท้อนมูลค่าทางเศรษฐกิจโดยตรง โมเดลมักถูกปรับเพื่อเป้าหมายทางคณิตศาสตร์ เช่น error, accuracy, AUC หรือ log loss แต่ตลาดให้รางวัลกับการตัดสินใจที่คำนึงถึงต้นทุนธุรกรรม ความผันผวน และข้อจำกัดด้านเวลา การตรวจสอบโมเดล ML ที่ดีจึงต้องมองครบโซ่การสร้างคุณค่า ตั้งแต่ prediction → decision → economic outcome
ความแม่นยำไม่เท่ากับมูลค่า ทำไมแบ็กเทสต์หลอกเราได้
ปัญหาใหญ่ขององค์กรคือหลงเชื่อว่าความแม่นยำสูงกับผลแบ็กเทสต์สวยงามคือหลักฐานว่าระบบ AI ใช้งานได้จริง ทั้งที่ในตลาดการเงิน โมเดลอาจทำนายทิศทางถูกบ่อย แต่ดันถูกก่อนการเคลื่อนไหวเล็กๆ และผิดในจังหวะที่ราคาขยับแรง ผลลัพธ์คือคะแนนสถิติดีแต่ตัดสินใจแย่ทางเศรษฐกิจ High predictive accuracy does not guarantee economic usefulness เมื่อโมเดลถูกปรับเพื่อเป้าหมายทางตัวเลขแบบแคบ โลกจริงที่เต็มไปด้วยต้นทุนธุรกรรม ความผันผวน และผลลัพธ์ไม่สมมาตรจึงทำให้มูลค่าจริงบิดเบือนได้ ยิ่งไปกว่านั้น โมเดลสองตัวสามารถมี error ใกล้เคียงกัน แต่เรียนรู้ฟังก์ชันต่างกันอย่างมีนัยสำคัญ ผลวิจัยในงาน volatility forecasting พบว่าท่อการฝึกต่างกันให้โมเดลที่นำไปสู่การตัดสินใจจัดพอร์ตที่มีความกระจายเกือบ 3 เท่า แม้คะแนนทำนายแทบไม่ต่างกัน ข้อเท็จจริงนี้ตอกย้ำว่าการตรวจสอบโมเดล ML ต้องประเมินทั้งพฤติกรรมการตัดสินใจและความสามารถในการทำซ้ำของกระบวนการวิจัย ไม่ใช่หยุดที่ตัวเลขความแม่นยำในการทำนาย
| ประเด็น | มองแบบคะแนน ML | มองแบบมูลค่าทางเศรษฐกิจ |
|---|---|---|
| ผลลัพธ์หลัก | ความแม่นยำสูงบนชุดทดสอบ | กำไรหลังต้นทุนและความผันผวน |
| ความเสี่ยง | โอเวอร์ฟิตแต่ไม่ถูกจับได้ | การจัดการความเสี่ยงเชิงพอร์ตและธุรกิจ |
| การตรวจสอบโมเดล ML | ดูแค่ metric เดียว | ตรวจสอบ prediction → decision → economic outcome |
คุณภาพระบบ AI ต้องเริ่มจากการตรวจสอบข้อมูลและโมเดล
เมื่อระบบ AI ไม่เป็นดีเทอร์มินิสติก เห็นคำถามเดียวกันให้คำตอบต่างกันได้ การทดสอบระบบ AI แบบเดิมที่หวังผลผ่านตกชัดเจนจึงใช้ไม่ได้ คุณภาพต้องถูกคิดใหม่ในสามชั้นคือข้อมูล โมเดล และเลเยอร์พรอมต์หรือเอเจนต์ที่โต้ตอบกับผู้ใช้ ชั้นข้อมูลคือรากฐาน การตรวจสอบข้อมูลจึงสำคัญที่สุด เพราะเกือบทุกความล้มเหลวของ AI หากไล่ย้อนมักเจอปัญหาจากข้อมูลที่เข้าไปในโมเดล ทีมคุณภาพเริ่มรับผิดชอบด่านข้อมูลโดยใช้เฟรมเวิร์กที่ตั้ง expectation เชิงประกาศ เช่น schema อัตรา null ช่วงค่าที่รับได้ และการกระจายของข้อมูลก่อนจะปล่อยให้ไหลต่อไปในท่อข้อมูล แนวทาง shift-left นี้ทำให้ปัญหา garbage-in-garbage-out ไม่หลุดรอดไปฝึกโมเดล ลดภาระการจัดการความเสี่ยงภายหลัง ด้านโมเดล การตรวจสอบโมเดล ML จึงไม่ใช่การเช็กตัวเลข accuracy เดียวอีกต่อไป แต่ต้องใช้ชุดการประเมินแบบหลายชั้น ทั้ง train/validation split cross-validation holdout test และ A/B test กับเบสไลน์ในโปรดักชัน
กรอบวิศวกรรมคุณภาพและการจัดการความเสี่ยงในโปรดักชัน
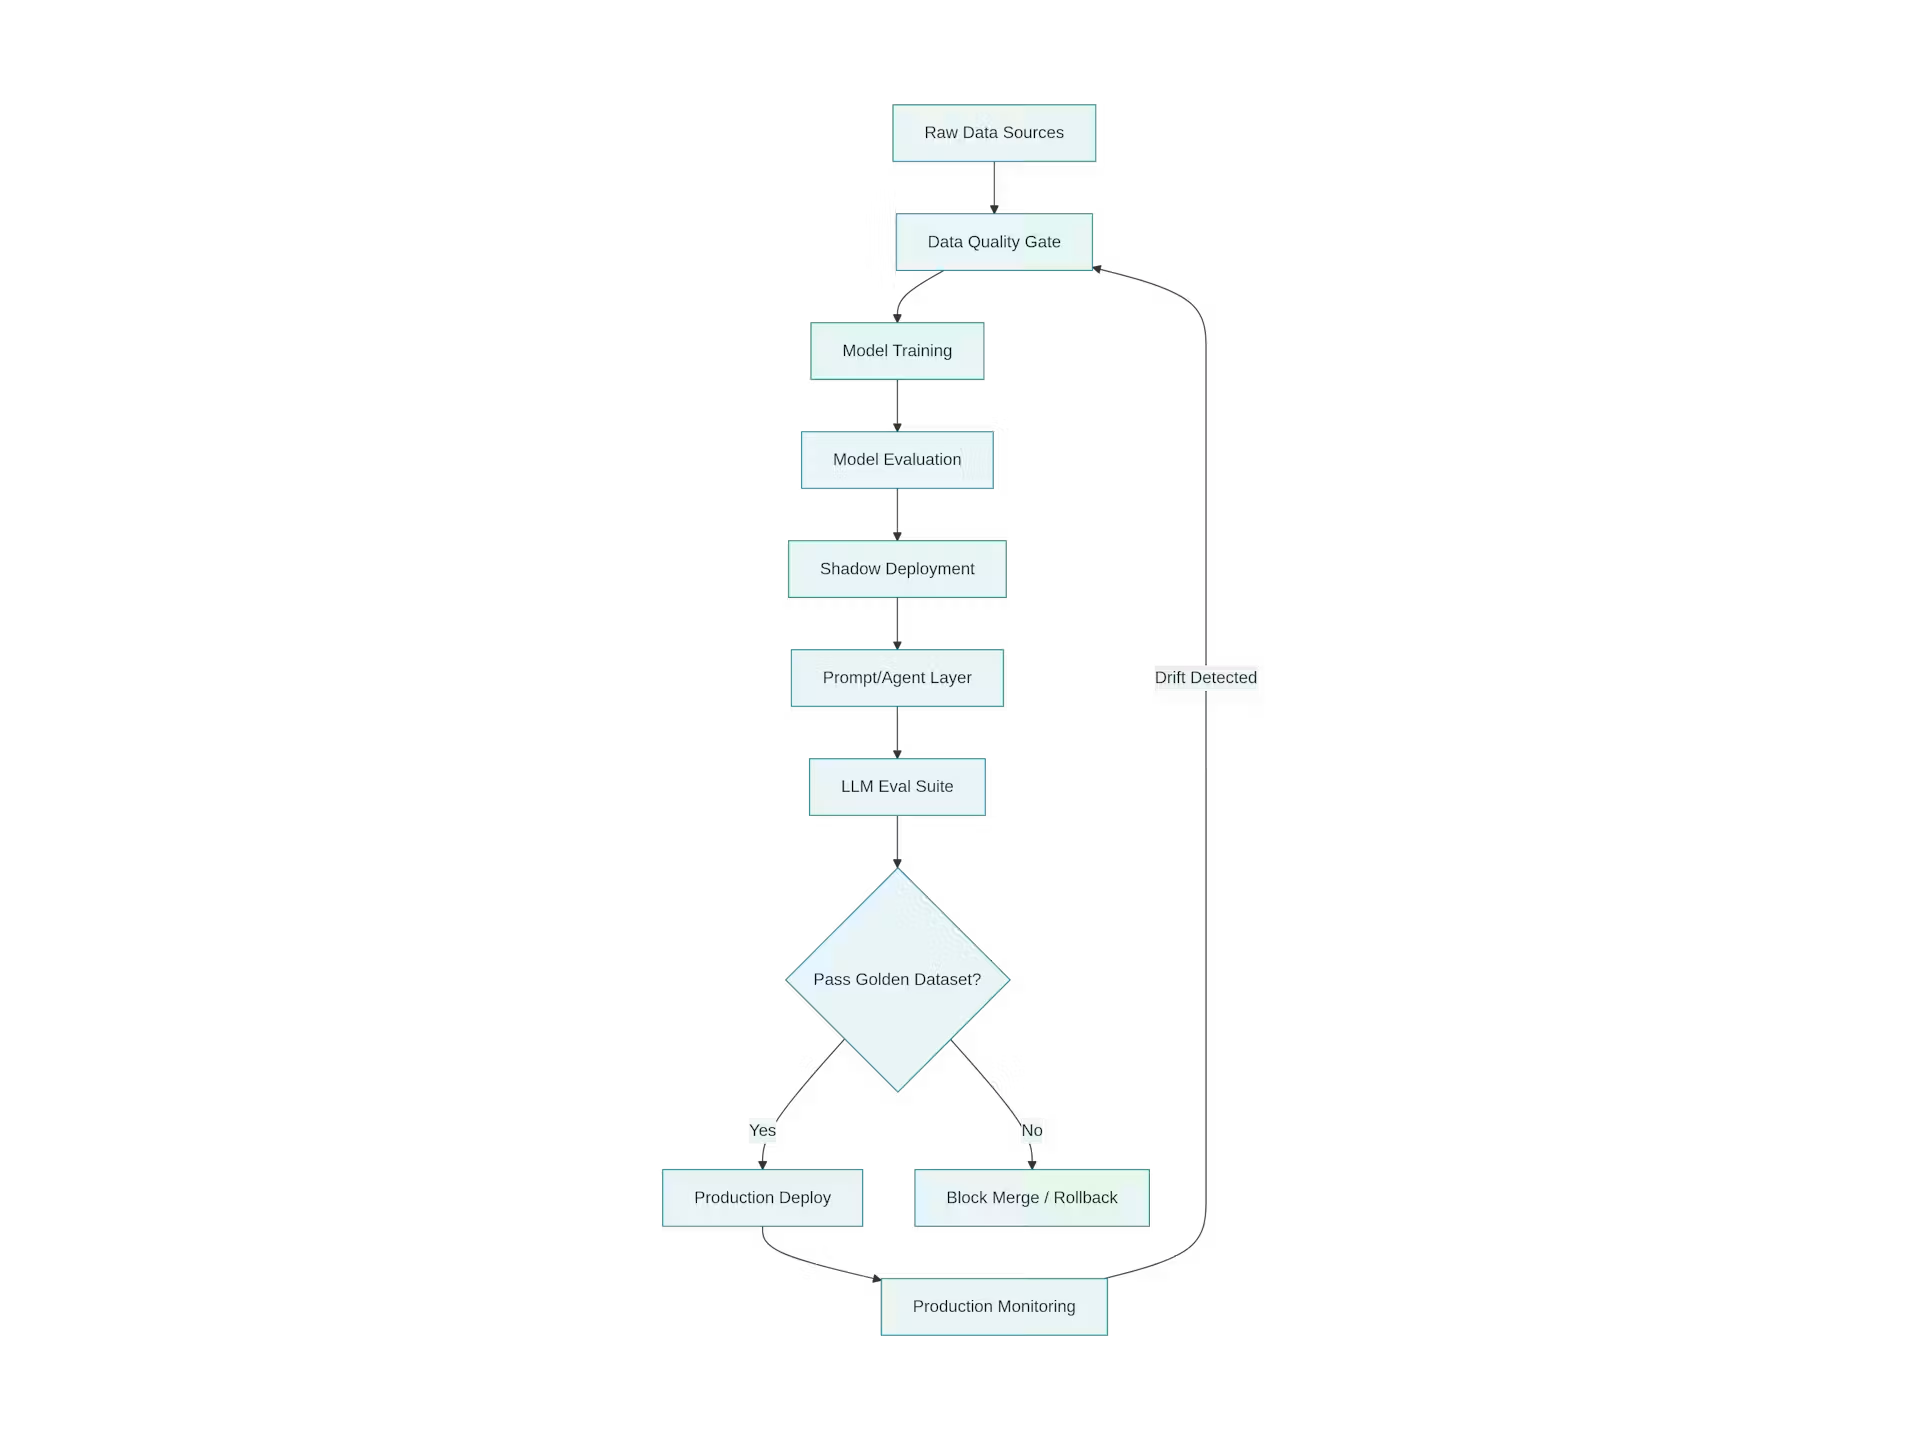
องค์กรที่จริงจังกับการจัดการความเสี่ยงของ AI เริ่มยอมรับว่า QA แบบเดิมไม่พอ เพราะระบบที่ทดสอบไม่ใช่โค้ดดีเทอร์มินิสติก แต่เป็นโมเดลที่นิยามเชิงสถิติและเปลี่ยนไปตามข้อมูลใหม่ วิศวกรรมคุณภาพสำหรับ AI จึงกลายเป็นวินัยใหม่ที่หยิบองค์ความรู้จาก data engineering สถิติ และ ML operations มาใช้ โดยยังยึดภารกิจเดิมคือสร้างความเชื่อมั่นก่อนปล่อยระบบใช้งาน หัวใจคือการสร้างวงจรคุณภาพแบบ end-to-end ที่ผูกการตรวจสอบข้อมูล การตรวจสอบโมเดล ML ชุดทดสอบ regression ของเอเจนต์ และการเฝ้าระวังในโปรดักชันเข้าด้วยกัน สิ่งสำคัญคือลูกศรย้อนกลับจากการมอนิเตอร์ในโปรดักชันไปยังด่านข้อมูล เพราะท่อ AI ไม่มีคำว่าเสร็จ การตรวจพบ drift ในโลกจริงต้องกระตุ้นให้ระบบกลับไปตรวจสอบข้อมูล ฝึกใหม่ และประเมินใหม่ทันที ไม่ใช่รอรอบรีลีสถัดไป กรอบกำกับดูแลที่ดีจึงต้องฝังโปรโตคอลการทดสอบเพื่อจับความล้มเหลวในโปรดักชันก่อนกระทบธุรกิจ โดยใช้ทั้งเช็กอัตโนมัติแบบดีเทอร์มินิสติก การให้ LLM ช่วยประเมิน และการรีวิวของมนุษย์สำหรับเคสความเสี่ยงสูง
จากเลขบนกราฟสู่ความเชื่อมั่นเชิงธุรกิจ
หากมองโครงการ AI แค่เป็นโมเดลที่ให้คะแนน accuracy สูง เรากำลังเล่นเกมตัวเลขโดยปล่อยให้ความเสี่ยงเชิงธุรกิจเดินตามหลังโดยไร้การควบคุม สิ่งที่ควรถามทุกครั้งไม่ใช่โมเดลแม่นแค่ไหน แต่คือกระบวนการวิจัยและการตรวจสอบโมเดล ML ช่วยให้ตัดสินใจทางเศรษฐกิจดีขึ้นหรือไม่ และมีหลักฐานที่ทำซ้ำได้หรือเปล่า การตรวจสอบที่ดีจึงต้องมอง validation เป็นโซ่ ไม่ใช่ตัวเลขหนึ่งค่า เพราะสิ่งที่ถูกประเมินจริงๆ ไม่ใช่แค่โมเดลสุดท้าย แต่คือกระบวนการวิจัยทั้งหมดที่สร้างมันขึ้นมา เมื่อองค์กรนำกรอบวิศวกรรมคุณภาพมาผูกกับการตรวจสอบข้อมูล การทดสอบระบบ AI แบบสถิติ และการมอนิเตอร์โปรดักชันอย่างต่อเนื่อง เราจะเปลี่ยน AI จากของเล่นเชิงเทคนิคให้เป็นสินทรัพย์ที่มีการจัดการความเสี่ยงรอบด้าน การไม่หลงเชื่อคะแนนความแม่นยำในการทำนายแต่ใช้ validation ที่รั่วข้อมูลไม่ได้ ทำซ้ำได้ และผูกกับผลลัพธ์เชิงเศรษฐกิจ คือก้าวสำคัญที่จะทำให้ AI กลายเป็นโครงสร้างพื้นฐานทางธุรกิจที่ไว้ใจได้ในระยะยาว