
ความเสี่ยง AI ในธุรกิจเริ่มต้นจากความเข้าใจผิดเรื่องคำว่าแม่นยำ
ความเสี่ยง AI ในธุรกิจคือสถานการณ์ที่องค์กรใช้ปัญญาประดิษฐ์โดยเชื่อในตัวเลขความแม่นยำหรือผลทดสอบย้อนหลังโดยไม่ตรวจสอบว่าโมเดลแปลผลไปสู่การตัดสินใจเชิงเศรษฐกิจที่มีคุณค่า มีความปลอดภัยข้อมูล AI เพียงพอ และไม่สร้างอุปสรรคใหม่ให้กับคนทำงานในสายอาชีพที่เกี่ยวข้อง ซึ่งช่องว่างการตรวจสอบนี้ทำให้ระบบที่ดูน่าเชื่อถือบนกระดาษกลายเป็นต้นเหตุของการขาดทุนเชิงธุรกิจ การเปิดช่องให้โจมตีไซเบอร์ และการปิดโอกาสการเติบโตของบุคลากรในระยะยาว
หัวใจของปัญหาไม่ใช่ว่า AI เก่งไม่พอ แต่คือองค์กรเชื่อในตัวเลขผิดประเภท ความแม่นยำ Machine Learning มักถูกวัดด้วยค่า error accuracy AUC หรือ log loss ซึ่งเป็นเป้าหมายเชิงคณิตศาสตร์ของนักพัฒนา แต่ตลาดและธุรกิจไม่ได้ตอบแทนโมเดลเพราะคะแนนพวกนี้ โมเดลเทรดดิ้งตัวหนึ่งอาจทำนายทิศทางได้ถูกบ่อยแต่ส่วนใหญ่เกิดก่อนการเคลื่อนไหวเล็กน้อย ขณะที่ครั้งที่ผิดดันอยู่หน้าการเคลื่อนไหวใหญ่ ทำให้ผลตอบแทนทางเศรษฐกิจแย่ แม้คะแนนทำนายสวยงามก็ตาม A model can be statistically good without being economically useful
ยิ่งไปกว่านั้น โมเดลสองตัวอาจมีความแม่นยำใกล้เคียงกันมากแต่สะท้อนฟังก์ชันการตัดสินใจที่ต่างกันอย่างมีนัยสำคัญ งานวิจัยด้านการพยากรณ์ความผันผวนพบว่าที่ระดับ Sharpe ratio ใกล้กัน พอร์ตโฟลิโอสามารถมีความถี่การซื้อขายต่างกันเกือบสามเท่า ซึ่งแปลว่าต้นทุนธุรกรรมและความสามารถในการใช้งานจริงต่างกันมาก Similar ML scores can hide different economic behaviour เมื่อธุรกิจมองแต่ตัวเลขด้านบนโดยไม่ถามว่าโมเดลตัดสินใจอะไรในโลกจริง ก็เหมือนเซ็นเช็คเปล่าให้ระบบอัตโนมัติ
เมื่อความแม่นยำหลอกตา: การตรวจสอบโมเดล AI ที่ดีต้องเกินกว่า backtest
ในโลกการเงิน ความเสี่ยง AI ในธุรกิจชัดเจนมาก โมเดลเทรดดิ้งอาจสร้าง backtest สวยหรูแต่ไม่ได้แปลว่ามันเรียนรู้อะไรที่ใช้การได้ในระยะยาว A trading AI can be accurate and still be economically useless มันยังสามารถสร้างผลทดสอบย้อนหลังที่ดีเยี่ยมโดยไม่ให้หลักฐานที่น่าเชื่อว่ามีการเรียนรู้ที่ยั่งยืนด้วย สาเหตุหนึ่งคือข้อมูลการเงินถูกใช้ซ้ำได้ง่าย นักวิจัยลองเปลี่ยนฟีเจอร์ โมเดล ไฮเปอร์พารามิเตอร์ วัตถุประสงค์หรือกฎตัดสินใจไปเรื่อยๆ จนกระทั่งมีบางตัวที่ดูดีแบบบังเอิญ
ทางออกจึงไม่ใช่การเชื่อ backtest ที่ชนะเลิศ แต่ต้องตรวจสอบทั้งกระบวนการคัดเลือก โมเดลที่ “ดูดีที่สุด” อาจเป็นเพียงผลการสุ่มที่โชคดี การทดลองหนึ่งใช้โมเดล deep reinforcement learning เทรดหุ้นและคริปโตซ้ำกัน 20 seed แล้วพบว่า Sharpe รายปีแกว่งจาก 0.233 ถึง 0.855 โดยค่าเฉลี่ยคือ 0.604 การรายงานเฉพาะ seed ที่ดีที่สุดทำให้ Sharpe ที่ประกาศสูงเกินจริงถึง 44% ซึ่งแตกต่างอย่างมากโดยไม่ได้เปลี่ยนสถาปัตยกรรมโมเดลหรือสัญญาณตลาดเลย แต่แค่เลือก realization ที่โชคดีกว่าเท่านั้น
ดังนั้น การตรวจสอบโมเดล AI ที่รับผิดชอบต้องคิดแบบ distribution ไม่ใช่ตัวเลขเดียว แทนที่จะเชื่อว่ามี performance เดียวที่แทนโมเดลได้ เราควรมองเป็นการกระจายของผลลัพธ์จากการเทรนซ้ำหลายครั้ง และที่สำคัญ ต้อง test the complete predictive workflow not merely the final winning model เพราะสิ่งที่เราประเมินจริงๆ ไม่ใช่โมเดลสุดท้าย แต่คือกระบวนการวิจัยทั้งหมด ตั้งแต่การออกแบบฟีเจอร์ การเลือกชุดข้อมูล การจับคู่สัญญาณกับกฎการตัดสินใจ ไปจนถึงเกณฑ์หยุดทดลอง
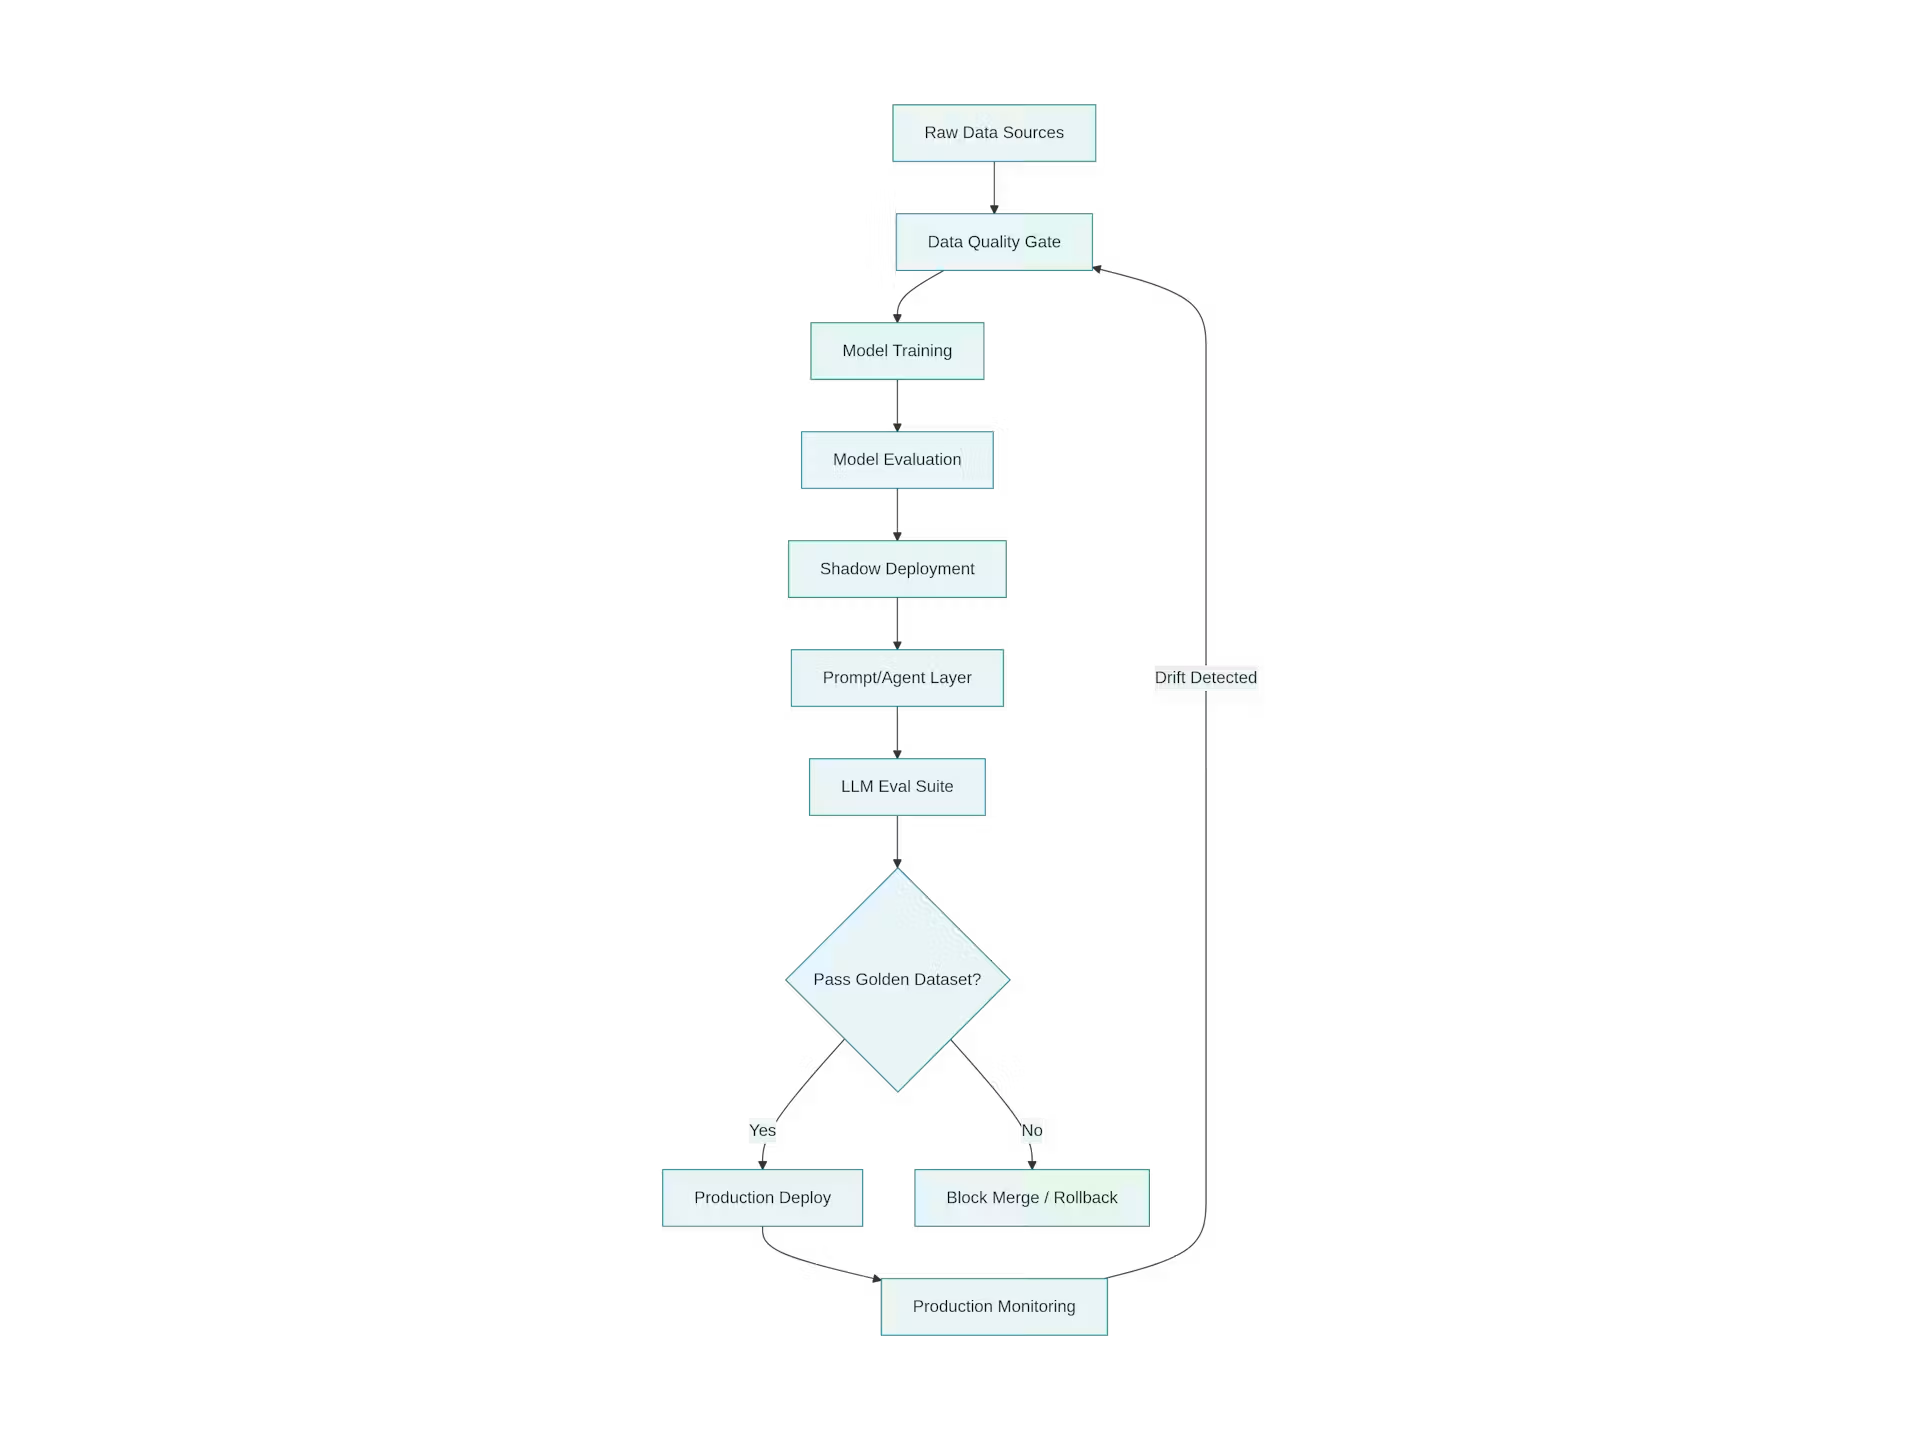
งานวิจัยสรุปแนวทางว่า validation chain ที่มีประโยชน์ควรหน้าตาแบบนี้ Predictive signal → Decision quality → Economic usefulness → Historical robustness → Reproducibility → Independent evidence นั่นหมายความว่าก่อนนำโมเดลเข้าผลิตจริง นักธุรกิจควรถามอย่างน้อยหกชั้น ไม่ใช่หยุดแค่ accuracy หรือ Sharpe ที่ดูน่าตื่นตา ซึ่งถ้าข้ามขั้นใดขั้นหนึ่งไป ความเสี่ยง AI ในธุรกิจจะถูกซ่อนอยู่ใต้พรมตัวเลขอย่างแนบเนียน
AI ใน SOC: เพิ่มประสิทธิภาพแต่สร้างกำแพงอาชีพและความเสี่ยงใหม่
ด้านความปลอดภัยไซเบอร์ก็สะท้อนปัญหาแบบเดียวกัน แต่เป้าหมายไม่ใช่กำไร เป็นเรื่องคนและความปลอดภัยข้อมูล AI งานวิจัยหนึ่งสำรวจผู้เชี่ยวชาญและผู้นำด้านปฏิบัติการความปลอดภัย 500 คน พบว่า 88% บอกว่า AI ทำให้งานของพวกเขาน่าพึงพอใจมากขึ้น ในขณะเดียวกัน 47% คาดว่า AI จะทำให้การเข้าสู่สายงานความปลอดภัยไซเบอร์ยากขึ้น โดยเพิ่มข้อกำหนดสำหรับบทบาทระดับจูเนียร์หรือทำให้โอกาสสร้างประสบการณ์พื้นฐานลดลง ประโยคนี้ควรถูกติดไว้หน้าประตูทุก SOC เพราะมันแปลว่าเรากำลังสร้างระบบที่ช่วยคนกลุ่มหนึ่งและตัดโอกาสคนอีกกลุ่มไปพร้อมกัน
AI กำลังกระจายวันทำงานของนักวิเคราะห์ใหม่ รายงานเต็มแสดงว่าผลกระทบที่เร็วที่สุดของ AI คือการเพิ่มขีดความสามารถ นักวิเคราะห์จัดการเหตุการณ์ความปลอดภัยได้มากขึ้น 47% ระบุว่าเป็นหนึ่งในสองการเปลี่ยนแปลงหลักตั้งแต่เริ่มใช้ AI 35% บอกว่ามีเวลามากขึ้นในการสืบสวนภัยคุกคามซับซ้อน และอีก 35% มีเวลาทำงานเชิงกลยุทธ์หรือทำงานข้ามทีมมากขึ้น ขณะเดียวกัน AI ลดเวลาที่ใช้สืบสวนรูปแบบภัยคุกคามที่รู้จักลง 43% แนะนำการตอบสนอง 34% และตรวจสอบคัดกรองการแจ้งเตือนที่เข้ามา 32% แต่ 34% ของนักวิเคราะห์กลับใช้เวลามากขึ้นในการตรวจสอบหรือยืนยันสิ่งที่ AI เสนอให้
ปัญหาจึงไม่ใช่ว่า AI แย่งงาน แต่คือ AI แย่ง “สนามฝึก” ทีมความปลอดภัยรุ่นก่อนเรียนรู้จากการไล่ดู alert ทำเอกสารและตัดสินใจแก้ไขซ้ำๆ งานจูเนียร์ที่เป็นงานรูทีนคือห้องทดลองจริงให้เขาสร้างวิจารณญาณ แต่เมื่อองค์กรทำส่วนนี้เป็นอัตโนมัติ นักวิเคราะห์รุ่นใหม่จะถูกขอให้ตรวจสอบผลของระบบที่ตัวเองไม่เคยมีประสบการณ์ลึกพอจะท้าทาย 37% คาดว่าบทบาทเริ่มต้นจะต้องมีความรู้และประสบการณ์สูงขึ้น และ 10% คาดว่าโอกาสในการได้ประสบการณ์พื้นฐานจะลดลง ขณะเดียวกัน 41% คาดว่าจะมีบทบาทใหม่ที่เน้นการดูแล ตรวจสอบ และประสานงานกับ AI และมีเพียง 1% เท่านั้นที่คิดว่าเส้นทางอาชีพใน SOC จะเหมือนเดิม
นี่ไม่ใช่การว่างงานเป็นวงกว้าง เพียง 10% เท่านั้นที่คาดว่าบทบาทนักวิเคราะห์แบบดั้งเดิมจะลดลงในขณะที่บทบาทความปลอดภัยใหม่ๆ เกิดขึ้น แต่คือการเลื่อนระดับความยากของงานเริ่มต้นให้ใกล้ระดับกลางของอาชีพ ซึ่งถ้าองค์กรไม่ออกแบบระบบฝึกใหม่ เด็กจบใหม่จะถูกขอให้ “กำกับ AI” โดยไม่มีเมทริกซ์ประสบการณ์รองรับ และนั่นคือความเสี่ยง AI ในธุรกิจที่ไม่มีตัวเลขใดเตือนล่วงหน้า
ความปลอดภัยข้อมูล AI และกับดักความเชื่อมั่นระบบอัตโนมัติเกินไป
เมื่อเราปล่อยให้ AI ตัดสินใจในระบบวิกฤตอย่าง SOC ความปลอดภัยข้อมูล AI กลายเป็นประเด็นใหญ่ รายงานเดียวกันชี้ว่า 19% ของผู้ตอบมองว่าการพึ่งพา AI มากเกินไปของนักวิเคราะห์เป็นความเสี่ยงที่ใหญ่ที่สุดในการขยาย AI ในการดำเนินงานด้านความปลอดภัย ซึ่งเป็นคำตอบที่พบมากที่สุด ผลนี้สะท้อนว่าความเสี่ยงอันดับหนึ่งไม่ได้มาจากศัตรูภายนอก แต่มาจากวิธีที่คนภายในเชื่อในระบบอัตโนมัติ ส่วนความเสี่ยงต่อการเปิดเผยข้อมูลและความเป็นส่วนตัวตามมาที่ 17% และการดัดแปลงระบบ AI โดยศัตรูได้รับ 14% ผลการค้นพบสอดคล้องกับ NIST AI Risk Management Framework ที่เน้น AI ที่รับผิดชอบ โปร่งใส อธิบายได้ และทนทาน
เมื่อเทียบกับโลกการเงินจะเห็นภาพเดียวกัน ต่างกันแค่สินทรัพย์ที่เสี่ยง ในพอร์ตการลงทุนเรากลัวการขาดทุน แต่ใน SOC เราเสี่ยงข้อมูลลูกค้า โครงสร้างพื้นฐาน และชื่อเสียงองค์กร การตรวจสอบโมเดล AI จึงต้องไม่หยุดที่ precision ในการจำแนกภัยคุกคาม แต่ต้องลงลึกว่า ระบบใช้ข้อมูลใด ตัดสินใจอย่างไร และใครเป็นคนอนุมัติสุดท้าย ในทางปฏิบัติ ทีมความปลอดภัยควรแสดงหลักฐานที่อยู่เบื้องหลังคำแนะนำจาก AI ให้นักวิเคราะห์ ตรวจให้ชัดว่ากรณีไหนต้องการการอนุมัติจากมนุษย์ บันทึกการกระทำอัตโนมัติทุกครั้ง และทำให้การหยุดหรือแทนที่ระบบเป็นเรื่องง่ายในเชิงปฏิบัติการ
นั่นหมายความว่าองค์กรต้องคิดถึง “สายธารการกระทำ” ของ AI อย่างจริงจัง ว่าแต่ละคำแนะนำเกิดจากข้อมูลใด ขั้นตอนใด และคนใดรับผิดชอบ เพื่อเปิดโปงจุดบอดทั้งด้านการควบคุมและการตัดสินใจ การตรวจสอบโมเดล AI ที่ดีจึงไม่ได้วัดแต่ผลลัพธ์สุดท้าย แต่ต้องเห็นตั้งแต่ input จนถึง action และปลายทางเชิงเศรษฐกิจหรือความปลอดภัย ถ้าเราไม่รู้ว่า AI ทำอะไรกับข้อมูล เราก็ไม่รู้เลยว่ากำลังเสี่ยงมากแค่ไหน
จากตัวเลขสวยสู่การกำกับ AI ที่รับผิดชอบ: บทเรียนสำหรับผู้บริหาร
บทเรียนใหญ่จากสองโลกที่ต่างกันคือ การมอง AI ผ่านตัวเลขสั้นๆ ทำให้ผู้บริหารประเมินความเสี่ยง AI ในธุรกิจต่ำเกินจริง ทั้งในรูปของเงิน ชื่อเสียง และทุนมนุษย์ ทางฝั่งการเงิน วิธีคิดแบบ validation chain แสดงให้เห็นว่าต้องตรวจตั้งแต่สัญญาณทำนาย คุณภาพการตัดสินใจ คุณค่าทางเศรษฐกิจ ความน่าเชื่อถือเชิงประวัติศาสตร์ การทำซ้ำได้ ไปจนถึงหลักฐานอิสระ ขณะที่ฝั่งความปลอดภัยไซเบอร์เตือนว่า หากองค์กรไม่สร้างพื้นที่ฝึกใหม่แทนงานรูทีนที่ถูกอัตโนมัติ เส้นทางอาชีพจะบิดเบี้ยวและทำให้ขาดแคลนคนที่มีวิจารณญาณในระยะยาว
สิ่งที่ควรทำต่อไปจึงไม่ใช่ชะลอ AI แต่คือการยกระดับการกำกับ AI รายงานด้าน SOC แนะนำว่าผู้บริหารไม่ควรรอให้เกิดการขาดแคลนนักวิเคราะห์ที่มีประสบการณ์ค่อยรู้ว่างานระดับเริ่มต้นถูกทำให้เป็นอัตโนมัติมากเกินไป องค์กรสามารถรักษาการพัฒนาในขณะที่ยังได้ประโยชน์จาก AI โดยสร้างห้องปฏิบัติการสืบสวนที่มีโครงสร้าง บังคับให้นักวิเคราะห์ตรวจสอบหลักฐานเบื้องหลังข้อสรุปอัตโนมัติ หมุนเวียนพนักงานระดับจูเนียร์ผ่านเคสซับซ้อน และวัดความก้าวหน้าทักษะแยกจากปริมาณงานและความพึงพอใจ
สุดท้าย SOC ที่ประสบความสำเร็จที่สุดน่าจะเป็นองค์กรที่มองการกำกับดูแล AI เป็น “ระเบียบวิธีที่ต้องเรียนรู้” ไม่ใช่ความสามารถพื้นฐานของมนุษย์ที่มีอยู่แล้ว ข้อคิดเดียวกันใช้ได้กับทุกธุรกิจที่เริ่มพึ่งพา AI มากขึ้น การตรวจสอบโมเดล AI ต้องกลายเป็นวินัยกลางขององค์กร ไม่ใช่งานเฉพาะของทีมเทคนิค หากผู้บริหารไม่ถามว่าตัวเลขความแม่นยำ Machine Learning แปลว่าอะไรในโลกจริง ตัวเลขเหล่านั้นจะกลับมาทวงหนี้ในรูปของความเสียหายทางเศรษฐกิจ ช่องโหว่ความปลอดภัย และคนรุ่นใหม่ที่ไม่มีพื้นที่เติบโต