
นิยามใหม่ของเศรษฐศาสตร์ AI ข้อมูลจัดเก็บ
เศรษฐศาสตร์การจัดเก็บข้อมูลสำหรับโครงสร้างพื้นฐาน AI คือกรอบคิดที่ผสานความจุจัดเก็บเพิ่มขึ้น ประสิทธิภาพการเข้าถึง และต้นทุนจัดเก็บข้อมูลตลอดวงจรการใช้งาน เข้ามาอยู่ในสมการเดียวกัน เพื่อรองรับทั้งการวิเคราะห์แบบเรียลไทม์และการนำข้อมูลประวัติกลับมาใช้งาน การตัดสินใจโครงสร้างพื้นฐาน AI ในยุคนี้จึงไม่ใช่แค่การเลือกสตอเรจที่เร็วที่สุด แต่ต้องออกแบบว่าข้อมูลแต่ละชุดควรอยู่บนชั้นความเร็วใด นานแค่ไหน และเรียกคืนได้เร็วเพียงใด เพื่อให้ตอบโจทย์ธุรกิจมากกว่าตอบโจทย์ฝ่ายไอที ประเด็นที่องค์กรมองข้ามไม่ได้อีกต่อไปคือ AI ไม่ได้ใช้ข้อมูลแค่ตอนเทรนโมเดล แต่สร้างข้อมูลใหม่กลับเข้าสู่ระบบทั้ง Synthetic Data Log ของโมเดล และผลลัพธ์ Inference อย่างต่อเนื่อง เมื่อวงจรข้อมูลขยายไม่หยุด คำถามสำคัญจึงกลายเป็น เราจะจัดเก็บอย่างไรให้คุ้ม ไม่ใช่จะจัดเก็บได้หรือไม่
การเติบโตแบบทวีคูณของข้อมูล AI และผลต่อการเก็บระยะยาว
การเติบโตของข้อมูลจากงาน AI กำลังเขย่ากติกาการจัดเก็บแบบเดิมอย่างชัดเจน รายงานดัชนี AI ระบุว่าขนาดชุดข้อมูลที่ใช้เทรน LLM เพิ่มเป็นสองเท่าทุกแปดเดือน ขณะที่ผลสำรวจของ IDC ที่สนับสนุนโดยผู้ผลิตดิสกระดับโลก พบว่า 94.7% ขององค์กรมีการจัดเก็บข้อมูลเพิ่มขึ้นในรอบ 12 เดือนที่ผ่านมา จากการใช้ AI และ Generative AI โดย 61% เห็นปริมาณข้อมูลโต 25% หรือมากกว่าในปีเดียว และ 74% คาดว่าการเติบโตระดับนี้จะดำเนินต่อไปอย่างน้อยอีกสามปี ตัวเลขเหล่านี้บอกตรงๆ ว่าแนวคิดเก็บข้อมูลสั้นๆ แล้วลบทิ้งใช้ไม่ได้อีกแล้ว 74.3% ขององค์กรเริ่มเก็บข้อมูลนานขึ้น และ 75.9% นำข้อมูล Cold-tier กลับมาออนไลน์มากขึ้น AI ต้องการทั้งข้อมูลสดและข้อมูลเก่าเพื่อใช้เทรน ปรับปรุง และสร้างบริบทแบบ Retrieval-Augmented Generation หรือ RAG ทำให้ชั้นจัดเก็บถาวรจากที่เคยเป็นแค่คลังสำรอง กลายเป็นแหล่งเชื้อเพลิงหลักของโครงสร้างพื้นฐาน AI
โจทย์ใหม่ของโครงสร้างพื้นฐาน AI ระหว่างความจุ ความเร็ว และต้นทุน
เมื่อความจุจัดเก็บเพิ่มขึ้นแบบไม่รอใคร องค์กรถูกบังคับให้คิดใหม่เรื่องโครงสร้างพื้นฐาน AI ที่สมดุลระหว่างความจุ การเข้าถึง และต้นทุนรวมต่อเทราไบต์ จุดที่มักถูกมองข้ามคือชุดข้อมูลหนึ่งไม่จำเป็นต้องอยู่บนสตอเรจที่เร็วที่สุดตลอดเวลา แต่ต้องอยู่ในชั้นที่เหมาะกับแต่ละช่วงของ AI Pipeline ตั้งแต่การคัดกรอง การเทรน ไปจนถึงการให้บริการ Inference และ RAG คำถามที่ผู้วางแผนโครงสร้างพื้นฐานควรถามจึงไม่ใช่แค่ว่า AI ต้องใช้สตอเรจเร็วแค่ไหน แต่ต้องถามว่าข้อมูลจำนวนมหาศาลที่ยังไม่เข้าเทรนจะถูกเก็บไว้ที่ไหนให้ปลอดภัย และพร้อมถูกดึงเข้าไปใน Workflow เมื่อจำเป็นโดยไม่ทำให้บิลค่าจัดเก็บระเบิด ความคิดแบบเดิมที่เอาทุกอย่างลงดาต้าเลกบนดิสก์ความเร็วสูงตลอดเวลา กลายเป็นข้อจำกัดทางเศรษฐศาสตร์ เพราะต้นทุนจะกลายเป็นเพดานว่าองค์กรจะกล้าเก็บข้อมูลมากแค่ไหน
กลยุทธ์จัดเก็บระยะยาวและย้อนเรียกข้อมูลเป็นแต้มต่อการแข่งขัน
ในยุคที่โมเดล AI ชั้นนำเปิดให้ใช้อย่างแพร่หลาย ข้อได้เปรียบที่แท้จริงขององค์กรไม่ใช่ตัวโมเดล แต่คือข้อมูลของตัวเองที่ไม่มีใครเลียนแบบได้ หากเข้าถึงและใช้ได้ในระดับขนาดใหญ่ การรู้ว่ามีข้อมูลอะไร อยู่ที่ไหน และต้องใช้เวลากี่วินาทีในการดึงมาตอบคำถามธุรกิจ จึงกลายเป็นตัวชี้วัดความเร็วในการตัดสินใจและการลงมือทำของบริษัท ไม่ใช่งานจิปาถะของทีมไอทีอีกต่อไป รายงานชี้ชัดว่า 96% ขององค์กรคาดว่าจะต้องเรียกคืนข้อมูลจากระบบจัดเก็บถาวรได้เร็วขึ้น เพื่อรองรับ AI Inference และโซลูชันแบบ Retrieval-Augmented Generation นั่นหมายความว่ากลยุทธ์คลังข้อมูลระยะยาวและการออกแบบชั้นย้อนเรียกข้อมูล ไม่ใช่แค่เรื่อง Compliance แต่เป็นยุทธศาสตร์การแข่งขันโดยตรง ผู้ที่วางโครงสร้างพื้นฐาน AI ให้ข้อมูลพร้อมถูกย้ายขึ้นชั้นประสิทธิภาพที่เหมาะสมในทันทีที่ต้องใช้ จะเปลี่ยนคลังข้อมูลที่เคยเป็นต้นทุน ให้กลายเป็นเครื่องเร่งการเติบโตทางธุรกิจ
อนาคตโครงสร้างพื้นฐาน AI ต้องรองรับทั้งเรียลไทม์และข้อมูลประวัติ
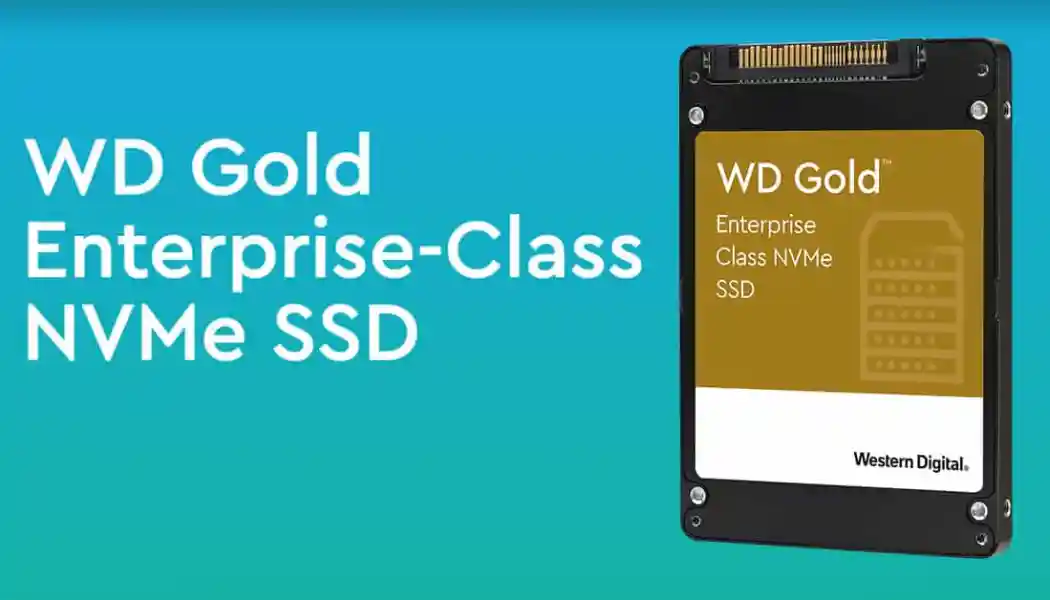
ทิศทางต่อไปของโครงสร้างพื้นฐาน AI ไม่ใช่การเลือกอย่างใดอย่างหนึ่งระหว่างความเร็วกับต้นทุน แต่ต้องออกแบบให้รองรับทั้งการวิเคราะห์แบบเรียลไทม์และการปลุกข้อมูลประวัติกลับมาทำงานพร้อมกัน ในมุมสตอเรจ นั่นแปลว่าต้องมีระบบชั้นความเร็วหลายระดับที่ให้ข้อมูลเคลื่อนย้ายระหว่างกันได้อย่างลื่นไหล ชุดข้อมูลที่อยู่ในชั้นถาวรหรือ Cold-tier ต้องพร้อมถูกดึงขึ้นมาอยู่บนชั้นที่ให้ Throughput สูงในทันทีที่ Workflow AI ต้องการ ไม่ว่าจะเป็นการเทรนแบทช์ใหญ่หรือการตอบคำถามแบบ RAG เทคโนโลยีดิสก์และเทปยุคใหม่จึงกลับมาอยู่ในสมการอย่างมีความหมาย เพราะช่วยให้ประสิทธิภาพและความจุสามารถขยายแยกจากกันได้ และทำให้ต้นทุนต่อเทราไบต์ในระดับหลายเพตะไบต์เป็นสิ่งที่องค์กร AI พอรับได้ เมื่อข้อมูลคือเชื้อเพลิงของการตัดสินใจและโมเดล การลงทุนให้ข้อมูลทั้งหมดอยู่ในสภาพพร้อมใช้งาน ในชั้นที่เหมาะสมกับภาระงาน คือทางเลือกเดียวที่จะทำให้องค์กรไม่ถูกจำกัดด้วยบิลค่าจัดเก็บ แต่ใช้คลังข้อมูลเป็นคันเร่งในการทิ้งคู่แข่ง