
ทำไมค่า Accuracy หลอกเรา และนิยามใหม่ของการตรวจสอบโมเดล ML
การตรวจสอบโมเดล ML คือการประเมินคุณภาพระบบ AI ตั้งแต่คุณภาพข้อมูล พฤติกรรมโมเดล ไปจนถึงผลลัพธ์ทางธุรกิจและความเสถียรระยะยาว โดยไม่ยึดติดกับคะแนนเดียว เช่น accuracy หรือ AUC แต่ดูว่าโมเดลแปลงการพยากรณ์ไปเป็นการตัดสินใจและผลลัพธ์ในโลกจริงอย่างสอดคล้อง มีหลักฐานที่ทำซ้ำได้ ปราศจาก data leakage และตรวจสอบได้ตลอดอายุการใช้งานในระบบ production ML validation โมเดลที่แม่นยำบนกราฟหรือสไลด์สามารถไร้ประโยชน์ในเชิงเศรษฐกิจได้ การซื้อขายอัตโนมัติที่ทำนายทิศทางตลาดถูกแต่ได้กำไรจากจังหวะเล็กน้อย กลับแพ้ให้กับไม่กี่ครั้งที่ผิดแล้วเสียหายมาก ผลลัพธ์คือโมเดลมีคะแนนดีแต่ตัดสินใจแย่ ไม่สร้างมูลค่าทางเศรษฐกิจเลย การตรวจสอบโมเดล ML ที่ยึดแค่ accuracy และ backtest จึงเป็นภาพลวงตา เราต้องถามเพิ่มเสมอว่า โมเดลนี้มีมูลค่าทางเศรษฐกิจจริงหรือไม่ และหลักฐานที่ใช้ยืนยันนั้นแน่นพอหรือยัง
จากคะแนนพยากรณ์สู่ผลลัพธ์เศรษฐกิจ และกับดักของ backtest
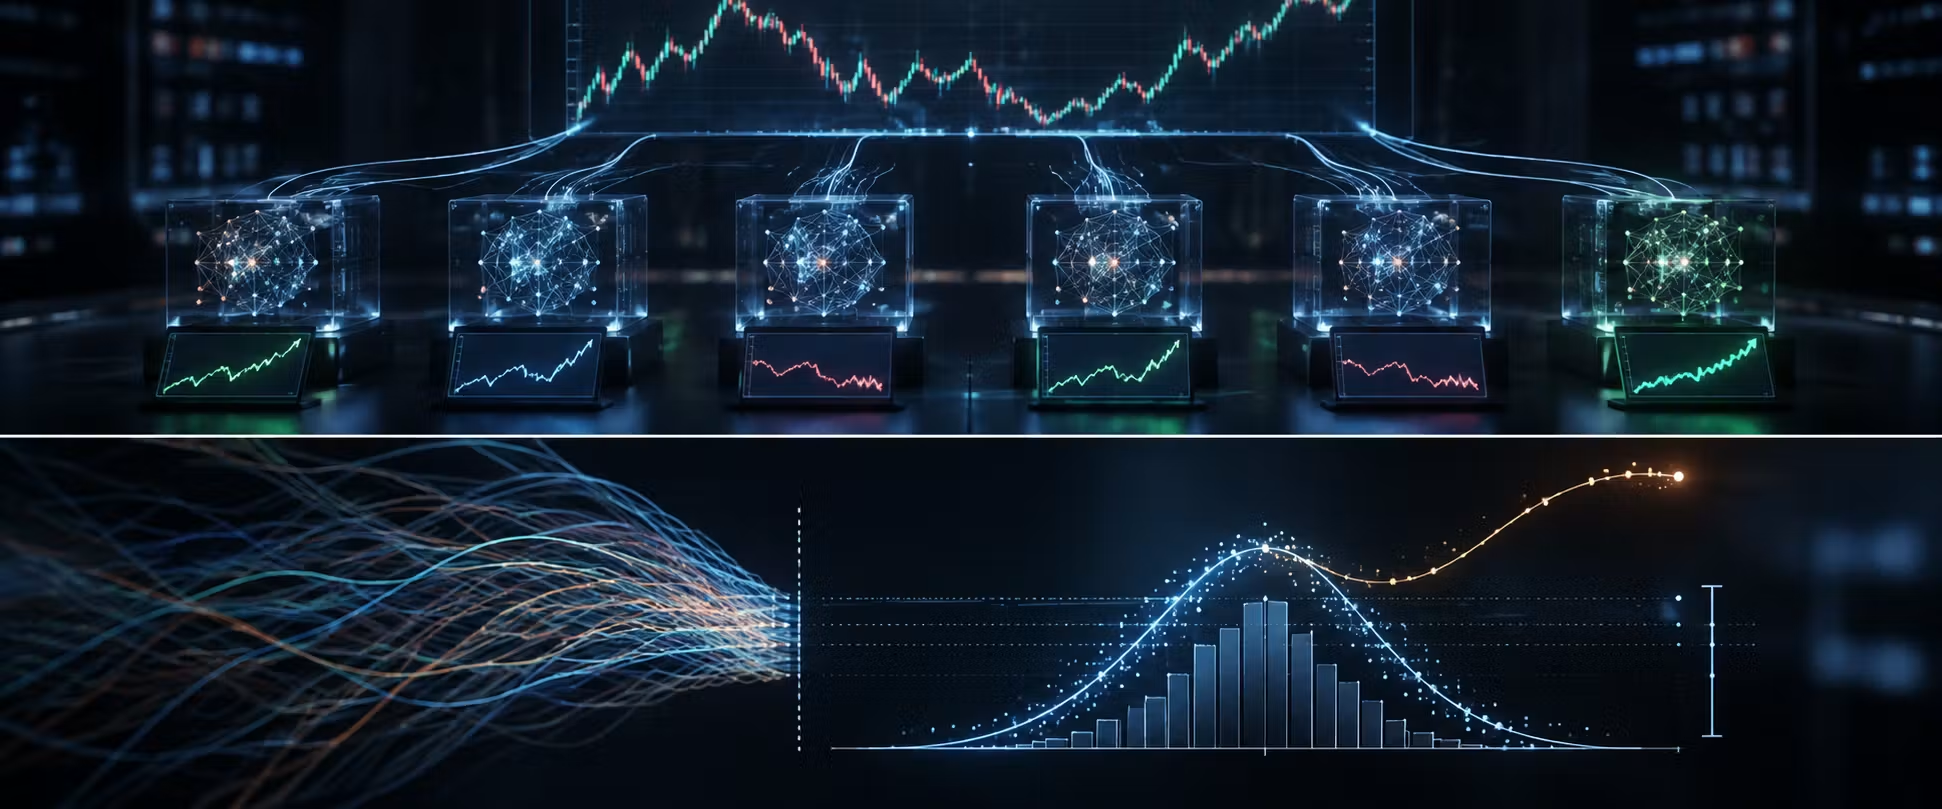
หัวใจของการทดสอบ machine learning ในงานการเงินและอุตสาหกรรม คือการเดินครบสามช่วงจาก prediction → decision → economic outcome โซ่คุณค่านี้เปิดโปงว่าโมเดลสองตัวที่มี error ใกล้กันมาก สามารถตัดสินใจพอร์ตได้ต่างกันอย่างรุนแรงถึงเกือบสามเท่า ซึ่งหมายความว่าการเปรียบเทียบด้วยคะแนนเดียวซ่อนความแตกต่างสำคัญของฟังก์ชันที่โมเดลเรียนรู้ backtest ก็เป็นอีกกับดักที่หลายทีมหลงเชื่อ “กราฟสวย” แต่ลืมตรวจสอบกระบวนการสร้างหลักฐาน งานวิจัยชี้ชัดว่า backtest ที่ดีไม่เท่ากับหลักฐานที่แข็งแรง เพราะคุณภาพของหลักฐานขึ้นกับวิธีการสร้าง ตั้งแต่การสุ่ม การแบ่งชุดข้อมูล ไปจนถึงขั้นตอน preprocessing ที่ร้ายแรงที่สุดคือ data leakage โมเดลเผลอได้รับข้อมูลที่ในเวลาจริงไม่มีอยู่ เช่นการใช้ฟีเจอร์ที่ช่วยทำนายด้วยข้อมูลอนาคต ทำให้ backtest ดูสมเหตุสมผล แต่โมเดลใช้สัญญาณที่ไม่เคยมีวันใช้ได้จริงใน production
มุมมองของวิศวกรรมคุณภาพต่อคุณภาพระบบ AI แบบสามชั้น
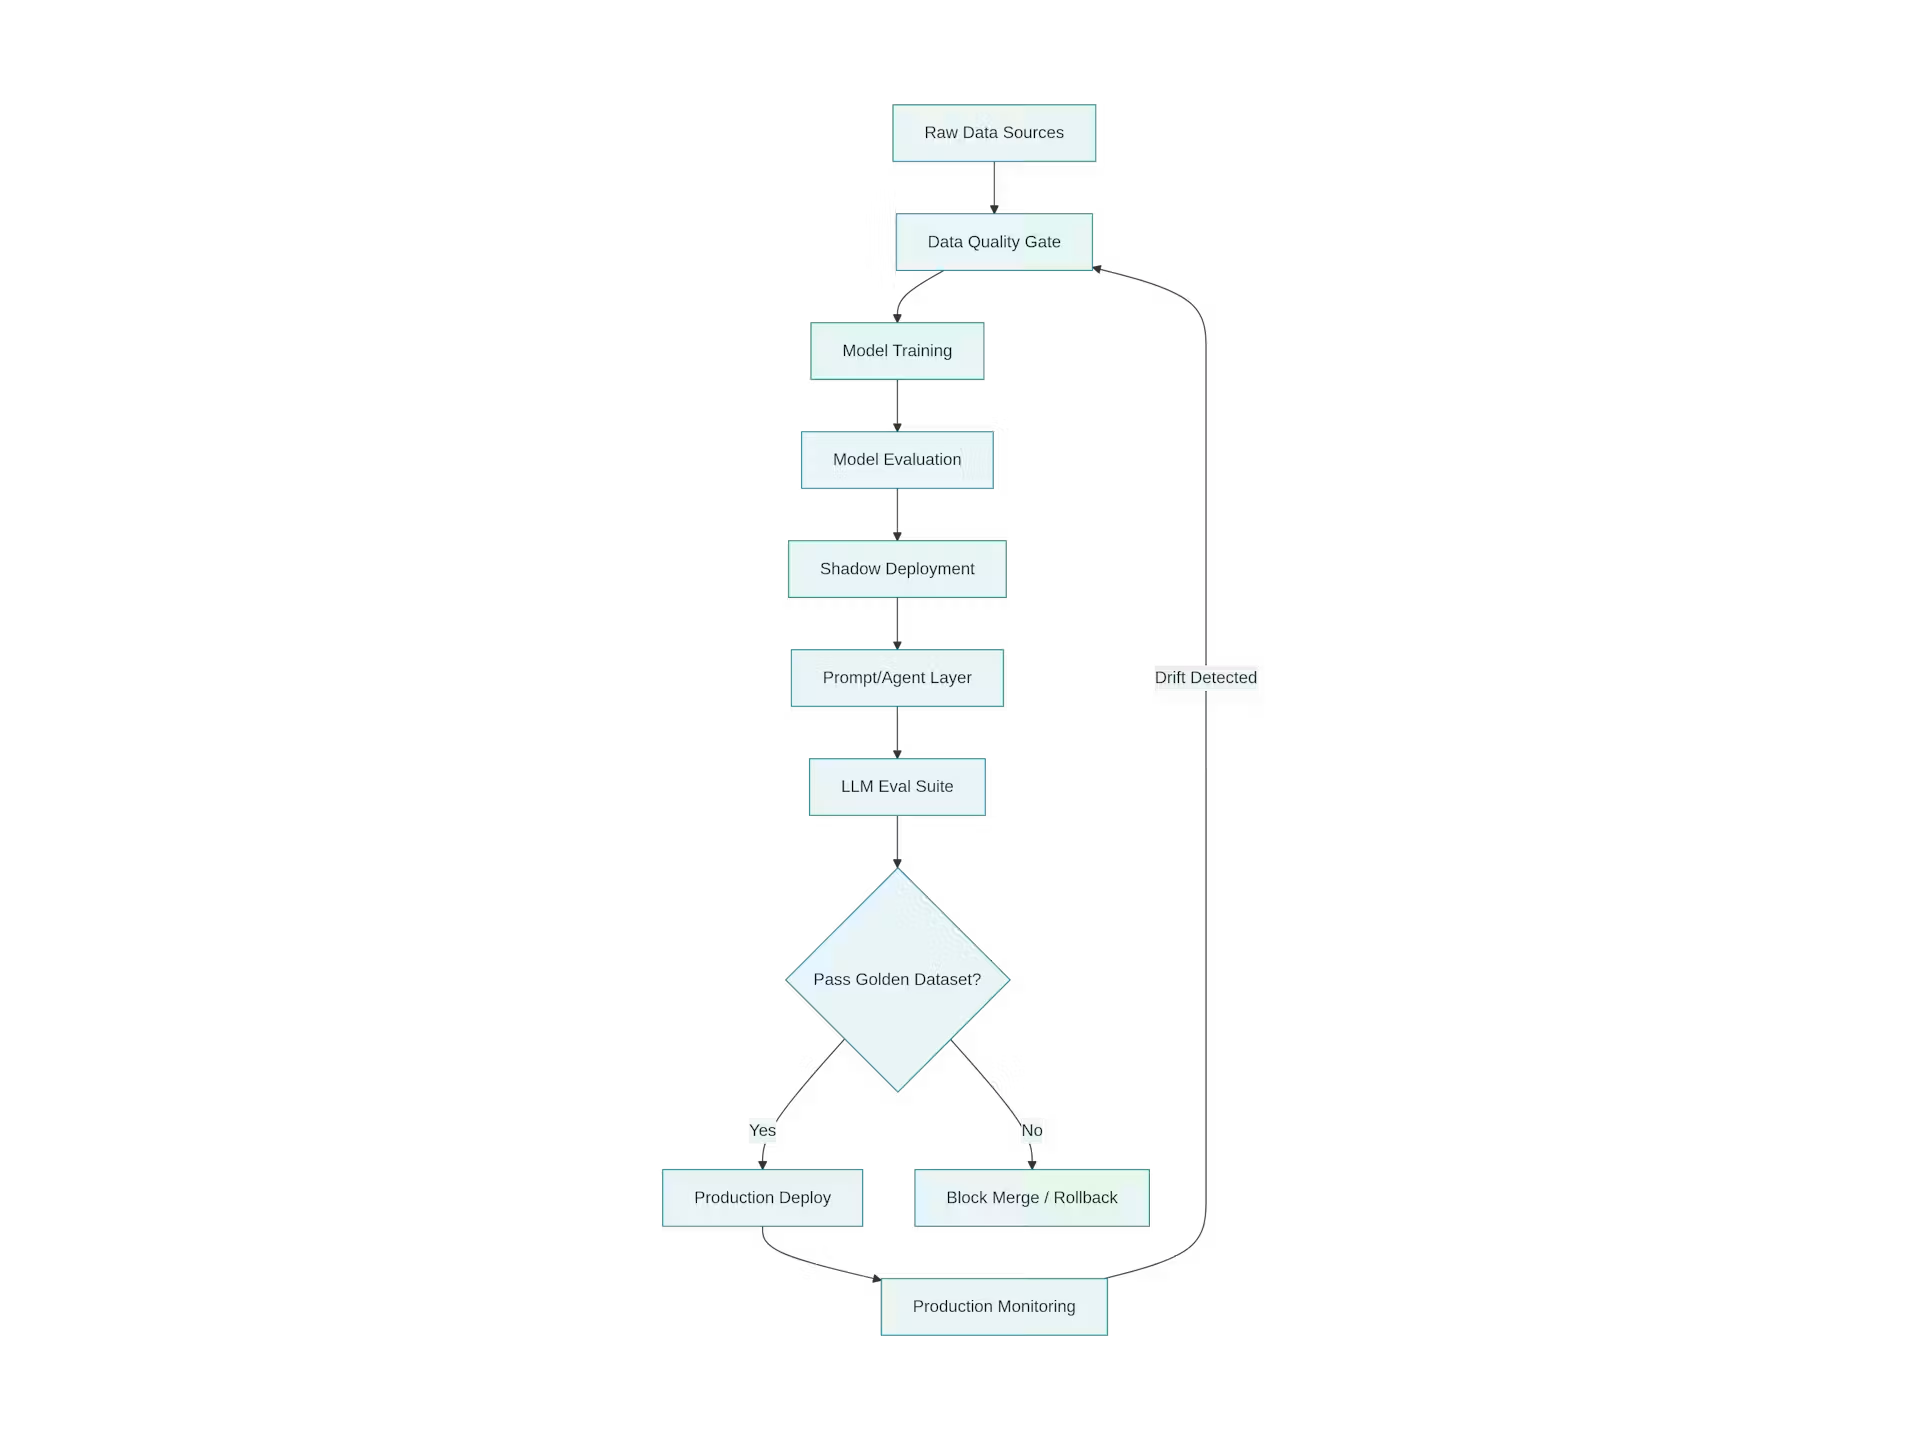
โลกคุณภาพระบบ AI ไม่ใช่การต่อยอด QA แบบเก่า แต่เป็นศาสตร์ใหม่ที่ผสม data engineering สถิติ และ ML operations เข้าด้วยกัน เพื่อสร้างความเชื่อมั่นก่อนปล่อยระบบไปตัดสินใจแทนคน ทีมคุณภาพต้องยอมรับว่าโมเดลมีความไม่แน่นอนตามธรรมชาติ ผลลัพธ์ไม่ใช่ค่าถูกผิดเดียว แต่เป็นคุณสมบัติทางสถิติผ่านการกระจายของเคสใช้งาน กรอบคิดที่ทรงพลังคือการแบ่งคุณภาพระบบ AI เป็นสามชั้นเชื่อมต่อกัน ได้แก่ ชั้นข้อมูล ชั้นโมเดล และชั้น prompt หรือ agent ที่ครอบคลุมแอปพลิเคชัน LLM ชั้นข้อมูลตอบคำถามว่าเรากำลังเทรนโมเดลบนอะไร มี bias หรือ data drift หรือไม่ ชั้นโมเดลดูการตรวจสอบโมเดล ML เช่น accuracy ความเสถียร ความเป็นธรรม และการทำงานข้ามสถานการณ์ ส่วนชั้น prompt/agent ตรวจสอบว่าระบบที่ใช้โมเดลให้ผลลัพธ์ที่ปลอดภัย น่าเชื่อถือ และสอดคล้องกับบริบทการใช้งาน การออกแบบคุณภาพระบบ AI ที่ดีต้องให้สามชั้นนี้ทำงานเป็นวงจรเดียวกัน ไม่ใช่เป็นด่านแยกส่วน
เครื่องมือในมือ QE: จาก data validation สู่การทดสอบความเสถียรโมเดลและ regression suites
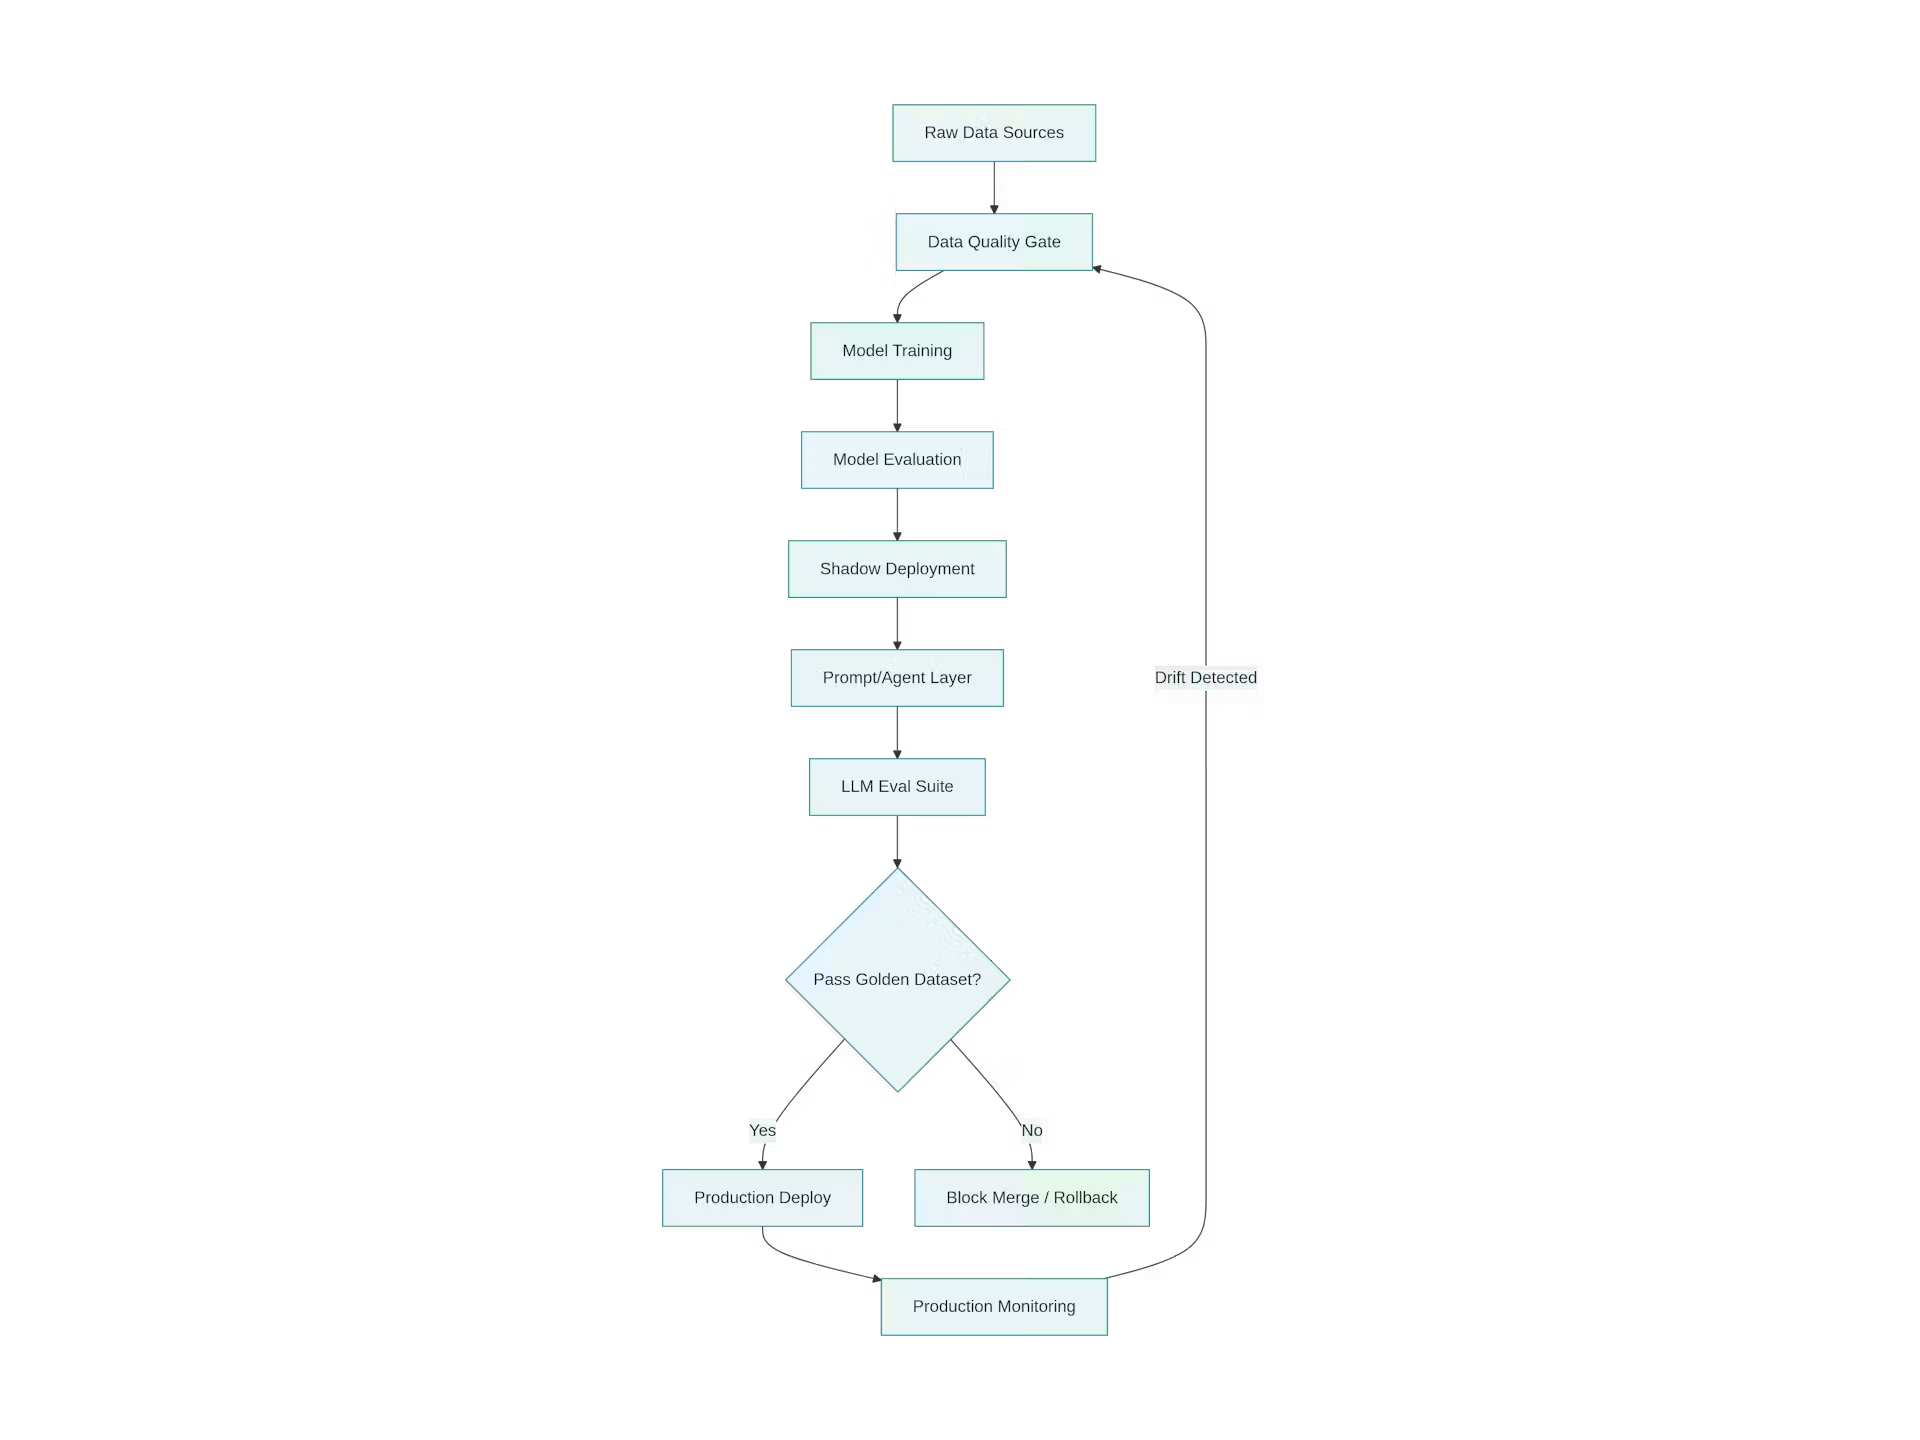
ถ้าตามรอยความล้มเหลวของ AI ไปจนถึงต้นตอ มักจบลงที่ปัญหาข้อมูล ทีมวิศวกรรมคุณภาพจึงเริ่มรับผิดชอบ data validation อย่างจริงจัง ใช้เฟรมเวิร์กความคาดหวังในการนิยามข้อกำหนดเชิงประกาศ เช่น schema อัตรา null ช่วงค่าที่รับได้ และลักษณะการกระจาย ที่ข้อมูลต้องผ่านก่อนจะถูกส่งต่อไปเทรนโมเดล นี่ทำให้แนวคิด garbage in garbage out ถูกจัดการตั้งแต่ต้นน้ำ ไม่ปล่อยให้ปัญหาข้อมูลไประเบิดใน production ML validation ชั้นโมเดลเองก็ต้องคิดเกินกว่า accuracy number QA ของโมเดลซ้อนทับกับงานของ data scientist เช่น train/validation split การทำ k-fold cross-validation เพื่อตรวจจับ overfitting การใช้ holdout บนข้อมูลที่ไม่เคยเห็น รวมถึง A/B test เทียบกับ baseline ใน production ทีมคุณภาพยังเพิ่ม shadow deployment เพื่อวิ่งโมเดลใหม่คู่กับตัวจริงบนทราฟฟิกจริงโดยไม่กระทบผู้ใช้ ตรวจสอบ performance ก่อนสลับโมเดล และใช้ perturbation testing ใส่ noise หรือข้อมูลหายบางส่วน เพื่อดูว่าผลลัพธ์ยังเปลี่ยนในกรอบที่สมเหตุสมผลหรือไม่ ทั้งหมดนี้ถูกแพ็กเป็น regression suites รันซ้ำเพื่อจับการเสื่อมและการเปลี่ยนพฤติกรรมโมเดลเมื่อรีเทรน
Production ML validation เป็นวงจรไม่จบ และบทสรุปสำหรับระบบการเงินและอุตสาหกรรม
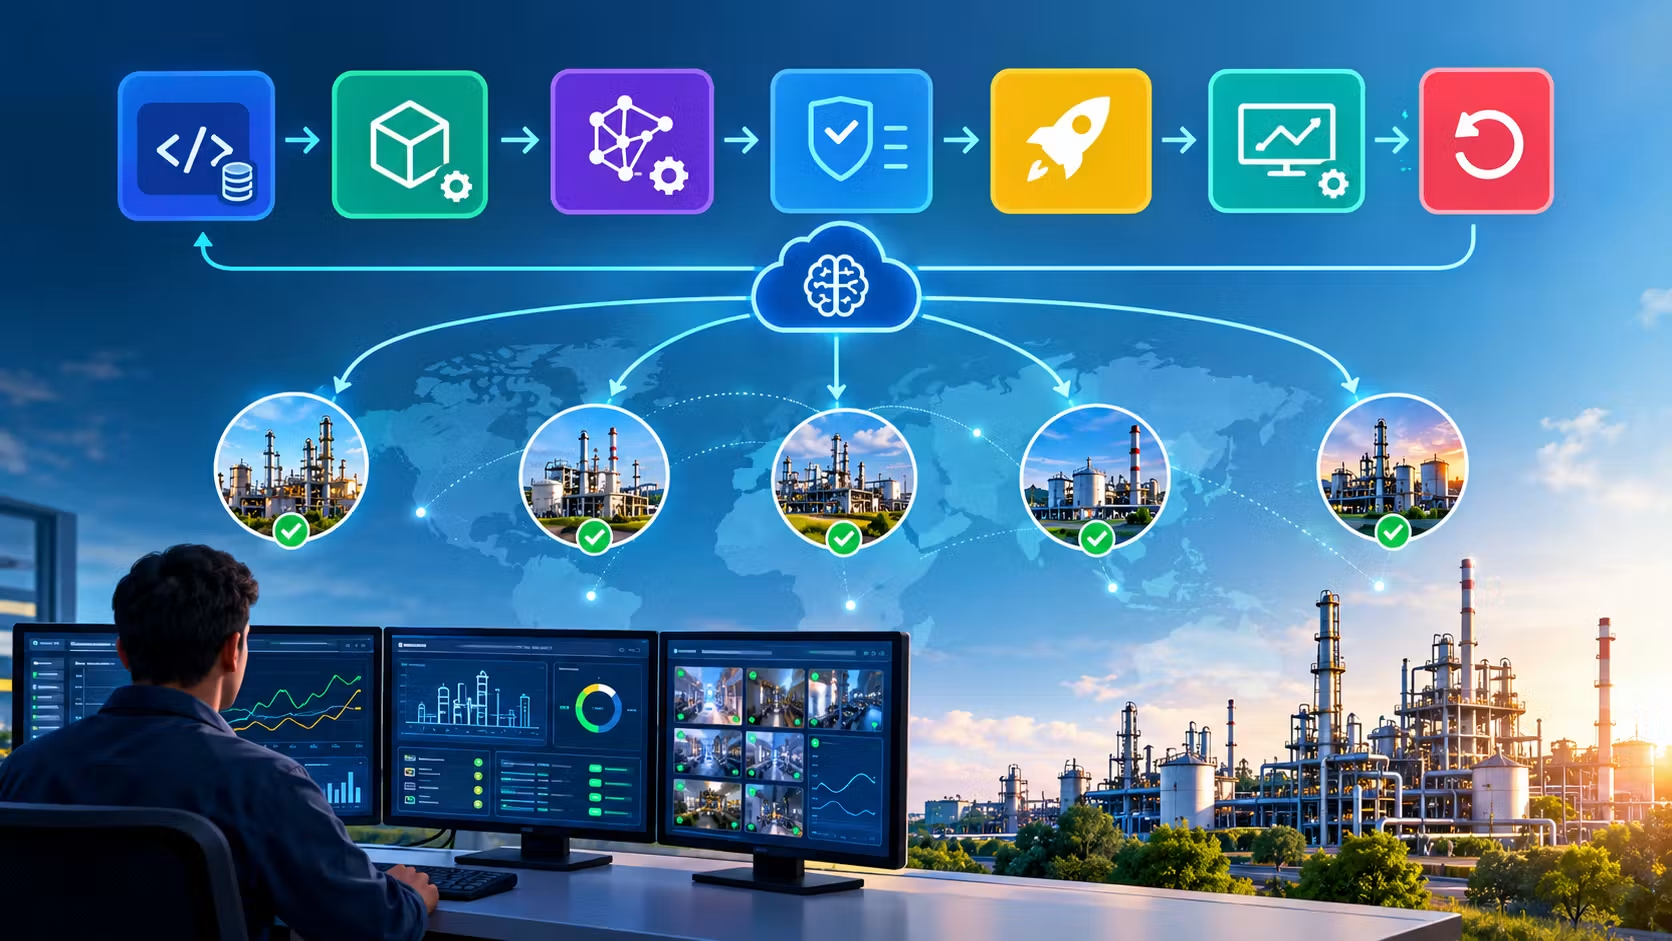
สำหรับระบบ AI ในโลกจริง production ML validation ต้องคิดเป็นวงจรคุณภาพปลายเปิด ไม่ใช่เส้นตรงจากเทรนแล้วปล่อยใช้งาน เมื่อระบบเริ่มเจอ data drift หรือ concept drift ใน production สัญญาณเหล่านี้ควรย้อนกลับไปเปิดด่าน data validation ใหม่ พร้อมทั้ง retrain และ re-evaluate จากต้นทาง ไม่ใช่รอรอบปล่อยเวอร์ชันครั้งต่อไป ในงานการเงินและอุตสาหกรรม ความคาดหวังยิ่งสูงกว่า โมเดลต้องรอดทั้งด้านมูลค่าทางเศรษฐกิจและด้านความเชื่อถือของหลักฐาน validation ไม่ใช่แค่ผ่าน accuracy หรือเห็นกราฟกำไรจาก backtest สวยงาม การตรวจสอบต้องคำนึงถึง process-aware testing ตั้งแต่การป้องกัน leakage ในทุกขั้นของ pipeline ไปจนถึงการรันโมเดลหลายครั้งเพื่อดู distribution ของผลลัพธ์ แทนที่จะเชื่อคะแนนเดียว เมื่อทีมยอมรับว่าการตรวจสอบโมเดล ML เป็น “โซ่ของ validation” ไม่ใช่ “ตัวเลขเดียว” ก็พร้อมสร้างคุณภาพระบบ AI ที่ทำงานในโลกจริง สร้างมูลค่าทางเศรษฐกิจ และไม่ทรยศความเชื่อใจของผู้ใช้