
AI voice consistency คืออะไร และทำไมครีเอเตอร์ต้องแคร์
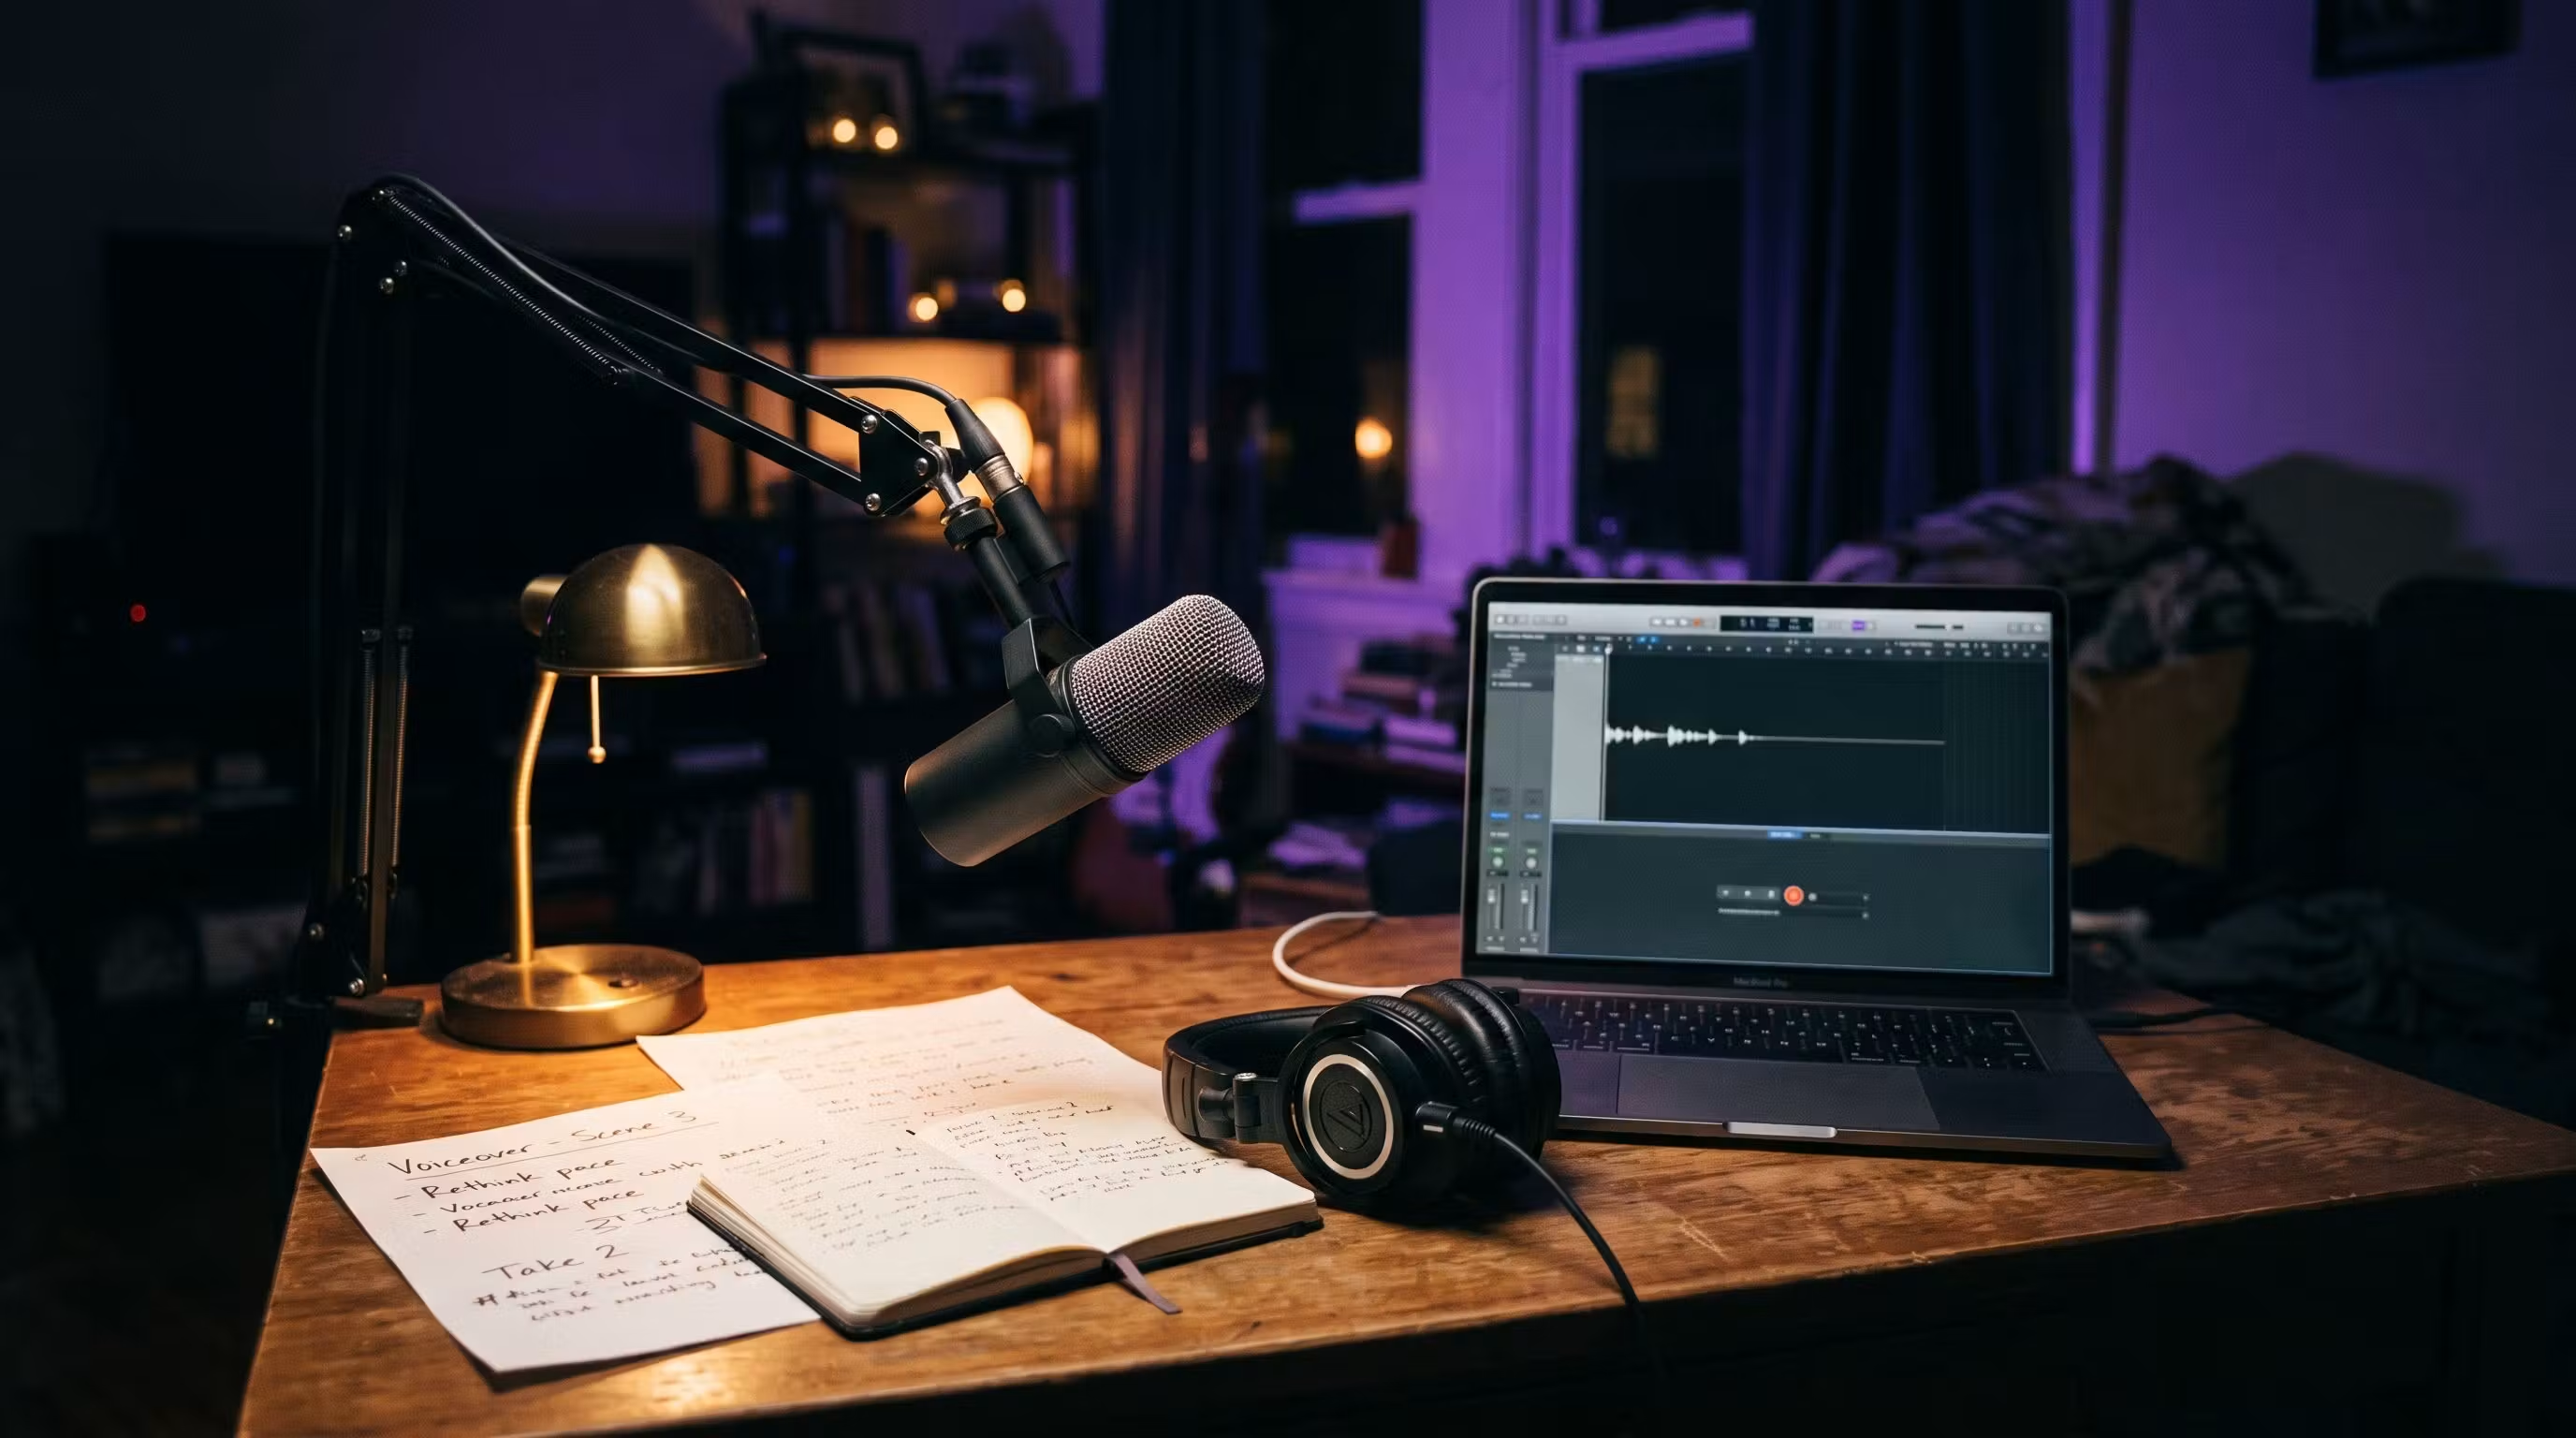
AI voice consistency คือการทำให้เสียงที่สร้างด้วย AI คงบุคลิก โทน อารมณ์ และจังหวะการพูดแบบเดียวกันทุกคลิป ทุกซีน และทุกภาษา เพื่อให้ผู้ชมรู้สึกว่าเป็นตัวละครคนเดิม ไม่ใช่คนพากย์คนใหม่แฝงตัวมาในแต่ละช็อต การดูแลให้เสียงนิ่งจึงสำคัญต่อแบรนด์ ช่องยูทูบ และโปรเจกต์วิดีโอที่ใช้งานซ้ำระยะยาว โดยเฉพาะเมื่อคุณใช้ video voice generation หลายสิบคลิปจากหลายวันถ่ายทำ
โลกของ AI character voice มีข้อจำกัดใหญ่ข้อหนึ่งคือ เครื่องมือเสียงส่วนมากจะตีความข้อความและตั้งค่าทุกครั้งแบบไม่จำทุกคลิปก่อนหน้า ทำให้โทนเสียง เพซ และอารมณ์อาจเปลี่ยนไปเอง ไม่มีอะไรมาบังคับให้เกิดความต่อเนื่องโดยอัตโนมัติ ดังนั้นถ้าคุณสร้างเสียงแยกคลิปกันไปเรื่อยๆ มีโอกาสสูงที่เสียงตัวละครจะเริ่มสวิงจนเหมือนเปลี่ยนคนพากย์กลางเรื่อง ผู้ชมที่ฟังผ่านหูฟังจะจับได้เร็วมาก โดยเฉพาะหนังสั้น แอนิเมชัน หรือคอนเทนต์ที่ใช้ตัวละครเดิมซ้ำ
ในบทความนี้เราจะเดินไปทีละขั้นตั้งแต่เตรียมไฟล์เสียงสำหรับ AI dubbing workflow ไปจนถึงการล็อกเวิร์กโฟลว์เสียงของแต่ละตัวละคร เพื่อให้คุณทำวิดีโอหลายคลิป หลายภาษา โดยรักษาคาแรกเตอร์เสียงเดิมไว้ได้โดยไม่ต้องอัดเสียงใหม่ทุกครั้ง และไม่ต้องมานั่งรีเจนเสียงยกแทร็กในห้องตัดต่อ
เตรียมโปรเจกต์ให้พร้อม ก่อนแตะปุ่มสร้างเสียง AI
หัวใจของ AI dubbing workflow ที่ดีคือการเตรียมต้นทาง ก่อนส่งอะไรเข้าเครื่อง คุณต้องแน่ใจก่อนว่าภาพ เสียง และสคริปต์นิ่งพอ เพราะการย้อนกลับมาปรับหลังดั๊บหลายภาษาแล้วคือฝันร้าย การอัปโหลดร่างตัดต่อแล้วหวังให้เครื่องมือจัดการทุกอย่างเองมักจบลงด้วยการต้องทำใหม่เกือบหมด
- เตรียมไฟล์ dialogue ให้สะอาด แยกเสียงพูดออกจากดนตรีและเอฟเฟกต์เสียง เพราะการมีทุกอย่างปนในแทร็กเดียวทำให้การถอดคำและแปลแย่ลงไม่ว่าคุณใช้เครื่องมือไหน
- ล็อกสคริปต์ให้แน่น แก้ชื่อเฉพาะ ชื่อแบรนด์ และสแลงให้เรียบร้อยก่อนแปล เพราะระบบถอดคำอัตโนมัติมักอ่านชื่อ固有ผิดและมีผลต่อทุกภาษา
- เลือกภาษาเป้าหมายแค่หนึ่งภาษาสำหรับรอบแรก อย่ารีบดั๊บทีเดียวห้าภาษา เพราะถ้าเจอปัญหาโทนเสียงหรือไทม์มิ่งทีหลัง คุณจะต้องแก้ซ้ำทุกภาษา
- ตัดสินใจเรื่อง lip-sync ล่วงหน้าว่าจะยอมรับปากไม่ตรงเสียง เลือกช็อตที่ไม่เห็นปาก หรือจะลงทุนกับเครื่องมือลิพซิงค์ การไม่ตัดสินใจคือความผิดพลาดที่พบได้บ่อยที่สุด
จุดที่หลายคนพลาดคือรีบแปล รีบดั๊บทั้งเรื่องก่อนตรวจทีละส่วน โดยไม่เคยลองทดสอบสักคลิปสั้นๆ สิ่งที่ควรทำคือดั๊บคลิปทดสอบยาวประมาณ 20–30 วินาทีในภาษาเป้าหมายแรก จากนั้นฟังดูว่าเสียงยังเป็นคาแรกเตอร์เดิมหรือไม่ ไม่ใช่ฟังแต่ความถูกต้องของคำแปล แล้วค่อยปรับค่าการโคลนเสียงหนึ่งครั้ง ทดสอบซ้ำ ก่อนคอมมิตทั้งเรื่อง

ขั้นตอนล็อกเสียง AI ให้คาแรกเตอร์นิ่งทุกคลิป
ปัญหาใหญ่ของ video voice generation คือทุกคลิปที่คุณกดเรนเดอร์คือการสุ่มใหม่จากโมเดลที่ไม่รู้ว่าคลิปก่อนหน้าเกิดอะไรขึ้น ทั้งภาพและเสียงจึงไม่ต่อเนื่องด้วยตัวเอง ทางออกคือเปลี่ยนจากการสร้างเสียงทีละคลิปไปเป็นเวิร์กโฟลว์แบบล็อกเสียง หรือ locked-voice workflow ที่ผูกทุกบรรทัดของตัวละครเข้ากับแหล่งอ้างอิงและคอนฟิกเดียวกันตั้งแต่ต้นจนจบโปรเจกต์
- เลือกระบบและล็อก voice reference เดียวต่อหนึ่งตัวละคร ใช้ตัวอย่างเสียงที่สะอาดเพียงคลิปเดียวหรือ voice ID เดียวสำหรับทุกประโยคที่ตัวละครนั้นพูด ห้ามสลับต้นทางกลางโปรเจกต์
- ตั้งค่า configuration ครั้งเดียวแล้วบันทึก ทั้งค่าความเสถียร จังหวะการพูด และแท็กต่างๆ ให้เรียกใช้ซ้ำได้ ไม่ต้องพิมพ์จำใหม่เองในแต่ละคลิป และจดโน้ตสั้นๆ ไว้ในเอกสารวางแผนช็อตคู่กับข้อมูลกล้องและแสง
- แยก voice model ต่อหนึ่งตัวละคร อย่าเอาโมเดลเสียงเดียวกันไปใช้กับตัวละครคนที่สองแม้จะเห็นว่าใกล้เคียง เพราะสุดท้ายผู้ชมจะได้ยินว่าเป็นคนเดียวกันเปลี่ยนบท
- ป้อน context มากกว่าข้อความเปล่า ระบุว่าใครกำลังพูด คุยกับใคร และอารมณ์ไหน เพื่อให้ประโยคเดียวกันส่งอารมณ์ในคาแรกเตอร์เดียวกัน แม้ใช้ voice ID เดิม
- แบตช์ทำงานตามตัวละคร ไม่ใช่ตามซีน สร้างเสียงทุกบรรทัดของตัวละครเดียวให้เสร็จในครั้งเดียวด้วยเซ็ตติ้งเดิม เพื่อจับอาการเสียงสวิงได้ระหว่างทำ แทนที่จะมารู้ตอนตัดต่อสามซีนถัดไป
เวิร์กโฟลว์นี้พิสูจน์แล้วในโปรเจกต์ที่ตัวละครเอกมีบทพูดมากที่สุดในซีรีส์ กระจายอยู่ในช็อตที่สร้างห่างกันหลายสัปดาห์ บนเครื่องคนละวัน แต่เมื่อใช้ reference เดียว เซ็ตติ้งเสถียรค่าหนึ่งเป็นค่าหลัก และจดบันทึกร่วมกับการควบคุมภาพ เสียงของตัวละครยังฟังเหมือนคนเดิมทุกตอน และอัตราการต้องรีเจนเสียงลดลงกว่าครึ่ง
เช็กลิสต์กันพลาด ก่อนขยายเสียงไปหลายภาษาและหลายฟอร์แมต
เมื่อคุณล็อกเสียงตัวละครในภาษาต้นทางได้แล้ว ขั้นต่อไปคือดูว่าเสียงนี้จะยังเป็นคนเดิมเมื่อแปลเป็นหลายภาษาไหม ตรงนี้แหละที่ผู้สร้างภาพยนตร์และคอนเทนต์จำนวนมากพลาด เพราะรีบสเกลงานโดยไม่เทสต์ AI voice consistency ให้แน่ใจก่อนว่าคาแรกเตอร์รอดจริงในแต่ละภาษา การแปลคือส่วนง่าย การรักษาการแสดงให้เหมือนตัวละครเดิมต่างหากที่ทำให้หลายโปรเจกต์ดั๊บแล้วต้องลบทิ้ง
- ทำคลิปทดสอบ 20–30 วินาทีในภาษาเป้าหมายแรกทุกครั้ง ปรับค่าความแรงการโคลนเสียงหนึ่งรอบแล้วทดสอบซ้ำ ก่อนสั่งดั๊บทั้งเรื่อง
- ดูให้ชัดว่าปัญหาคืออะไร ถ้าเสียงโอเคแต่ปากไม่ตรง คุณต้องตัดสินใจเรื่องเครื่องมือลิพซิงค์ ไม่ใช่โทษระบบเสียง
- อย่าปล่อยให้สคริปต์ภาพยังไม่ล็อกแล้วไปดั๊บ ถ้าคุณตัดต่อใหม่หลังดั๊บ คุณต้องซิงก์เสียงแปลใหม่ทุกภาษาอีกครั้ง
- ตรวจสอบข้อจำกัดไฟล์ของแต่ละเครื่องมือ เช่น ความยาวต่อไฟล์ และจำนวนวิดีโอที่จะส่งแบบแบตช์ เพื่อไม่ให้โปรเจกต์สะดุดกลางทาง
ข้อผิดพลาดที่พบบ่อยอีกอย่างคือการเปลี่ยนเครื่องมือเสียงกลางซีรีส์เพราะเห็นเดโมตัวใหม่ดูน่าสนใจ ผลลัพธ์คือไม่ใช่แค่เสียงไหลเล็กน้อย แต่กลายเป็นเสียงใหม่ที่พยายามแสดงเป็นตัวละครเดิม ซึ่งคนดูจับได้ทันที อีกชุดความผิดพลาดคือการปรับค่าความเสถียรทีละคลิปโดยไม่เคยจด เมื่อเอามาตัดต่อเรียงกันหลายคลิปจึงเกิดเสียงลอยไม่เหมือนกัน
เลือกเครื่องมือเสียงและดั๊บอย่างไร ให้ภาพกับเสียงไปด้วยกัน
เมื่อเวิร์กโฟลว์ล็อกเสียงนิ่งแล้ว คำถามต่อมาคือจะเอาเสียงนี้ไปใช้ในงานดั๊บแบบไหนบ้าง ทั้งแบบเสียงอย่างเดียวและแบบภาพปากขยับตาม สิ่งสำคัญคือตัดสินใจให้ชัดเจนว่าหนังหรือวิดีโอของคุณให้ความสำคัญกับปากตัวละครแค่ไหน ถ้าเป็นช็อตพูดใกล้ๆ ปากคือทุกอย่าง การใช้เครื่องมือที่ไม่ขยับปากใหม่เลยอาจทำให้ช็อตดูผิดทันที
มีบริการที่เน้นโคลนเสียงและแปลโดยตรง ซึ่งจะแทนที่แทร็กเสียงด้วยภาษาใหม่ แต่ไม่เรนเดอร์ปากซ้ำ ปากในภาพจะยังขยับตามภาษาเดิมอยู่จึงเหมาะกับช็อตมุมกว้างหรือช็อตที่ไม่เห็นปากชัด ในหลายกรณีคุณภาพเสียงแบบนี้ไม่ต่างจากตัวเลือกที่แพงกว่ามาก แต่มีต้นทุนด้านภาพที่ต่ำกว่า ส่วนผู้ให้บริการที่รวมการรีแอนิเมตปากไว้ในระบบจะแก้ปัญหาปากไม่ตรงได้ตรงจุด เหมาะกับคอนเทนต์ที่เป็น talking head เต็มจอ
หัวใจคือการใช้หลักล็อกเสียงเดิมเสมอ ไม่ว่าคุณจะใช้เครื่องมือเสียงตัวไหน และจำไว้ว่า AI voice tools ส่วนใหญ่ไม่มีความทรงจำข้ามคลิป ทุกครั้งที่คุณกดสร้างคือการสุ่มใหม่ทั้งหมด การทรีตเสียงตัวละครเหมือนใบหน้าของตัวละคร คือล็อกครั้งเดียว ใช้ซ้ำอย่างมีวินัย และจดบันทึกไว้ในที่ที่คุณเปิดดูทุกครั้งก่อนรอบเรนเดอร์ถัดไป เมื่อทำแบบนี้ ครีเอเตอร์สามารถสร้างคลิปหลายสิบคลิปด้วยคาแรกเตอร์เสียงเดียวกันโดยไม่ต้องนั่งอัดเสียงใหม่ และยังลดเวลาแก้ไขในห้องตัดต่อได้มาก