
การแยกข้อมูลเอกสาร AI คืออะไร และเหตุใด OCR อย่างเดียวจึงไม่พอ
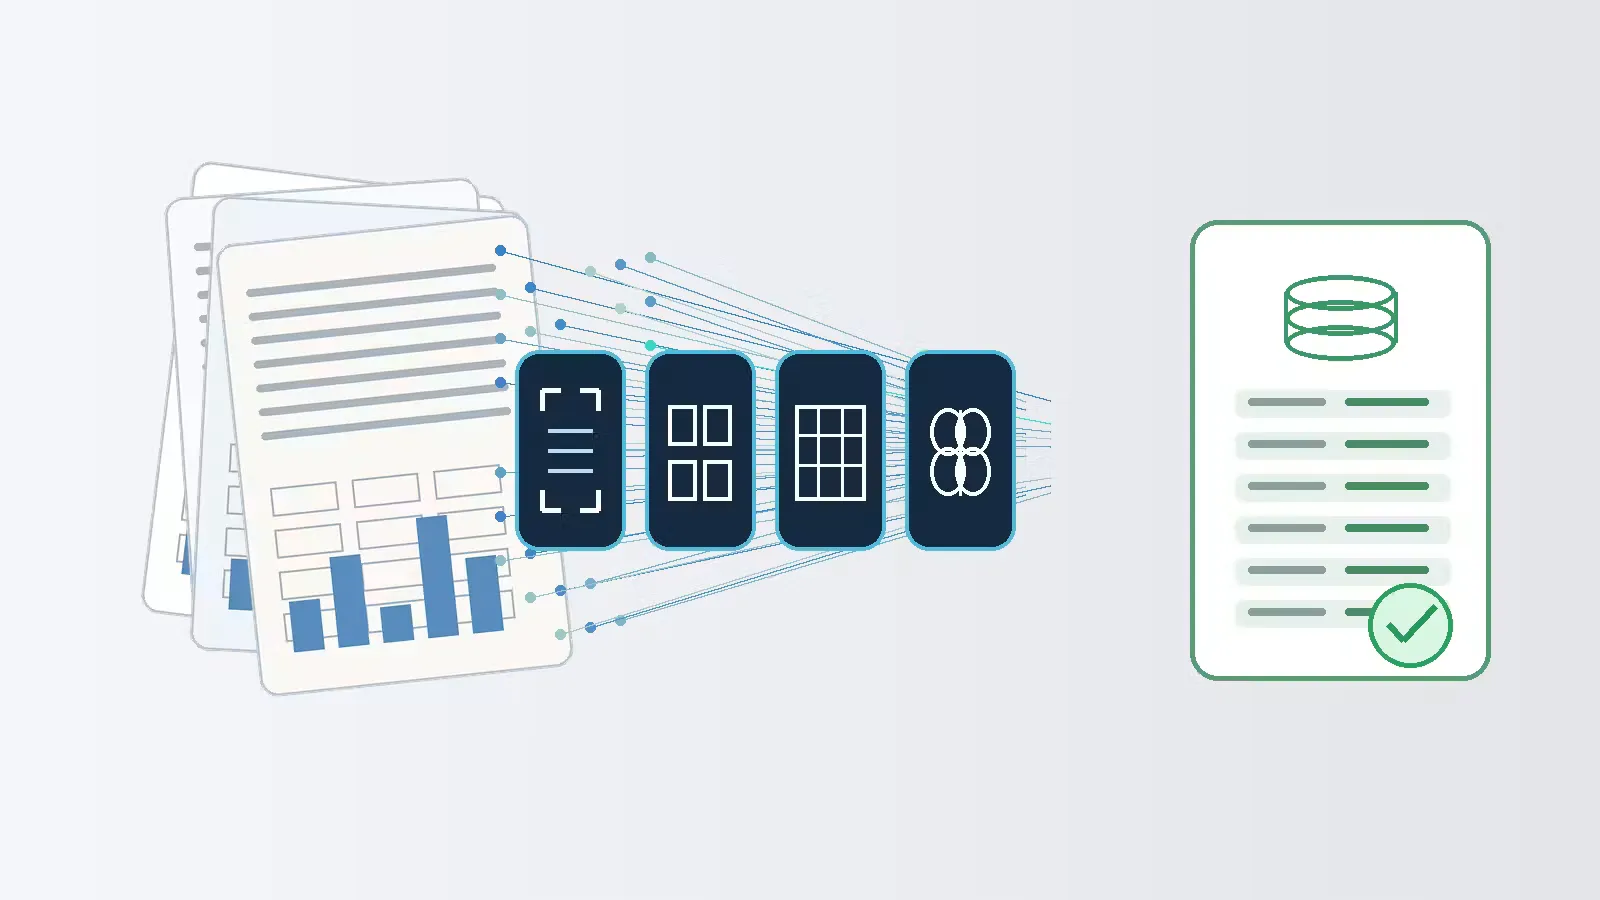
การแยกข้อมูลเอกสาร AI คือกระบวนการเปลี่ยนข้อความ ตัวเลข ตาราง และโครงร่างภาพจากเอกสารที่ยุ่งเหยิงให้กลายเป็นข้อมูลเชิงโครงสร้างที่ระบบอื่นสามารถเชื่อถือและนำไปใช้ต่อได้ โดยอาศัยการผสาน OCR โมเดลเข้าใจโครงร่าง ตาราง และกฎการตรวจสอบข้อมูลเข้าด้วยกันเพื่อให้ได้ผลลัพธ์ที่แม่นยำและตรวจสอบย้อนกลับได้ การมองโจทย์นี้แค่ว่าเป็นการอ่านข้อความบนหน้าเอกสารจึงเป็นความเข้าใจที่คลาดเคลื่อนตั้งแต่ต้น เพราะแม้ OCR จะอ่านคำได้ถูกต้อง แต่ยังไม่เข้าใจว่าข้อมูลชิ้นนั้นอยู่ตรงไหน มีความสัมพันธ์กับหัวข้อใด และหมายถึงอะไรในบริบทธุรกิจ จุดที่มักถูกเข้าใจผิดคือการคิดว่าความแม่นยำ OCR เพียงพอแล้วสำหรับเอกสารธุรกิจอัตโนมัติ ในความเป็นจริงคุณสามารถรู้ทุกคำบนหน้าเอกสารแต่ตีความผิดทุกตัวเลขสำคัญได้ หากระบบทำการแยกข้อมูลโดยไม่คำนึงถึงโครงร่าง ตาราง และหัวข้อที่รายล้อมอยู่ การแยกข้อมูลเอกสาร AI ที่ดีจึงเริ่มจากการยอมรับว่า OCR เป็นแค่ขั้นตอนแรก ไม่ใช่คำตอบสุดท้าย

จาก OCR สู่โมเดลโครงร่าง เอกสารไม่ได้มีแค่คำแต่มีโครงสร้าง
หากมองใกล้ๆ เอกสารธุรกิจที่ซับซ้อนไม่ได้ประกอบด้วยข้อความต่อเนื่อง แต่เต็มไปด้วยคอลัมน์ ตาราง หัวข้อย่อย เชิงอรรถ และองค์ประกอบภาพที่บอกความหมายผ่านตำแหน่งและความสัมพันธ์กัน เอกสารการเงินอาจมีตารางซ้อนเชิงอรรถ รายงานค่าตอบแทนใช้หัวข้อเฉพาะทาง สัญญาเช่ากระจายข้อกำหนดข้ามหลายหน้า และรายงานด้านความยั่งยืนผสมแผนภาพ ตาราง และเนื้อเรื่องเข้าไว้ด้วยกัน ถ้าระบบแยกข้อมูลเพียงดึงข้อความออกมาโดยไม่เข้าใจโครงร่าง โอกาสผิดย่อมสูงอย่างหลีกเลี่ยงไม่ได้ ทางออกคือการเพิ่มโมเดลเข้าใจโครงร่างเข้ามาในสายพานการแยกข้อมูล โมเดลเหล่านี้จะระบุว่าอะไรคือหัวข้ออะไรคือย่อหน้า อะไรคือพื้นที่คู่ค่า key value และตรงไหนคือส่วนของตาราง จากนั้นจึงใช้ขั้นตอนตรวจจับตารางเพื่อประกอบแถวและคอลัมน์ให้กลับมาเป็นตารางที่มีหัวตารางสัมพันธ์กับค่าจริง แนวคิดเดียวกันนี้ถูกใช้กับเอกสารเรซูเม่หลายคอลัมน์ โดยนำตำแหน่ง x y ของตัวอักษรมาจัดกลุ่มตามคอลัมน์ซ้ายขวาแล้วเรียงบนลงล่างให้กลายเป็น Markdown ที่มีหัวข้อและลำดับประสบการณ์ชัดเจน การเข้าใจโครงร่างก่อนจึงเป็นก้าวสำคัญที่เปลี่ยนเอกสารยุ่งเหยิงให้เป็นข้อมูลจัดระเบียบพร้อมตรวจสอบ
สายพานหลายขั้นตอน ความแม่นยำ OCR เป็นแค่จุดเริ่มต้น ไม่ใช่จุดจบ
เมื่อดูจากประสบการณ์ในระบบแยกข้อมูลเอกสารที่ใช้ในงานจริง จุดยากไม่ใช่การอ่านคำ แต่คือการทำให้ข้อมูลที่อ่านได้กลายเป็นข้อมูลเชิงโครงสร้างที่ระบบอื่นเชื่อถือได้ วิธีที่ใช้งานได้จริงคือการแบ่งปัญหาออกเป็นหลายขั้นตอน แต่ละขั้นจัดการข้อผิดพลาดคนละแบบแทนที่จะพึ่งโมเดลเดียวให้ทำทุกอย่างในคราวเดียว สายพานทั่วไปเริ่มจากการนำเข้าเอกสาร ตรวจคุณภาพหน้าและรูปภาพ จากนั้นใช้ OCR อ่านข้อความ ก่อนส่งต่อให้โมเดลเข้าใจโครงร่างระบุหัวข้อ ย่อหน้า ตาราง และพื้นที่คู่ค่า แล้วจึงใช้ตัวตรวจจับตารางประกอบแถวและคอลัมน์ให้กลับมาเป็นตารางสมบูรณ์ สุดท้ายจึงให้โมเดลแยกข้อมูลตาม schema เป้าหมายที่กำหนดไว้ล่วงหน้า ในระบบวิเคราะห์เรซูเม่สมัยใหม่ สายพานถูกจัดเป็นขั้นตอนต่อเนื่องเช่น การนำเข้า Layout Sanitization ที่จัดตัวอักษรตามพิกัดให้กลายเป็น Markdown การประกอบข้อความนำสำหรับโมเดล การรันโมเดลในโหมด JSON และการตรวจสัญญาด้วย schema อย่างเข้มงวดก่อนบันทึกลงฐานข้อมูล ข้อดีของการแบ่งขั้นคือสามารถตรวจสอบและทดสอบความผิดพลาดของแต่ละช่วงได้ง่าย ทำให้การแยกข้อมูลเอกสาร AI น่าเชื่อถือขึ้นโดยไม่ต้องหวังให้โมเดลเดียวเก่งทุกเรื่องพร้อมกัน หนึ่งในคำกล่าวที่ควรจำคือ “การรู้ทุกคำบนหน้าเอกสารไม่ได้แปลว่าคุณเข้าใจเอกสารนั้น” เพราะถึง OCR จะอ่านตัวอักษรถูกทุกตัว หากสายพานต่อจากนั้นไม่เข้าใจโครงร่างและไม่ตรวจสอบข้อมูล ผลลัพธ์สุดท้ายก็ยังผิดพลาดได้เต็มร้อย
เหตุใดเอกสารธุรกิจต้องมีการตรวจสอบข้อมูลหลายชั้น
เอกสารธุรกิจ เช่น ใบแจ้งหนี้ ฟอร์ม หรือเอกสารเปิดเผยข้อมูลทางการเงิน ไม่ใช่เอกสารที่อ่านเล่นแล้วผิดนิดหน่อยไม่เป็นไร แต่เป็นข้อมูลที่ขับเคลื่อนการจ่ายเงิน การวิเคราะห์บัญชี การประเมินความเสี่ยง และการตัดสินใจในองค์กร หากนำข้อมูลที่แยกออกผิดไปป้อนระบบวิเคราะห์หรือรายงาน ผลกระทบจะสะสมเป็นความเสียหายรุนแรงในภายหลัง นี่คือเหตุผลที่เอกสารธุรกิจอัตโนมัติต้องอาศัยการตรวจสอบข้อมูลหลายชั้น ในเอกสารการเงิน ตัวเลขหนึ่งค่าอาจดูเหมือนรายรับ ค่าใช้จ่าย หรือกำไรได้ ขึ้นกับว่ามันอยู่แถวไหน คอลัมน์ไหน ช่วงเวลาใด และหัวข้อรอบข้างว่าเขียนว่าอะไร หากระบบแยกข้อมูลสูญเสียความสัมพันธ์ระหว่างค่าและหัวคอลัมน์ แม้ข้อความจะถูกต้อง ผลลัพธ์เชิงโครงสร้างก็ผิดทั้งหมดได้ แนวคิดเดียวกันใช้กับตารางสัญญาเช่า หากระบบไม่รักษาความสัมพันธ์ระหว่างวันที่ จำนวนเงิน และเงื่อนไขต่ออายุให้ครบถ้วน ข้อมูลที่ได้ไม่มีใครกล้าใช้ต่อในระดับองค์กร เพื่อจัดการความเสี่ยงนี้ ระบบเอกสารธุรกิจอัตโนมัติมักออกแบบกฎความเชื่อมั่นและการตรวจสอบ เพื่อคัดกรองว่าอะไรควรผ่านอัตโนมัติ และอะไรต้องให้คนตรวจ ว่าด้วยหลักการแล้วค่าที่ความเชื่อมั่นสูงและมีหลักฐานจากเอกสารสนับสนุนชัดเจนสามารถเดินหน้าแบบอัตโนมัติ ส่วนเขตคลุมเครือ เลย์เอาต์ผิดปกติ หรือค่าที่ขัดกันเองจะถูกปักธงให้เจ้าหน้าที่ทบทวน แนวคิดนี้ทำให้การแยกข้อมูลเอกสาร AI ไม่ใช่แค่การอ่าน แต่เป็นการคุมคุณภาพข้อมูลแบบเป็นระบบ
ผสาน OCR กับ schema validation เพื่อผลลัพธ์ที่องค์กรเชื่อใจได้
เมื่อมาถึงจุดที่ต้องให้เอกสารธุรกิจอัตโนมัติทำงานในระดับองค์กร คำถามไม่ใช่ว่าระบบอ่านได้หรือไม่ แต่คือองค์กรจะเชื่อข้อมูลที่ออกมาหรือเปล่า การสร้างความเชื่อใจนี้ต้องอาศัยการผสานหลายองค์ประกอบ ตั้งแต่ความแม่นยำ OCR การเข้าใจโครงร่าง ตาราง การแยกข้อมูลตาม schema และการตรวจสอบข้อมูลด้วย validation ที่เข้มงวด โดยแต่ละค่าในผลลัพธ์ไม่ควรเป็นแค่ตัวเลขลอยๆ แต่ต้องมาพร้อมหลักฐานว่ามาจากหน้าไหน ตารางใด และระบบมั่นใจแค่ไหน กรณีระบบวิเคราะห์เรซูเม่แบบเรียลไทม์ที่ใช้โมเดลขนาดใหญ่ สุดท้ายต้องเปลี่ยนผลลัพธ์ที่มีความสุ่มให้กลายเป็นเรคคอร์ดฐานข้อมูลแบบชนิดชัดเจนพร้อมคะแนน อาร์เรย์คำสำคัญที่ขาด และข้อเสนอแนะรายส่วนเพื่อให้ UI ใช้งานได้ ในการป้องกันความผิดและการล้มระหว่าง parse ระบบจึงบังคับให้โมเดลตอบในรูปแบบ JSON ตามสัญญา และใช้การตรวจสอบ runtime ด้วย schema พร้อมตัวช่วย sanitize ก่อนอนุญาตให้ข้อมูลเข้าไปอยู่ในฐานข้อมูล แนวทางเดียวกันนี้เมื่อนำมาใช้กับใบแจ้งหนี้แบบสแกนหรือรายงานการเงินจะสร้างชั้นการป้องกันที่สำคัญ เพราะแม้ OCR จะพลาดตัวอักษรบางตัว หรือโมเดลโครงร่างอาจเข้าใจหัวข้อผิด การตรวจสอบข้อมูลด้วย schema และหลักฐานจากเอกสารจะทำหน้าที่เป็นเครื่องกรองสุดท้ายก่อนให้ข้อมูลเดินทางต่อเข้าสู่โลก analytics โมเดลข้อมูล รายงาน และระบบตัดสินใจภายในองค์กร สุดท้ายความคุ้มค่าของการแยกข้อมูลเอกสาร AI ไม่ได้อยู่ที่การดึงข้อความออกจาก PDF หรือภาพสแกนได้รวดเร็ว แต่คือการทำให้ข้อมูลที่แต่เดิมเข้าถึงยากกลายเป็นข้อมูลเชิงโครงสร้างที่สามารถป้อนเข้าสู่ระบบวิเคราะห์ โมเดลข้อมูล รายงาน การค้นหา และระบบตัดสินใจได้อย่างมีความมั่นใจ เมื่อยอมรับว่า OCR เป็นเพียงขั้นแรก และลงทุนกับโมเดลโครงร่าง ตาราง และการตรวจสอบข้อมูลอย่างเป็นระบบ คุณจะได้เอกสารธุรกิจอัตโนมัติที่ไม่เพียงทำงานอัตโนมัติ แต่ยังน่าเชื่อถือในสายตาองค์กรด้วย