
AI Agent ในโลกโปรดักชันคือระบบกระจาย ไม่ใช่แค่แชตบอต
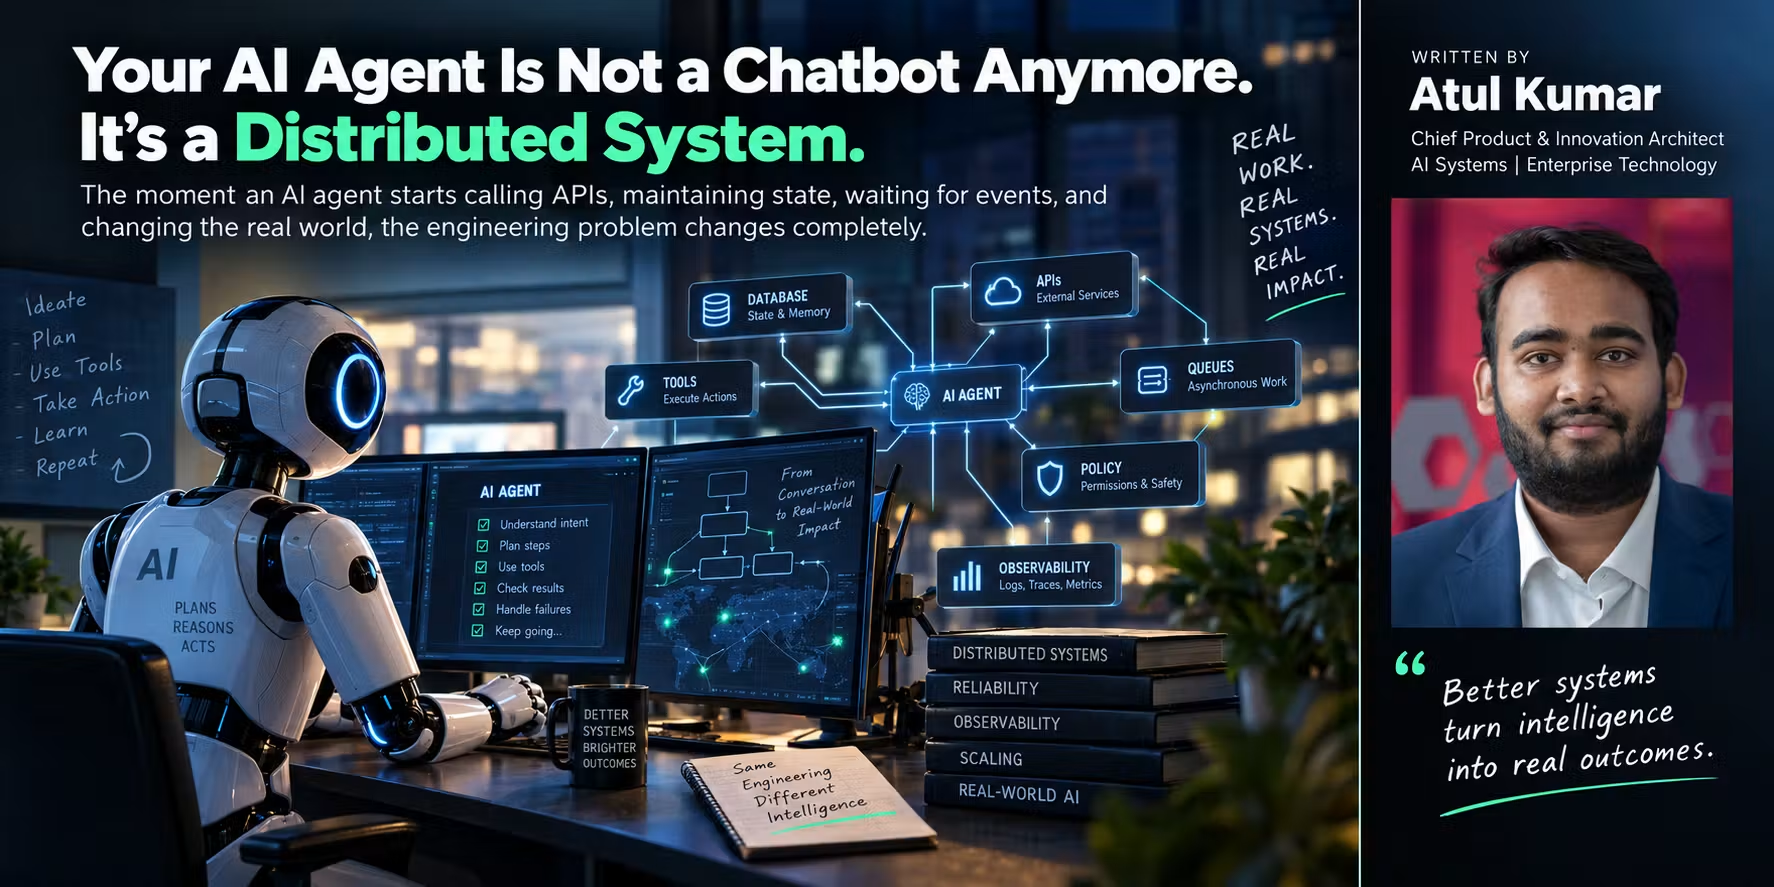
AI Agent ในโลกโปรดักชันคือกระบวนการซอฟต์แวร์ที่มีแกนกลางเป็นโมเดลภาษาที่ตัดสินใจเชิงความน่าจะเป็น เชื่อมต่อกับฐานข้อมูล API และเวิร์กโฟลว์แบบกระจาย เพื่อเปลี่ยนแปลงสถานะของระบบธุรกิจจริง ไม่ใช่เพียงตอบแชตหรือสร้างข้อความ จึงต้องออกแบบให้จัดการสถานะ ความผิดพลาด และการกู้คืนได้เหมือนระบบองค์กรเต็มรูปแบบ ปัญหาที่ทำให้ AI agent reliability ต่ำไม่ได้มาจากโมเดลไม่ฉลาด แต่มาจากการคิดว่า agent เป็นแค่แชตบอตที่มีเครื่องมือเพิ่มเล็กน้อย เมื่อเราให้มันอัปเดต CRM สร้างทิกเก็ต ซิงค์สต็อก หรือคืนเงินลูกค้า สถาปัตยกรรมจะเปลี่ยนทันทีและต้องรับมือฐานข้อมูล การยืนยันตัวตน ความขัดข้องของเครือข่าย ความขนาน การ retry และการกู้คืนสถานะที่ซับซ้อน จุดที่องค์กรพลาดคือทดสอบบนเดโมที่มีลูป ผู้ใช้ โมเดล และเครื่องมือเพียงเส้นเดียว แล้วเชื่อว่าถ้าเดโมสวย ระบบโปรดักชันก็พร้อม ทั้งที่โลกจริงเต็มไปด้วยการทำงานพร้อมกัน เวลาตอบสนองที่ยืดเยื้อ และข้อมูลที่เปลี่ยนตลอดเวลา
ช่องว่างระหว่าง Pilot กับการ rollout: ตัวเลขดีไม่ได้แปลว่าพร้อมใช้ทั้งองค์กร
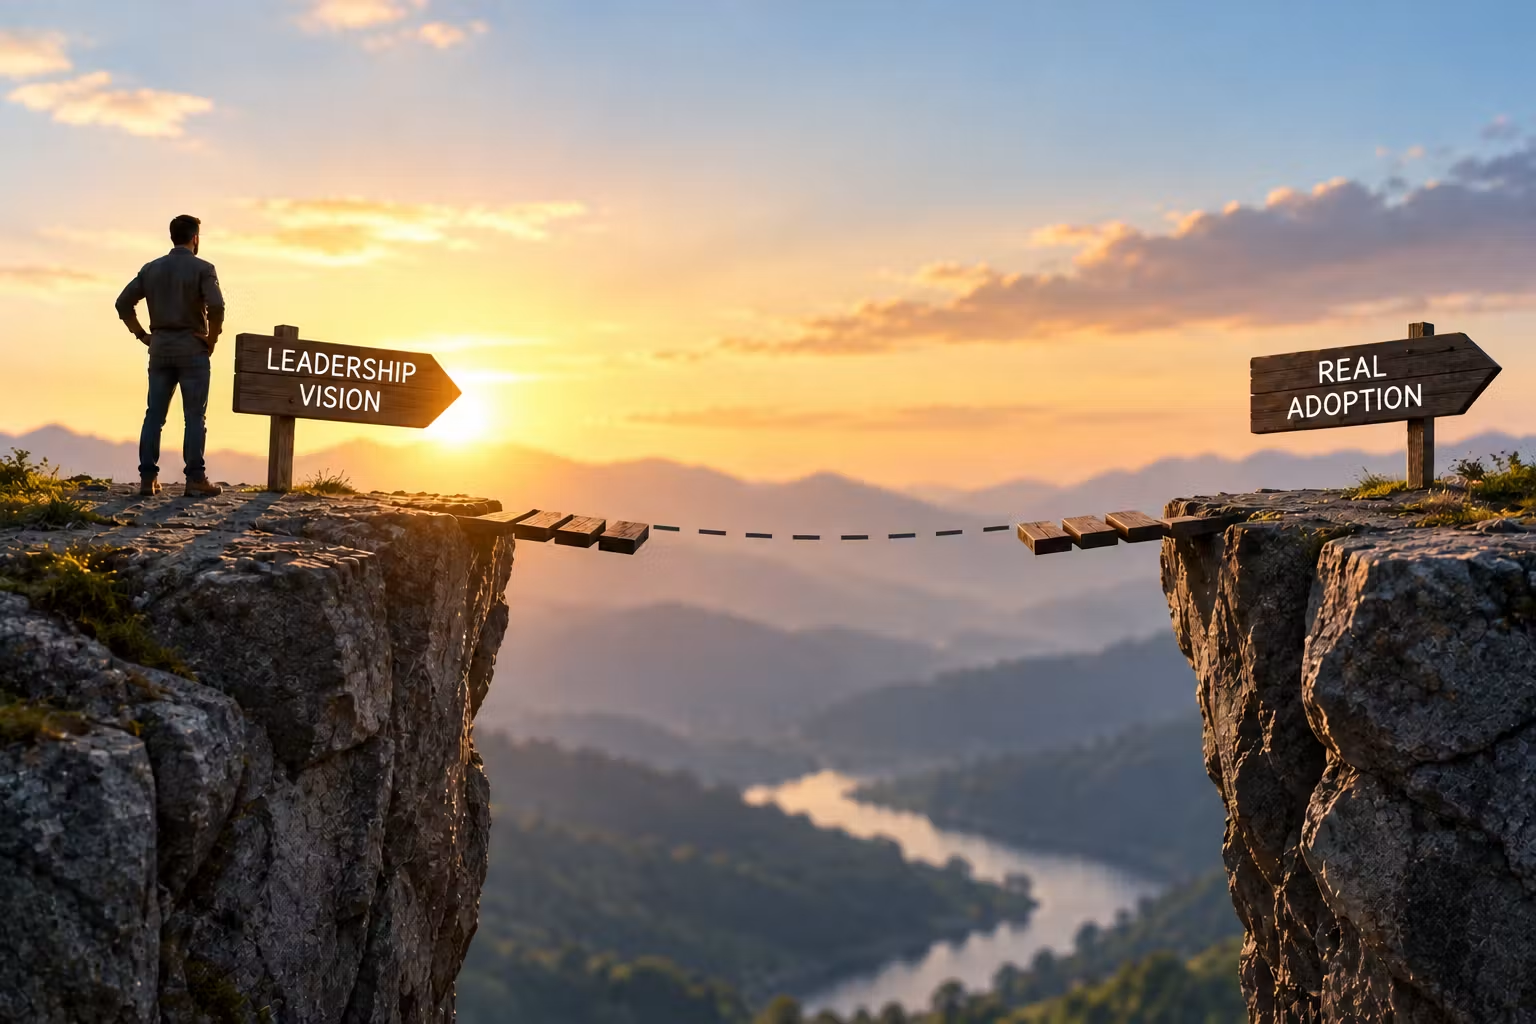
ถ้าอยากให้ AI agent reliability สูง เราต้องยอมรับก่อนว่าผลลัพธ์จาก testing pilot มักหลอกตา ในการสำรวจ QA จำนวน 302 คน 88% บอกว่า AI เป็นยุทธศาสตร์สำคัญของการทดสอบในอนาคต แต่มีเพียง 12.6% ที่ใช้มันในกิจกรรมทดสอบหลักอย่างแพร่หลาย คำพูดนี้ควรถูก quote ตรงๆ เพราะมันบอกชัดว่าความคาดหวังกับการใช้งานจริงยังห่างกันมาก รายงาน World Quality Report 2025 ระบุว่าองค์กรเพียง 15% ใช้ GenAI ทั่วทั้งองค์กร 43% ยังอยู่ระดับทดลอง และ 30% ใช้ในเคสจำกัด ขณะที่ 11% ยังไม่ใช้เลย เคส health-tech ที่รัน pilot 6 สัปดาห์บน flow intake ที่มีเอกสารดี ผลออกมางาม ทั้ง coverage ดีและเจอบั๊ก severity 2 เพิ่มอีกสามเคส แต่เมื่อ leadership ข้ามขั้น scaling แล้วสั่ง rollout ไป 12 flow ภายในสองสัปดาห์ ความจริงก็โผล่ สามสัปดาห์ถัดมา ทีม QA ใช้เวลากว่า 40% ไปกับการแก้เทสที่ AI สร้าง มากกว่าการเขียนเทสใหม่เอง แปลว่าตัวชี้วัดความสำเร็จของ pilot ไม่เคยถูกออกแบบมาเพื่อวัด production deployment ตั้งแต่แรก
State management ไม่ใช่ memory เพิ่ม เครื่องมือสถาปัตยกรรมที่หลายทีมมองข้าม
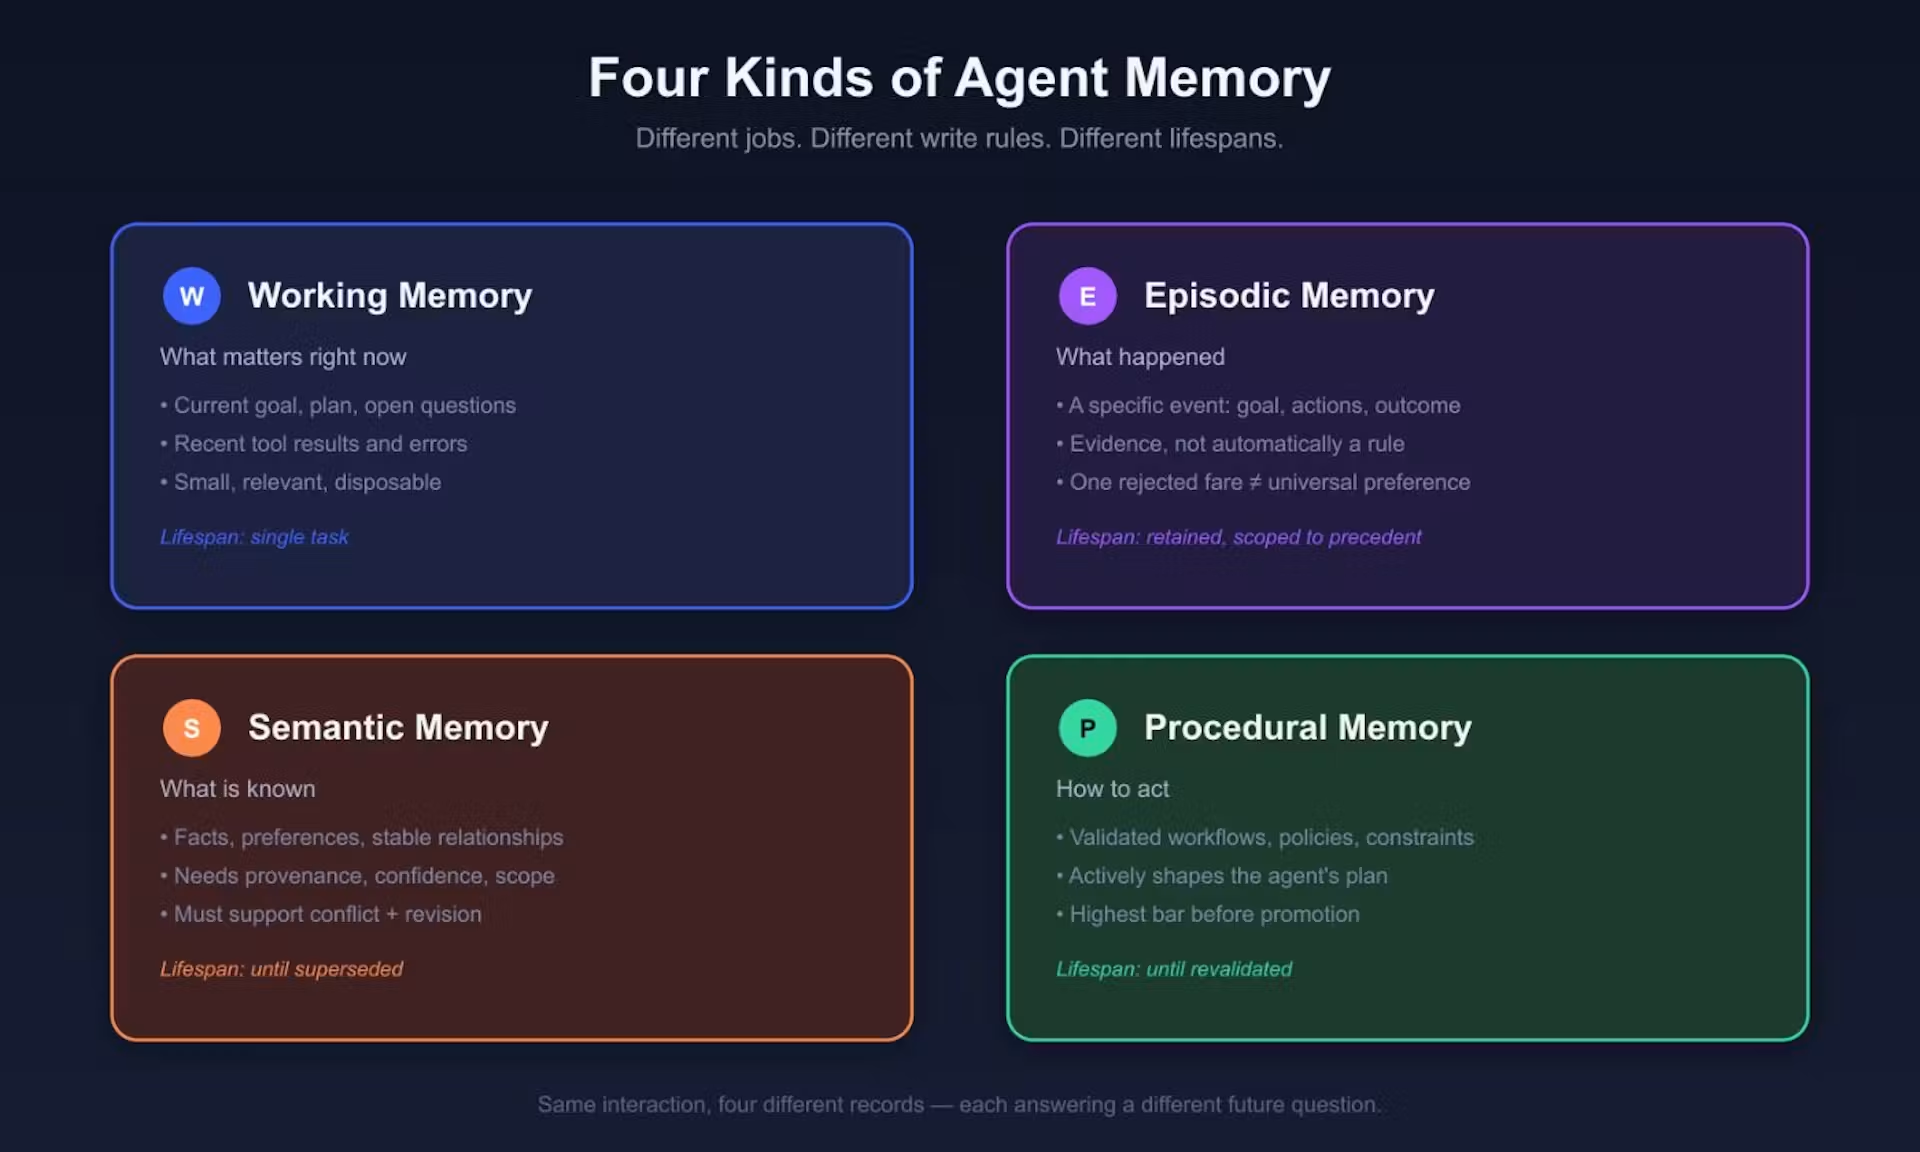
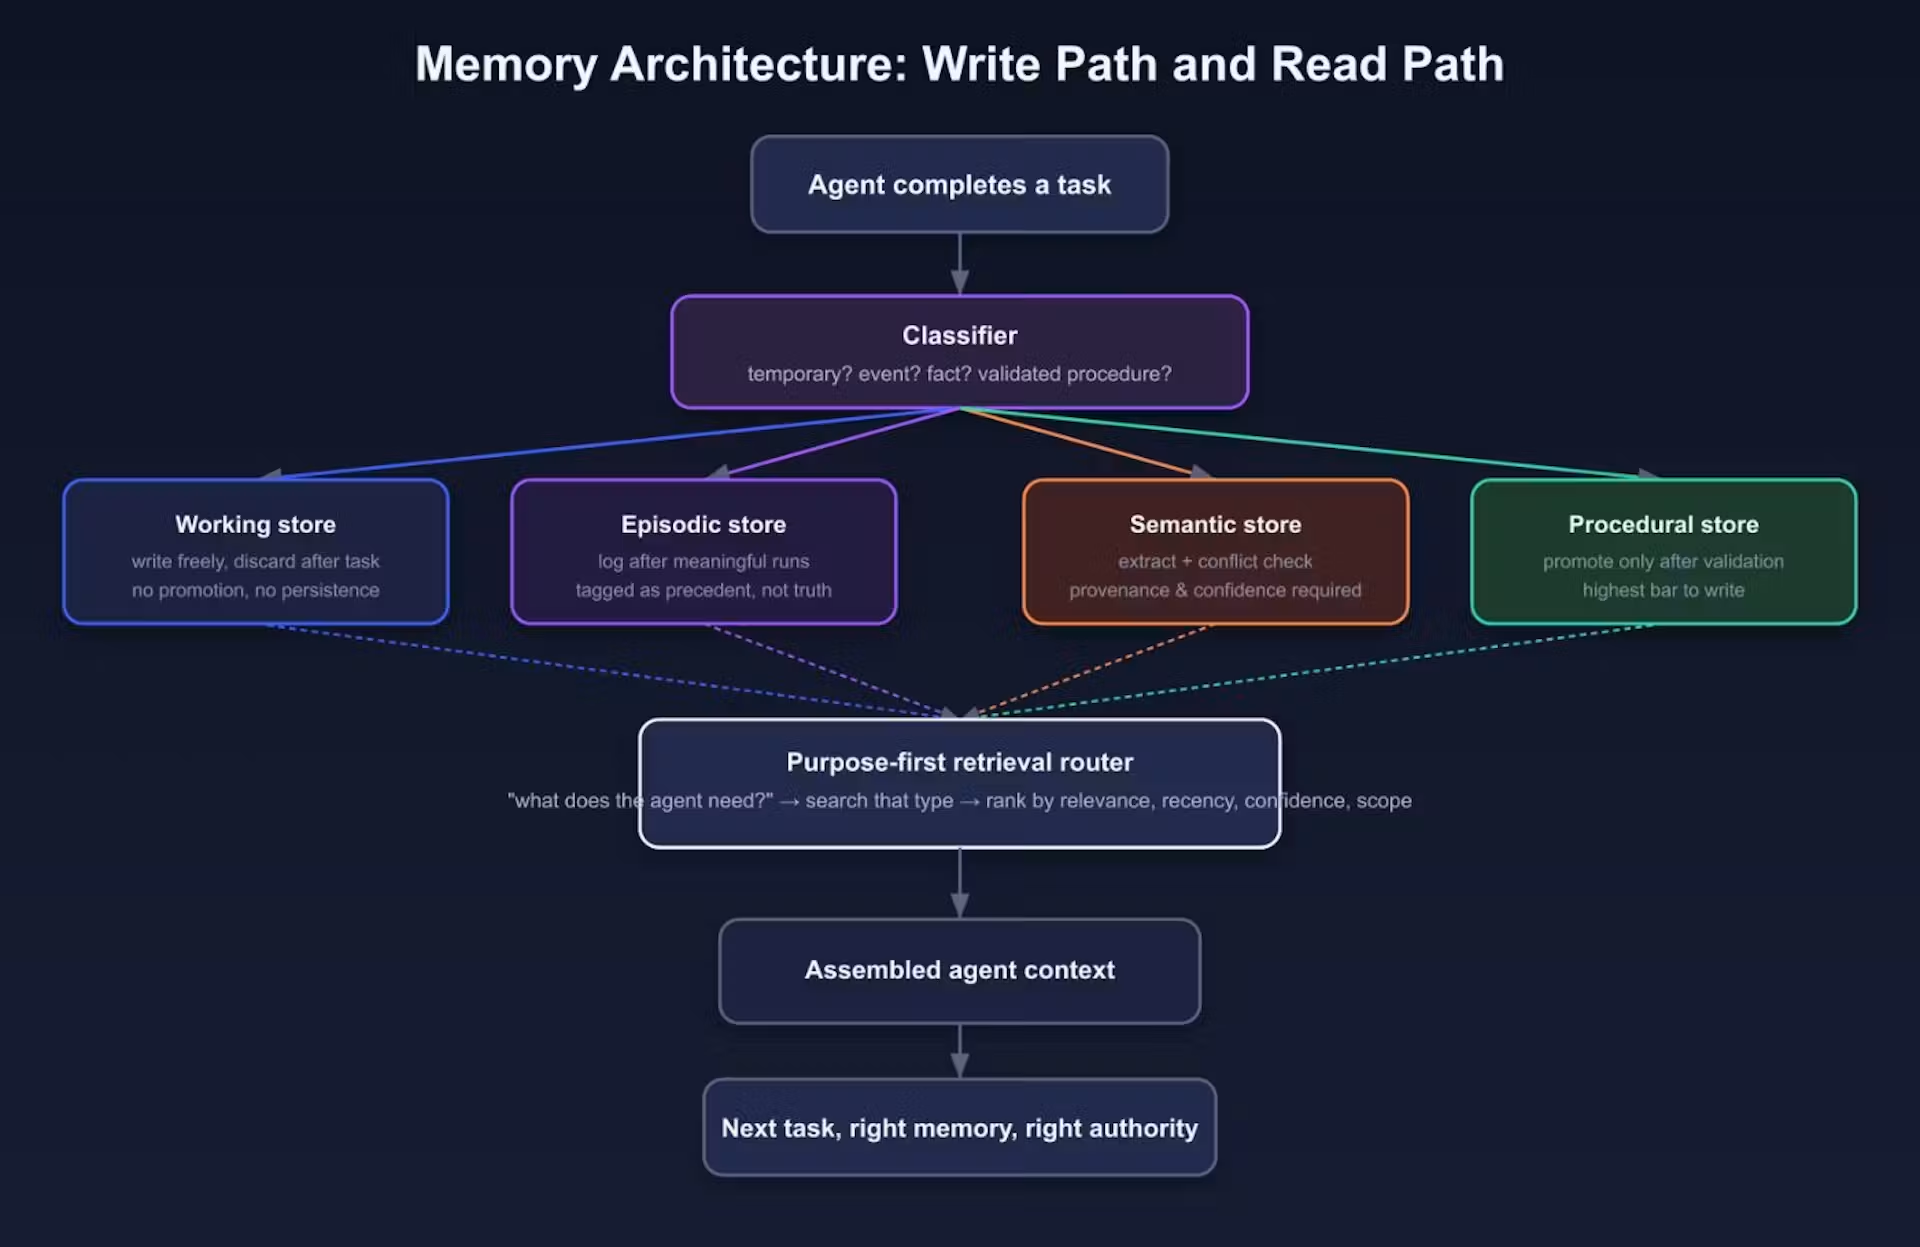
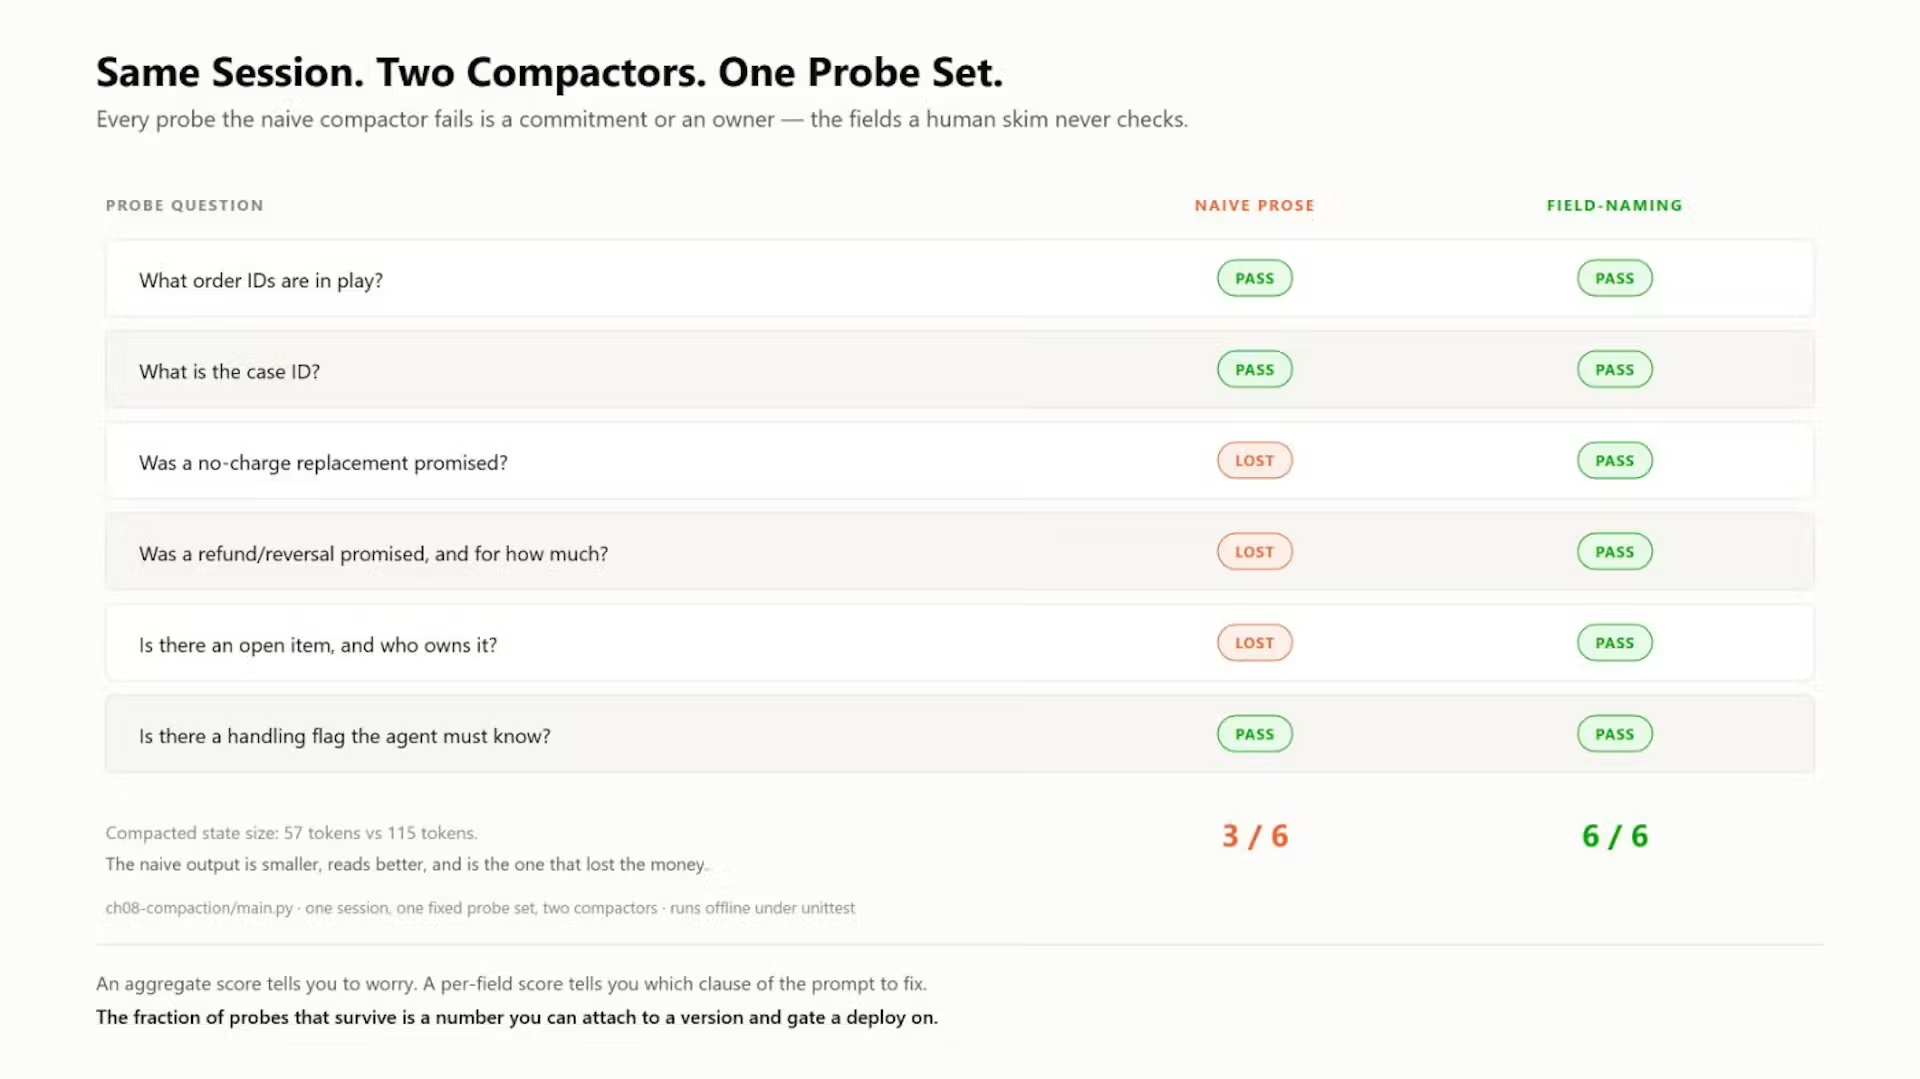
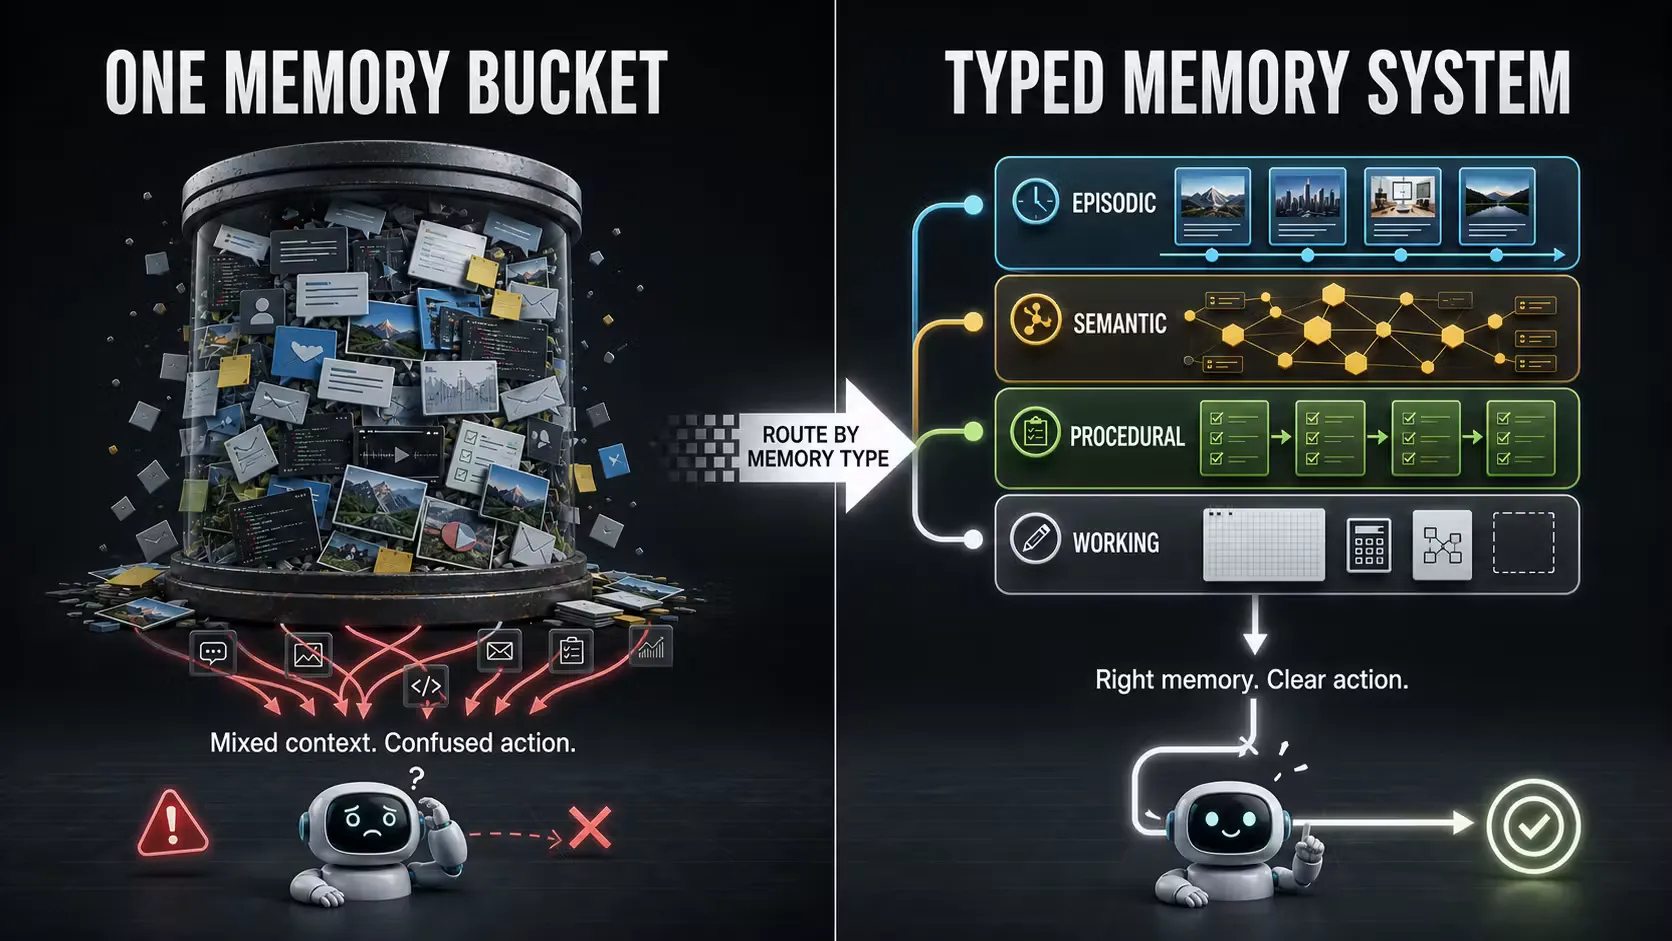
ทุกครั้งที่ agent ลืมอะไรบางอย่าง สัญชาตญาณของทีมคือเพิ่ม memory ทั้งเพิ่ม context window ใช้เวกเตอร์ดาต้าเบส สรุปบทสนทนา หรือดึงประวัติมากขึ้นก่อนตัดสินใจ ซึ่งฟังดูดีแต่เริ่มพังทันทีที่ agent ไม่ใช่แค่หน้าต่างสนทนาและเริ่มทำงานกับระบบธุรกิจจริง ปัญหาไม่ได้อยู่ที่จำไม่พอ แต่อยู่ที่ไม่รู้ว่าอะไรคือความจริง ณ ตอนนี้ ตัวอย่าง agent คืนเงินลูกค้า มันอาจจำบทสนทนา จำว่ามีการเรียก API และข้อความตอบรับ แต่สิ่งที่บอกได้ว่าคืนเงินสำเร็จหรือไม่คือระบบจ่ายเงิน ไม่ใช่ความทรงจำของ agent เอง นี่คือปัญหา state management โดยตรง แนวทางที่ได้ผลในโปรดักชันคือทำให้ LLM เป็นส่วน stateless ล้อมด้วย state management systems ที่ดูแลเซสชัน สถานะการทำงาน การ persist การเรียกเครื่องมือ และการ recovery ขณะที่โมเดลได้รับเพียง context compaction ที่ถูกเลือกแล้วว่าสำคัญต่อการตัดสินใจครั้งนั้น เมื่อเราหยุดเรียกทุกอย่างว่า memory คำถามสำคัญที่โผล่มาคือ ใครเป็นเจ้าของ state นั้น และมันสดใหม่แค่ไหน

Observability-first และสัญญา output: กัน agent พัง UI และ workflow
ในโลกที่ LLM ไม่เป็นเชิงกำหนด การจะให้ AI agent reliability สูง เราต้องเริ่มจาก observability architecture ก่อนเขียนลูปหลักของ agent ผู้พัฒนาระบบ support หลังการซื้อหนึ่งรายออกแบบชั้น tracing เต็มรูปแบบก่อนเขียนโค้ด agent แม้บอกเองว่า observability คือรากฐานของความน่าเชื่อถือ และออกแบบให้มีโมเดล trace ในหน่วยความจำเป็นแหล่งความจริงสำหรับระบบตรวจสอบ ขณะที่เครื่องมืออย่างแพลตฟอร์ม tracing ภายนอกเป็นแค่ที่เก็บเพื่อให้มนุษย์วิเคราะห์ แนวทางนี้ทำให้มองเห็น state corruption หรือ context ที่หายไปได้ตั้งแต่ต้น ในฝั่งผู้ใช้ทั่วไป ปัญหาชัดเจนกว่าคือช่องว่างระหว่างการตอบเชิงความน่าจะเป็นของโมเดลกับ UI มือถือที่ต้องการข้อมูลที่มีโครงสร้างแน่นอนเสมอ ถ้าไม่มี output contract แบบ schema ชัดเจน การแสดงผลจึงพังเงียบๆ บนเครื่องผู้ใช้ ทางแก้ไม่ใช่เขียน prompt ใหม่ แต่ต้อง treat output เป็นสัญญาที่ผ่านการ validate ก่อน UI แตะ ถ้าไม่ผ่านต้องมี fallback ที่ไม่ทำให้จอขาวหรือแอปค้าง พร้อมกับมีชั้น policy และ validation ตรวจโครงสร้างและความหมายของคำสั่งที่ agent เสนอ ก่อนบันทึกเป็น state ใหม่ของระบบ
Memory ที่ดีต้องรู้จักลืม และนิยามเส้นชัยใหม่ของการ rollout
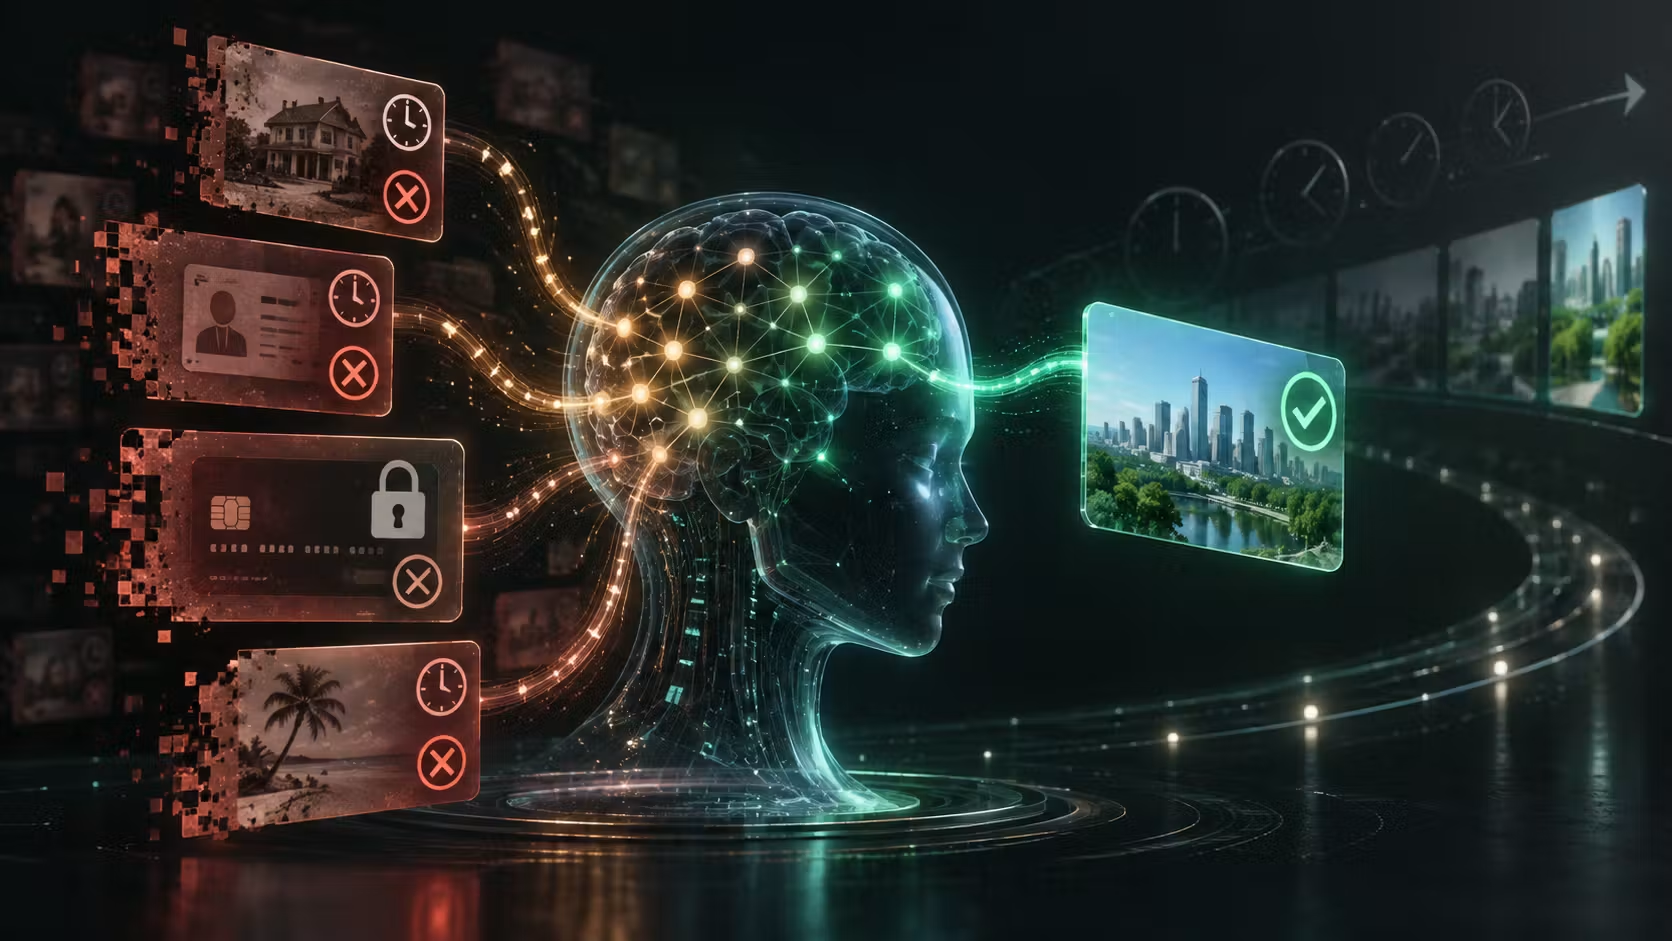
อีกหลุมพรางของหลายทีมคือหมกมุ่นกับการให้ agent จำทุกอย่าง นานที่สุด โดยไม่สอนให้มันรู้ว่าอะไรควรถูกลบหรือ supersede ตัวอย่างคลาสสิกคือ agent ตอบลูกค้าว่านโยบายคืนเงินคือ 14 วันไม่ถามเหตุผล จากบทสนทนาจริงเมื่อหลายเดือนก่อน ทั้งที่บริษัทลดเหลือ 7 วันเพราะปัญหาทุจริตมาสามเดือนแล้ว agent ไม่โกหก มันแค่ยกความจริงเก่าที่ถูกโลกแซงไปแล้ว นี่คือการออกแบบ memory ที่ขาดความเข้าใจเรื่อง freshness และ supersession ในโลกมนุษย์ เราไม่แบกทุกบทสนทนาไว้ตลอดชีวิต สมองปล่อยให้ข้อมูลที่ไม่สำคัญหลุดไป ระบบ agent ก็ต้องทำแบบเดียวกัน ไม่ใช่ append ความทรงจำไปเรื่อยๆ ด้วยความมั่นใจเท่าเดิมในวันที่ 400 เมื่อมองย้อนกลับไปที่เรื่อง health-tech จะเห็นว่าปัญหาที่แท้จริงของ production deployment คือการนิยามเส้นชัยผิด A passing pilot is just a starting point ไม่ใช่ใบรับรองว่าระบบพร้อมใช้ทั้งองค์กร ระยะต่อไปต้องเน้น scaled testing ที่วัด defect escape rate เมื่อเทสที่ AI สร้างถูกฝังใน CI และครอบคลุม flow ที่ไม่มีใครเฝ้าดูใกล้ชิดแล้ว ส่วนฝั่ง agent เอง หลังออกแบบชั้น tracing เสร็จ ผู้พัฒนาก็พร้อมไปสู่ขั้นตอนเขียนลูปหลักของ agent ซึ่งจะถูกเล่าต่อในบทความถัดไป แสดงให้เห็นว่าการออกแบบฐานความน่าเชื่อถือและการจัดการความทรงจำที่มีเส้นตายชัดเจนคือก้าวต่อไปที่หลีกเลี่ยงไม่ได้