
AI Agent ไม่ได้โง่หรือขี้ลืม ปัญหาคือ state และ context ที่ผิดรูป
AI agent ที่ดูเหมือนความจำสั้นมักไม่ได้ลืมเพราะโมเดลแย่ แต่เพราะจัดการ state และ context ไม่ดี ทำให้ข้อมูลสำคัญถูกบีบอัดทิ้งหรือไม่รู้ว่าอะไรคือความจริงล่าสุดระหว่างประวัติการสนทนา เครื่องมือภายนอก และระบบธุรกิจที่เป็นแหล่งข้อมูลอ้างอิง จึงต้องออกแบบสถาปัตยกรรม AI agent memory management ที่แยกความหมายของข้อมูลแต่ละชนิด และตัดสินได้ว่าอะไรควรถูกเก็บ ใช้ ลืม หรือเขียนทับ เพื่อให้การตัดสินใจในขั้นตอนต่อไปไม่พังเพราะ state ที่ผิดหรือเก่า
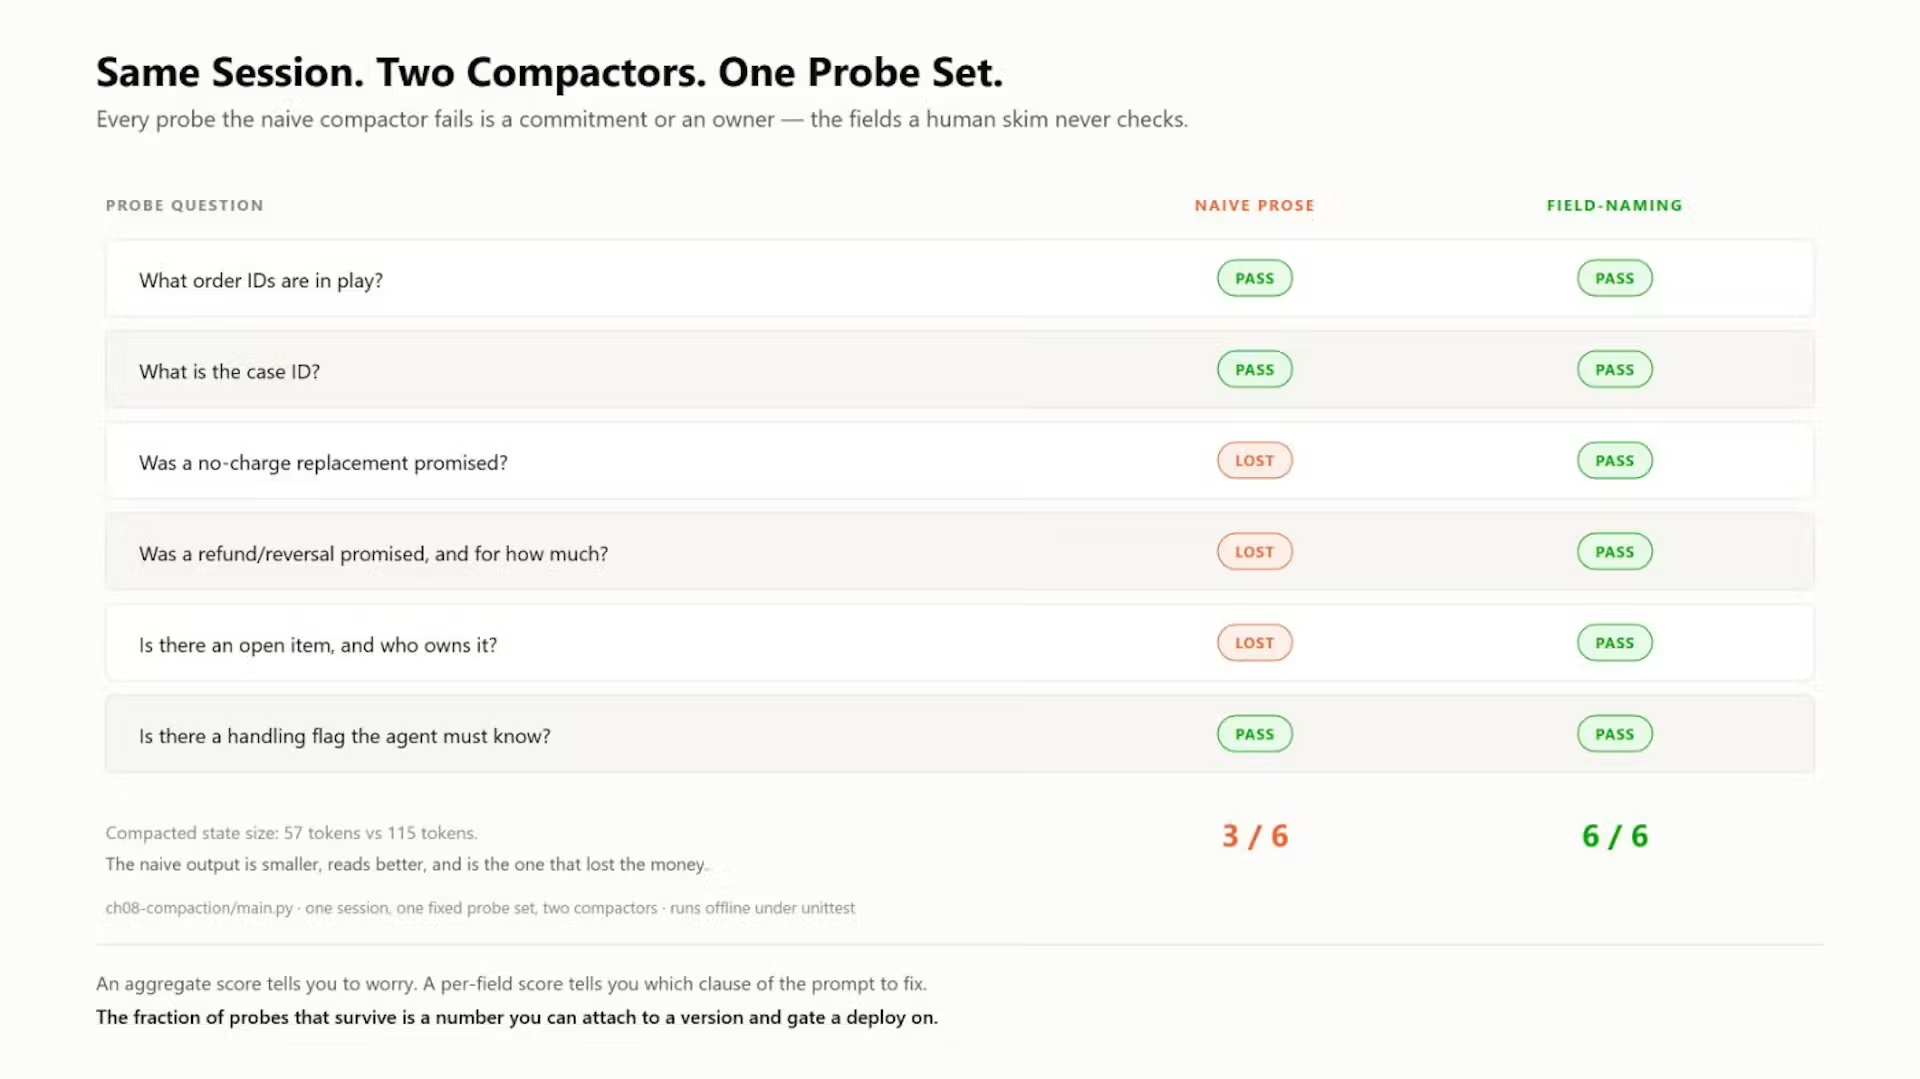
เวลาผู้ใช้บอกว่า AI ถามข้อมูลซ้ำ ทำผิดข้อกำหนด หรือไม่รักษาสัญญาเก่า ปฏิกิริยาปกติคือโทษว่าโมเดลหลอน แต่บ่อยครั้งโมเดลกำลังทำตาม context ที่ถูกบีบอัดผิดก่อนเข้าระบบนั่นเอง อ่านสรุปแล้วยังดูครบ แต่ข้อมูลเชิงปฏิบัติที่จำเป็นต่อการตัดสินใจขั้นถัดไปกลับหายไป นี่คือเหตุผลที่ประโยคว่า “Readable summaries can still be operationally wrong” สะท้อนความจริงของระบบ production ได้แรงมาก ปัญหาจึงไม่ใช่ต้องเพิ่มความจำอย่างเดียว แต่ต้องมอง context compression เป็นพื้นผิวด้านความเชื่อถือ ไม่ใช่แค่เครื่องมือประหยัดโทเคน
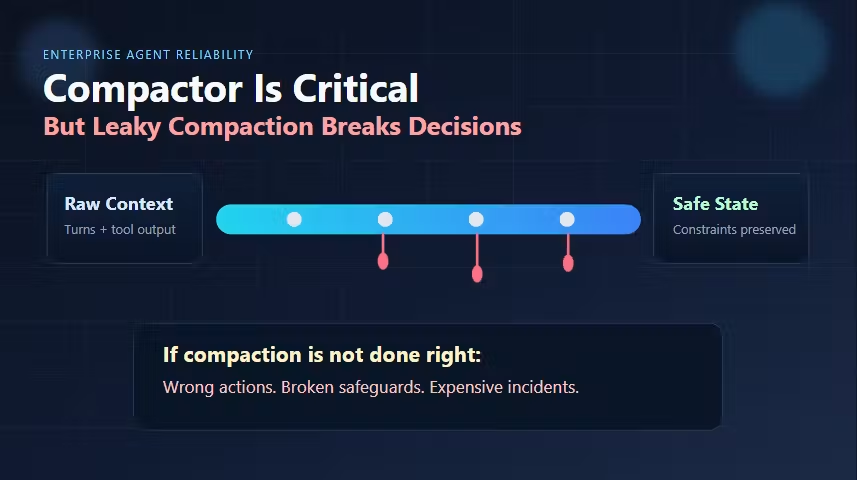
แยก “ความเกี่ยวข้อง” ออกจาก “ความจริง” ด้วย state management architecture
การดันเอกสารเก่า ประวัติแชตยาว หรือผลตอบสนองจากเครื่องมือต่างๆ เข้า context โดยไม่คิดว่าอะไรคือความจริง ณ ตอนนี้ ทำให้โมเดลตีความได้ดีแต่บนข้อมูลผิด ความสามารถ reasoning อาจถูกต้อง แต่ข้อมูลที่ให้ไปผิด ส่งผลให้ข้อสรุปผิดแบบแก้ด้วย prompt engineering ไม่ได้ง่ายเลย การดึงข้อมูลที่ “เกี่ยวข้อง” ผ่าน vector search จึงไม่เท่ากับการดึงข้อมูลที่ “เป็นความจริงล่าสุด” ซึ่งเป็นคนละโจทย์กับการจัดการฐานความรู้ โดยยังยืนยันได้ว่าระบบค้นคืนเชิงความหมายยังมีประโยชน์มากสำหรับงานที่ออกแบบมาให้ใช้
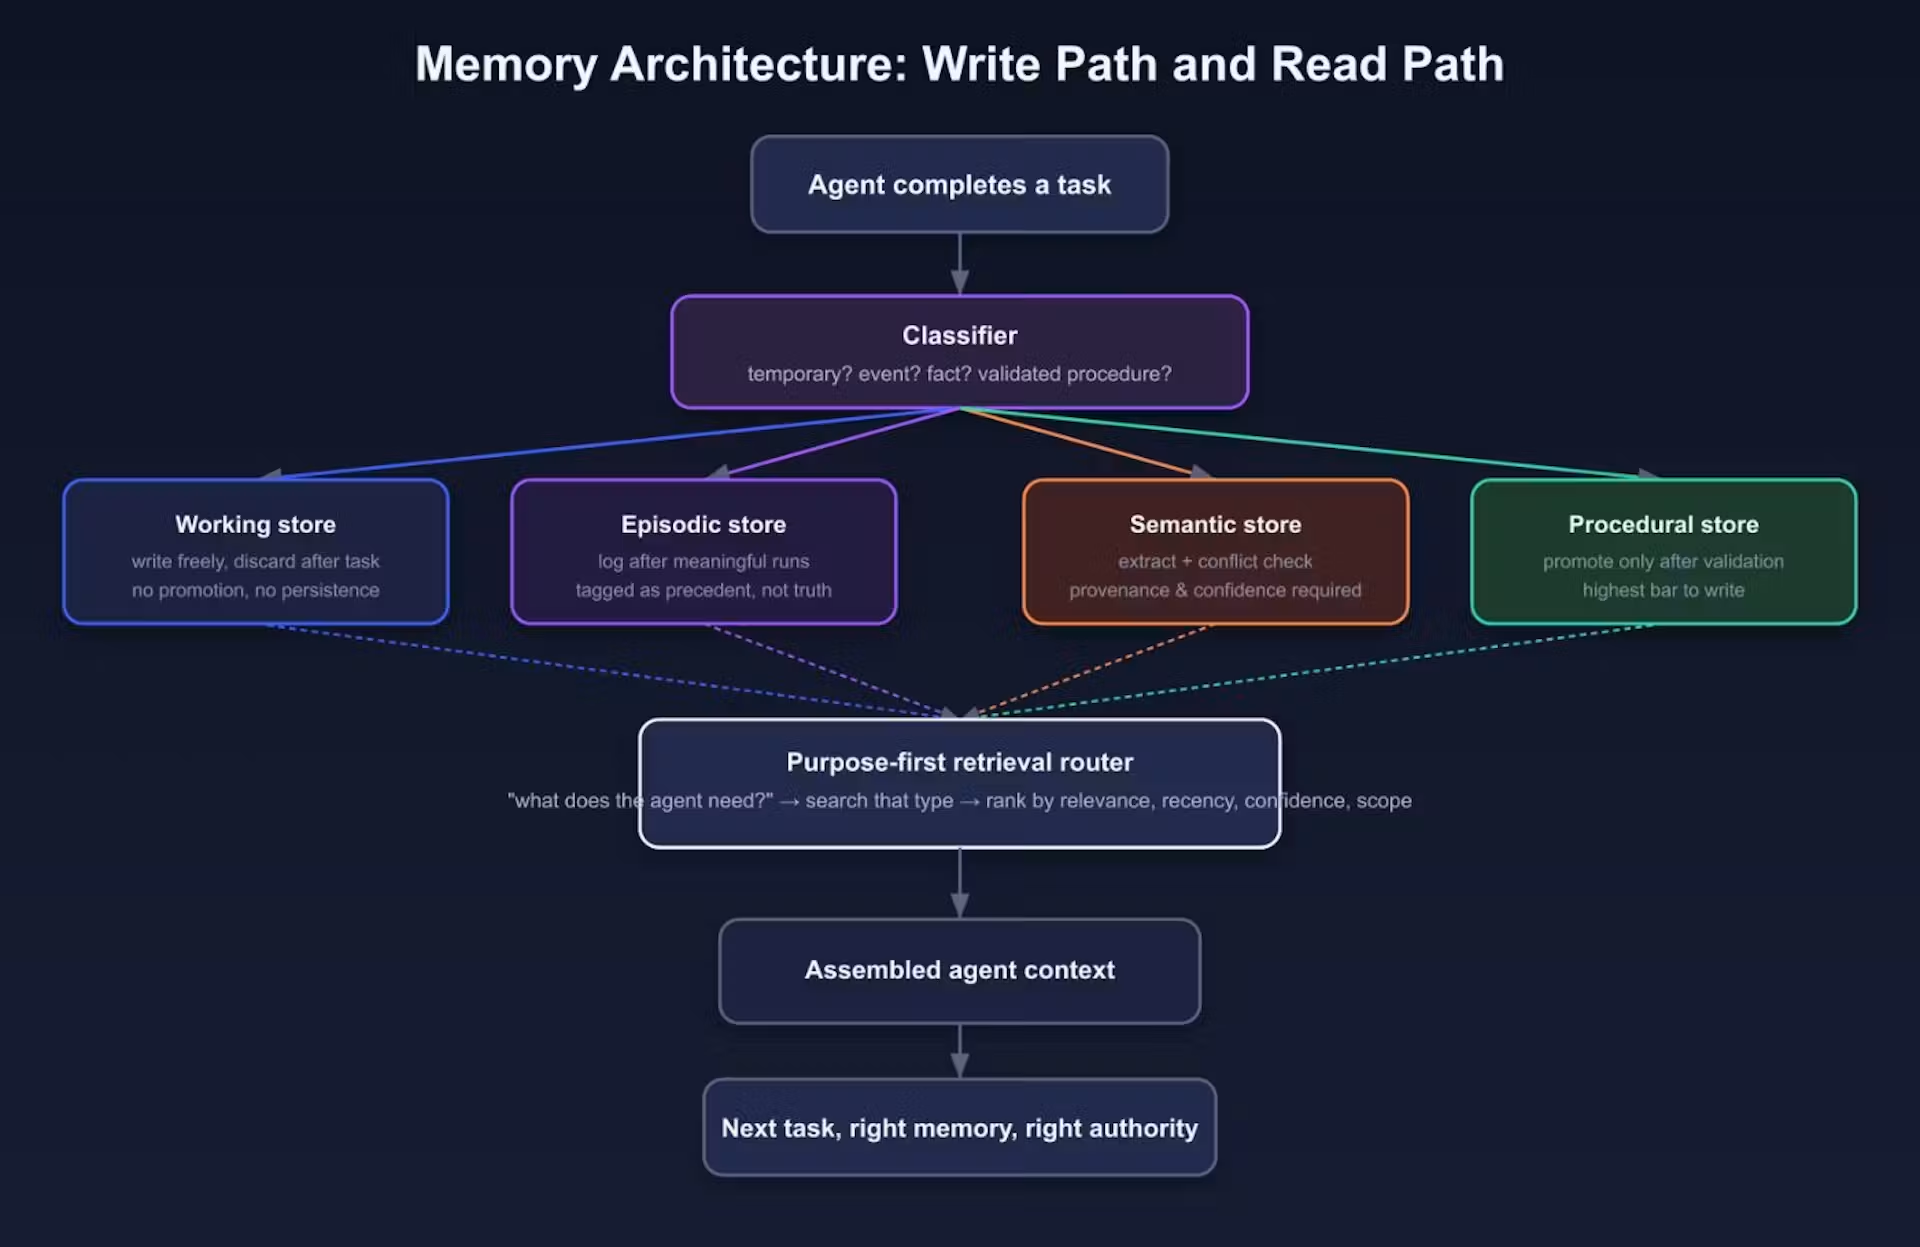
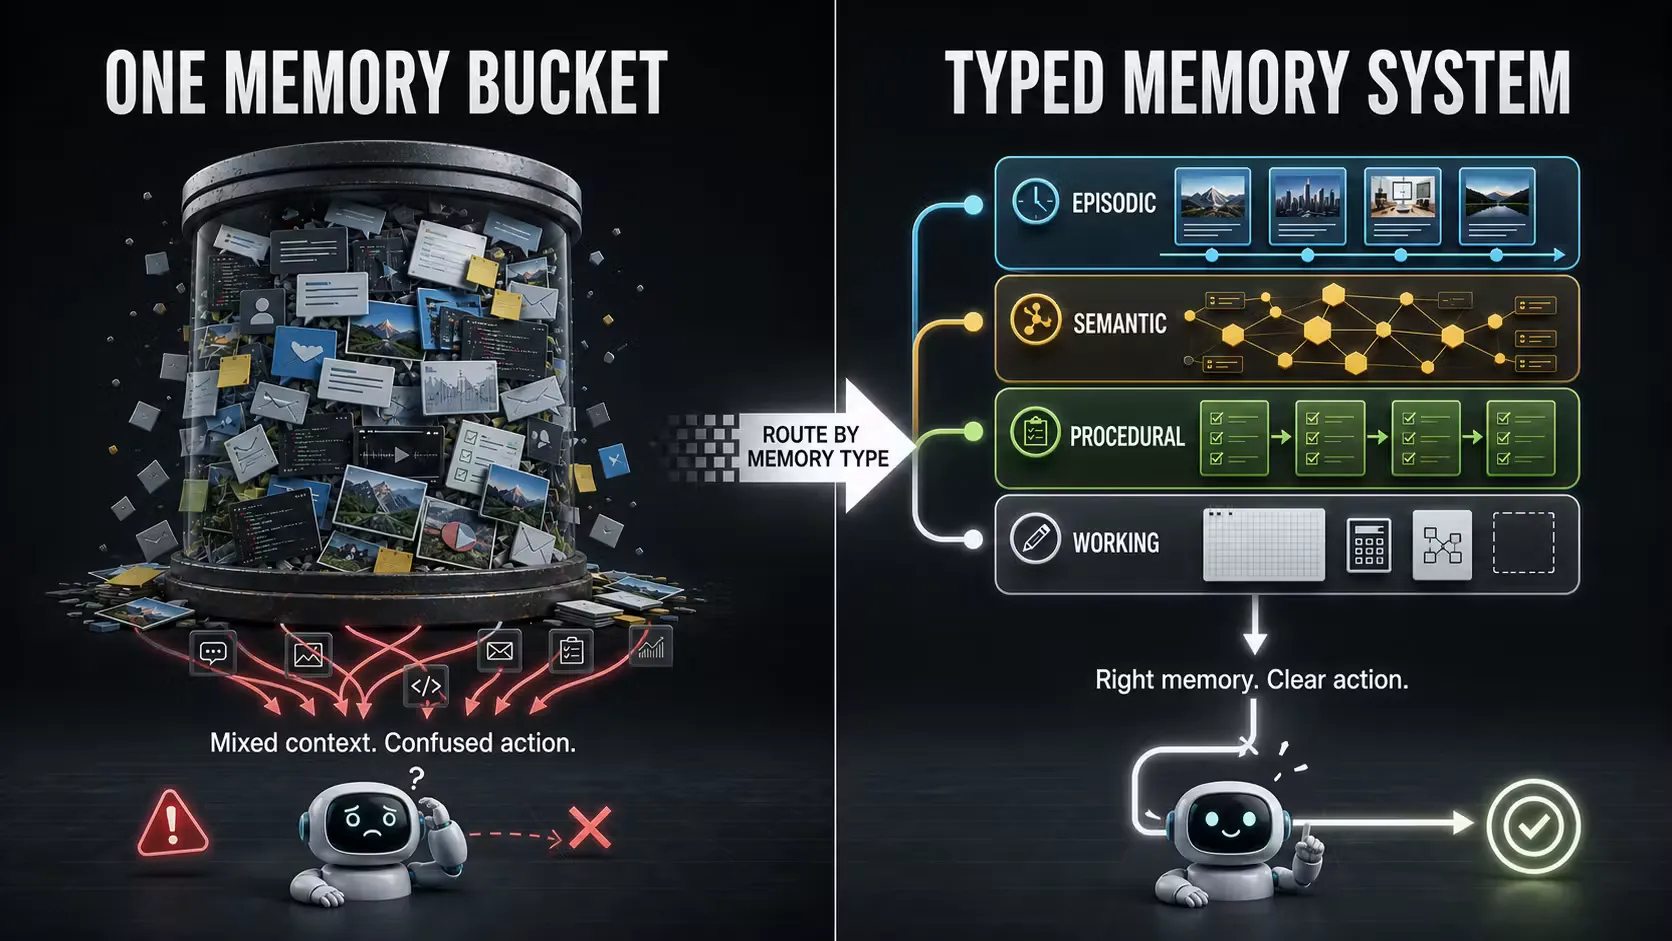
คำตอบที่ได้ผลในโลก production คือทำให้โมเดล LLM เป็นแกน stateless แล้วล้อมด้วย runtime แบบ stateful ที่รับผิดชอบ session execution state persistence การเรียกใช้เครื่องมือ และการกู้คืน workflow เมื่อเลิกเรียกทุกอย่างว่า “memory” คำถามถัดไปคือ ใครเป็นเจ้าของ state จริงของแต่ละชนิด เช่น ระบบจ่ายเงิน ระบบลูกค้า หรือ agent เอง การจัดการ state ในระดับนี้ต้องอาศัยแนวคิดแบบวิศวกรรมระบบกระจาย เช่น timestamp เวอร์ชัน optimistic concurrency idempotency ธุรกรรม event log checkpoint lease ขอบเขตความสอดคล้อง และกติกาการ recovery ซึ่งให้ผลดีกว่าการเพิ่มขนาด context อย่างเดียว

ออกแบบ AI agent memory management ให้จำในสิ่งที่ควรจำ ไม่ใช่ทุกอย่าง
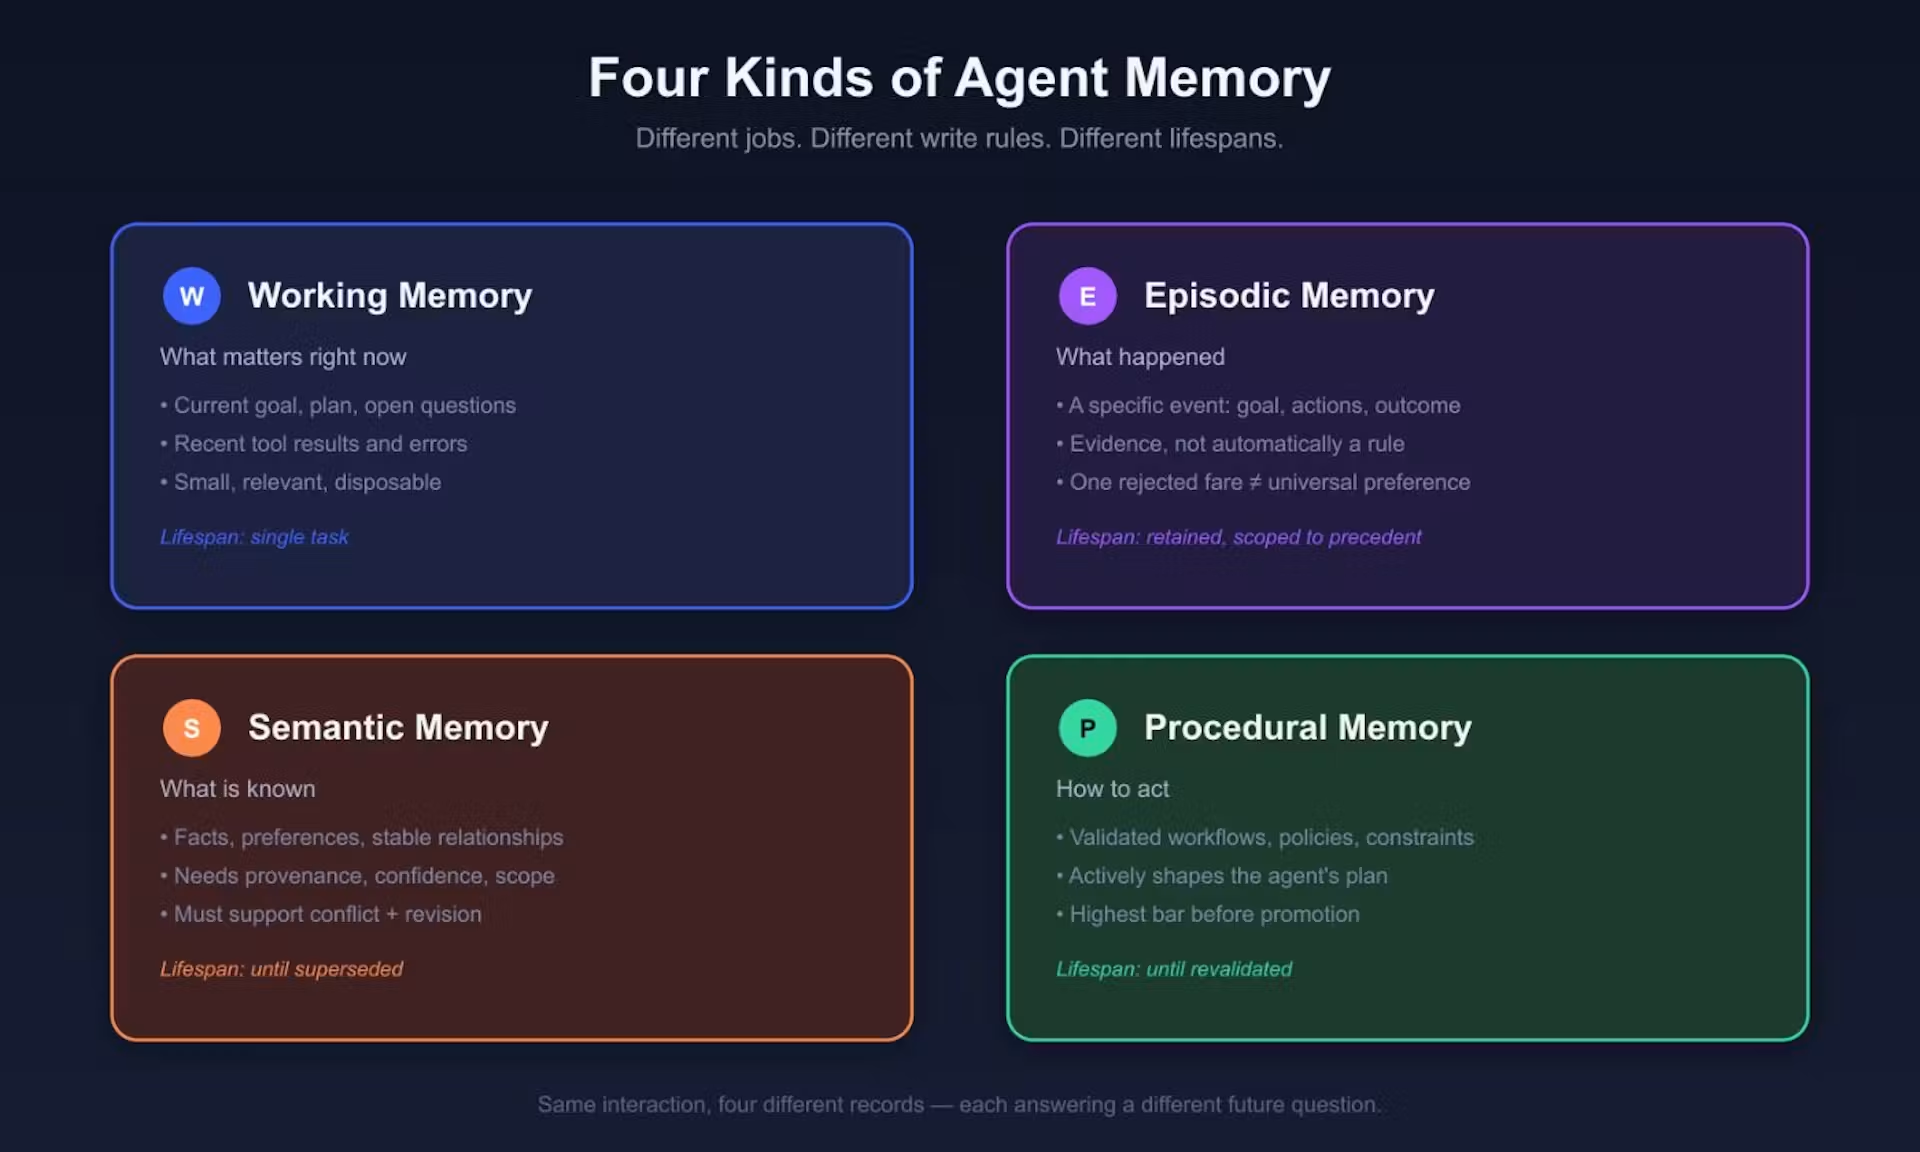
ปัญหาใหญ่ของ AI agent รุ่นแรกๆ คือเป็น stateless แทบทั้งหมด ต่อให้สนทนาดูเป็นธรรมชาติ แต่พอจบ session ทุกอย่างก็หายไป ตั้งแต่พื้นหลังผู้ใช้จนถึงเป้าหมายและคำแก้ไขต่างๆ ทำให้รู้สึกเหมือนเครื่องมือใช้ครั้งเดียวมากกว่าพันธมิตรที่เข้าใจเราต่อเนื่อง สิ่งที่ขาดไปคือ memory layer ซึ่งเป็นบริการที่ให้ agent เก็บ ดึง และใช้ context ข้ามการโต้ตอบได้ เพื่อไม่ต้องเริ่มจากศูนย์ทุกครั้ง
ระบบ AI agent memory management ที่ดีมักมีโฟลว์เหมือนกันคือ จับเหตุการณ์ที่เกิดขึ้น ตัดสินว่าอะไรควรถูกจำ แล้วแปลงเป็น record สำหรับใช้ในอนาคต เหตุการณ์เหล่านี้อาจเป็นข้อความ การแก้ไข การตัดสินใจ พร้อม metadata เช่น เวลา ผู้กระทำ และ context ของ session จากนั้นใช้กลยุทธ์เลือกว่าส่วนไหนควรถูกเก็บเป็นความรู้ ความชอบ หรือเป้าหมายระยะยาว เช่น ถ้าผู้ใช้ขอโค้ด agent ควรตรวจดูว่ามีภาษาที่ชอบถูกบันทึกไว้ไหม หรือก่อนแนะนำร้านอาหารควรตรวจดูข้อจำกัดด้านอาหารและสไตล์ที่ชอบก่อน แนวคิดนี้ทำให้ agent รู้สึก “รู้จักเรา” มากขึ้นโดยไม่ต้องสะสมทุกอย่างแบบไร้ขอบเขต
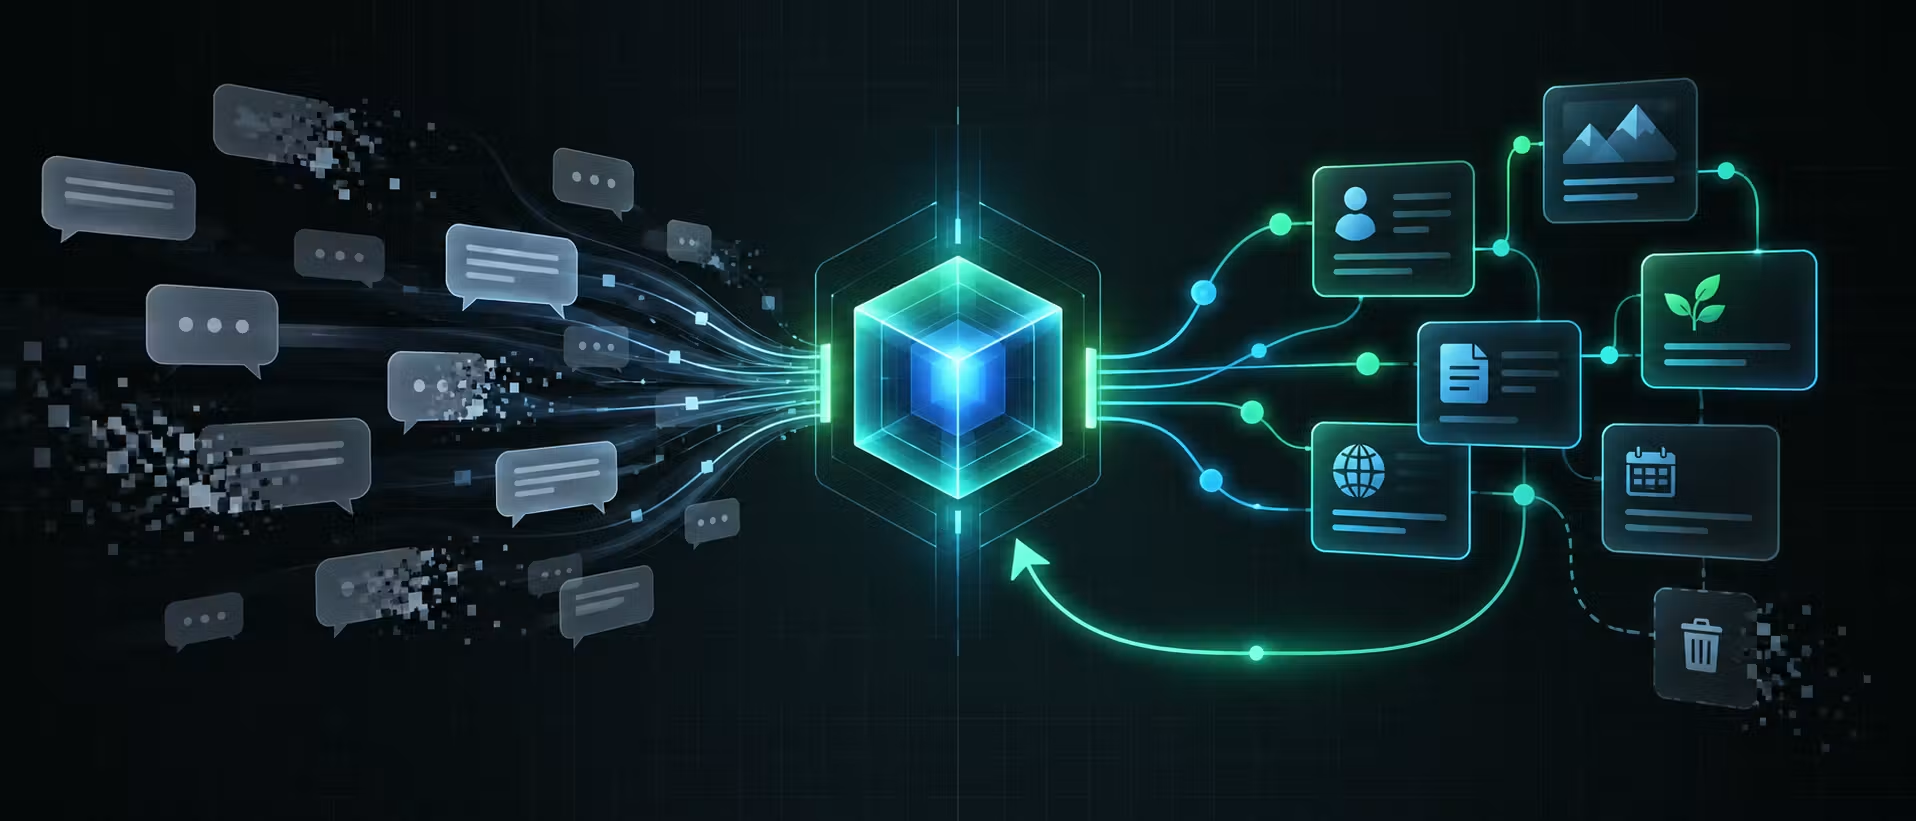
Context engineering และ FRESH Model ทำให้การจำของ agent ฉลาดขึ้น
หลายทีมมอง context compaction เป็นแค่การสรุปให้สั้นและอ่านง่าย แต่สำหรับระบบ production มุมมองนี้อันตราย เพราะสรุปที่อ่านลื่นอาจผิดในเชิงปฏิบัติได้ วิธีที่ดีกว่าคือ context engineering ที่บีบอัดข้อมูลไปเป็น typed state แทนการสรุปเชิงเล่าเรื่อง เพื่อบอกให้ชัดว่า state ตอนนี้คืออะไร ใครเป็นเจ้าของ สิทธิ์อยู่ที่ใคร และข้อจำกัดสำคัญยังคงอยู่หรือไม่ การจัดสรุปแบบนี้ทำให้เราทดสอบการถูกต้องได้ และตรวจ regression เมื่อ compactor ทำข้อมูลสำคัญหล่นได้ง่ายขึ้น
อีกปัญหาที่มักถูกมองข้ามคือ agent ถูกฝึกให้จำ แต่ไม่รู้ว่าเมื่อไรข้อมูลนั้นล้าสมัย ถูกแทนที่ หรืออ่อนไหวเกินกว่าจะเก็บต่อไป เช่น agent ที่ยังตอบตามนโยบายคืนเงินแบบเก่าเพราะจำบทสนทนาที่ครั้งหนึ่งเคยจริงอยู่ ทางออกไม่ใช่ “เก็บให้น้อยลง” เพราะบาง context ต้องอยู่ยาว แต่ต้องมองการเก็บเป็นการเลือกที่ต้องอธิบายได้ และมองการลบเป็นค่าเริ่มต้น ที่นี่ FRESH Memory Model จึงเป็นเช็กลิสต์ที่มีประโยชน์ ก่อนให้ memory ใดมีผลต่อการตัดสินใจเราควรถามว่า F มีความสดใหม่แค่ไหน R มาจากแหล่งที่เชื่อถือได้ไหม E ควรหมดอายุเมื่อไร S มีข้อมูลใหม่กว่านี้หรือยัง และ H ถ้าจำผิดแล้วจะเกิดผลเสียแค่ไหน
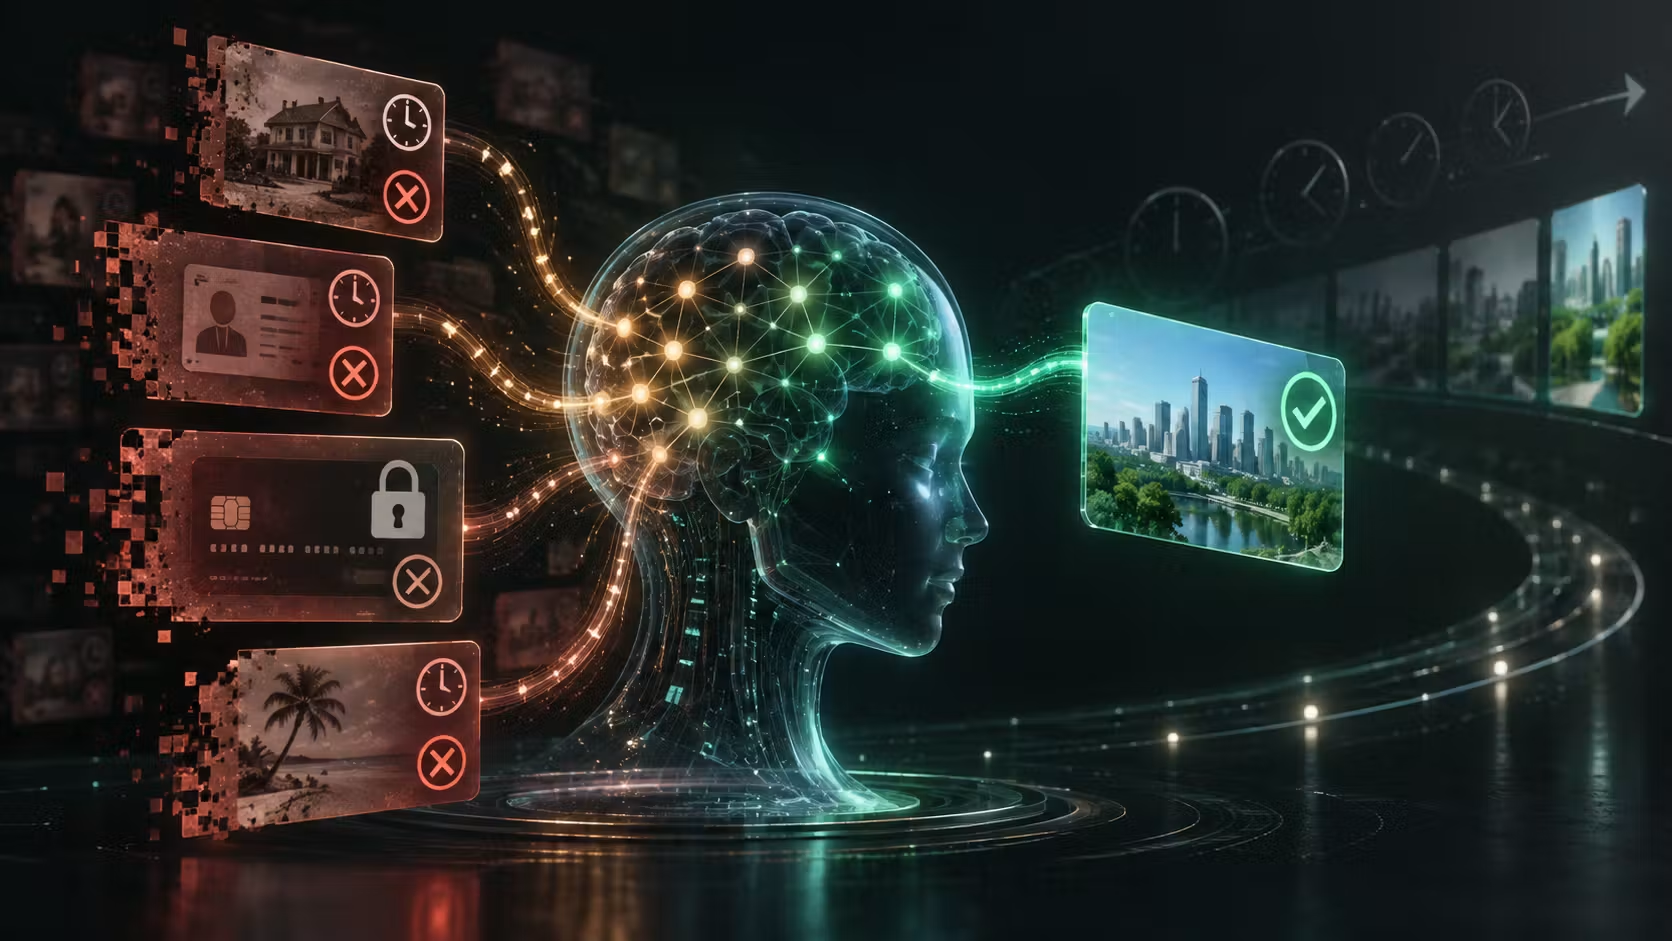
จาก “เพิ่มความจำ” ไปสู่ “จัดการ state ทั้งระบบ”
เบื้องหลัง incident ส่วนใหญ่ของ AI agent ในโลกจริง เช่น ถามข้อมูลซ้ำ ทำผิดข้อกำหนด หรือเมินสัญญาที่ให้ไว้ก่อนหน้า ไม่ได้เกิดจากโมเดลหลอนเพียงอย่างเดียว แต่เกิดจากการจัดการ context และ state ที่ทำให้ข้อมูลสำคัญหล่นระหว่างทาง การแก้ไขที่ยั่งยืนจึงไม่ใช่แค่เพิ่มขนาด context window เพิ่ม vector database หรือสาด long-term memory เข้าไปทุกที่ แต่ต้องออกแบบ state management ให้รับมือกับ concurrency การกู้ workflow และการเชื่อมกับโลกจริงอย่างเป็นสถาปัตยกรรม พร้อมทั้งทำให้ AI agent information retention เป็นเรื่องของนโยบาย ไม่ใช่ side effect ของการเก็บทุกอย่าง
ในมุมคนออกแบบระบบ ผลลัพธ์ที่ต้องการไม่ใช่ agent ที่จำทุกอย่างตลอดไป แต่คือ agent ที่จำสิ่งสำคัญเท่าที่ “จำเป็นต้องจริงในตอนนี้” และรู้ว่าจะกลับไปถามใครเมื่อสงสัยว่าจะยังจริงอยู่ไหม การย้ายจากแนวคิด “เพิ่มความจำเพื่อแก้ปัญหา” ไปสู่ “สร้างสถาปัตยกรรมจัดการ state รอบโมเดล” ทำให้เราสามารถออกแบบ AI agent ที่น่าเชื่อถือกว่า ปลอดภัยกว่า และเป็นคู่คิดระยะยาวได้ โดยไม่ต้องเผาโทเคนและทรัพยากรทิ้งไปกับความทรงจำที่ไม่มีวันได้ใช้