
ความแม่นยำ 91.67% ไม่ได้แปลว่า AI พร้อมใช้งานจริง
การปรับใช้ AI ในโลกธุรกิจหมายถึงกระบวนการนำโมเดลที่ผ่านการทดสอบทางเทคนิคมาฝังเข้าในขั้นตอนทำงานจริงขององค์กร ตั้งแต่การรับข้อมูล การตัดสินใจของโมเดล ไปจนถึงการเชื่อมผลลัพธ์กับคน ระบบ และตัวชี้วัดธุรกิจ ความสำเร็จจึงไม่ได้วัดจากความแม่นยำ AI ในการทดสอบเพียงอย่างเดียว แต่ต้องดูว่า AI ทำงานได้สอดคล้องกับบริบทธุรกิจ มีเสถียรภาพ และสร้างคุณค่าอย่างต่อเนื่องภายใต้ข้อจำกัดของระบบจริงที่มีความยุ่งเหยิงและเปลี่ยนแปลงตลอดเวลา กรณีหนึ่งเริ่มจากการให้ทีมงานแคปหน้าจอรีวิวลูกค้าบนหน้าแรก ส่งเข้าโมเดล และประมาณการปริมาณรีวิวรายเดือนแบบหยาบๆ เพื่อใช้วิเคราะห์คู่แข่ง ตัวเลขที่ได้ดูแม่นยำแต่กระบวนการกลับอ่อนแอ เมื่อพัฒนาเป็น workflow ระยะผลิตที่ทำงานทุกคืนครอบคลุมจากเดิมราว 5 บริษัทใน 2 ตลาด ไปเป็น 14 บริษัทใน 3 ตลาด ปัญหาก็โผล่ทันที ทั้ง timeout rate limit และแรงกดดันด้านหน่วยความจำ นี่คือสัญญาณชัดว่าแม่นยายในชุดทดสอบไม่เท่ากับพร้อมรับภาระในระบบจริง
จากสกรีนช็อตสู่ระบบ AI ในการผลิต: เมื่อคะแนนสวยแต่ความเสี่ยงซ่อนอยู่
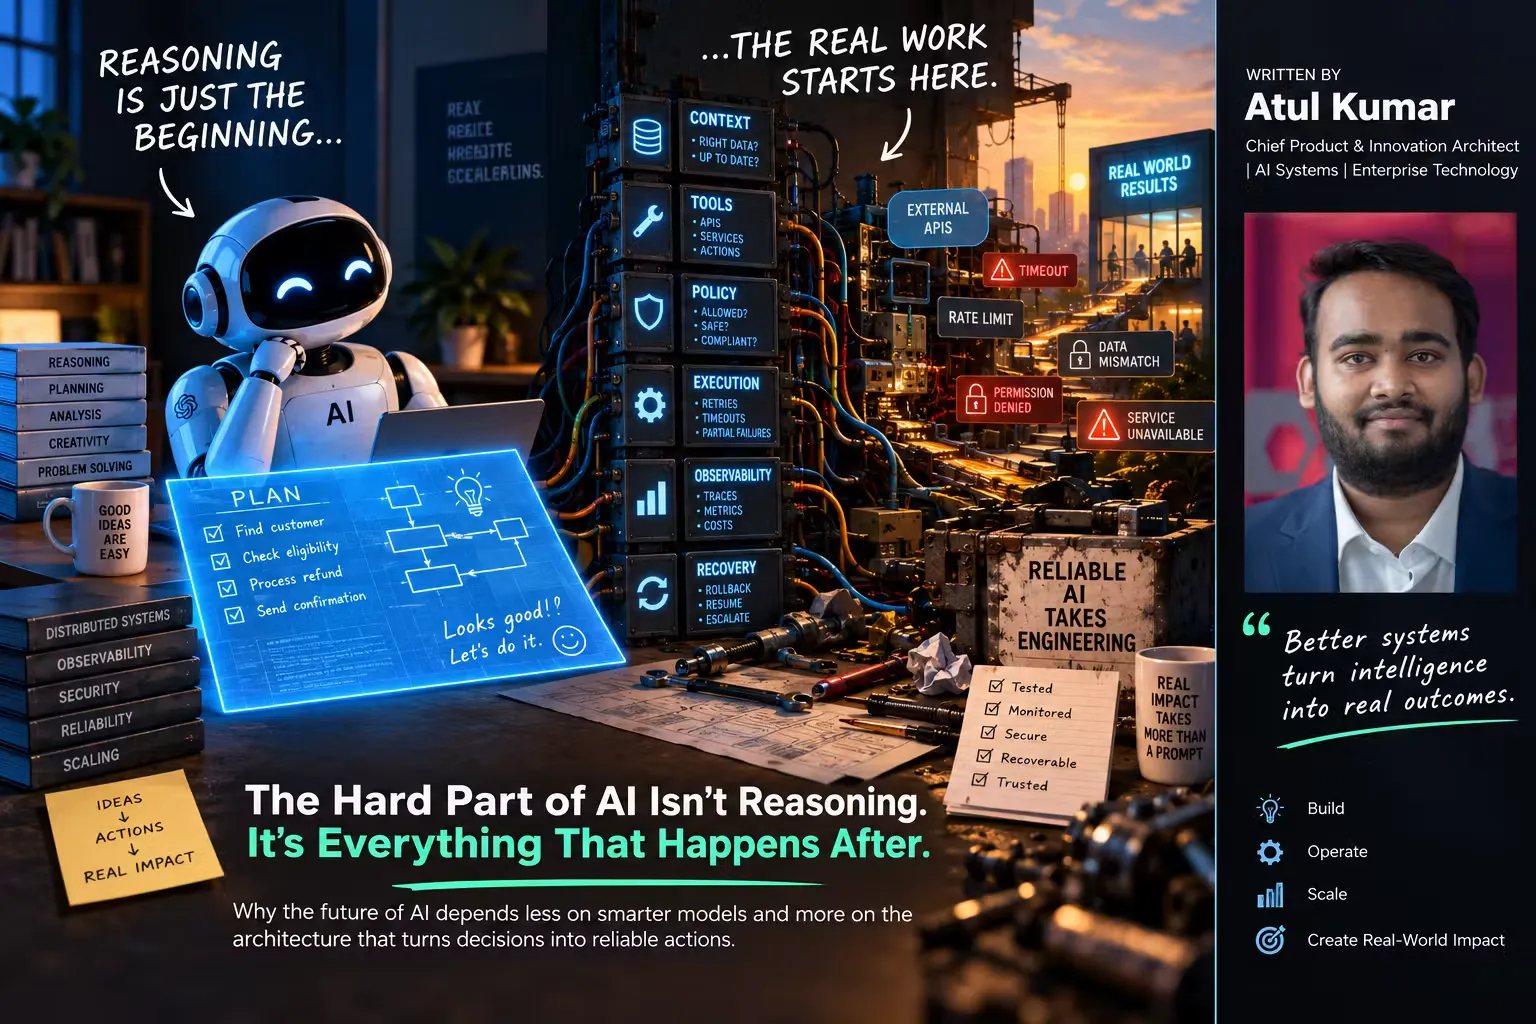
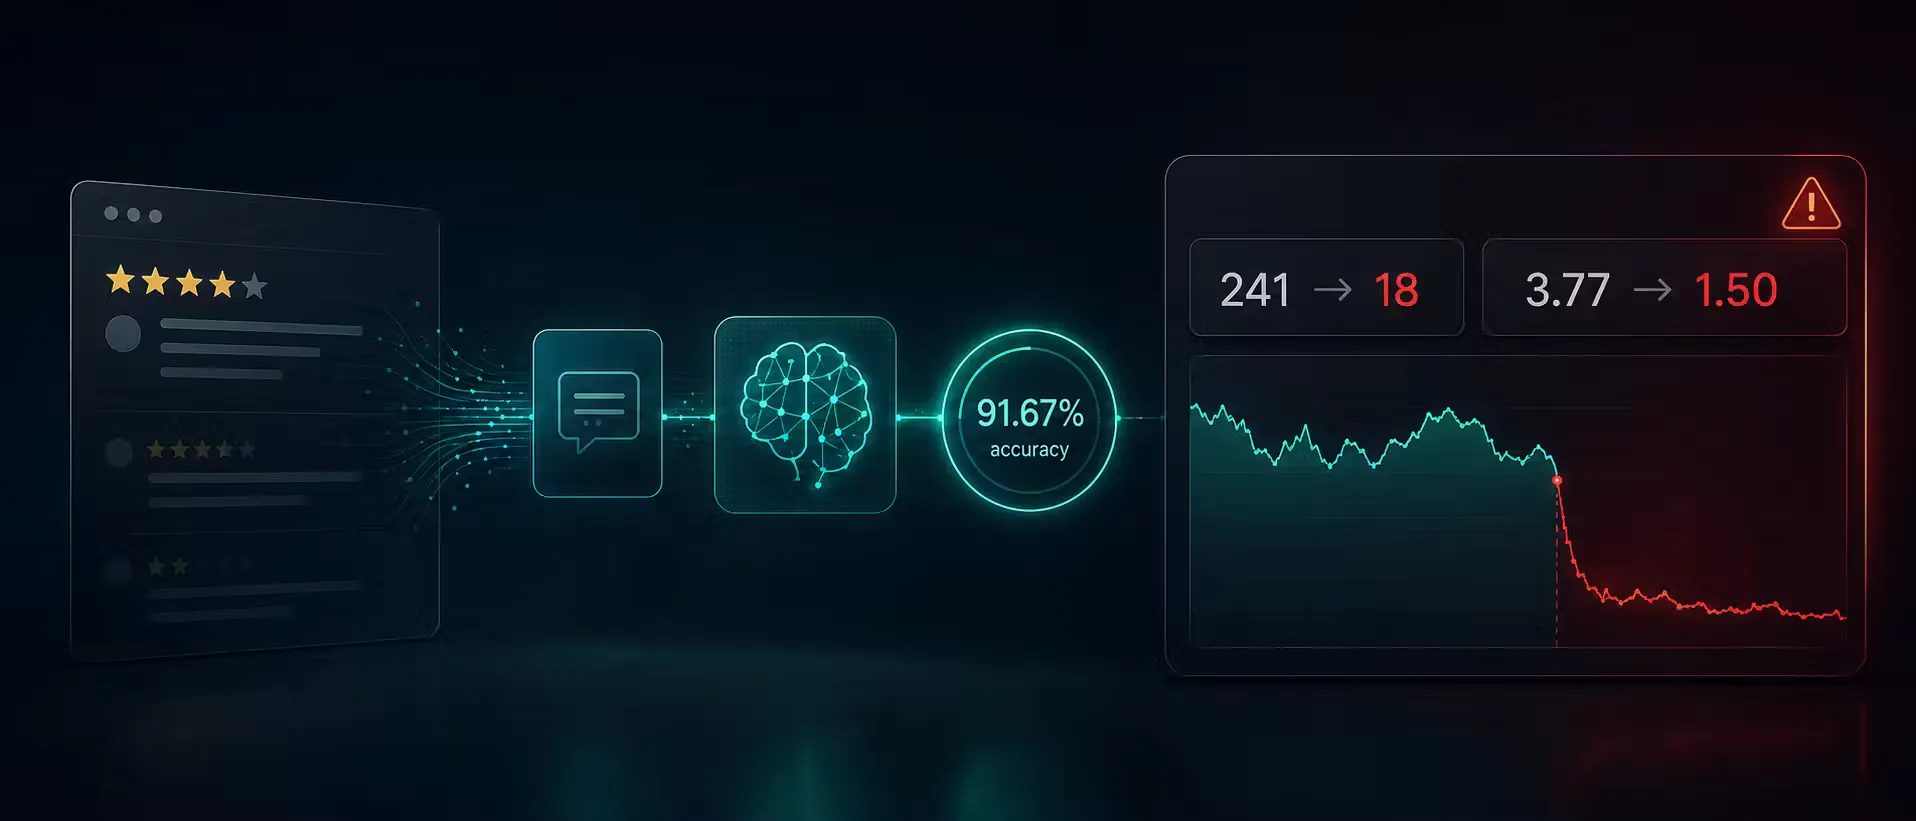
เมื่อทีมย้ายจากการส่งรีวิวทีละชิ้นไปสู่ pipeline ที่ใช้โมเดลจัดหมวดหมู่รีวิวเป็นรายแบทช์ การออกแบบกระบวนการกลับเป็นเรื่องยากกว่าออกแบบตัวโมเดลเอง การเรียกโมเดลทีละรีวิวทนภาระของการทดสอบขนาดเล็กได้ แต่พอขยายขึ้นก็ชนข้อจำกัดด้านเวลาและทรัพยากรจนต้องเปลี่ยนเป็นประมาณ 20 รีวิวต่อคำขอจึงเริ่มนิ่ง ที่สำคัญคือการแยก job ใหญ่เป็น subflow เล็กๆ ทำให้ความเชื่อถือของระบบดีขึ้นโดยไม่จำเป็นต้องเปลี่ยนโมเดลเลย จึงชัดว่าความท้าทายของระบบ AI ในการผลิตอยู่ที่ workflow และโครงสร้างงาน ไม่ใช่แค่สมองของโมเดล เมื่อมาประเมินความแม่นยำ AI ในการทดสอบด้วยตัวอย่างรีวิว 300 รายการ ทีมตั้งเกณฑ์รับได้ที่ 85 เปอร์เซ็นต์ แต่โมเดลกลับทำคะแนนรวมได้ถึง 91.67 เปอร์เซ็นต์ หรือ 275 จาก 300 ป้ายอารมณ์ตรงกับค่าอ้างอิง ประโยคที่ควรหยิบมาอ้างได้คือ "Sentiment accuracy is 91.67%" ทว่าภาพสวยนี้หลอกตา เพราะโมเดลทำได้ดีมากในรีวิวเชิงบวกและลบ แต่ทำได้แย่ในรีวิวกลางๆ จน F1 ของ neutral เหลือเพียง 0.62 และเรียกรีวิวกลางไปผิดถัง ส่งผลให้แดชบอร์ดแสดงตลาดรุนแรงกว่าความจริง
เมตริกห้องทดลอง vs เมตริกโลกจริง: บทเรียนจากเคสสุขภาพ
ช่องว่างระหว่างตัวเลขในห้องทดลองกับผลลัพธ์ในโลกจริงไม่ได้เกิดเฉพาะในงานรีวิวลูกค้า แต่เห็นชัดในโลกทดสอบซอฟต์แวร์ด้วย ผลสำรวจ QA 302 คนพบว่า 88 เปอร์เซ็นต์มอง AI เป็นหัวใจของกลยุทธ์การทดสอบในอนาคต แต่มีเพียง 12.6 เปอร์เซ็นต์ที่ใช้จริงในกิจกรรมทดสอบหลักวันนี้ นี่ไม่ใช่หลักฐานว่า AI ล้มเหลว แต่สะท้อนว่ามีช่องว่างขนาดใหญ่ระหว่างความคาดหวังกับการปรับใช้ AI จริง กรณี health tech หนึ่งให้บทเรียนขม ทีมรัน pilot หกสัปดาห์กับ flow รับข้อมูลที่จัดเอกสารดีมาก ผลคือชุดทดสอบที่สร้างขึ้นแทบไม่ต้องแก้และยังเจอ defect ระดับรุนแรงกลาง 3 เคสที่การทดสอบมือเดิมมองไม่เห็น ผู้นำเห็นตัวเลขก็อนุมัติ rollout กระโดดจาก pilot สู่ 12 flow ภายในสองสัปดาห์โดยข้ามขั้น scaling ทั้งหมด พอผ่านสามสัปดาห์ QA กลับต้องใช้เวลามากกว่า 40 เปอร์เซ็นต์ไปกับการแก้ชุดทดสอบที่ AI สร้าง แทนที่จะเขียนชุดใหม่ ความมั่นใจใน AI จึงร่วงวูบ ทั้งที่ pilot ไม่เคยถูกออกแบบมาเพื่อตอบคำถามว่า ระบบจะอยู่รอดเมื่อใช้ครอบคลุม flow ที่ยุ่งเหยิงและเอกสารขาดๆ
ความสำเร็จสามระยะ: ทำไมองค์กรถึงล้มเหลวเมื่อรีบข้ามขั้น
ปัญหาหลักของความล้มเหลวของโครงการ AI ไม่ใช่เหตุนอกระบบ แต่เกิดจากการเอาเกณฑ์ผิดไปวัดผิดเฟส Pilot มีหน้าที่ตอบคำถามง่ายว่า เครื่องมือ AI สร้างผลลัพธ์ที่เชื่อถือได้ใน flow ที่อยู่ในขอบเขตหรือไม่ โดยมักเริ่มจากหนึ่งทีมหนึ่ง flow ที่เอกสารดีและความเสี่ยงพอรับได้ หากผ่านจุดนี้ต้องโยกไปเฟส scaling ที่หลายทีมใช้ AI กับหลาย flow ที่ซับซ้อนขึ้น เพื่อดูว่าค่า acceptance rate ของผลลัพธ์ยังดี และค่า defect ทดสอบเปรียบเทียบกับวิธี manual เดิมยังคุ้มค่า เมื่อเข้าสู่ระยะ scaled หรือ rollout องค์กรควรวัดความสำเร็จจาก defect escape rate ทั้งพอร์ต ไม่ใช่แค่ flow ที่เคยอยู่ใน pilot และต้องดูว่าทีมยังสามารถใช้ AI โดยไม่ให้ภาระการดูแลชุดทดสอบกินทับผลิตภาพ ประโยคที่ควรจำคือ "A passing pilot is just a starting point Do not treat it as a production readiness certificate" การข้ามขั้น scaling จึงเปรียบเหมือนการนำเครื่องมือผ่านทดสอบห้องทดลองไปเปิดใช้งานโรงงานใหญ่โดยไม่ผ่านการทดสอบภาคสนาม ผลคือความล้มเหลวไม่เกี่ยวกับความสามารถของโมเดล แต่เกี่ยวกับกระบวนการตัดสินใจของคน
จากโมเดลเก่งสู่ระบบที่เชื่อถือได้: ทางออกขององค์กรที่อยากใช้ AI จริง
บทเรียนจากทั้งโลกรีวิวลูกค้าและโลกทดสอบซอฟต์แวร์บอกตรงกันว่า AI ที่ผ่านการทดสอบด้วยตัวเลขงามๆ ยังห่างไกลจากคำว่า "พร้อมใช้งานจริง" เพราะเมตริกอย่างความแม่นยำ 91.67 เปอร์เซ็นต์วัดแค่ความตรงระหว่างป้ายโมเดลกับชุดอ้างอิง ไม่ได้ตอบว่าข้อมูลต้นทางครบไหม แหล่งข้อมูลเปลี่ยนไปหรือไม่ หรือสัญญาณรวมที่แปลกไปแปลว่าอะไรทางธุรกิจ ในเคสรีวิว เมื่อปริมาณรีวิวรายเดือนของบริษัทหนึ่งดิ่งจาก 241 เหลือ 18 หรือร่วงถึง 92.5 เปอร์เซ็นต์ พร้อมคะแนนเฉลี่ยร่วงจาก 3.77 เหลือ 1.50 ดาว ซึ่งต่างกันถึง 2.27 ดาว ตัวเลขแรงแบบนี้จะอันตรายมากถ้าองค์กรไม่มีระบบตรวจแหล่งที่มาและบริบทว่าเกิดจากพฤติกรรมตลาดหรือปัญหาการเก็บข้อมูล ทางออกคือองค์กรต้องลงทุนในระบบที่ออกแบบมาเพื่อรองรับบริบทธุรกิจ การเชื่อมต่อข้อมูล และการติดตามคุณภาพอย่างต่อเนื่อง ไม่ใช่โฟกัสที่การปั้นโมเดลให้เก่งที่สุดเพียงจุดเดียว ระบบควรแยกชั้นโมเดลออกจากผลิตภัณฑ์ให้ส่วนอื่นไม่ต้องรู้ว่าเบื้องหลังใช้โมเดลใด และวางกระบวนการที่สามารถปรับ taxonomy ตรวจป้ายอ้างอิงใหม่ รันการประเมินหลังปรับ prompt และแยกผลตามภาษาและตลาด สุดท้ายแล้ว AI ที่ประสบความสำเร็จในโลกธุรกิจไม่ใช่ AI ที่แม่นที่สุดในห้องทดลอง แต่คือ AI ที่ผสานเข้าใน workflow ที่เชื่อถือได้ มีเมตริกถูกต้องในแต่ละเฟส และได้รับการดูแลเหมือนโครงสร้างพื้นฐานทางธุรกิจไม่ใช่ของเล่นทดลอง