
ราคาโทเคนเท่ากัน ไม่ได้แปลว่าบิลเท่ากัน
ต้นทุนต่อชิ้นงานของโมเดล AI คือค่าใช้จ่ายรวมที่เกิดขึ้นจนงานหนึ่งชิ้นเสร็จ โดยขึ้นกับทั้งปริมาณข้อมูลที่ป้อน จำนวนข้อความที่โมเดลสร้าง และการแก้ไขซ้ำ ไม่ใช่ราคาต่อโทเคนเพียงอย่างเดียว เมื่อต้องเปรียบเทียบโมเดล AI จึงควรถามว่าแต่ละตัวทำงานเป้าหมายสำเร็จด้วยต้นทุนและคุณภาพแบบใด
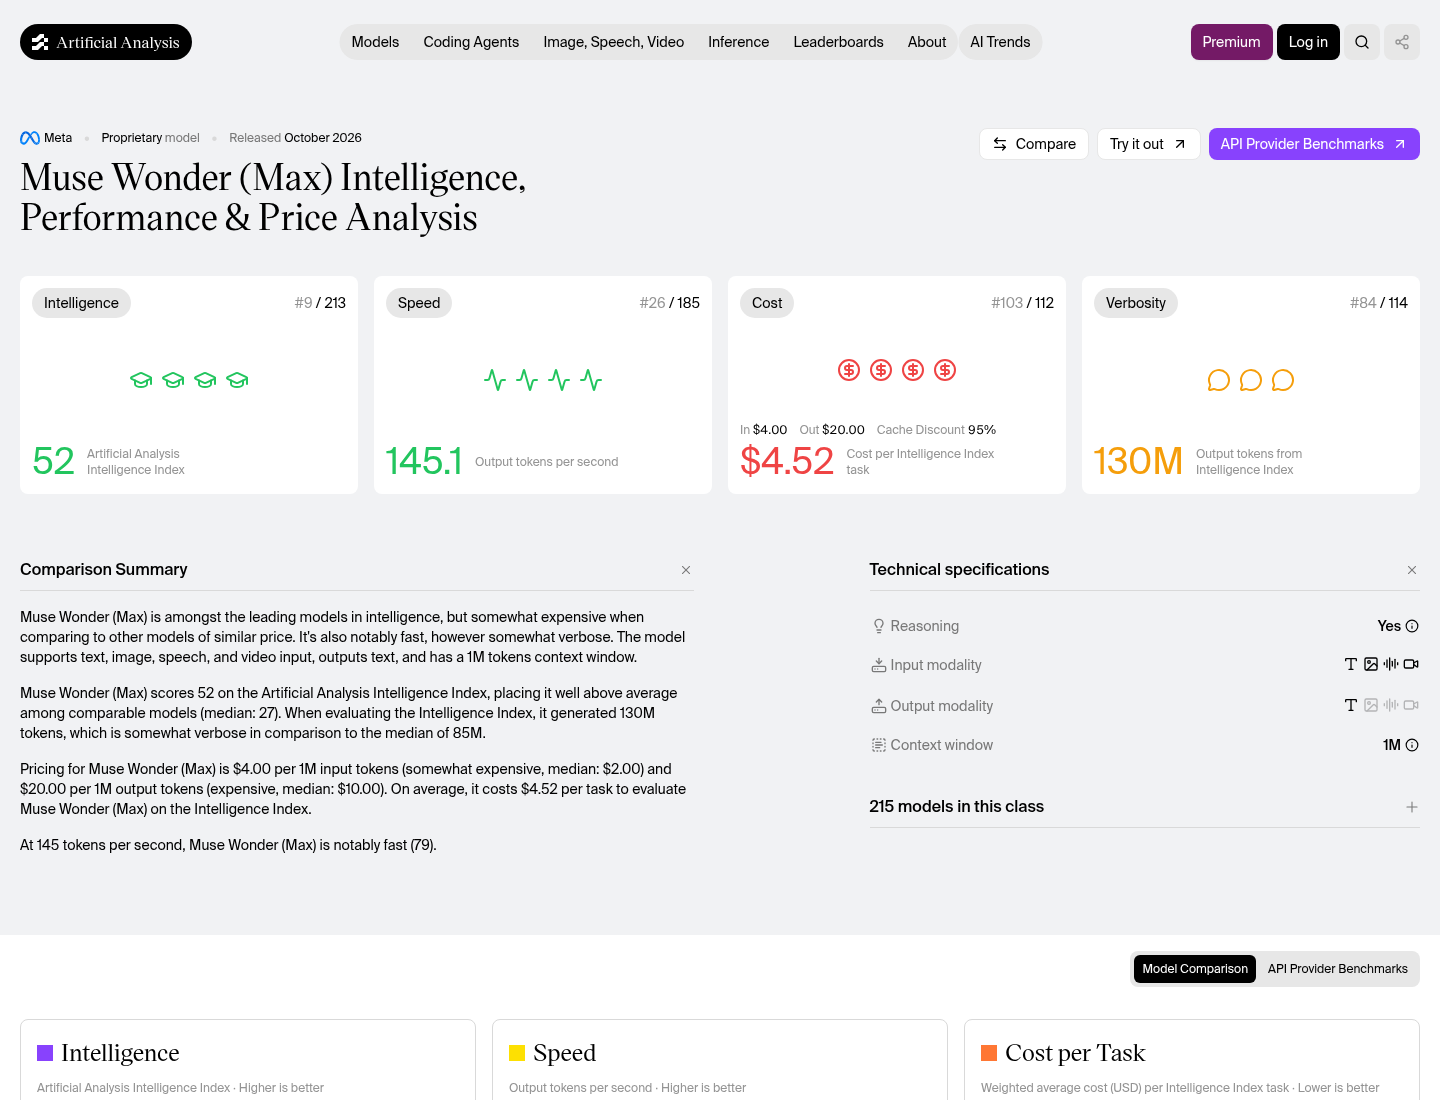
Muse Wonder กับ GPT-5.6 Sol เป็นตัวอย่างชัดเจน เพราะมีราคาโทเคนและบริบทสูงสุดใกล้เคียงกัน แต่การประเมินงานดัชนีหนึ่งชุดพบว่าต้นทุนของ Muse Wonder สูงกว่า GPT-5.6 Sol มากกว่าสองเท่า โดยอยู่ที่ประมาณ 4.52 ดอลลาร์ เทียบกับ 1.99 ดอลลาร์ แม้ Muse Wonder ได้คะแนน Intelligence Index 52 และอันดับ 9 จาก 213 ส่วน Sol ได้ 47 และอันดับ 27 จาก 213
สาเหตุสำคัญคือ Muse Wonder ใช้โทเคนเอาต์พุตราว 130 ล้านโทเคนในงานประเมิน เทียบกับค่ามัธยฐาน 85 ล้านโทเคน จึงสร้างบิลสูงแม้เรตราคาต่อโทเคนเท่ากัน จุดเด่นของ Muse Wonder คือคะแนนดัชนีและความเร็ว ขณะที่ Sol มีต้นทุนต่อภารกิจต่ำกว่าและผ่านการใช้งานมานานกว่า แต่ Sol ถูกแทนที่ในตระกูลรุ่นแล้ว ส่วนผลทดสอบอิสระของ Muse Wonder ยังมีจำกัด
| ประเด็น | Muse Wonder | GPT-5.6 Sol |
|---|---|---|
| ราคาอินพุตและเอาต์พุตต่อล้านโทเคน | 4.00 และ 20.00 ดอลลาร์ | 4.00 และ 20.00 ดอลลาร์ |
| ต้นทุนภารกิจดัชนีหนึ่งชุด | ประมาณ 4.52 ดอลลาร์ | ประมาณ 1.99 ดอลลาร์ |
| Intelligence Index | 52 คะแนน อันดับ 9 จาก 213 | 47 คะแนน อันดับ 27 จาก 213 |
| บริบท | 1 ล้านโทเคน | ประมาณ 1.05 ล้านโทเคน |
| ข้อสังเกต | ใช้เอาต์พุตราว 130 ล้านโทเคนในงานประเมิน | มีประวัติใช้งานจริงนานกว่า แต่ถูกแทนที่แล้ว |
หากงานของคุณต้องการคำตอบคุณภาพสูงและความเร็ว Muse Wonder น่าสนใจ แต่ควรทดสอบจำนวนโทเคนจริงก่อนเปิดใช้ในวงกว้าง ส่วนงานที่ทำซ้ำบ่อยและต้องควบคุมค่าใช้จ่าย Sol เป็นตัวเลือกที่ประหยัดกว่าในผลประเมินนี้ ทั้งนี้คะแนนสูงกว่าไม่ได้รับประกันว่าคุ้มกว่าในทุกงาน
Mercury 3 แลกความเร็วกับหลักฐานที่ยังไม่ครบ
Mercury 3 วางจุดขายไว้ที่การตอบสนองรวดเร็วและบริบทขนาดใหญ่ โดยเป็นโมเดลแบบ diffusion ที่สร้างข้อความหลายโทเคนพร้อมกันแล้วค่อยปรับปรุง แทนการสร้างทีละโทเคน รุ่นนี้มีบริบทหนึ่งล้านโทเคน และผู้พัฒนารายงานความเร็ว 1,068 โทเคนต่อวินาที เทียบกับประมาณ 130 ของ GPT-6 Luna และ 240 ของ Claude Haiku 5.5
ในชุดทดสอบที่ผู้พัฒนานำเสนอ Mercury 3 ชนะ 8 จาก 12 รายการ และได้คะแนน GDPval แบบ Elo 1,237.2, MultiChallenge 60.35 และ DeepSearchQA 71.33 แต่ยังตาม Haiku 5.5 ใน DeepSWE ซึ่งวัดงานเขียนโค้ดหลายขั้นตอน และตามในชุดทดสอบบริบทยาวบางรายการ เช่น MRCR v2 และ AA-LCR
ตัวเลขเหล่านี้ยังต้องอ่านอย่างระมัดระวัง เพราะยังไม่มีผลประเมินจากภายนอกมายืนยัน Mercury 3 ความเร็วสูงจึงเป็นเหตุผลให้ทดลองกับงานที่การรอสะสมเป็นต้นทุน เช่น เอเจนต์เบราว์เซอร์หรือขั้นตอนตอบโต้ต่อเนื่อง ไม่ใช่หลักฐานว่าโมเดลนี้มีต้นทุนรวมต่ำที่สุด
ราคาที่เห็นในช่วงโปรโมชันอาจทำให้ Mercury 3 ดูคุ้มกว่าราคาปกติ จึงควรตรวจสอบเงื่อนไขและช่วงเวลาของข้อเสนอ รวมทั้งคำนวณต้นทุนหลังสิ้นสุดโปรโมชันก่อนตัดสินใจ เพราะการเปรียบเทียบราคาโมเดล AI ที่ยุติธรรมต้องใช้ราคาที่ทีมจะจ่ายจริงตลอดช่วงใช้งาน ไม่ใช่เฉพาะราคาเริ่มต้น
Terra ประหยัดกว่า ส่วน Opus เด่นในงานที่ต้องใช้ความสามารถสูง
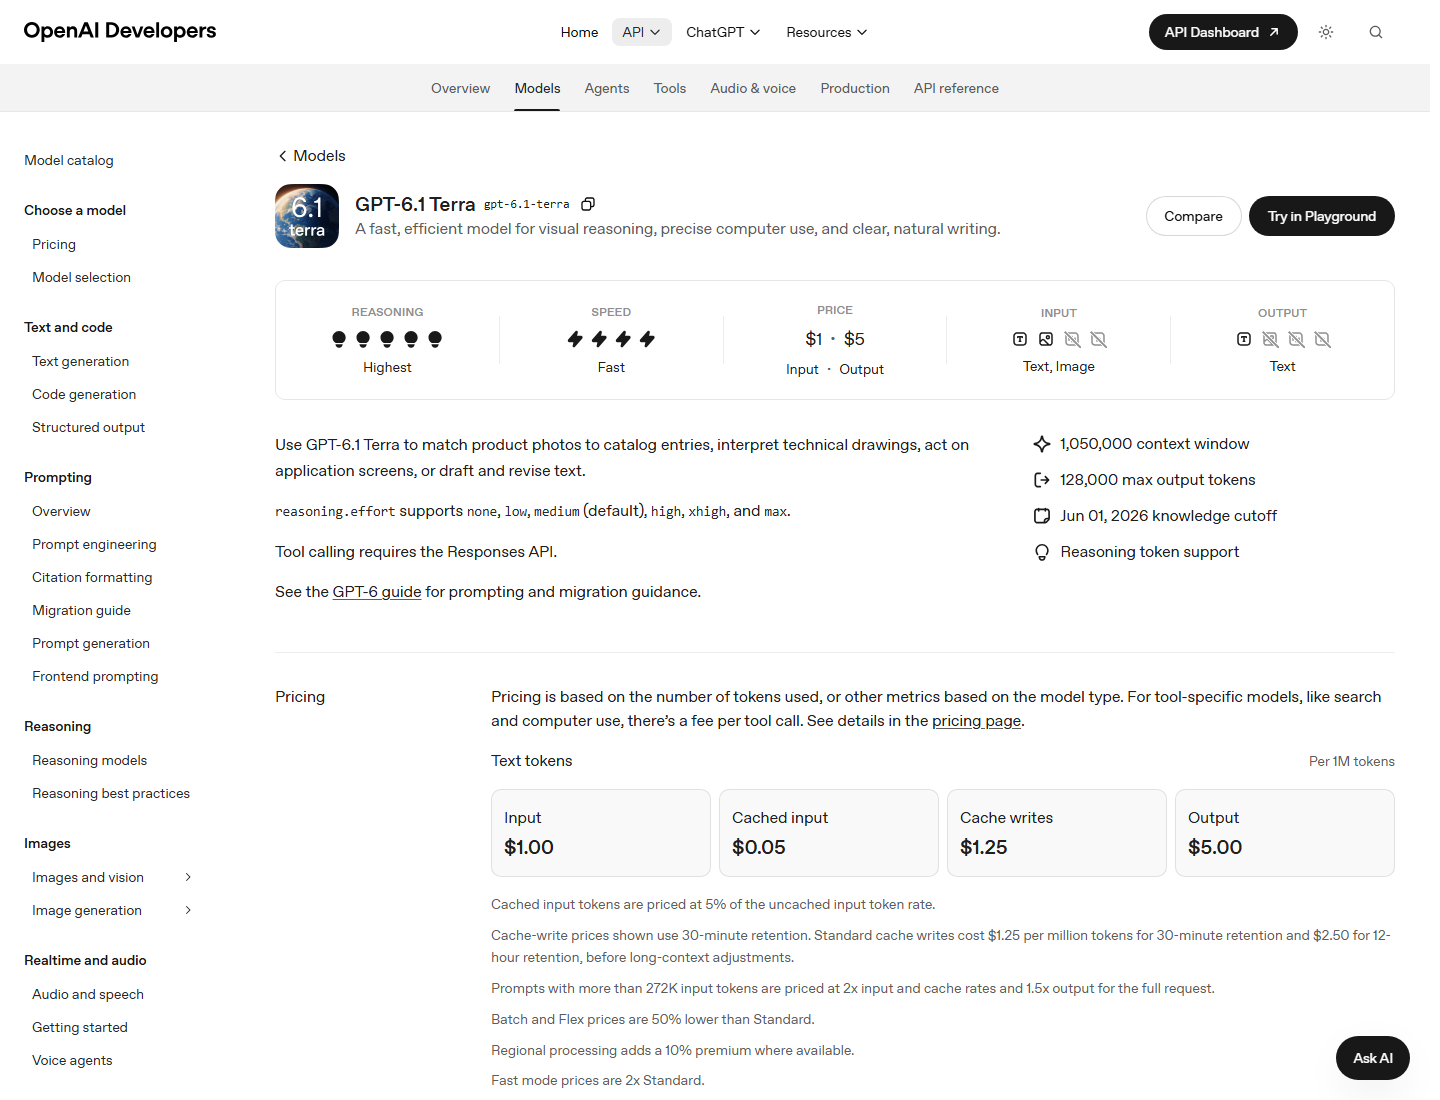
GPT-6.1 Terra กับ Claude Opus 5.5 แสดงให้เห็นอีกด้านของการชั่งน้ำหนักราคาและคุณภาพ Terra ได้ Intelligence Index 48 ส่วน Opus 5.5 ได้ 58 คะแนนและอยู่ในอันดับสูงสุดของกลุ่มที่นำมาเปรียบเทียบ อย่างไรก็ตาม Terra มีราคาต่อโทเคนต่ำกว่า Opus ในข้อมูลต้นทาง จึงเหมาะเป็นตัวเลือกสำหรับงานปริมาณมากที่คุณภาพของผลลัพธ์ยังผ่านเกณฑ์ทีม
ช่องว่างไม่ได้เท่ากันทุกประเภทงาน บน OSWorld 2.1 ซึ่งทดสอบการใช้งานคอมพิวเตอร์ Opus ได้ 81.8% และ Terra ได้ 74.2% ห่างกัน 7.6 จุด หากงานหลักเป็นระบบอัตโนมัติบนเดสก์ท็อป Terra จึงอาจใกล้พอให้ความประหยัดเป็นตัวตัดสิน แต่เมื่องานต้องให้เหตุผลหนัก เขียนโค้ด หรือทำงานเอเจนต์ต่อเนื่อง คะแนนดัชนีที่ Opus นำอยู่สิบคะแนนอาจคุ้มกับการจ่ายเพิ่ม
อย่าตัดสินจากคะแนน benchmark AI โดยไม่ลองงานจริง เพราะดัชนีรวมไม่ได้บอกอัตราความล้มเหลว ต้นทุนแก้งาน หรือเวลาที่ทีมต้องใช้ตรวจคำตอบ โมเดลที่เหมาะคือโมเดลที่ทำงานผ่านเกณฑ์ของคุณได้สม่ำเสมอ และมีภาระตรวจสอบที่ทีมรับได้ แม้จะไม่ได้เป็นอันดับหนึ่ง
ก่อนเลือก ควรทดสอบชุดงานเดียวกันบนแต่ละโมเดล แล้วบันทึกจำนวนโทเคน เวลารอ จำนวนครั้งที่ต้องลองใหม่ และสัดส่วนคำตอบที่ต้องแก้ วิธีนี้จะเปลี่ยนการเทียบราคาโทเคนให้เป็นการเทียบต้นทุนต่อชิ้นงานจริง พร้อมเผยให้เห็นว่าคะแนนที่เพิ่มขึ้นช่วยลดเวลาและความผิดพลาดได้คุ้มค่าหรือไม่
Buy if / Skip if
- Buy the Muse Wonder if งานของคุณให้ความสำคัญกับคะแนนดัชนีและการตอบสนองเร็ว และคุณพร้อมวัดปริมาณโทเคนจริงก่อนขยายการใช้งาน
- Skip the Muse Wonder if ปริมาณงานสูงและต้องควบคุมต้นทุนต่อชิ้นงานอย่างเข้มงวด โดยยังไม่ผ่านการทดสอบค่าใช้จ่ายกับงานจริง
- Buy the GPT-5.6 Sol if งานที่ทำซ้ำต้องการต้นทุนต่อภารกิจต่ำกว่าในผลประเมิน และคุณยอมรับการเลือกใช้รุ่นที่ถูกแทนที่แล้วได้
- Skip the GPT-5.6 Sol if การผสานระบบใหม่ต้องอิงโมเดลรุ่นปัจจุบันและได้รับการสนับสนุนต่อเนื่อง
- Buy the Mercury 3 if ความเร็วสูงและบริบทใหญ่ช่วยให้งานที่ไวต่อเวลาทำงานได้ดีขึ้น และคุณยืนยันผลด้วยการทดลองของตัวเองได้
- Skip the Mercury 3 if ต้องการผลทดสอบอิสระก่อนใช้งาน หรือกำลังประเมินจากราคาโปรโมชันโดยยังไม่ทราบราคาหลังโปรโมชัน
- Buy the GPT-6.1 Terra if งานจำนวนมากผ่านเกณฑ์คุณภาพของคุณได้โดยไม่ต้องพึ่งคะแนนสูงสุด และต้องการประหยัดค่าใช้จ่าย
- Skip the GPT-6.1 Terra if งานหลักต้องใช้การให้เหตุผลขั้นสูงหรือความแม่นยำในการทำงานเอเจนต์ต่อเนื่อง ซึ่งผลทดสอบชี้ว่า Opus 5.5 ทำได้ดีกว่า
- Buy the Claude Opus 5.5 if คุณภาพในงานยากและความสามารถด้านการใช้งานคอมพิวเตอร์สำคัญกว่าค่าใช้จ่ายต่อโทเคน
- Skip the Claude Opus 5.5 if งานทั่วไปผ่านเกณฑ์ด้วยโมเดลที่ถูกกว่า และส่วนต่างคุณภาพไม่ช่วยลดงานตรวจหรือแก้ไข