
AI ที่คะแนนสวยแต่เสี่ยงล่มทั้งพอร์ต
ความล้มเหลวในการตรวจสอบโมเดล AI ในภาคการเงิน คือสถานการณ์ที่โมเดล Machine Learning แสดงค่าประสิทธิภาพรวมดี เช่น accuracy หรือ precision สูง แต่กลับพลาดกรณีสำคัญในบางกลุ่มข้อมูล ทำให้ระบบนำไปสู่การตัดสินใจทางการเงินที่เสี่ยง ขาดบริบททางธุรกิจ และไม่รู้เท่าทันการเปลี่ยนแปลงของข้อมูลจริง ส่งผลให้เกิดความเสียหายต่อผู้ใช้ ลูกค้า และสถาบันที่นำโมเดลไปใช้ ในโลกการเงิน หลายองค์กรยังหมกมุ่นกับการเลือกโมเดล “เก่งที่สุด” มากกว่าการถามคำถามที่ถูกว่า โมเดลนี้ปลอดภัยพอจะใช้กับเงินจริงหรือยัง การประเมินผล Machine Learning แบบดูค่าเฉลี่ยเดียวทำให้เข้าใจผิดอย่างหนัก เพราะตัวเลขเดียวตอบคำถามได้แค่ว่าโมเดลทำคะแนนได้ดีบนชุดทดสอบเดิม ไม่ได้บอกว่ามันจะยังดีเมื่อเจอสถานการณ์จริงที่หลากหลายและเปลี่ยนตลอดเวลา ยิ่งโมเดลทรงพลังและใช้ในงานกว้างขึ้น คำถามว่า “เรารู้ได้อย่างไรว่ามันทำงานได้จริง” ยิ่งตอบยาก และต้นทุนของการตอบผิดก็สูงขึ้นตาม ในภาคการเงิน ความเสี่ยง AI การเงิน จึงไม่ได้อยู่แค่ค่าพยากรณ์ผิด แต่อยู่ที่การตรวจสอบโมเดล AI ที่ไม่ลึกพอจะเห็นจุดอ่อนก่อนขึ้นระบบจริง
เมื่อค่าเฉลี่ยสวยบังจุดพังที่ซ่อนอยู่
ปัญหาหลักของการประเมินผล Machine Learning ด้วยเมตริกภาพรวม เช่น accuracy หรือ F1 คือมันถูกขับเคลื่อนด้วย “เคสส่วนใหญ่” ไม่ใช่ “เคสที่สำคัญที่สุด” ค่าเฉลี่ยจะถูกครอบงำด้วยสถานการณ์ง่าย เช่น ลูกค้าที่มีพฤติกรรมปกติ รายการธุรกรรมทั่วไป เหมือนในกรณี perception model ที่สถานการณ์ส่วนใหญ่คืออากาศดี รถปกติ และระยะมองเห็นชัดเจน ขณะที่เหตุการณ์ที่กำหนดว่าระบบปลอดภัยหรือไม่ กลับเป็นเหตุการณ์หายากโดยนิยาม โมเดลจึงสามารถทำคะแนนรวมดีขึ้นแต่กลับแย่ลงใน slice ข้อมูลที่เสี่ยง เช่น ลูกค้ากลุ่มรายได้ต่ำในช่วงวิกฤต หรือนิติบุคคลขนาดกลางที่ข้อมูลไม่สมบูรณ์ และค่า topline จะยังดูดีอยู่เหมือนไม่มีอะไรผิด นี่คือความล้มเหลวด้านวิธีคิด ไม่ใช่แค่ความผิดพลาดทางสถิติ เพราะเมตริกกำลังตอบคำถามผิด เมื่อระบบ AI ถูกใช้ตัดสินใจอนุมัติสินเชื่อ กำหนดวงเงิน หรือจับสัญญาณผิดปกติ การมองแค่ค่าเฉลี่ยเท่ากับยอมปล่อยให้จุดเสี่ยงสำคัญหลุดเข้าไปในระบบโดยไม่มีใครเห็น และผู้ใช้ปลายทางคือคนที่แบกรับผลลัพธ์นั้นไว้

AI การเงินไม่ได้พังเพราะโมเดล แต่เพราะขาดบริบท
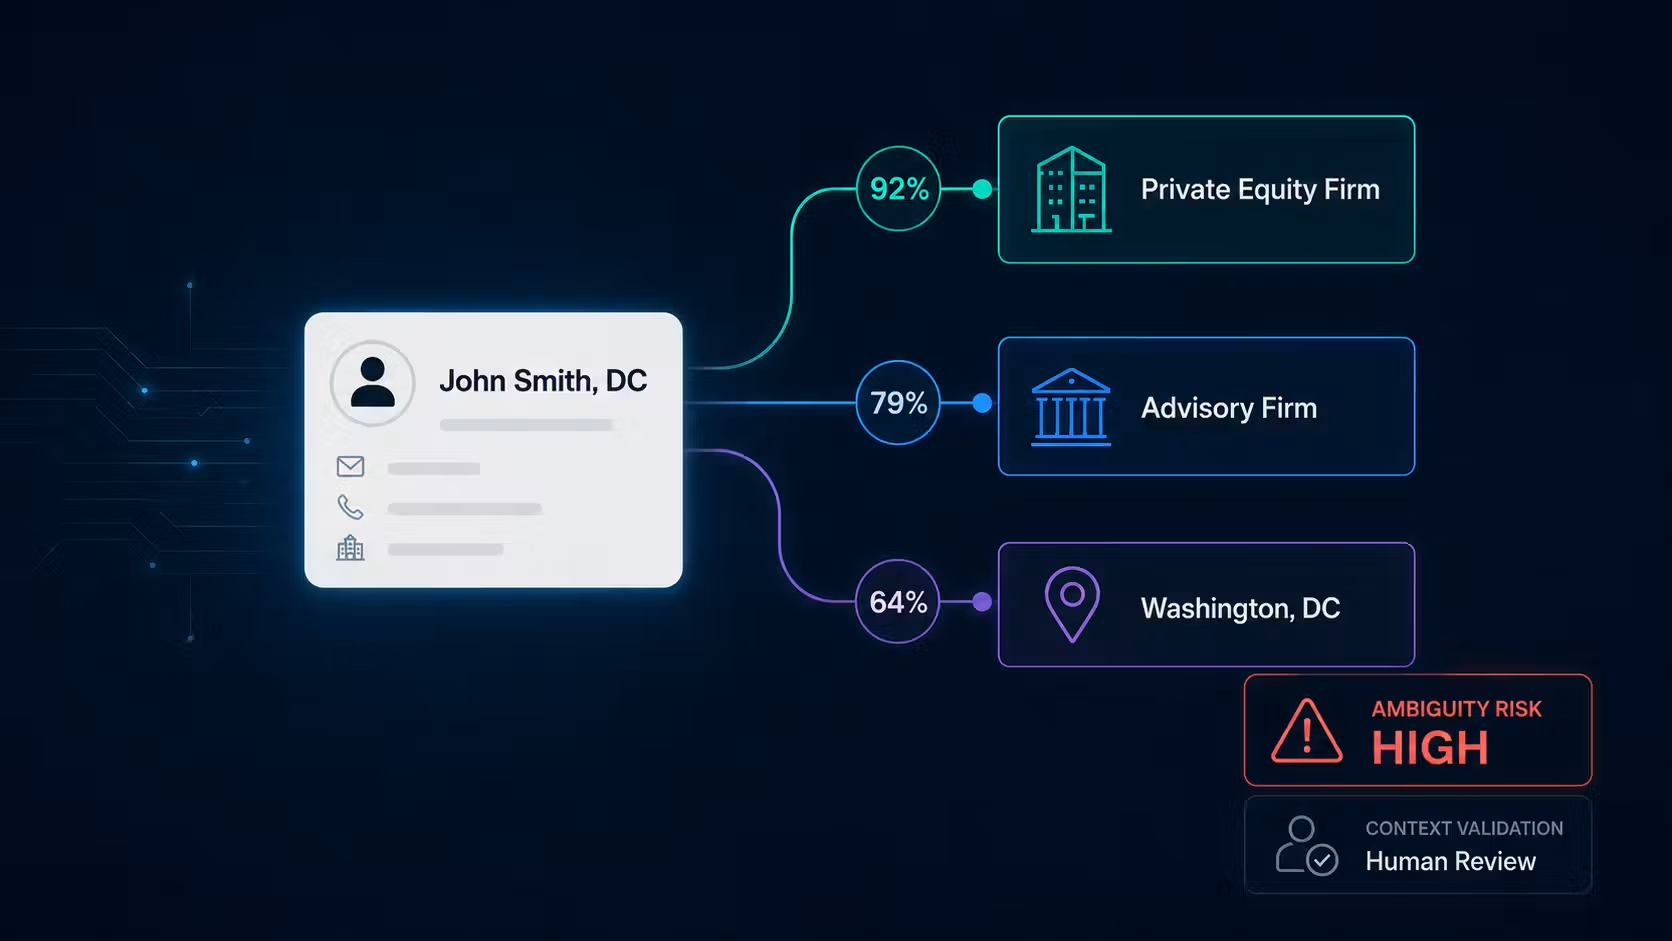
ในสถาบันการเงินระดับองค์กร มีความเชื่อฝังหัวว่าความท้าทายหลักของ AI คือการเลือกโมเดลที่ถูกต้อง ทั้งที่ในทางปฏิบัติ คอขวดตัวจริงคือ “ชั้นบริบท” ที่ให้ความหมายกับข้อมูล ลองนึกถึงระบบที่ต้องรวมรายชื่อลูกค้าจากงานสัมมนาเข้ากับ CRM เมื่อเจอข้อมูลอย่าง “John Smith, DC” ระบบไม่มีทางรู้ได้เลยว่า DC คือชื่อบริษัท DC Capital หรือ DC Advisory หรือหมายถึงพื้นที่ Washington DC หากไม่มีบริบทเพิ่มเติม ผลลัพธ์คือการแมตช์คนผิด จัดบริษัทผิด ส่งข้อมูลดีลลับไปหาคนที่ไม่ควรได้ กรณีแบบนี้ไม่ได้เกิดจากโมเดลเสีย แต่เกิดจากระบบที่ออกแบบให้ตัดสินใจโดยไร้บริบท ผู้เขียนในหนึ่งแหล่งข้อมูลสรุปไว้อย่างคมว่า “โมเดลทำงานตามที่ออกแบบ แต่ระบบต่างหากที่ผิด” เพราะ AI ไม่ได้แค่รับข้อมูลเละเทะ แต่มันขยายความเละนั้นให้กระจายไปทั้งองค์กร ในข้อมูลการเงินที่ดูเหมือนมีโครงสร้าง ความจริงคือมันถูกประกอบจากเศษข้อมูล ความสัมพันธ์ระหว่าง GP LP และบริษัทร่วมลงทุน ที่เปลี่ยนความหมายตามบริบท หากไม่ออกแบบความรู้ทางธุรกิจเข้าไปในระบบ AI ความน่าเชื่อถือ AI ก็เป็นเพียงภาพลวงตา
ตรวจสอบโมเดล AI แบบแบ่ง slice จับความเสี่ยงก่อนหลุดสู่ระบบจริง
ทางออกที่ได้ผลไม่ใช่การเพิ่มข้อมูลทดสอบอย่างไร้ทิศทาง แต่คือการออกแบบการประเมินผล Machine Learning รอบ “โหมดความล้มเหลว” โดยตรง ผู้พัฒนาระบบ perception ค้นพบว่าเมื่อจัดการวัดผลแยกตามหมวด เช่น ประเภทวัตถุ ระยะทาง ระดับการบัง การตั้งค่าแสงหรือสภาพแวดล้อม แต่ละ slice มีเกณฑ์ของตัวเอง คำถามจึงเปลี่ยนจาก “คะแนนรวมเท่าไร” เป็น “มี slice ไหนที่ยอมรับไม่ได้หรือไม่” หนึ่งตัวเลขกลายเป็นโปรไฟล์ที่ใช้ถกเถียงกันในขั้นตอนอนุมัติปล่อยระบบ กรอบการประเมินแบบ reproducible ที่มีข้อมูลและเมตริกแบบ versioned ครอบคลุมโหมดล้มเหลว มีการรันซ้ำได้ และมี threshold ที่มีอำนาจหยุดการปล่อยเวอร์ชันใหม่ เป็นสิ่งที่ควรถือเป็นวินัยวิศวกรรมเต็มรูปแบบ ไม่ใช่แค่สคริปต์สุดท้ายก่อนขึ้นระบบ ผลที่ได้คือข้อผิดพลาดน้อยลงเพราะ regression ถูกจับตั้งแต่ด่านหน้า ไม่หลุดไปถึงระบบภาคสนาม และทีมสามารถตัดสินใจได้เร็วขึ้นเพราะรู้ชัดว่าอะไรเปลี่ยน เปลี่ยนตรงไหน และมีนัยสำคัญหรือไม่ ในบริบทการเงิน นี่หมายถึงการลดความเสี่ยง AI การเงิน ก่อนมันกลายเป็นเรื่องร้องเรียนจากลูกค้าหรือปัญหากำกับดูแลจริง
แรงกดดันให้รีบใช้ AI กับคำถามที่ควรถามเสียก่อน
สถาบันการเงินกำลังเผชิญแรงกดดันให้เร่งใช้งาน AI ในทุกจุด ตั้งแต่กระบวนการดีล การรายงานนักลงทุน ไปจนถึงเวิร์กโฟลว์กำกับดูแล เมื่อระบบอัตโนมัติเหล่านี้ขยายตัว ช่องว่างด้านบริบทและการตรวจสอบโมเดล AI กลายเป็นความเสี่ยงเชิงระบบ ไม่ใช่แค่ความไม่สะดวกทางเทคนิค ที่น่ากังวลยิ่งกว่าคือการผลักมนุษย์ออกจากลูปโดยไม่มีจุด checkpoint ให้ตรวจสอบเลย คำถามที่ควรตั้งจึงไม่ใช่ “โมเดลตัวต่อไปควรใช้ตัวไหน” แต่คือ “การตัดสินใจอัตโนมัติข้อไหนในองค์กรที่ไม่มีมนุษย์คอยตรวจ และถ้ามันผิดเงียบๆ เราจะเสียใจที่สุดข้อไหน” การตรวจสอบโมเดล AI จึงต้องถูกยกขึ้นเป็นงานชั้นหนึ่งของวิศวกรรม ไม่ใช่ภารกิจท้ายโครงการ โมเดลคือสมมติฐาน การประเมินคือการทดลอง และในระบบ production การทดลองนี้ต้องมีมาตรฐานเดียวกับตัวโมเดลเอง มีการจัดการเวอร์ชันข้อมูล เมตริก การครอบคลุมโหมดล้มเหลว และ threshold ที่กล้าหยุด release เมื่อยังไม่พร้อม เพราะท้ายที่สุด ความน่าเชื่อถือ AI ในการเงินไม่ได้วัดจากว่าโมเดลฉลาดแค่ไหน แต่วัดจากว่ามันถูกตรวจสอบอย่างเข้มข้นเพียงใดก่อนที่เงินจริงและความสัมพันธ์กับลูกค้าจะต้องเป็นคนรับความเสี่ยงนั้นแทนเรา