
ย้ายงานก่อสร้างจากไซต์สู่โรงงาน
โรงงาน AI แบบโมดูลาร์คือโครงสร้างพื้นฐานประมวลผลที่ประกอบระบบคอมพิวเตอร์ เครือข่าย ไฟฟ้า และระบบทำความเย็นเป็นชุดสำเร็จจากโรงงาน ก่อนขนส่งไปติดตั้ง ณ จุดที่มีสาธารณูปโภครองรับ
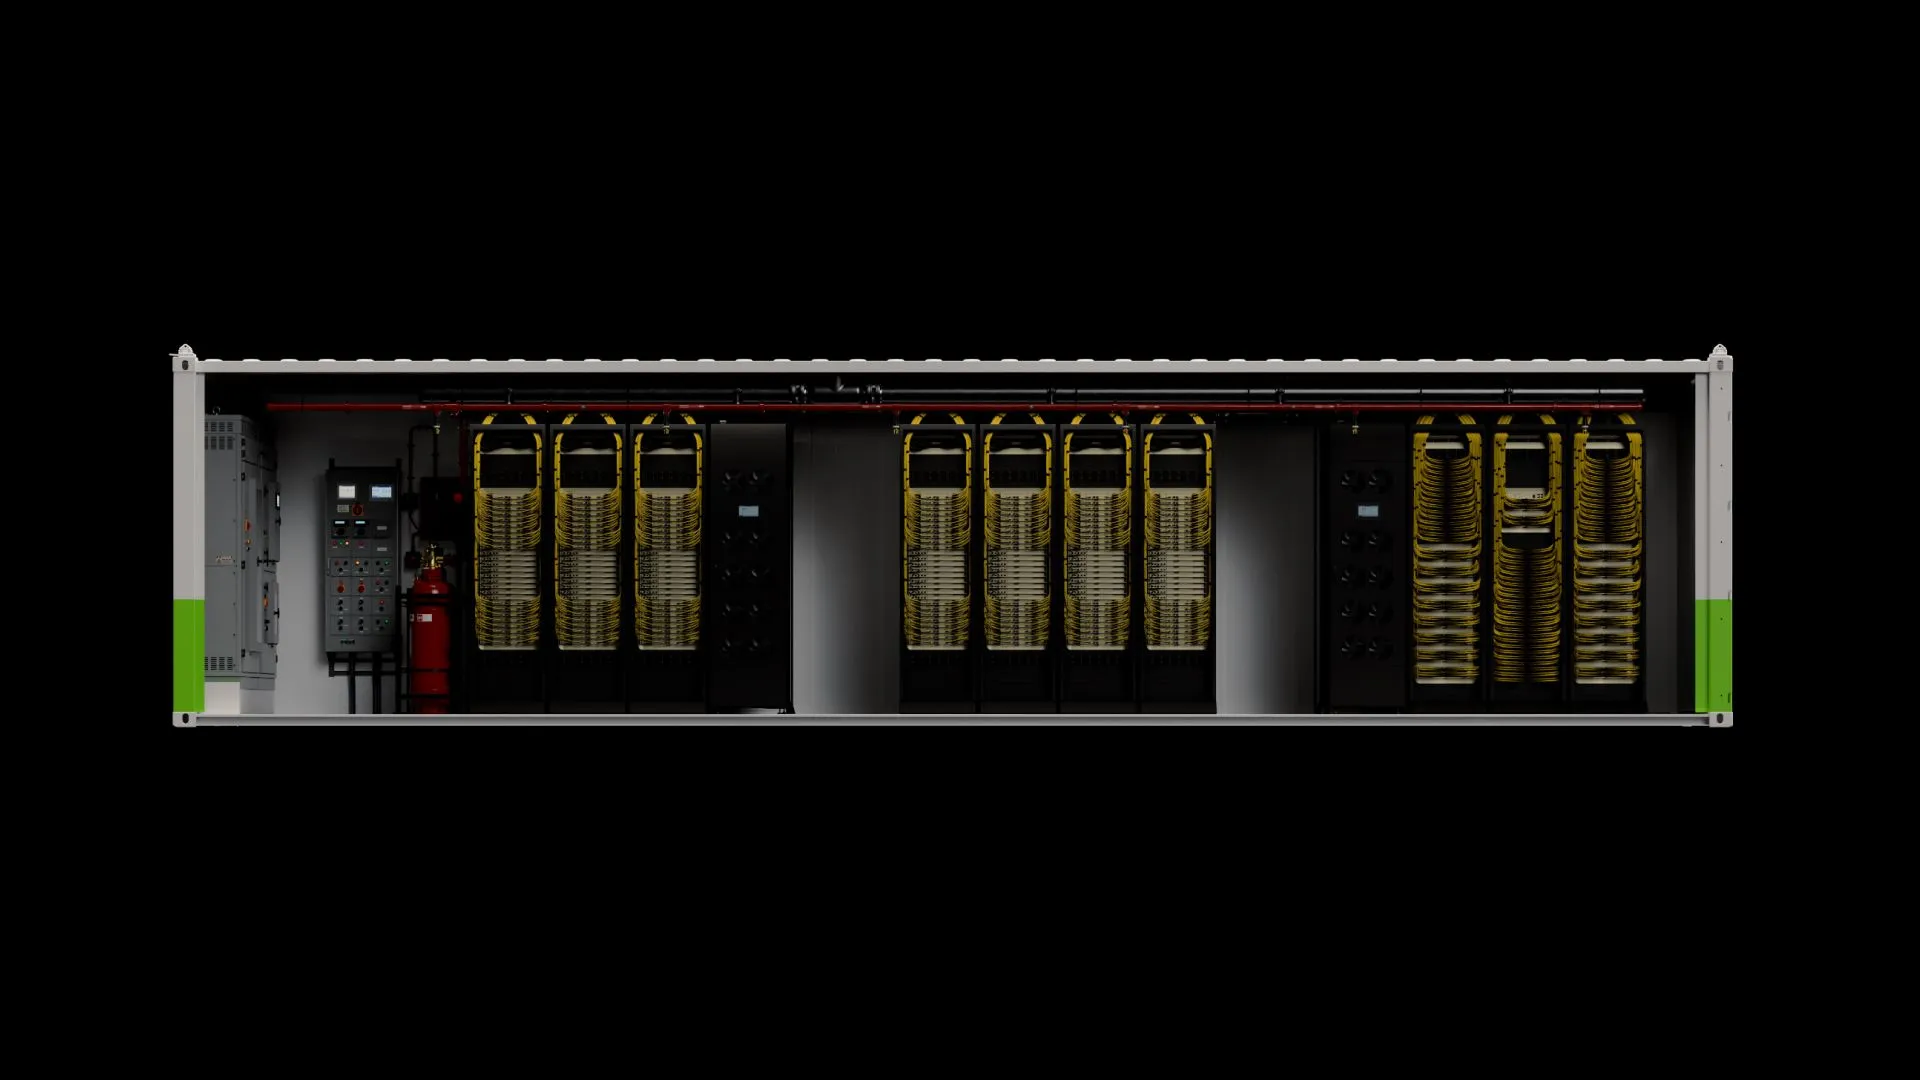
ที่งาน GTC ในเบอร์ลิน เอ็นวิเดียเปิดตัว DSX POD ซึ่งรวมระบบประมวลผล Vera Rubin เข้ากับอุปกรณ์สำคัญของศูนย์ข้อมูล AI และย้ายงานประกอบกับทดสอบส่วนใหญ่ไปทำในโรงงาน แทนการเริ่มติดตั้งทุกอย่างที่ไซต์งาน จุดนี้สำคัญกว่าการลดขั้นตอนก่อสร้าง เพราะทุกวันที่ระบบยังไม่พร้อมคือวันที่ยังผลิตโทเคน AI ไม่ได้ เอ็นวิเดียระบุว่า DSX POD อาจลดเวลาติดตั้งจากหกเดือนเหลือ 14 วัน หากสถานที่มีโครงสร้างพื้นฐานรองรับอยู่แล้ว ขณะที่การเปิดตัวเกิดขึ้นท่ามกลางความต้องการประมวลผลที่เพิ่มขึ้น แต่พลังงานและเงินทุนกลายเป็นคอขวดของธุรกิจนีโอคลาวด์ ดังนั้นคำว่าเร็วขึ้นจึงมีเงื่อนไข ไม่ใช่การเสกศูนย์ข้อมูลขึ้นได้ในสองสัปดาห์โดยไม่ต้องเตรียมไฟฟ้าและพื้นที่
ระบบระบายความร้อนคือส่วนหนึ่งของประสิทธิภาพ
DSX POD วางระบบประมวลผล เครือข่าย การจ่ายไฟ และการระบายความร้อนเหลวไว้ในตู้ที่ประกอบจากโรงงาน โดยแบบอ้างอิงเริ่มจากระบบ Vera Rubin NVL72 ซึ่งประกอบด้วยแร็กประมวลผลที่ระบายความร้อนด้วยของเหลวเจ็ดแร็ก เชื่อมต่อด้วยสาย Spectrum-X รวมประมาณ 17 กิโลเมตร นี่เป็นแนวทางที่สมเหตุสมผลเมื่อชิป AI ใช้กำลังสูงขึ้น เพราะการเพิ่มจำนวน GPU โดยไม่แก้ปัญหาความร้อนย่อมทำให้กำลังประมวลผลที่ลงทุนไปใช้ได้ไม่เต็มที่
การลดความร้อนจึงไม่ใช่แค่เรื่องดูแลอุปกรณ์ แต่เกี่ยวโดยตรงกับประสิทธิภาพพลังงานและจำนวนงานที่ทำได้ต่อหน่วยไฟฟ้า เอ็นวิเดียประเมินว่าระบบที่ทำงานระดับ 2 กิกะวัตต์อาจประหยัดน้ำได้ 54 ล้านลิตรต่อวัน เมื่อเทียบกับระบบทั่วไปที่ใช้หอหล่อเย็น ตัวเลขนี้เป็นประมาณการ ไม่ใช่ผลรับรองจากการใช้งานจริง และประสิทธิภาพที่เกิดขึ้นย่อมขึ้นกับสถานที่กับรูปแบบเดินระบบด้วย การส่งมอบ DSX POD คาดว่าจะเริ่มต้นในช่วงต้นปี 2027 ขณะที่ผลประหยัดและประสิทธิภาพยังต้องผ่านการตรวจสอบอิสระในสภาพใช้งานจริง ผู้ซื้อจึงควรมองตัวเลขเป็นเป้าหมายที่น่าติดตาม ไม่ใช่คำรับประกัน
แผ่นระบายความร้อนที่อาจเพิ่มผลตอบแทน
ข้อจำกัดด้านพลังงานทำให้การเพิ่มประสิทธิภาพจาก GPU แต่ละตัวมีความหมายมากขึ้น เพราะกำลังไฟสำหรับโรงงาน AI มีจำกัดและขยายเพิ่มได้ยากหรือมีต้นทุนสูง Frore Systems เปิดตัว LiquidJet Diamond ในเดือนตุลาคม 2026 โดยเพิ่มแผ่นกระจายความร้อนที่มีเวเฟอร์เพชรไว้ตรงตำแหน่งจุดร้อนบนแผ่นระบายความร้อน วิธีนี้ต่อยอดจาก LiquidJet ซึ่งออกแบบช่องทางไหลของของเหลวให้ตรงกับรูปแบบความร้อนของ GPU รายตัว และบริษัทระบุว่ารุ่นดังกล่าวลดอุณหภูมิไดได้ 12 องศาเซลเซียส พร้อมเพิ่มประสิทธิภาพโทเคนต่อวัตต์ 25 เปอร์เซ็นต์
สำหรับ LiquidJet Diamond บริษัทระบุว่าช่วยลดอุณหภูมิจุดร้อนเพิ่มอีก 10 องศาเซลเซียส และเพิ่มโทเคนต่อวัตต์กับรายได้ได้สูงสุด 35 เปอร์เซ็นต์เมื่อเทียบกับแผ่นระบายความร้อนแบบเดิม โดยรายได้ที่เพิ่มขึ้นส่งผลต่อกำไรโดยตรงตามการประเมินของบริษัท นี่คือเหตุผลที่การระบายความร้อนเหลวควรถูกมองเป็นส่วนหนึ่งของเศรษฐศาสตร์การประมวลผล ไม่ใช่อุปกรณ์เสริม อย่างไรก็ตาม ตัวเลขดังกล่าวเป็นคำกล่าวอ้างของผู้ผลิต และไม่ควรตีความว่าทุกศูนย์ข้อมูลจะทำกำไรเพิ่มในสัดส่วนเดียวกัน ผลจริงต้องขึ้นกับงานที่รัน การจ่ายไฟ และการออกแบบระบบโดยรวม
ขยายระบบเป็นชุด โดยไม่ต้องเริ่มใหม่ทุกครั้ง
คุณค่าของสถาปัตยกรรมแบบโมดูลาร์ไม่ได้หยุดที่การติดตั้งเร็ว แต่ยังอยู่ที่การเพิ่มกำลังประมวลผลเป็นหน่วยซ้ำได้ ตัวอย่างจาก Hyperfusion และ Vast Data คือ Sentinel ซึ่งบรรจุศูนย์ข้อมูล AI ลงในตู้ขนส่งขนาด 45 ฟุต และมีแบบอ้างอิงที่ใช้ GPU 96 ตัว พร้อมความจุข้อมูลราว 2 ถึง 3 เพตะไบต์ ส่วน HyperPod ขยายแนวทางเดียวกันไปสู่ระบบหลายเมกะวัตต์ และแต่ละชุดรองรับการขยายได้ถึงราว 20 เพตะไบต์ เมื่อใช้ Vast AI OS ข้อมูลยังอยู่ในประเทศและอยู่ภายใต้การควบคุมของลูกค้า ขณะที่ Sentinel กับ HyperPod ใช้พื้นที่ชื่อข้อมูลร่วมกันได้
สองบริษัทเตรียมทำตลาดร่วมกัน พร้อมตรวจสอบการทำงานของ Vast ในสถาปัตยกรรม Sentinel และ HyperPod และยังวางแผนศึกษาระบบควบคุมกลางสำหรับจัดการการติดตั้ง Sentinel หลายแห่ง ตัวอย่างนี้ไม่ใช่หลักฐานว่าแพลตฟอร์มดังกล่าวเป็นส่วนหนึ่งของ DSX POD แต่สะท้อนหลักคิดเดียวกัน คือทำให้การขยายระบบองค์กรเกิดจากการเพิ่มหน่วยที่เข้ากันได้ แทนการรื้อแบบเดิมทุกครั้ง สำหรับองค์กร นี่ช่วยให้วางแผนรองรับงานอนุมานและข้อมูลที่ต้องอยู่ภายใต้การควบคุมได้เป็นขั้นตอน ข้อสรุปคือ DSX POD และระบบโมดูลาร์อื่นมีโอกาสลดเวลารอและเพิ่มความคุ้มค่าด้านพลังงาน แต่ผลลัพธ์จริงยังขึ้นกับไฟฟ้าพร้อมใช้ การทดสอบหน้างาน และการพิสูจน์ตัวเลขประสิทธิภาพ