
DeepSeek V4.1-Flash คืออะไร และทำไมจึงน่าจับตา
DeepSeek V4.1-Flash คือโมเดล AI ขนาดเล็กที่ออกแบบบนสถาปัตยกรรมใหม่เพื่อให้ประมวลผลได้เร็ว มีความเข้าใจภาษาและภาพในตัว ใช้งานแบบมัลติโมดัล AI ได้เต็มรูปแบบ และตั้งใจให้รองรับทั้งงานโค้ด งานเอเจนต์ และแอปพลิเคชันผู้บริโภค ด้วยต้นทุนการประมวลผลที่ต่ำกว่ารุ่นเรือธงแต่ยังรักษาความสามารถระดับใกล้เคียง โมเดลนี้ถูกเปิดตัวในฐานะอัปเดตของไลน์โมเดลที่เน้นประสิทธิภาพ โดยมีเป้าหมายชัดเจนว่าโมเดลระดับประหยัดไม่จำเป็นต้องตามหลังโมเดลชั้นนำอย่าง GPT หรือ Claude อีกต่อไป พร้อมทั้งถูกยืนยันว่าเป็นสมาชิกที่เล็กที่สุดในครอบครัวสถาปัตยกรรมใหม่ของ DeepSeek
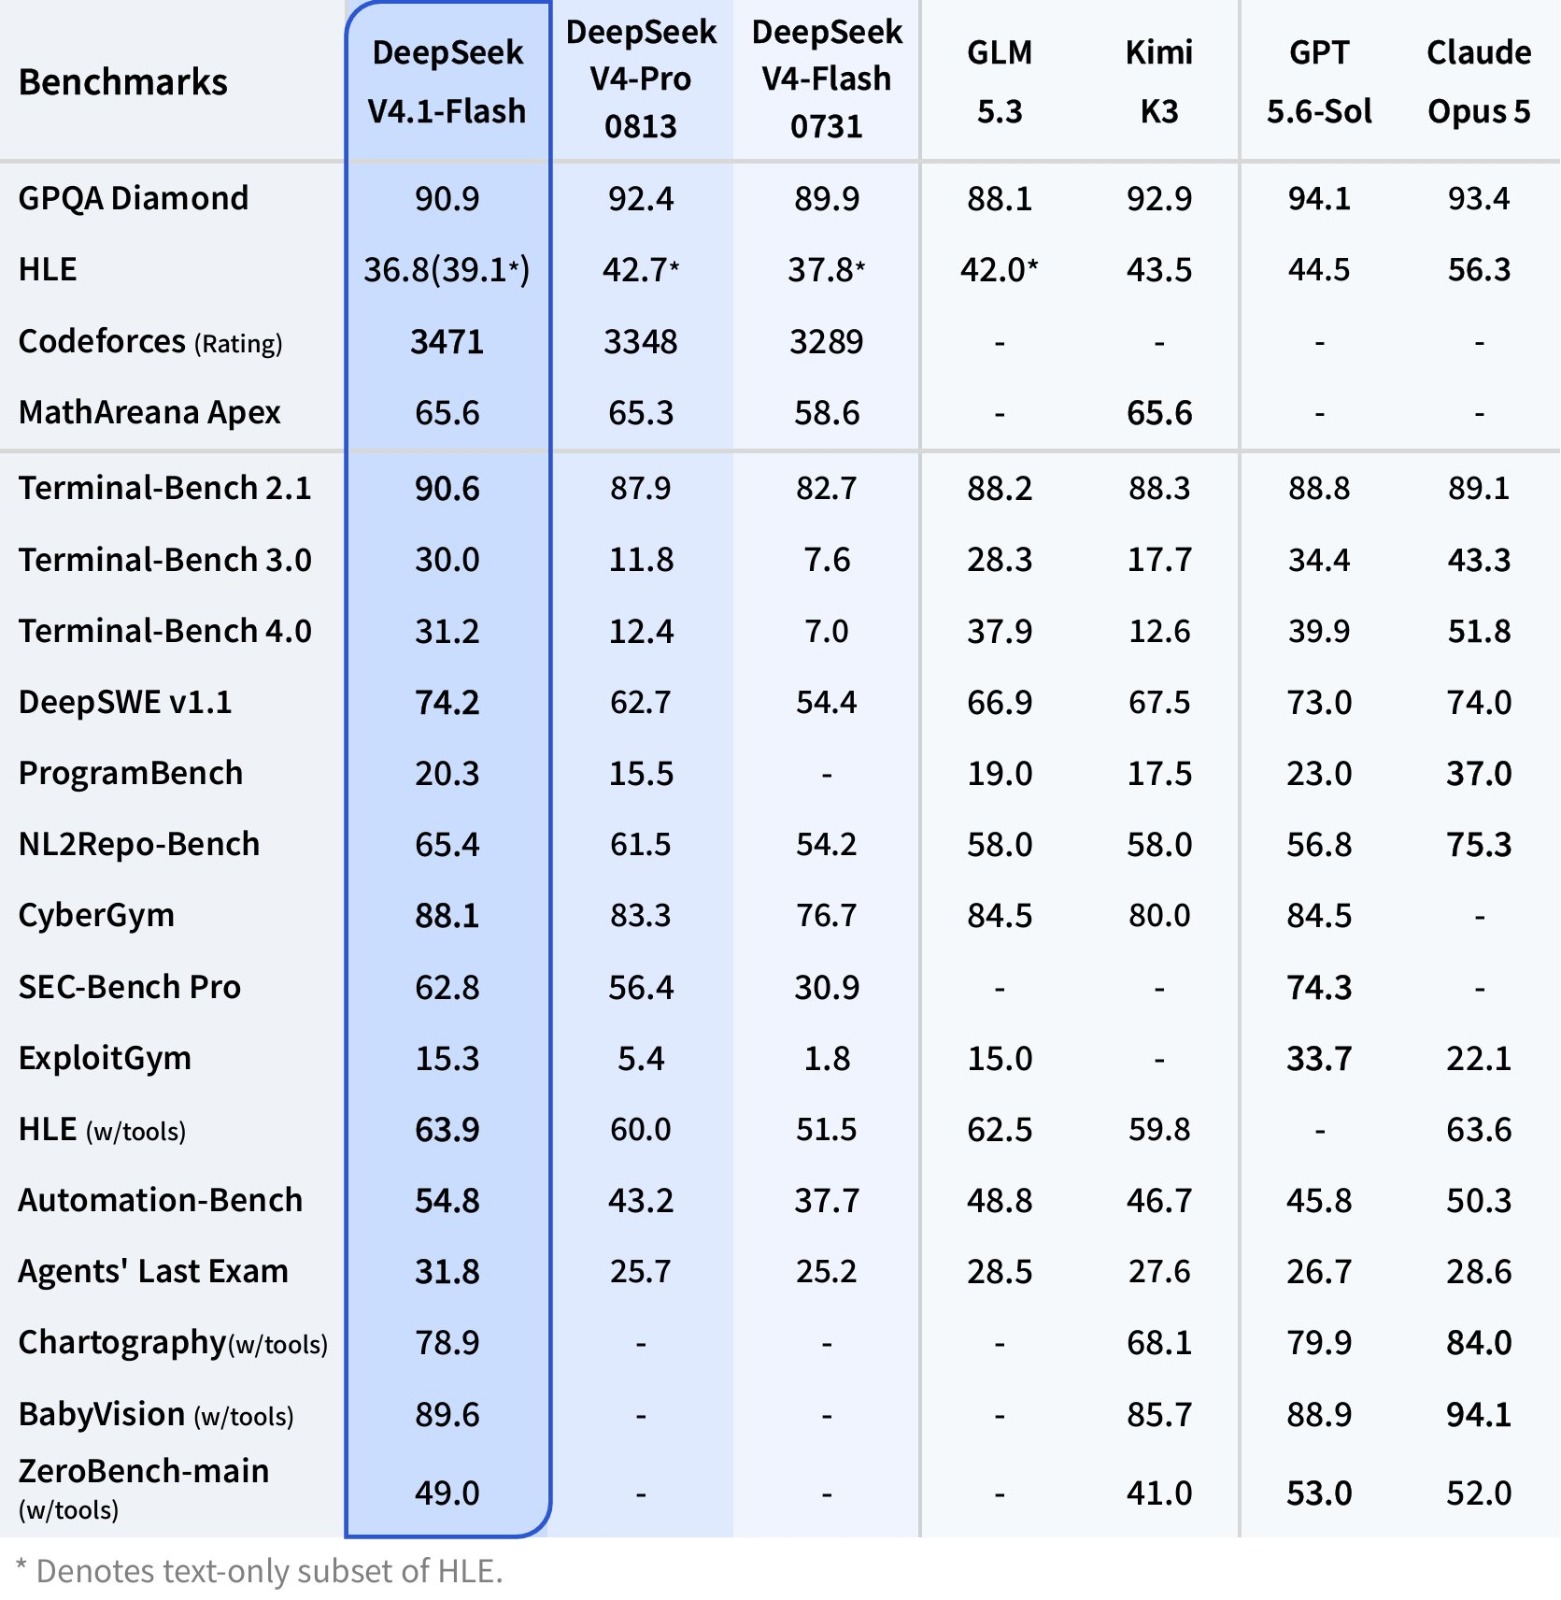
คะแนนทดสอบที่ไล่ทัน GPT และ Claude แต่ใช้ทรัพยากรน้อยกว่า
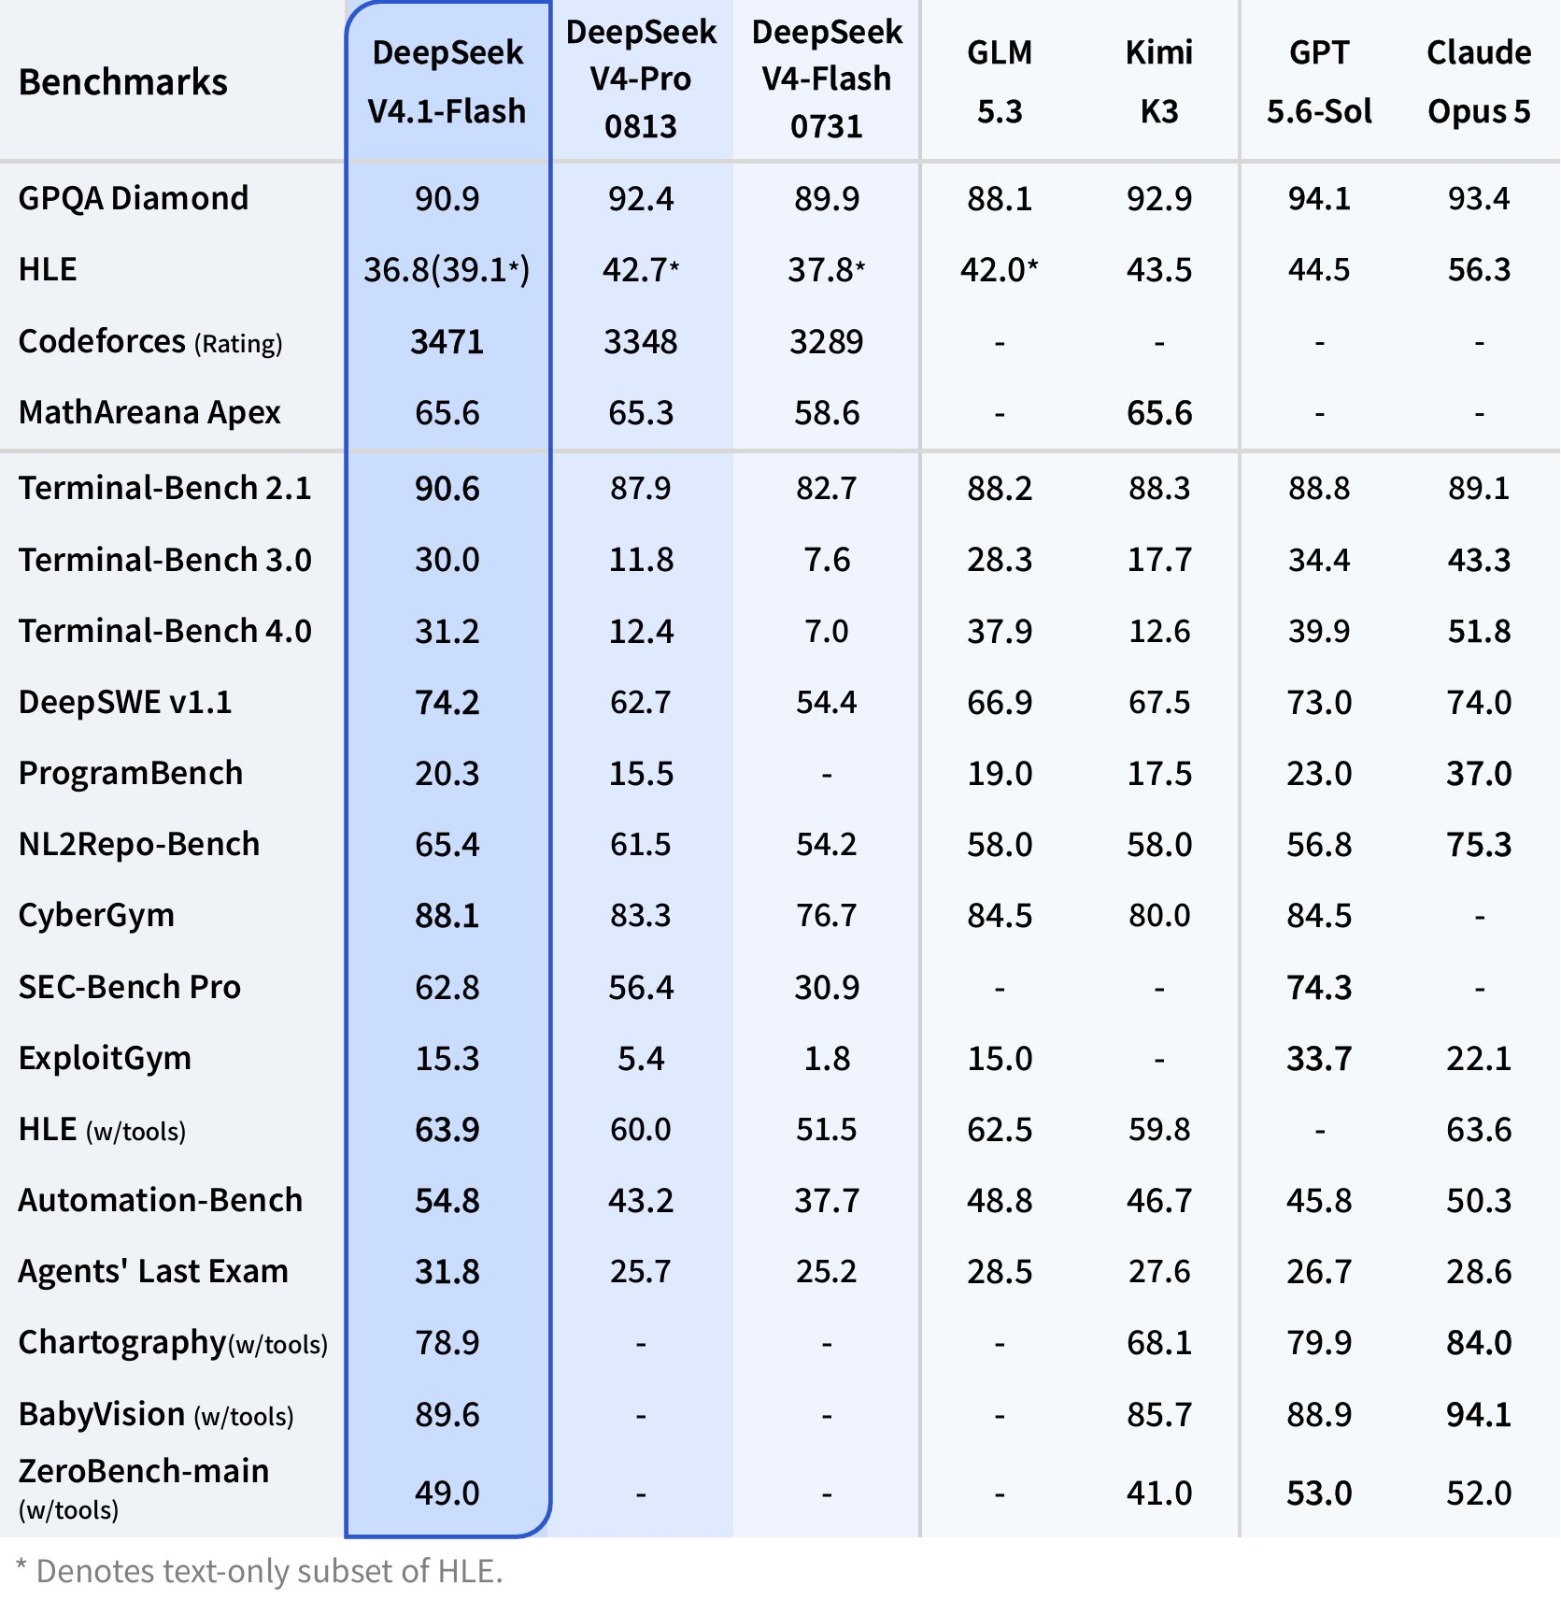
สาระสำคัญของ DeepSeek V4.1-Flash ไม่ใช่แค่คำโฆษณาเรื่อง “ฉลาดและเร็วขึ้น” แต่คือผลทดสอบที่ยืนในระดับเดียวกับโมเดลเรือธงราคาสูงกว่า ในการทดสอบด้านความปลอดภัยไซเบอร์อย่าง CyberGym โมเดลนี้ทำคะแนนได้ 88.1 แซง GPT 5.6 Sol และ GLM 5.3 ที่ได้ 84.5 และ Kimi K3 ที่ 80.0 ขณะที่บน DeepSWE v1.1 ซึ่งเน้นวิศวกรรมซอฟต์แวร์ V4.1-Flash ทำได้ 74.2 ชนะ Claude Opus 5 ที่ 74.0 และ GPT 5.6 Sol ที่ 73.0 ตัวเลขเหล่านี้บอกชัดว่าในงานเอเจนต์และโค้ด โมเดล AI ขนาดเล็กตัวนี้ไม่ใช่ตัวรอง แต่เป็นคู่แข่งตรงของ GPT และ Claude แม้จะยังตามหลังในบางหมวดความรู้เชิงลึก เช่น HLE และบางชุดทดสอบการใช้เทอร์มินัล แต่น้ำหนักโดยรวมเริ่มเปลี่ยนจากคำถามว่า “ดีเท่าหรือไม่” เป็น “ดีพอไหมสำหรับต้นทุนที่ประหยัดกว่ามาก”
สถาปัตยกรรมเล็กแต่แรง และผลต่อการใช้บนมือถือและระบบองค์กร
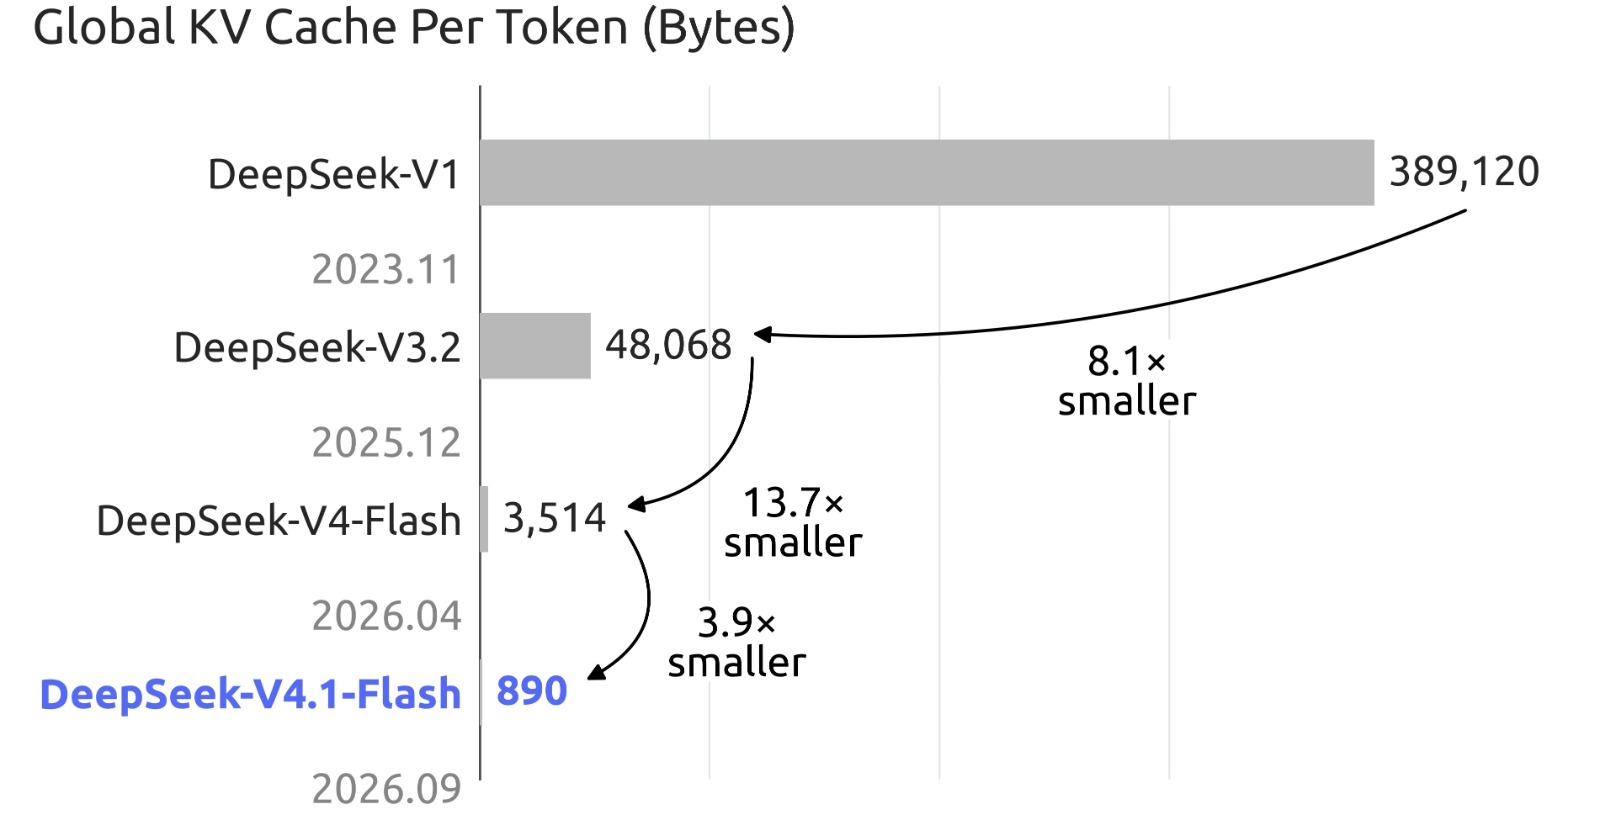
จุดพลิกเกมของ DeepSeek V4.1-Flash อยู่ที่การออกแบบสถาปัตยกรรมแบบไม่สมมาตรที่เน้นประสิทธิภาพจริง แม้จะเป็นโมเดล Mixture-of-Experts ที่มีพารามิเตอร์รวม 552 พันล้าน แต่มีพารามิเตอร์ที่ทำงานจริงเพียง 8 พันล้านสำหรับรับอินพุต และ 16 พันล้านสำหรับสร้างเอาต์พุต ทำให้โมเดลนี้จัดอยู่ในกลุ่มโมเดล AI ขนาดเล็กในทางการใช้งาน พร้อมค่าใช้ทรัพยากรขณะรันต่ำลงมาก การลดขนาด KV cache จากระดับเดิมลงเหลือเพียง 890 ไบต์ต่อโทเคน ทำให้เล็กกว่ารุ่นก่อนหน้า V4-Flash ราว 3.9 เท่า และเล็กกว่ารุ่นแรกกว่า 400 เท่า ส่งผลตรงต่อค่าใช้จ่ายของงานเอเจนต์ที่ต้องใช้บริบทซ้ำ เพราะหน่วยความจำที่ต้องสำรองต่อโทเคนน้อยลงอย่างมีนัยสำคัญ สำหรับโลกจริง นี่แปลว่าองค์กรสามารถออกแบบเอเจนต์ที่คุยยาว ทำงานต่อเนื่อง หรือใช้บนอุปกรณ์พกพาได้โดยไม่ต้องลงทุนทรัพยากรหน่วยความจำสูงเหมือนอดีต
มัลติโมดัลและความเข้าใจภาพ ทำให้ใช้ได้จริงทั้งผู้บริโภคและองค์กร
V4.1-Flash ไม่ได้เป็นแค่โมเดลภาษาที่เร็ว แต่เป็นมัลติโมดัล AI ที่มีความเข้าใจภาพ AI แบบพื้นฐานในตัว โมเดลนี้ถูกออกแบบให้รองรับความสามารถด้านการมองเห็นแบบเนทีฟ ไม่ต้องพึ่งโมเดลแยกเฉพาะภาพเหมือนรุ่นก่อนอย่าง V4-Flash-Vision-Exp ที่ถูกยกเลิกไปแล้ว ผลคือสำหรับนักพัฒนาที่ต้องการสร้างแอปผู้บริโภค เช่น ผู้ช่วยส่วนตัวบนมือถือ แอปกล้องอัจฉริยะ หรือเครื่องมือด้านเอกสารองค์กรที่ต้องอ่านทั้งข้อความและภาพ V4.1-Flash แปลตรงเป็นความง่ายในการออกแบบสถาปัตยกรรม เพราะไม่ต้องต่อโมเดลหลายตัวเข้าด้วยกัน การมีมัลติโมดัลในตัวยังลดความซับซ้อนด้านต้นทุนและการดูแลระบบ เมื่อรวมกับประสิทธิภาพเชิงคำนวณและ KV cache ที่เล็กลง โมเดลนี้จึงเหมาะทั้งสำหรับบริการผู้ใช้จำนวนมากบนมือถือ และระบบหลังบ้านขององค์กรที่ต้องใช้เอเจนต์จำนวนมากโดยยังคุมค่าใช้จ่ายได้
โอเพ่นซอร์ส การตั้งราคา และทิศทางต่อไปของ DeepSeek
ด้านการเข้าถึง DeepSeek เลือกเส้นทางที่ตรงข้ามกับโมเดลเรือธงแบบปิดหลายราย ด้วยการเผยแพร่โมเดลและรายงานเทคนิคบนแพลตฟอร์มโอเพ่นซอร์ส และประกาศทำงานร่วมกับชุมชนเพื่อพัฒนาการรันโมเดล รวมถึงเปิดรับพันธมิตรที่วางแผนดีพลอยบนจีพียูหลักพันตัว แนวทางนี้ทำให้ V4.1-Flash กลายเป็นตัวเลือกที่เข้าถึงได้สำหรับนักพัฒนาทั่วโลก ซึ่งต้องการทางเลือกจากโมเดลเชิงพาณิชย์ที่ผูกขาดโดยค่ายใหญ่ ในด้านรูปแบบค่าบริการ DeepSeek ใช้โมเดลคิดราคาแยกระหว่างช่วงพีกและนอกพีก โดยเปิดใช้ตั้งแต่วันที่ 10 กันยายน 2026 เน้นสะท้อนต้นทุนการให้บริการที่ลดลงจากสถาปัตยกรรมใหม่ และให้แรงจูงใจให้นักพัฒนาจัดตารางงานที่ยืดหยุ่นในช่วงเวลาที่เซิร์ฟเวอร์ไม่หนาแน่น ที่สำคัญ ตั้งแต่วันที่ 14 กันยายน 2026 DeepSeek จะเปลี่ยนทุกคำขอ API ที่ใช้ deepseek-v4-pro ให้ไปรันบน V4.1-Flash พร้อมใช้อัตราค่าบริการที่ถูกลง และจะทำเช่นนี้ต่อไปจนกว่าจะมีรุ่น V4.1-Pro ทิศทางนี้สะท้อนความมั่นใจว่ารุ่น Flash ใหม่ไม่ใช่รุ่นรอง แต่คือฐานหลักของสถาปัตยกรรมยุคต่อไป