
DeepSeek V4.1-Flash คืออะไร และทำไมโมเดล AI ประหยัดจึงสำคัญ
DeepSeek V4.1-Flash คือโมเดล AI ประหยัดที่ออกแบบให้มีประสิทธิภาพสูงในงานเอเยนต์และโค้ดดิ้ง สามารถแข่งขันกับโมเดลเรือธงอย่าง GPT และ Claude ได้ใกล้เคียงแต่ใช้ทรัพยากรคำนวณและหน่วยความจำระหว่างรันน้อยลงอย่างมาก จึงตอบโจทย์การนำไปใช้บนมือถือและระบบองค์กรที่ต้องการทั้งความฉลาด ความเร็ว และต้นทุนรวมที่ต่ำลง เบื้องหลังการเปิดตัวครั้งนี้คือการเดินเกมของค่ายพัฒนา AI จากเอเชียที่ต้องการไล่ทันและกดดันผู้เล่นสหรัฐผ่านแนวคิดโมเดล AI ประหยัดที่ฟีเจอร์ใกล้เคียงรุ่นแพงกว่า ไม่ใช่เพียงแค่การลดต้นทุนแต่เป็นการสร้างมาตรฐานใหม่ว่าโมเดลระดับ “flash” ไม่จำเป็นต้องด้อยความสามารถจากรุ่นเรือธงอีกต่อไป ในมุมมองของผู้ใช้ นี่คือโอกาสในการเข้าถึงโมเดลเก่งขึ้นโดยไม่ต้องเพิ่มงบประมาณด้านโครงสร้างพื้นฐานอย่างรุนแรง
คะแนน DeepSWE 74.2 สะท้อนอะไรในการแข่งขัน AI โมเดล
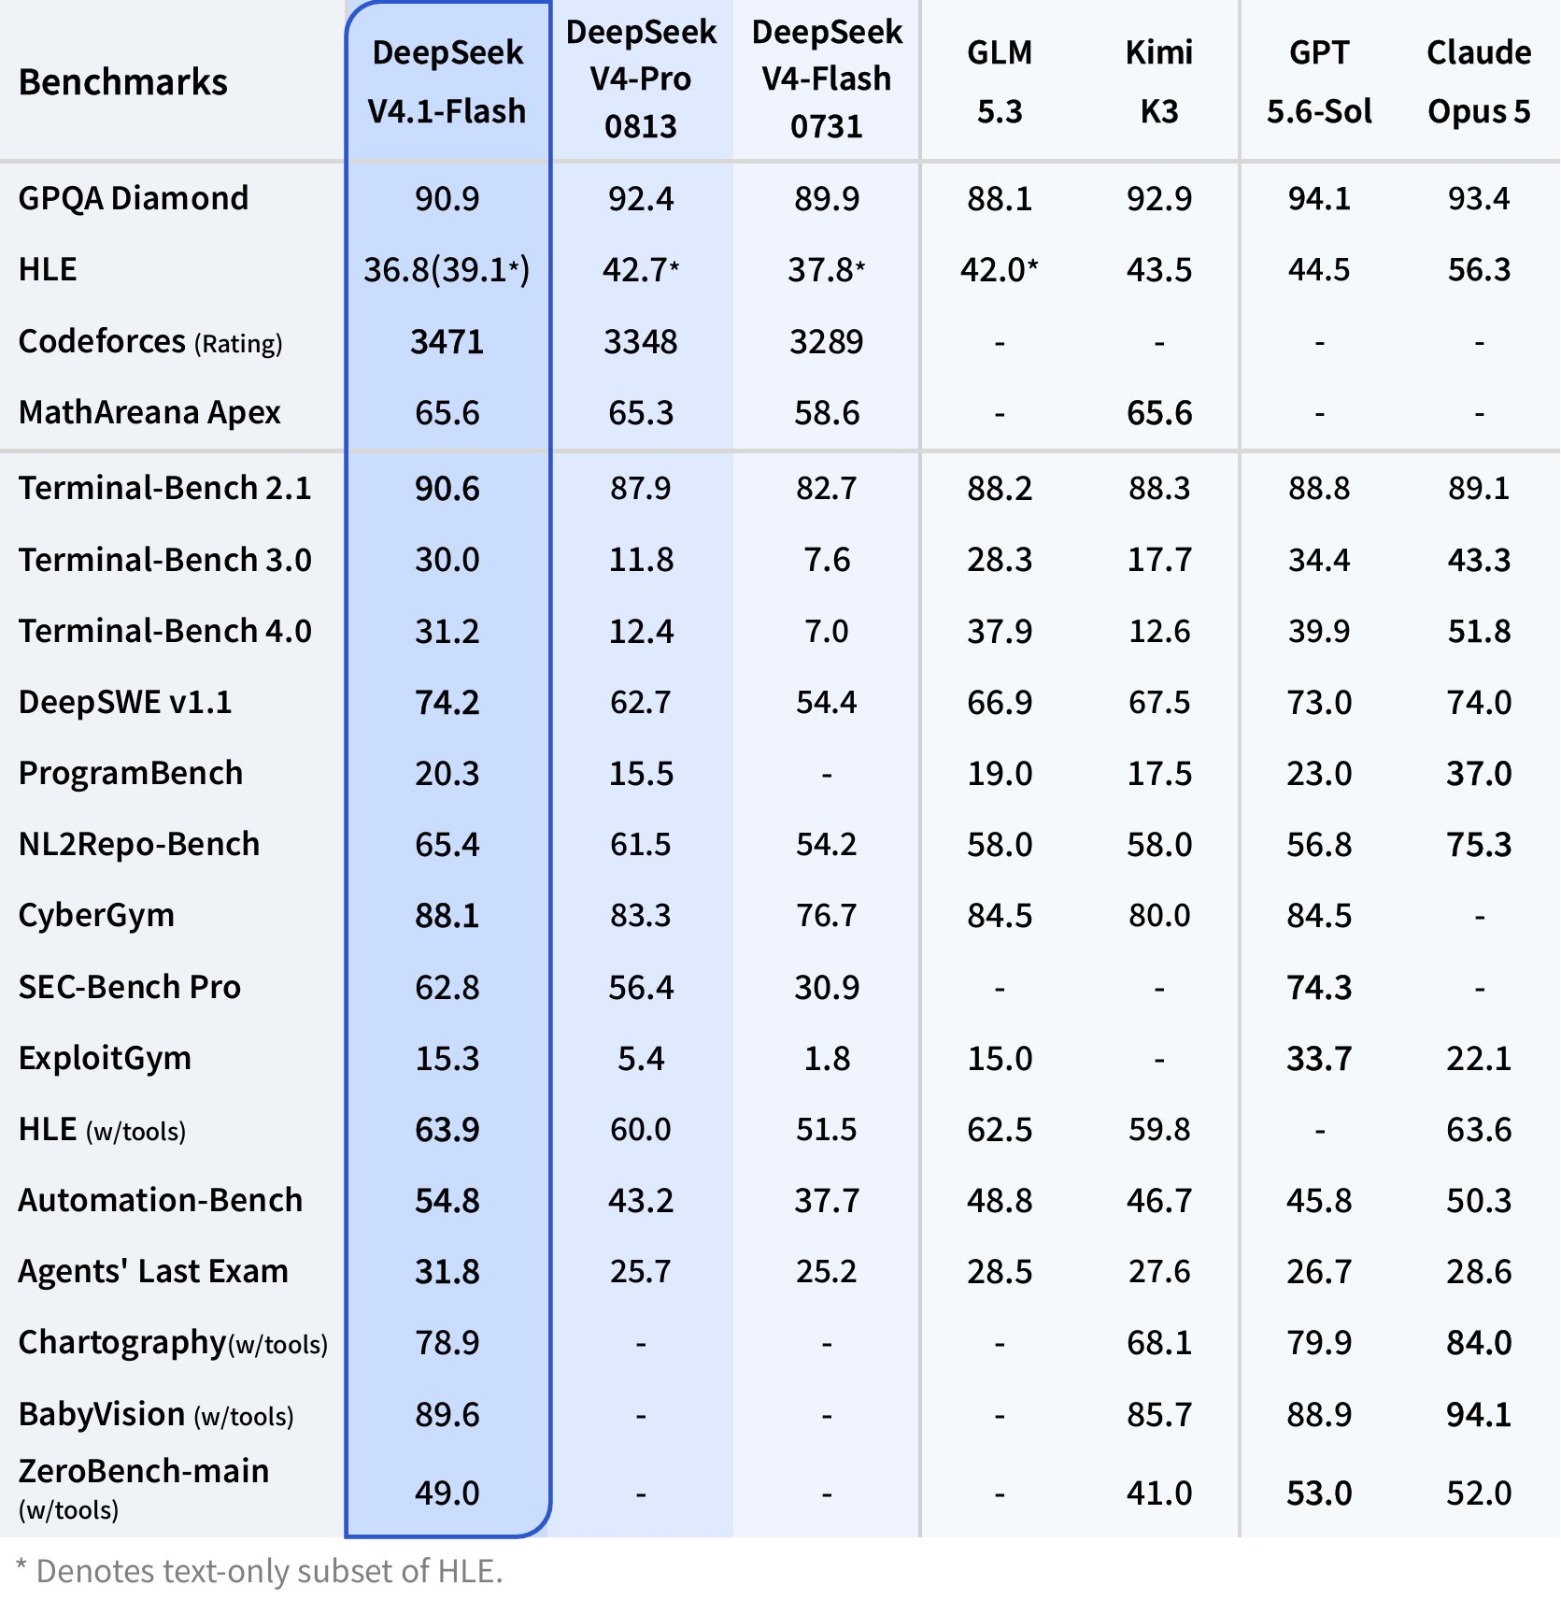
หัวใจของการแข่งขัน AI โมเดลวันนี้อยู่ที่คำถามว่า ใครให้ความสามารถสูงสุดในงบประมาณต่ำสุด ในสนามทดสอบด้านวิศวกรรมซอฟต์แวร์ DeepSWE v1.1 โมเดล DeepSeek V4.1-Flash ทำคะแนนได้ 74.2 แซงทั้ง Claude Opus 5 ที่ 74.0 และ GPT 5.6 Sol ที่ 73.0 อย่างเฉียดฉิว นี่ไม่ใช่เรื่องคะแนนเพียงเล็กน้อย แต่เป็นสัญญาณชัดว่ารุ่นที่ถูกออกแบบมาให้ประหยัด สามารถขึ้นมาเทียบชั้นและบางงานก็แซงรุ่นเรือธงได้แล้ว รูปแบบนี้เห็นได้ชัดในเบนช์มาร์กอื่น เช่น Automation-Bench ที่ V4.1-Flash นำหน้า Claude Opus 5 และ GPT 5.6 Sol อย่างต่อเนื่อง ทำให้ภาพรวมของการแข่งขันเปลี่ยนจาก “ใครเก่งที่สุดแบบไม่สนต้นทุน” มาเป็น “ใครคุ้มค่าที่สุดต่อหนึ่งงานเอเยนต์หรือโค้ด” ซึ่งเป็นมุมที่ผู้ประกอบการและนักพัฒนามองว่าสำคัญกว่าในระยะยาว
| เบนช์มาร์ก | DeepSeek V4.1-Flash | โมเดลคู่แข่ง |
|---|---|---|
| DeepSWE v1.1 | 74.2 | Claude Opus 5 74.0 / GPT 5.6 Sol 73.0 |
| Automation-Bench | 54.8 | Claude Opus 5 50.3 / GPT 5.6 Sol 45.8 |
| CyberGym | 88.1 | GPT 5.6 Sol 84.5 |
ความสามารถมัลติโมดัล ตัวภาพและข้อความในโมเดลเดียว
จุดพลิกเกมสำคัญของ DeepSeek V4.1-Flash คือการย้ายความสามารถด้านภาพเข้ามาเป็นส่วนหนึ่งของตัวโมเดล ไม่ต้องพึ่งโมเดลเสริมหรือตัวเสริมด้านวิชันอีกต่อไป โมเดลนี้มาพร้อม native visual understanding และความสามารถมัลติโมดัลที่รองรับทั้งข้อความและภาพในชุดสถาปัตยกรรมเดียว การออกแบบเช่นนี้ทำให้การนำไปใช้ในงานจริง เช่น แอปบนมือถือ ระบบช่วยงานพนักงาน หรือแดชบอร์ดวิเคราะห์ข้อมูลภาพกับข้อความ มีความง่ายและเสถียรมากขึ้น ในมุมธุรกิจ การที่ความสามารถมัลติโมดัลถูกฝังเป็นเนทีฟหมายถึงทีมพัฒนาไม่ต้องออกแบบระบบเรียกใช้สองโมเดล แยกบริหารทรัพยากร หรือจัดการไลเซนส์หลายชุด ลดทั้งความซับซ้อนและต้นทุนเชิงวิศวกรรม และเมื่อจับคู่กับประสิทธิภาพการรันที่เน้นความคุ้มค่า V4.1-Flash จึงดูมีเสน่ห์สำหรับผลิตภัณฑ์ที่ต้องตอบสนองเร็วบนทรัพยากรจำกัด
สถาปัตยกรรมประหยัดทรัพยากรกับการกระจาย AI สู่มือถือและองค์กร
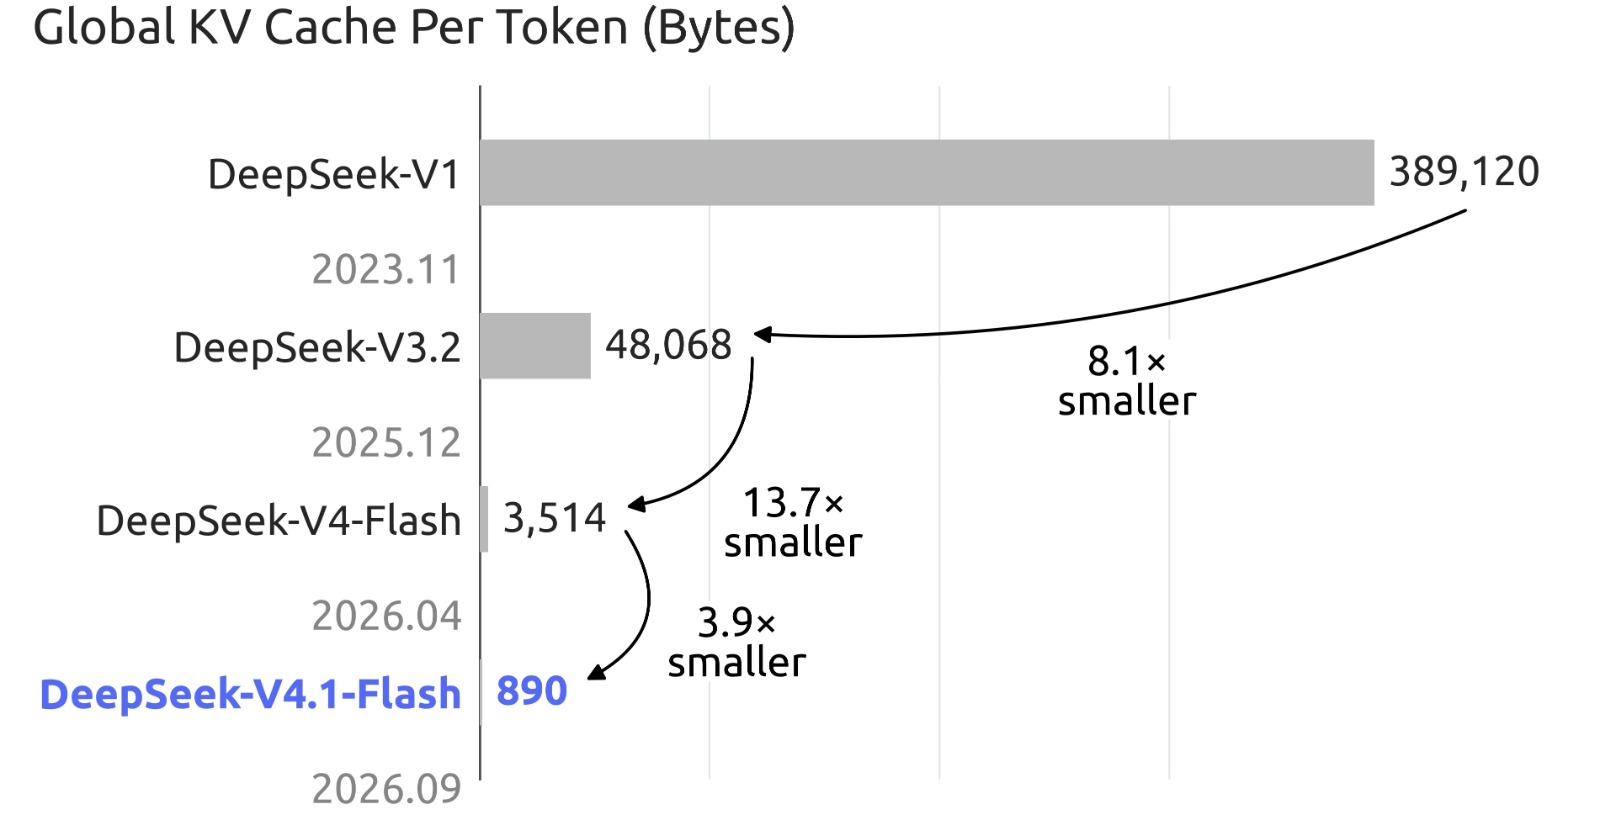
สิ่งที่ทำให้ DeepSeek V4.1-Flash เข้าข่ายโมเดล AI ประหยัดอย่างแท้จริงไม่ใช่แค่คะแนน แต่คือสถาปัตยกรรมที่ออกแบบมาเพื่อกดภาระทรัพยากรลง โมเดลนี้เป็น Mixture-of-Experts ขนาด 552 พารามิเตอร์ระดับพันล้าน แต่ใช้พารามิเตอร์แอคทีฟเพียง 8 พันล้านสำหรับอินพุต และ 16 พันล้านสำหรับเอาต์พุตในแต่ละครั้ง จุดนี้ทำให้การรันแต่ละครั้งกินทรัพยากรเครื่องน้อยลงอย่างชัดเจนเมื่อเทียบกับโมเดลใหญ่แบบดั้งเดิม นอกจากนี้ ขนาดคีย์แวลูแคชหรือ KV cache ถูกลดต่อเนื่องจนเหลือเพียงส่วนเล็กมากจากรุ่นก่อนหน้า โดยข้อมูลระบุว่าขนาดต่อโทเคนใน V4.1-Flash เล็กกว่ารุ่นแรกของตระกูลเดียวกันหลายร้อยเท่า ผลที่ตามมาคือการใช้งานเอเยนต์ที่ต้องดึงบริบทเดิมซ้ำ ๆ มีต้นทุนความจำและการเก็บข้อมูลลดลง ซึ่งเป็นจุดเจ็บปวดของระบบ AI เชิงองค์กรที่มักรันงานยาวและต่อเนื่อง
การแข่งขัน AI โมเดลจีน–สหรัฐ กับทิศทางการนำไปใช้ในอนาคต
การเปิดตัว DeepSeek V4.1-Flash พร้อมการปรับโครงราคาตามช่วงเวลาการใช้งานสะท้อนภาพใหญ่ของการแข่งขัน AI โมเดลระหว่างฝั่งจีนและสหรัฐที่กำลังขับเคี่ยวกันด้านประสิทธิภาพและต้นทุน โมเดลนี้ถูกวางตัวให้เป็นรุ่นประสิทธิภาพสูงราคาย่อมเยา และถึงขั้นประกาศเลิกใช้ V4-Pro โดยจะเปลี่ยนทราฟฟิกทั้งหมดไปยัง V4.1-Flash ตั้งแต่วันที่ 14 กันยายน เพื่อให้ผู้ใช้ได้ประโยชน์จากความคุ้มค่ามากขึ้น ในเชิงกลยุทธ์ ผู้พัฒนาโมเดลกำลังผลักดันให้ V4.1-Flash กลายเป็นฐานรองรับรุ่นใหญ่กว่าในครอบครัวเดียวกัน พร้อมเดินหน้าร่วมงานกับคอมมูนิตี้โอเพ่นซอร์ส สนับสนุนการรันบนคลัสเตอร์ขนาดพันจีพียูขึ้นไป หากทิศทางนี้สำเร็จ เราน่าจะเห็นการกระจาย AI ระดับสูงเข้าสู่บริการจำนวนมาก ทั้งในรูปแบบแอปมือถือ ระบบองค์กร และเอเยนต์อัตโนมัติ ที่ใช้โมเดล AI ประหยัดเป็นแกนกลางแทนการพึ่งพารุ่นเรือธงราคาแพงเพียงไม่กี่เจ้า