
Grok 4.7 บน Amazon Bedrock คืออะไร และสำคัญต่อองค์กรอย่างไร
Grok 4.7 Amazon Bedrock คือโมเดลภาษาขนาดใหญ่จาก xAI ที่ถูกนำไปให้บริการบนแพลตฟอร์ม Amazon Bedrock เพื่อรองรับงานโค้ด ตัวแทนอัตโนมัติระยะยาว และงานความรู้ระดับมืออาชีพ โดยมีหน้าต่าง AI context window 500K โทเคนสำหรับจัดการข้อมูลจำนวนมากในคำขอเดียว รองรับอินพุตทั้งข้อความและรูปภาพ และส่งคืนข้อความ ทำให้ทีมองค์กรสามารถใช้ความสามารถ AI ระยะยาวผ่านโครงสร้างพื้นฐาน AWS AI models ที่ได้รับการจัดการโดยไม่ต้องดูแลระบบเอง จุดเปลี่ยนสำคัญคือวันที่โมเดลนี้เข้าสู่โลกองค์กรแบบเต็มตัว Amazon Web Services ประกาศว่า Grok 4.7 จาก xAI พร้อมให้ใช้งานบน Amazon Bedrock เมื่อวันที่ 28 กันยายน 2026 ขยายการเข้าถึงจากเดิมที่เปิดตัวครั้งแรกเมื่อวันที่ 21 กันยายนบนแพลตฟอร์มอย่าง Cursor และ Grok Build รวมถึงผ่าน Grok API และแพลตฟอร์มเขียนโค้ดของบุคคลที่สาม การตัดสินใจนำ Grok 4.7 เข้าสู่แคตาล็อก AWS AI models จึงไม่ใช่เพียงการเพิ่มตัวเลือกโมเดลใหม่ แต่คือการส่งสัญญาณชัดเจนว่า การประมวลผลงานยาวและ complex long-task workflows กำลังกลายเป็นมาตรฐานใหม่ใน enterprise AI deployment และองค์กรที่ยังคิดแบบงานสั้น จะเริ่มเห็นว่ากำลังตามหลังคู่แข่งที่ลงทุนกับเอเจนต์อัตโนมัติและเวิร์กโฟลว์ระยะยาว
หน้าต่างบริบท 500K โทเคน เปลี่ยนเกม long-task workflows อย่างไร
หัวใจของ Grok 4.7 บน Amazon Bedrock คือ AI context window 500K โทเคนที่ถูกออกแบบมาเพื่อกลืนข้อมูลในระดับโครงการ ไม่ใช่แค่ไฟล์เดี่ยว โมเดลถูกเพิ่มเข้าไปในแคตาล็อก Bedrock พร้อมหน้าต่างบริบท 500K โทเคน รองรับข้อความและรูปภาพ และมีระดับความพยายามในการให้เหตุผลที่กำหนดค่าได้สี่ระดับ จุดนี้สำคัญกับองค์กรเพราะหมายถึงการประมวลผลเอกสารขนาดใหญ่ โค้ดทั้ง repository หรือชุดข้อมูลเชิงธุรกิจจำนวนมากในคำขอเดียว ลดการแตกงานเป็นชิ้นเล็กที่มักทำให้บริบทหล่นหาย แนวคิดด้านการฝึกโมเดลก็สะท้อนวิสัยทัศน์ long-task workflows ชัดเจน xAI รายงานว่า Grok 4.7 ใช้ฐานโมเดลใหม่ที่ใหญ่ขึ้นและถูกฝึกด้วยการเรียนรู้เสริมที่ยาวนานขึ้นบนงานที่ใช้เวลาหลายชั่วโมง โดยให้ความสำคัญกับการตรวจสอบงานของตนเองและการใช้หน้าต่างบริบท 500K โทเคนอย่างมีประสิทธิภาพ โครงสร้างแบบนี้ตอบโจทย์ยุคที่ซอฟต์แวร์กำลังหันไปสู่สถาปัตยกรรมตัวแทนอัตโนมัติ ซึ่งงานจริงไม่ใช่การเขียนฟังก์ชันเดียวให้สวย แต่คือการอ่านโค้ดทั้งระบบ แปลงความต้องการเชิงสถาปัตย์เป็นการปรับหลายโมดูล และวนทดสอบในเทอร์มินัลหลายชั่วโมงโดยไม่หลุดเป้าหมาย สำหรับทีมองค์กร นี่คือความแตกต่างระหว่างเอเจนต์ที่ทำงานได้ในเดโม กับเอเจนต์ที่อยู่รอดในระบบโปรดักชันอย่างต่อเนื่อง
ประสิทธิภาพในงานยาวและงานมืออาชีพ มากกว่าเรื่องคะแนนทดสอบ
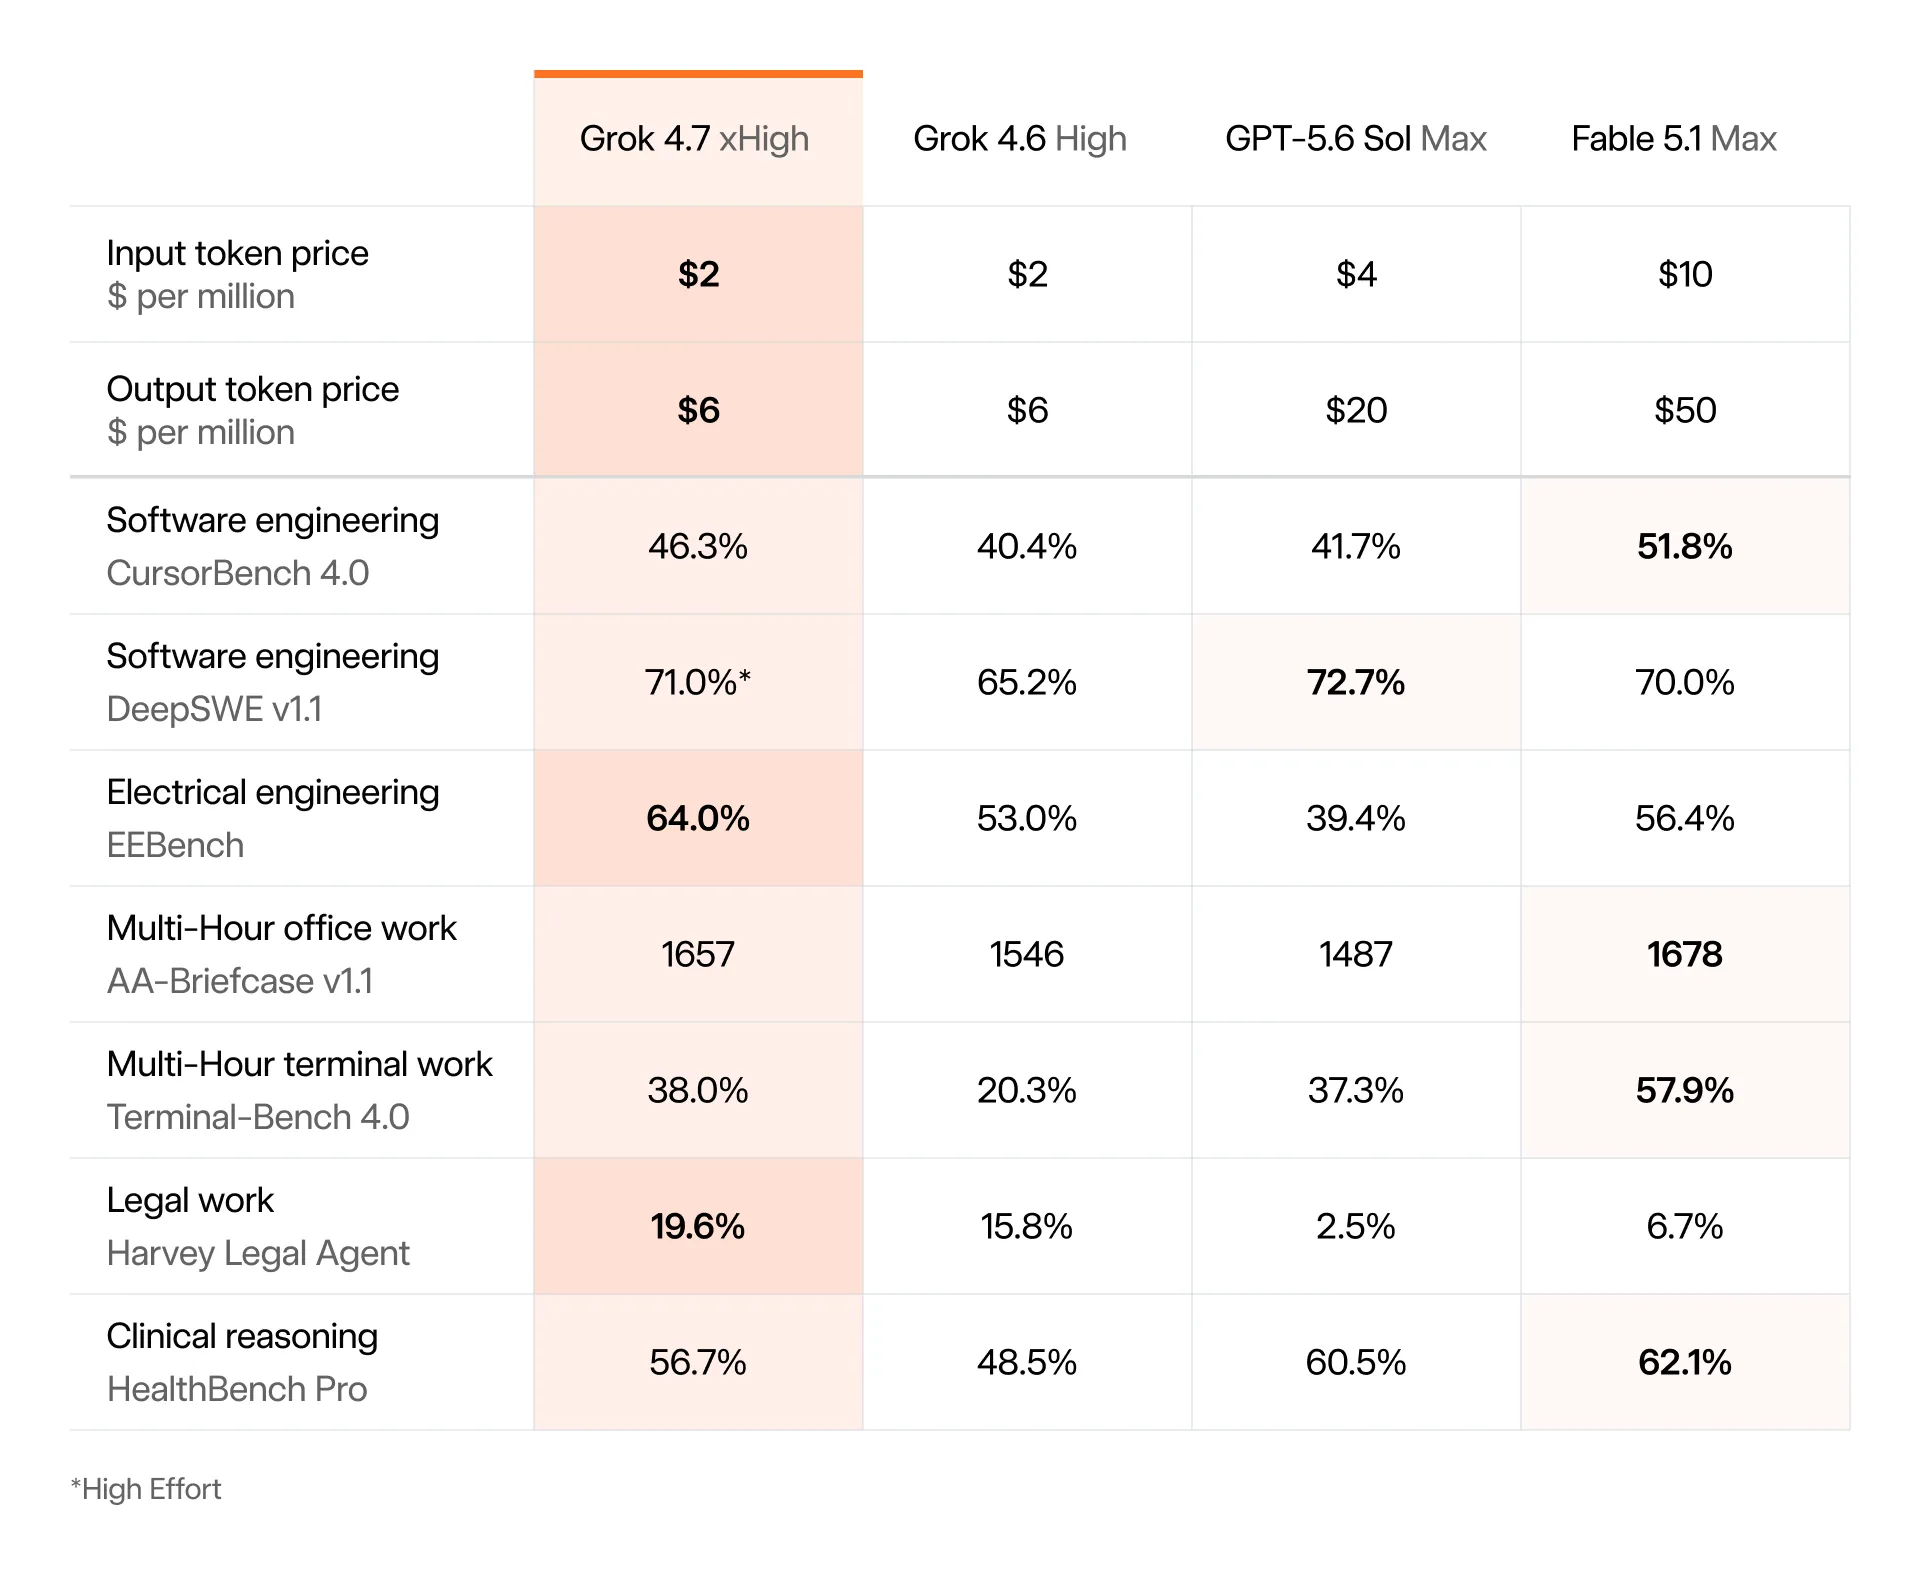
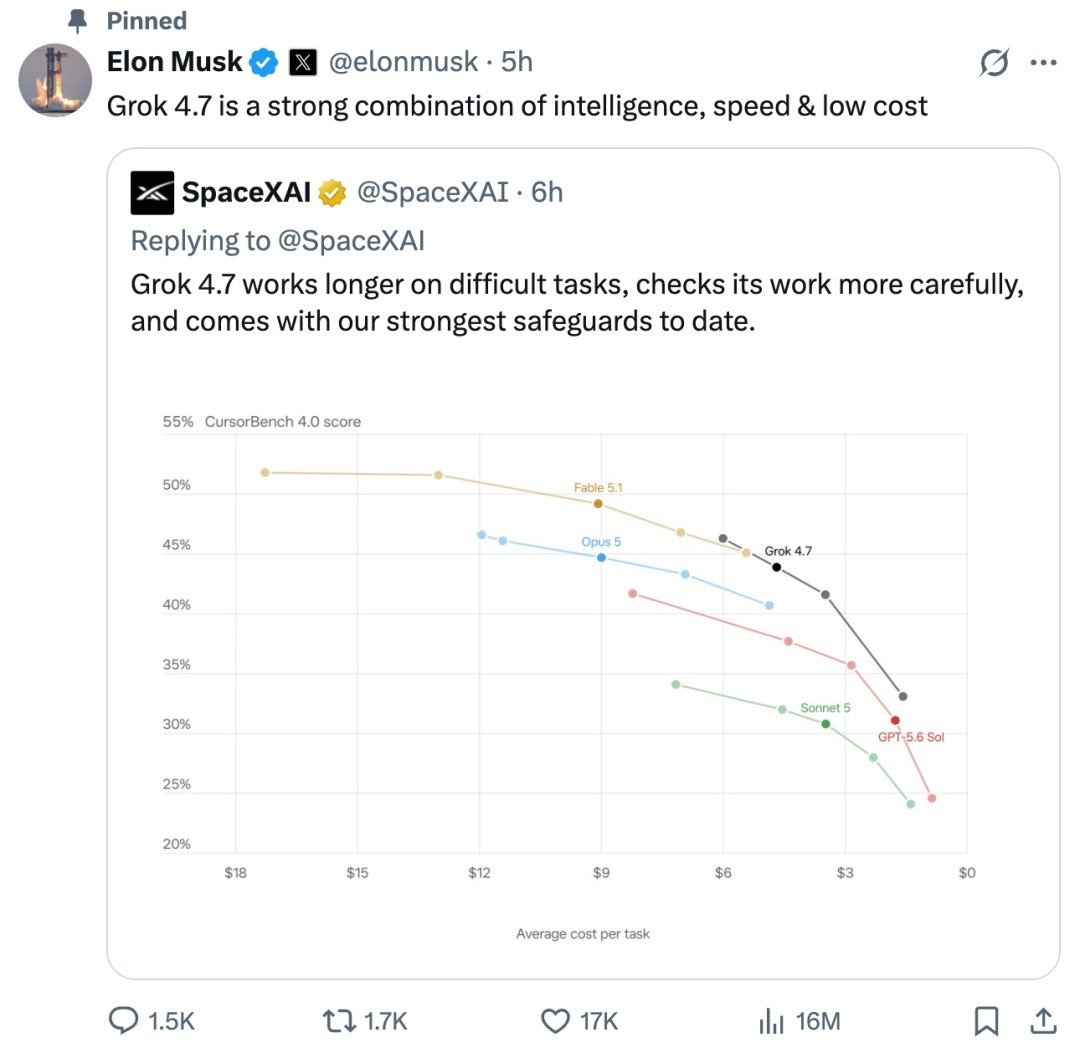
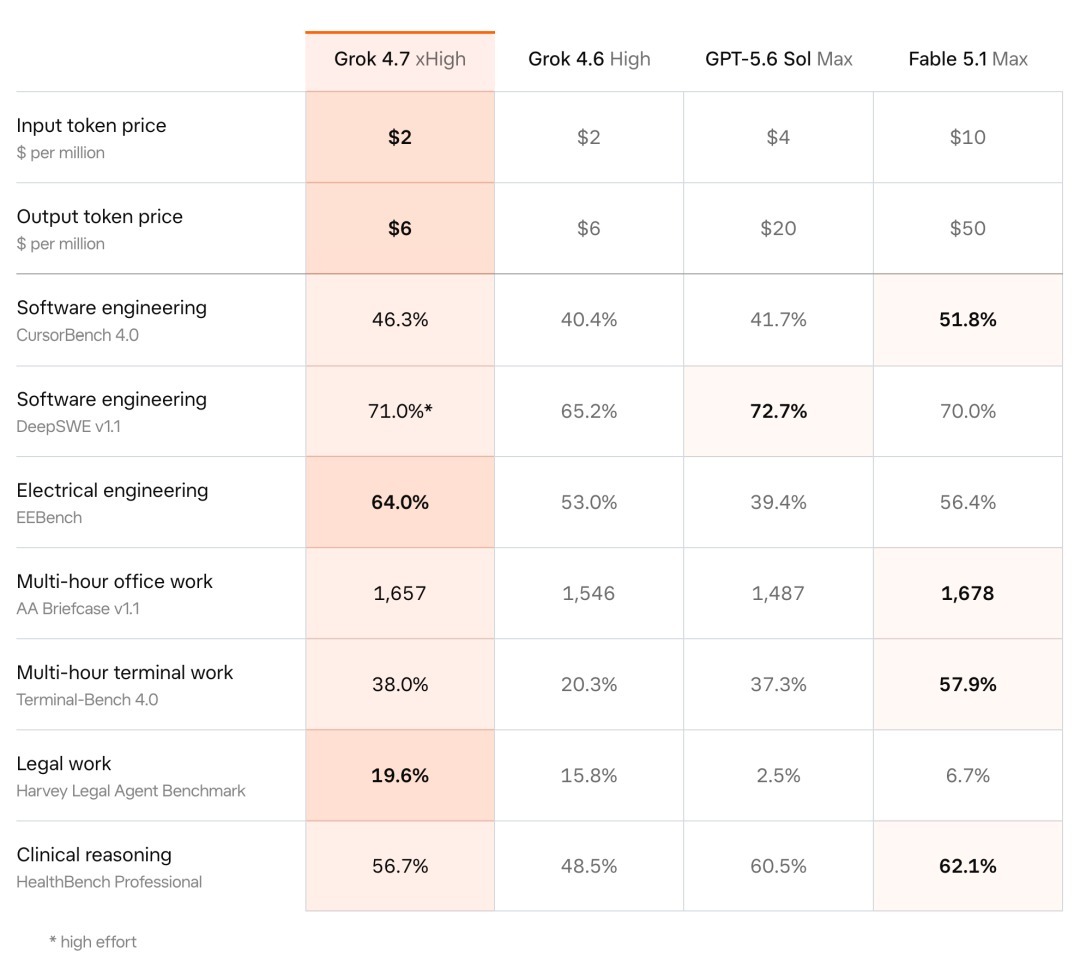
แม้ Grok 4.7 จะถูกวิจารณ์ว่าไม่ได้ครองทุกอันดับในตารางคะแนน แต่เมื่อมองผ่านเลนส์องค์กร ตัวเลขหลายชุดสะท้อนว่าโมเดลนี้ถูกจูนมาเพื่อความทนทานในงานยาวมากกว่าความเร็วดิบ ใน CursorBench 4.0 ซึ่งเน้นการพัฒนาโปรแกรมระยะยาว Grok 4.7 ทำได้ 46.3 เปอร์เซ็นต์ เทียบกับ Grok 4.6 ที่ 40.4 เปอร์เซ็นต์ เพิ่มขึ้น 5.9 จุด ส่วน Terminal-Bench 4.0 ที่วัดงานเทอร์มินัลหลายชั่วโมง โมเดลกระโดดจาก 20.3 เป็น 38.0 เปอร์เซ็นต์ ตัวเลขเหล่านี้มีความหมายต่อองค์กรที่ต้องการเอเจนต์โค้ดที่ไม่ล้มกลางทางมากกว่าความฉลาดเฉพาะช่วงสั้น การประเมินจากผู้ประเมินอิสระก็เสริมภาพนี้ Artificial Analysis วัด Grok 4.7 ที่ Intelligence Index 46 เทียบกับ 44 ของ Grok 4.6 และ Coding Agent Index 56 เทียบกับ 47 พร้อมทั้งลดอัตราภาพหลอนจาก 34 ลงเหลือ 29 เปอร์เซ็นต์ บนงานมืออาชีพอย่าง AA‑Briefcase และ GDPval โมเดลเก็บคะแนน Elo สูงขึ้นชัดเจน โค้ตที่องค์กรควรสนใจคือว่า ในการวัดหนึ่งชุด Grok 4.7 ใช้โทเคนเอาต์พุตเฉลี่ยราวสองเท่าของ Grok 4.6 ต่อภารกิจ แต่แลกกับการให้เหตุผลที่เข้มข้นขึ้นและการตรวจงานตัวเองก่อนเดินหน้าต่อ ในบริบทธุรกิจ นี่คือการยอมใช้ทรัพยากรเพิ่มเพื่อแลกกับการลดงานซ้ำ ลดการรีรัน และลดความเสี่ยงจากคำตอบเพ้อที่เขียนงานทั้งระบบพัง
AWS infrastructure ทำให้ enterprise AI deployment ง่ายขึ้นแค่ไหน
จุดแข็งที่มองข้ามไม่ได้คือการที่ Grok 4.7 ถูกห่ออยู่ในโครงสร้างพื้นฐาน AWS AI models แบบ managed service แทนที่จะต้องให้ทีมไอทีไปดีพลอยโมเดลเอง บน Bedrock โมเดลรับอินพุตข้อความและรูปภาพและส่งคืนข้อความ ผ่าน endpoint bedrock-runtime ใช้โปรไฟล์การสรุปผลข้ามภูมิภาค เช่น us.xai.grok-4.7 หรือ global.xai.grok-4.7 บนเส้นทาง /openai/v1 ความเข้ากันได้กับ OpenAI API และการรองรับ Responses API Chat Completions InvokeModel และ Converse ทำให้องค์กรที่มีโค้ดเดิมอยู่แล้วปรับระบบได้โดยแทบไม่ต้องเขียนทุกอย่างใหม่ โมเดลยังเชื่อมกับฟีเจอร์มาตรฐานของ Bedrock เช่น การแคชพรอมต์อัตโนมัติสำหรับคำนำที่ซ้ำ การแนบ Bedrock Guardrails เพื่อกรองเนื้อหา ลบข้อมูลส่วนบุคคล และบังคับนโยบายคำ รวมถึงการบังคับให้ผลลัพธ์อยู่ใน JSON Schema เพื่อให้โค้ดถัดไปแยกวิเคราะห์ได้ตรง จากมุมมอง enterprise AI deployment นี่หมายถึงการทดลองหลายผู้ให้บริการ AI ผ่านโครงสร้างเดียว การตั้งสิทธิ์ผ่าน IAM ปกติ และการบันทึกการเรียกทุกครั้งลง CloudWatch พร้อมจำนวนโทเคนและโทเคนให้เหตุผล องค์กรที่ต้องการเปรียบเทียบโมเดลหลายเจ้าไม่จำเป็นต้องสร้างสแตกใหม่ทุกครั้ง ลดต้นทุนการบำรุงรักษาและความซับซ้อนเชิงปฏิบัติการลงอย่างชัดเจน
โปรไฟล์ Global, ชั้นบริการ และความปลอดภัย สำหรับทีมองค์กรที่คิดยาว
สำหรับทีมองค์กร การใช้ Grok 4.7 ผ่าน Amazon Bedrock ไม่ใช่เรื่องโมเดลอย่างเดียว แต่เป็นการเลือกโปรไฟล์และชั้นบริการให้เข้ากับกลยุทธ์ข้อมูลและปริมาณงาน โปรไฟล์ Global จะส่งคำขอไปยัง AWS Region เชิงพาณิชย์ที่รองรับใดก็ได้ กระจายภาระงานไปยังความจุที่มากขึ้นและตั้งราคาไว้ต่ำกว่าการระบุภูมิศาสตร์ แลกกับการควบคุมตำแหน่งประมวลผลที่น้อยลงและความหน่วงเวลาที่แปรปรวนมากขึ้น ส่วนโปรไฟล์ US จะประมวลผลภายในภูมิภาคเดียว ตอบโจทย์ความต้องการด้านการเก็บข้อมูลที่ต้องการจำกัดพื้นที่ องค์กรยังเลือกชั้นบริการได้สามระดับ Standard เป็นการจ่ายต่อโทเคนโดยไม่มีสัญญา Priority ให้การประมวลผลเร็วขึ้นและได้คิวก่อนด้วยค่าบริการพรีเมียม ส่วน Flex ลดต้นทุนแต่เหมาะกับงานที่ไม่ต้องรีบ เมื่อรวมกับเกราะป้องกันใหม่ของ Grok 4.7 ที่ถูกออกแบบให้ปฏิเสธงานอันตรายโดยยังสนับสนุนภารกิจด้านความมั่นคงทางไซเบอร์และงานชีวภาพที่ถูกต้องตามกฎหมาย ภาพรวมคือบริการที่คิดมาสำหรับระบบโปรดักชัน ไม่ใช่แค่ sandbox ทดลอง การที่มีแคชพรอมต์ Guardrails ชั้นบริการหลายระดับ และโปรไฟล์ Global ให้ใช้ บอกชัดว่าโมเดลนี้ตั้งใจเข้าไปอยู่ในเวิร์กโฟลว์หลักขององค์กร ตั้งแต่เอเจนต์โค้ด ระบบวิเคราะห์เอกสาร ไปจนถึงงานวิจัยที่ต้องการเชื่อมต่อข้อมูลจำนวนมหาศาลในบริบทเดียว