
Grok 4.7 คืออะไร และทำไมสายเขียนโค้ดต้องหันมามอง
Grok 4.7 โมเดล AI คือรุ่นหลักใหม่จาก SpaceXAI ที่ออกแบบมาเพื่อการเขียนโค้ด งานความรู้ และการทำงานแบบ AI Agent โดยเฉพาะ มันต่อยอดจาก Grok 4.6 ด้วยโมเดลฐานขนาดใหญ่ขึ้น การเรียนรู้แบบเสริมแรงที่ยาวนานขึ้น และชุดระบบป้องกันใหม่ เป้าหมายคือให้โมเดลทำงานโครงการยาวหลายชั่วโมงได้อย่างต่อเนื่อง ตรวจสอบงานตัวเองได้ดีขึ้น และรองรับบริบทข้อความยาวในระดับที่เหมาะกับทีมพัฒนาที่ใช้ AI ร่วมกับเครื่องมือและเอเจนต์หลายตัวพร้อมกัน
หัวใจของเรื่องนี้คือ SpaceXAI ไม่ได้แค่เปิดตัวโมเดลใหม่ แต่กำลังประกาศว่าความสามารถเขียนโค้ดระดับสูงไม่จำเป็นต้องมาพร้อมราคา API ระดับพรีเมียมอีกต่อไป Grok 4.7 ถูกวางเป็นรุ่นสำหรับการเขียนโค้ดและงานความรู้อย่างชัดเจน โดยบริษัทระบุว่าเป็นรุ่นที่ทรงพลังที่สุดของตนในหมวดนี้ และเปิดตัวเมื่อวันที่ 21 กันยายน 2026 เพื่อสานต่อจังหวะปล่อยรุ่นย่อยถี่มากหลังจาก Grok 4.5 และ 4.6 เพียงไม่กี่เดือน
โครงสร้างใหม่ RL นานขึ้น และการผสานกับ Grok Bot เปลี่ยนเกม AI Agent
จุดต่างที่น่าสนใจที่สุดของ Grok 4.7 ไม่ใช่แค่ตัวเลขเบนช์มาร์ก แต่คือวิธีที่โมเดลถูกสร้างขึ้นใหม่จากฐาน ตามประกาศ โมเดลนี้ใช้โมเดลฐานที่ใหญ่กว่า Grok 4.6 และฝึกด้วยการเรียนรู้แบบเสริมแรงบนชุดงานที่ยากขึ้นนานขึ้น โดยเน้นโจทย์ที่ต้องใช้เวลาหลายชั่วโมงจึงจะเสร็จ นี่หมายความว่ามันถูกฝึกให้ทนงานยาว รักษาโฟกัส และตามรอยสถานะโครงการที่ซับซ้อน ซึ่งเป็นจุดเจ็บหลักของการใช้ AI ในโปรเจกต์จริง
ที่สำคัญกว่านั้น SpaceXAI ฝึก Grok 4.7 ให้เข้าใจโครงสร้างของ Grok Bot ซึ่งเป็นผลิตภัณฑ์เอเจนต์ของบริษัทอย่างเป็นธรรมชาติ ทำให้โมเดลจัดการงานสนทนาและงานความรู้ทั่วไปได้ดีขึ้น กล่าวอีกแบบคือ Grok 4.7 ไม่ได้เป็นแค่โมเดลตอบข้อความ แต่เป็นสมองกลางให้ทีม AI Agent ที่ทำงาน 24 ชั่วโมงในเครื่องมือและแอปต่างๆ การเขียนโค้ด AI จึงขยับจากแชตเดี่ยวไปสู่ทีมเอเจนต์ที่แบ่งงานกันทำได้จริง
เบนช์มาร์กและการเปรียบเทียบ GPT: ชนะบางสนาม แพ้บางจุด แต่ราคาเขย่าตลาด
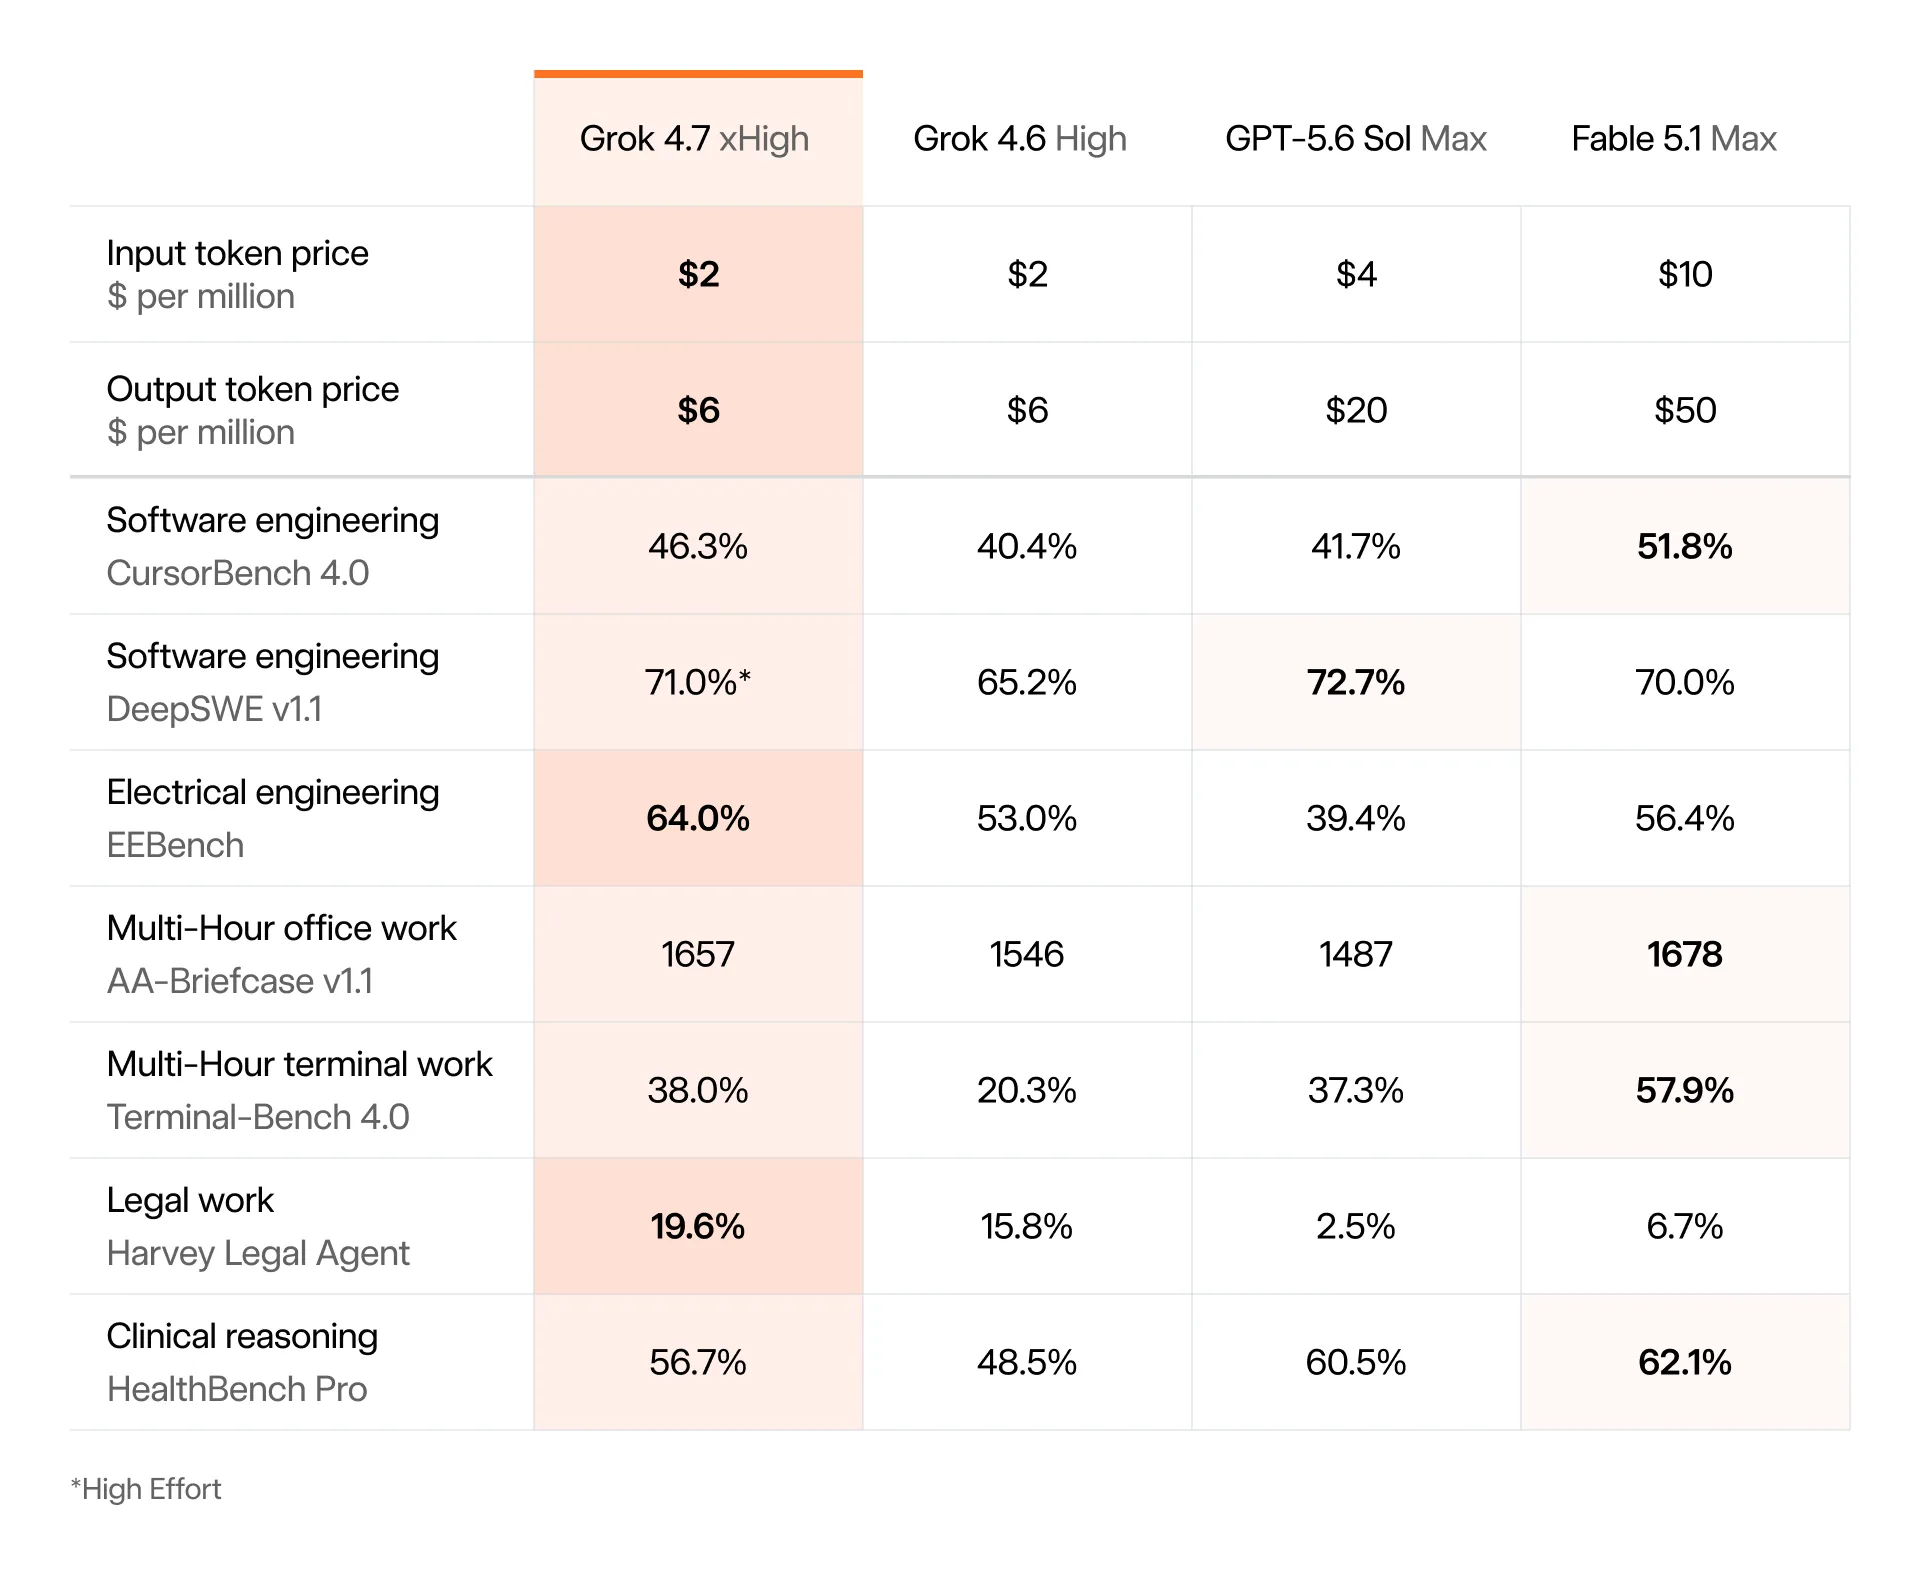
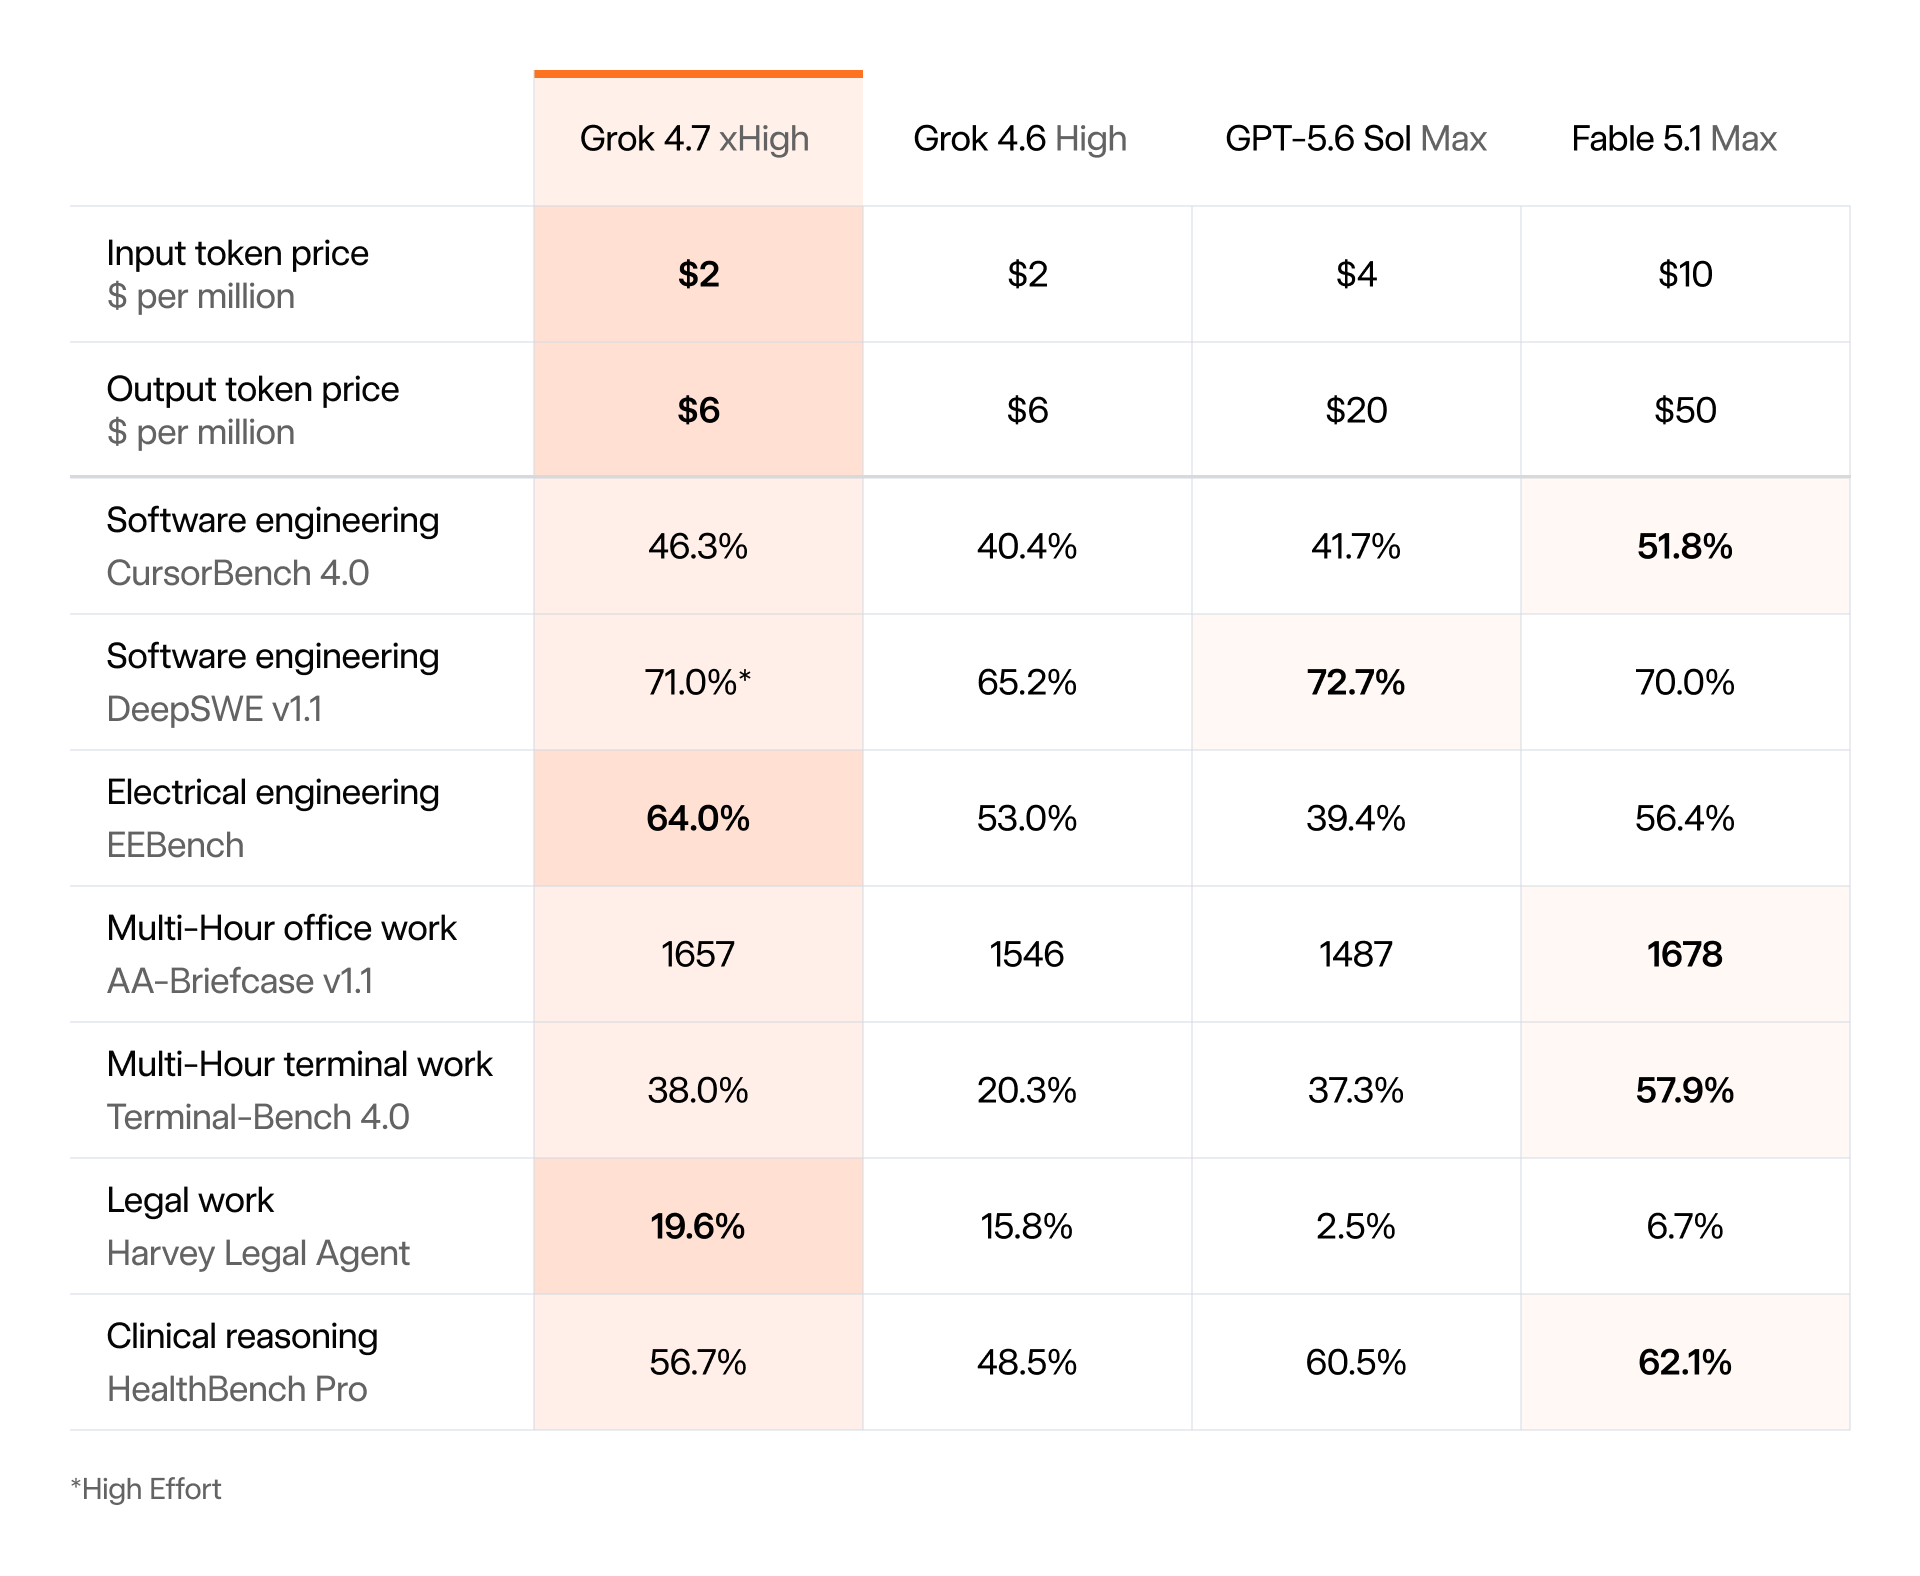
ในเชิงตัวเลข Grok 4.7 แสดงให้เห็นชัดเจนว่ามันไม่ใช่รองบ่อนของค่ายใหญ่แบบ GPT อีกต่อไป ใน CursorBench 4.0 ซึ่งโฟกัสงานเขียนโค้ดต่อเนื่อง Grok 4.7 ได้ 46.3% สูงกว่า Grok 4.6 และ GPT-5.6 Sol แต่ยังตามหลัง Fable 5.1 ที่ 51.8% อยู่บ้าง บน DeepSWE มันสูสี GPT-5.6 Sol และเหนือกว่า Fable 5.1 เล็กน้อย ขณะที่ใน EEBench และ Harvey Legal Agent Benchmark Grok 4.7 แซงทั้ง GPT-5.6 Sol และ Fable 5.1
ภาพรวมคือ Grok 4.7 ชนะ GPT-5.6 Sol ใน 5 จาก 7 เบนช์มาร์ก และแม้จะไม่ชนะ Fable 5.1 ทุกด้าน แต่ก็ขึ้นมาสู้ได้อย่างสูสี โดยเฉพาะด้านวิศวกรรมและกฎหมาย บนงานระดับมืออาชีพอย่าง GDPval โมเดลทำคะแนน Elo 1,695 สูงกว่า GPT-6 Astra และขยับเข้าใกล้ Fable 5.1 อย่างมีนัยสำคัญ ถ้ามองเฉพาะการเปรียบเทียบ GPT Grok 4.7 แสดงจุดยืนชัดว่าเป็นคู่แข่งตรง ไม่ใช่รุ่นรองราคาประหยัดแบบเดิมอีกต่อไป
ราคา API ถูกและความคุ้มค่า: โมเดลสายเขียนโค้ดที่บังคับให้ทุกค่ายต้องทบทวนราคา
แม้คะแนนเบนช์มาร์กจะดูสูสี แต่จุดที่ Grok 4.7 ทำให้ตลาดสะเทือนจริงคือความคุ้มค่าต่อราคา API ตามตารางเปรียบเทียบค่าโทเคน Grok 4.7 ถูกวางไว้ในระดับเดียวกับ Grok 4.6 ขณะที่ต้นทุนต่อโทเคนของ GPT-5.6 Sol และ Fable 5.1 สูงกว่าหลายเท่า บริษัทถึงกับบอกว่า Grok 4.7 อยู่ “แนวหน้าด้านราคาเทียบกับประสิทธิภาพ” บน CursorBench 4.0 เพราะให้คะแนนราว 46% ด้วยค่าใช้จ่ายต่อหนึ่งงานต่ำกว่าคู่แข่งอย่างชัดเจน
SpaceXAI ยังแสดงกราฟให้เห็นว่าเส้นโค้งราคาเทียบคะแนนของ Grok 4.7 อยู่เหนือหรือเทียบเท่าคู่แข่งส่วนใหญ่ที่ระดับการใช้จ่ายต่ำถึงกลาง รวมถึงรุ่นท็อปอย่าง Claude Opus 5, GPT-5.6 Sol และ Claude Sonnet 5 เมื่อประกบกับจุดขาย “ทำงานเร็วขึ้นสองเท่าในราคาครึ่งหนึ่งของรุ่นเทียบเคียง” ที่บริษัทระบุ กลยุทธ์นี้กดดันให้ผู้ให้บริการรายอื่นต้องคิดใหม่ทั้งเรื่องราคา API และโมเดลสำหรับเขียนโค้ด AI เพราะนักพัฒนาเริ่มมีตัวเลือกที่ทั้งเก่งและประหยัดกว่า
ความปลอดภัยและทิศทางต่อไป: จากเครื่องมือเขียนโค้ดสู่โครงสร้างพื้นฐานความปลอดภัยไซเบอร์
อีกมุมที่น่าสนใจคือ SpaceXAI ไม่ได้ขาย Grok 4.7 แค่ในฐานะโมเดลเขียนโค้ด แต่ยังวางเป็นเครื่องมือด้านความปลอดภัยไซเบอร์ บริษัทระบุว่า Grok 4.7 มาพร้อมชุดระบบป้องกันใหม่ทั้งหมด และเป็นโมเดลที่แข็งแรงที่สุดที่บริษัทเคยทดสอบในด้านการปฏิเสธคำขอที่ไม่ปลอดภัยและการต้านการเจลเบรก ในโดเมนสองด้านอย่างไซเบอร์และชีวภาพ โมเดลถูกออกแบบให้ทั้งช่วยงานที่ถูกต้องและลดความเสี่ยงการใช้ไปในทางผิด
ที่สะท้อนทิศทางอนาคตชัดคือ SpaceXAI เริ่มให้พันธมิตรด้านความปลอดภัยไซเบอร์บางรายเข้าถึงความสามารถ red-team ของ Grok 4.7 แบบเชิญเท่านั้นเพื่อใช้วิจัยด้านการป้องกัน ขณะเดียวกันยังเตรียมรุ่นย่อยแบบความเร็วสูงที่ให้ความเร็วเอาต์พุตเพิ่มขึ้นสองเท่าแลกกับราคาสูงขึ้นเท่าตัวสำหรับงานที่ต้องการตอบสนองไว เมื่อรวมกับความสามารถใน Grok Bot ภาพที่ชัดคือ Grok 4.7 กำลังถูกดันให้เป็นโครงสร้างพื้นฐาน AI Agent ที่ทั้งเขียนโค้ด ทำงานออฟฟิศ และช่วยป้องกันระบบไปพร้อมกัน
บทสรุป: Grok 4.7 เปลี่ยนสมการการเลือกโมเดลจาก “เก่งสุด” เป็น “คุ้มสุดต่อโปรเจกต์”
เมื่อมองภาพรวม Grok 4.7 โมเดล AI บังคับให้คำถามของทีมพัฒนาเปลี่ยนจาก “โมเดลไหนคะแนนสูงสุด” ไปเป็น “โมเดลไหนคุ้มสุดต่อหนึ่งโปรเจกต์” ในเชิงความสามารถ มันอาจไม่ชนะทุกเบนช์มาร์ก แต่คะแนนที่สูสีกับ GPT-5.6 Sol และ Fable 5.1 ประกอบกับการออกแบบเพื่อเขียนโค้ด งานความรู้ และ AI Agent โดยตรง ทำให้มันกลายเป็นตัวเลือกหลักของคนที่ต้องควบคุมต้นทุน API และต้องการให้เอเจนต์ทำงานยาวหลายชั่วโมงได้จริง
สำหรับนักพัฒนาและองค์กร นี่คือสัญญาณว่าการแข่งขันยุคใหม่ไม่ได้มีแค่การเปรียบเทียบ GPT กับคู่แข่ง แต่เป็นการแข่งขันของสถาปัตยกรรมเอเจนต์ ความคุ้มค่าต่อภารกิจ และมาตรการความปลอดภัย Grok 4.7 แสดงให้เห็นว่ารุ่นที่ราคา API ถูกสามารถไล่ทันและแซงรุ่นท็อปในบางด้านได้ ถ้าคุณกำลังวางระบบเขียนโค้ด AI หรือแพลตฟอร์ม Agent ใหม่ การไม่ทดลอง Grok 4.7 อาจหมายถึงการจ่ายแพงกว่าโดยไม่จำเป็น