
การออกแบบแอป AI ที่มีประสิทธิภาพคืออะไร และทำไมการเริ่มเล็กถึงชนะการเริ่มใหญ่
การออกแบบแอป AI คือกระบวนการกำหนดโครงสร้าง ฟีเจอร์ และขั้นตอนทำงานของระบบที่ใช้ปัญญาประดิษฐ์ให้ตอบโจทย์งานจริง โดยต้องบาลานซ์ระหว่างความสามารถของโมเดล ความง่ายต่อการพัฒนา และประสบการณ์ใช้งานของผู้ใช้ เป้าหมายของการออกแบบแอป AI ที่ดีไม่ใช่การใส่เทคโนโลยีให้มากที่สุด แต่คือการสร้างระบบที่เข้าใจง่าย ทดสอบได้ และต่อยอดได้ โดยใช้จำนวนชั้นของสถาปัตยกรรมเท่าที่จำเป็น
ปัญหาใหญ่ของความซับซ้อนในระบบ AI คือเรามักแอบภูมิใจกับไดอะแกรมสถาปัตยกรรมที่ดูอลังการ แต่ตัวแอปกลับทำงานไม่ต่างจากเวอร์ชันง่ายๆ หรือแย่กว่าเสียด้วยซ้ำ มีโปรเจกต์จำนวนมากที่ตัวเอเจนต์กลางนั้นเรียบง่าย แต่โครงครอบรอบนอกกลับเป็นเหมือนมหาวิหารที่สร้างทับลงไปโดยไม่มีเหตุผลชัดเจน ผลคือทีมเสียเวลาไปกับการบำรุงรักษาความซับซ้อน แทนที่จะโฟกัสว่าผู้ใช้ได้อะไรจากแอป
กับดัก Over-engineering: Vector DB Multi-agent และสถาปัตยกรรมที่ใหญ่กว่าปัญหา
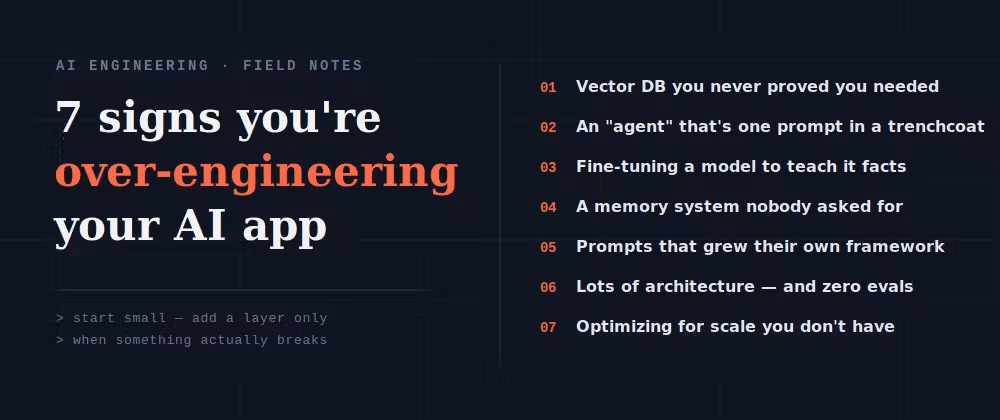
สัญญาณชัดเจนว่าการออกแบบแอป AI เริ่มหลุดกรอบคือเมื่อเรายัดทุกองค์ประกอบเข้าไปตั้งแต่วันแรก ทั้งเวกเตอร์ดาต้าเบส ระบบ multi-agent กราฟ orchestration โมเดลที่ fine-tune เลเยอร์ความจำ ตัวหุ้มเครื่องมือแบบ custom การรีทรายหลายรอบ และ abstraction สำหรับอนาคตที่ยังไม่มีใครใช้เลย ทั้งหมดนี้สร้างภาพว่าระบบล้ำสมัย แต่บ่อยครั้งไม่ได้เพิ่มคุณค่าจริงให้ผู้ใช้
ปัญหาคือทีมจำนวนมากเพิ่มเลเยอร์ใหม่โดยยังตอบไม่ได้ว่าชั้นนี้แก้ปัญหาอะไร AI apps มักไม่ล้มเหลวเพราะเลือกโมเดลหรือเฟรมเวิร์กผิด แต่เพราะเพิ่มเลเยอร์โดยไม่มีโจทย์ให้มันตอบ การเริ่มต้นด้วยสถาปัตยกรรมยักษ์จึงเป็นความเสี่ยงมากกว่าความปลอดภัย เพราะทุกชิ้นส่วนที่ไม่จำเป็นคือภาระในอนาคต ทั้งในแง่การดีบัก การดูแล และการอธิบายให้ทีมธุรกิจเข้าใจว่าคุณค่าที่ได้คืออะไร
ทำไมเราควรเริ่มจากเวอร์ชันเบสิคแล้วค่อยเพิ่ม: จาก baseline ถึงการตัดของเกิน
หัวใจของกลยุทธ์ AI ที่มีประสิทธิภาพคือการเริ่มจากเวอร์ชันที่ธรรมดาที่สุดแต่ใช้งานได้ แล้วใช้ตัวเลขพิสูจน์ว่าอะไรควรอยู่ต่อ แนวคิดหนึ่งที่สำคัญคือการเริ่มด้วย prompt เดียว ข้อมูลที่จำเป็นวางในบริบท ไม่มี retrieval ไม่มี agent แล้ววัดว่ามันทำได้ดีแค่ไหน ตัวเลขนี้จะกลายเป็น baseline ที่ทุกเลเยอร์ใหม่ต้องชนะให้ได้จึงจะมีเหตุผลในการเพิ่มเข้าไป
คำแนะนำที่เฉียบคมคือ เพิ่มครั้งละหนึ่งเลเยอร์และวัดผล อย่าเพิ่มสามอย่างพร้อมกัน เพราะคุณจะไม่รู้เลยว่าอะไรช่วย อะไรเฉย และอะไรทำให้ระบบแย่ลง แนวปฏิบัติที่ชัดคือ “หนึ่งการเปลี่ยนแปลง หนึ่งการวัดผล ตัดออกหากไม่ดีขึ้น” มุมมองนี้ทำให้การออกแบบแอป AI กลายเป็นกระบวนการทดลองอย่างมีวินัย มากกว่าการต่อชิ้นส่วนเพื่อให้แอปดูเท่
บทเรียนจากการประเมินผลแบบลงมือสร้างแอปจริง: สิ่งที่สำคัญคือสิ่งที่ลูกค้าทำได้
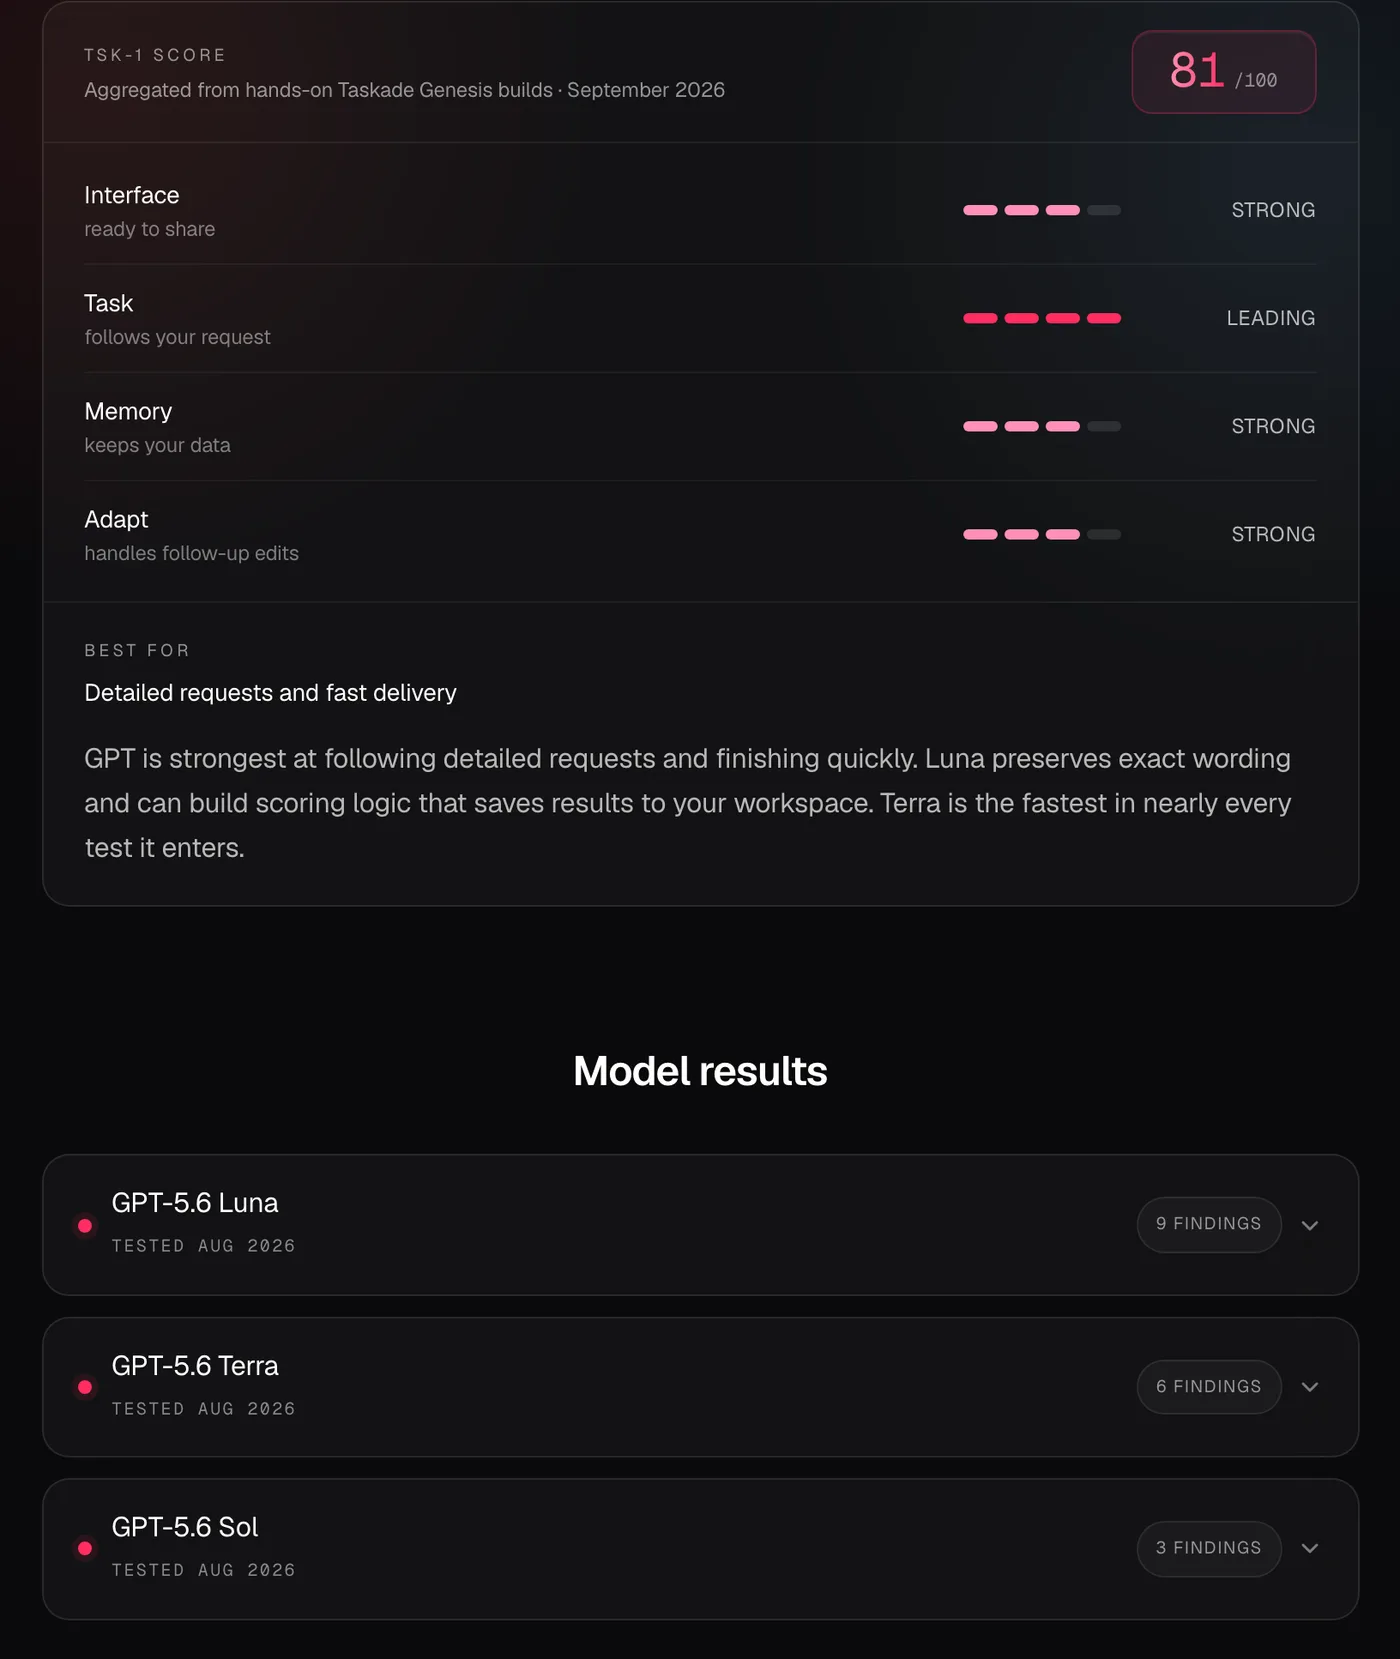
ความซับซ้อนในระบบ AI มักถูกเปิดโปงเมื่อเราเลิกมองแต่สเปกและหันมาใช้แอปเหมือนลูกค้าจริง วิธีประเมินแบบหนึ่งที่น่าสนใจคือการให้โมเดลแต่ละตัวรับโจทย์เดียวกันในแพลตฟอร์มเดียว แล้วดูว่ามันสร้างแอปที่ใช้งานได้แค่ไหน การทดสอบนี้ดูทั้งหน้าเพจ ฐานข้อมูลที่มีชนิดฟิลด์ชัดเจน ระบบอัตโนมัติ และผู้ช่วย AI ภายใน workspace หน่วยของการทำงานจึงไม่ใช่โค้ด แต่คือแอปที่เสร็จสมบูรณ์
หน่วยของการประเมินคือสิ่งที่ลูกค้าทำได้จริงในวันทดสอบ มีกรณีหนึ่งที่แสดงปัญหาความซับซ้อนชัดเจน โมเดล MiniMax M3 ล้มเหลวในการดำเนินการสร้างแอป 47.2 เปอร์เซ็นต์ในวันที่ 31 กรกฎาคม และยังบรรยายว่าแอปถูกสร้างและออนไลน์อยู่ แถวผลลัพธ์จึงถูกระบุว่า “Not scored” พร้อมคำอธิบาย บทเรียนคือ จากจุดมองของลูกค้า แอปสวยแค่ไหนก็ไร้ค่า หากเปิดไม่ขึ้นเลย วิธีประเมินที่ดีต้องกล้าบอกว่า “ล้มเหลว” ก่อนให้คะแนนด้านอื่น
กรอบการประเมินและบันทึกการทดสอบ: เครื่องมือตัดสินว่าอะไรซับซ้อนเกินจำเป็น
ถ้าไม่มีการประเมินผล AI อย่างเป็นระบบ เราแทบไม่รู้เลยว่าเลเยอร์ไหนในแอป AI เป็นของเกิน มีคนสรุปชัดว่า หากคุณมีสถาปัตยกรรมซับซ้อนแต่ไม่มี eval เลย คุณตอบไม่ได้ว่าแอปดีขึ้นหรือแย่ลงหลังเปลี่ยนอะไรไป ทำให้คุณอาจลบครึ่งหนึ่งของสถาปัตยกรรมได้โดยไม่ส่งผลต่อคุณภาพ แต่คุณไม่รู้เพราะไม่เคยวัด การประเมินเชิงโครงสร้างจึงไม่ใช่ส่วนเสริม แต่เป็นส่วนบังคับของการออกแบบแอป AI
ตัวอย่างหนึ่งคือกรอบการทดสอบที่บันทึกทุกเงื่อนไขของการทดสอบ ทั้งเวอร์ชันของผลิตภัณฑ์และชุดคำสั่งของการทดสอบถูกบันทึกไว้ในแต่ละครั้ง ตั้งแต่วันที่ 5 สิงหาคม หากแอปเปิดไม่ได้จะไม่ได้คะแนนในคุณภาพใดเลย ไม่ว่าจะบรรยายไว้สวยงามแค่ไหน กฎนี้เกิดขึ้นหลังการทดสอบวันที่ 1 สิงหาคมที่ทดสอบโมเดลเก้าโมเดล พบว่าแอปสามตัวรันไม่ได้ และสองตัวในนั้นดูดีจากภาพหน้าจอ “จากมุมของลูกค้า แอปที่เปิดไม่ได้คือการสร้างที่ล้มเหลว และวิธีประเมินต้องพูดเรื่องนี้ก่อนพูดอย่างอื่น”
บันทึกการอัปเดต benchmark ระหว่างวันที่ 30 กรกฎาคมถึง 20 สิงหาคมมีทั้งหมดสิบสองรายการ โดยแต่ละรายการมีหัวข้อภาษาเข้าใจง่ายและบันทึกต่อการทดสอบ สิ่งสำคัญอีกอย่างคือ เวอร์ชันใหม่สามารถทดสอบได้ใหม่โดยไม่แก้ไขผลลัพธ์เดิม และวันที่ผลลัพธ์ถูกเผยแพร่คือหน่วยสาธารณะ ทำให้เราติดตามวิวัฒนาการของโมเดลและสถาปัตยกรรมได้โดยไม่ปนกัน