
เลือกจากรูปแบบงาน ไม่ใช่เดโม
โมเดล TTS โลคัล คือระบบแปลงข้อความเป็นเสียงที่ประมวลผลบนอุปกรณ์หรือเซิร์ฟเวอร์ของผู้ใช้เอง แทนการส่งข้อความไปยังผู้ให้บริการภายนอก จึงลดการพึ่งพาเครือข่ายและช่วยให้ควบคุมข้อมูลได้มากขึ้น แต่ต้องแลกกับข้อจำกัดด้านภาษาและกำลังเครื่อง
ถ้างานต้องตอบโต้ทันที ทำงานออฟไลน์ หรือมีข้อความที่ไม่ควรออกจากระบบ โลคัลเป็นตัวเลือกที่ได้เปรียบชัดเจน แต่ถ้าต้องใช้หลายภาษา เสียงหลากหลาย หรือการปรับอารมณ์และโคลนเสียง บริการคลาวด์ตอบโจทย์กว่า จุดตัดสินใจจึงไม่ใช่แค่เสียงแบบไหนฟังดีกว่า แต่คือความหน่วงที่ยอมรับได้ และข้อจำกัดด้านข้อมูลกับภาษา
ความเร็วประมวลผลที่ต่ำไม่ได้แปลว่าประสบการณ์จะเร็วเสมอไป หากอุปกรณ์ช้า หรือมีงานอื่นแย่งทรัพยากร ส่วน API คลาวด์ยังต้องผ่านเครือข่ายและขึ้นกับภาระของบริการด้วย สำหรับงานที่ต้องให้เสียงเริ่มพูดแทบจะทันที โมเดลบนเครื่องมีข้อได้เปรียบโดยตรง ส่วนงานสร้างเสียงเป็นชุดหรือเน้นการปรับแต่ง คลาวด์มักสะดวกกว่า
ความหน่วงที่ต่างกันมีผลกับบทสนทนา
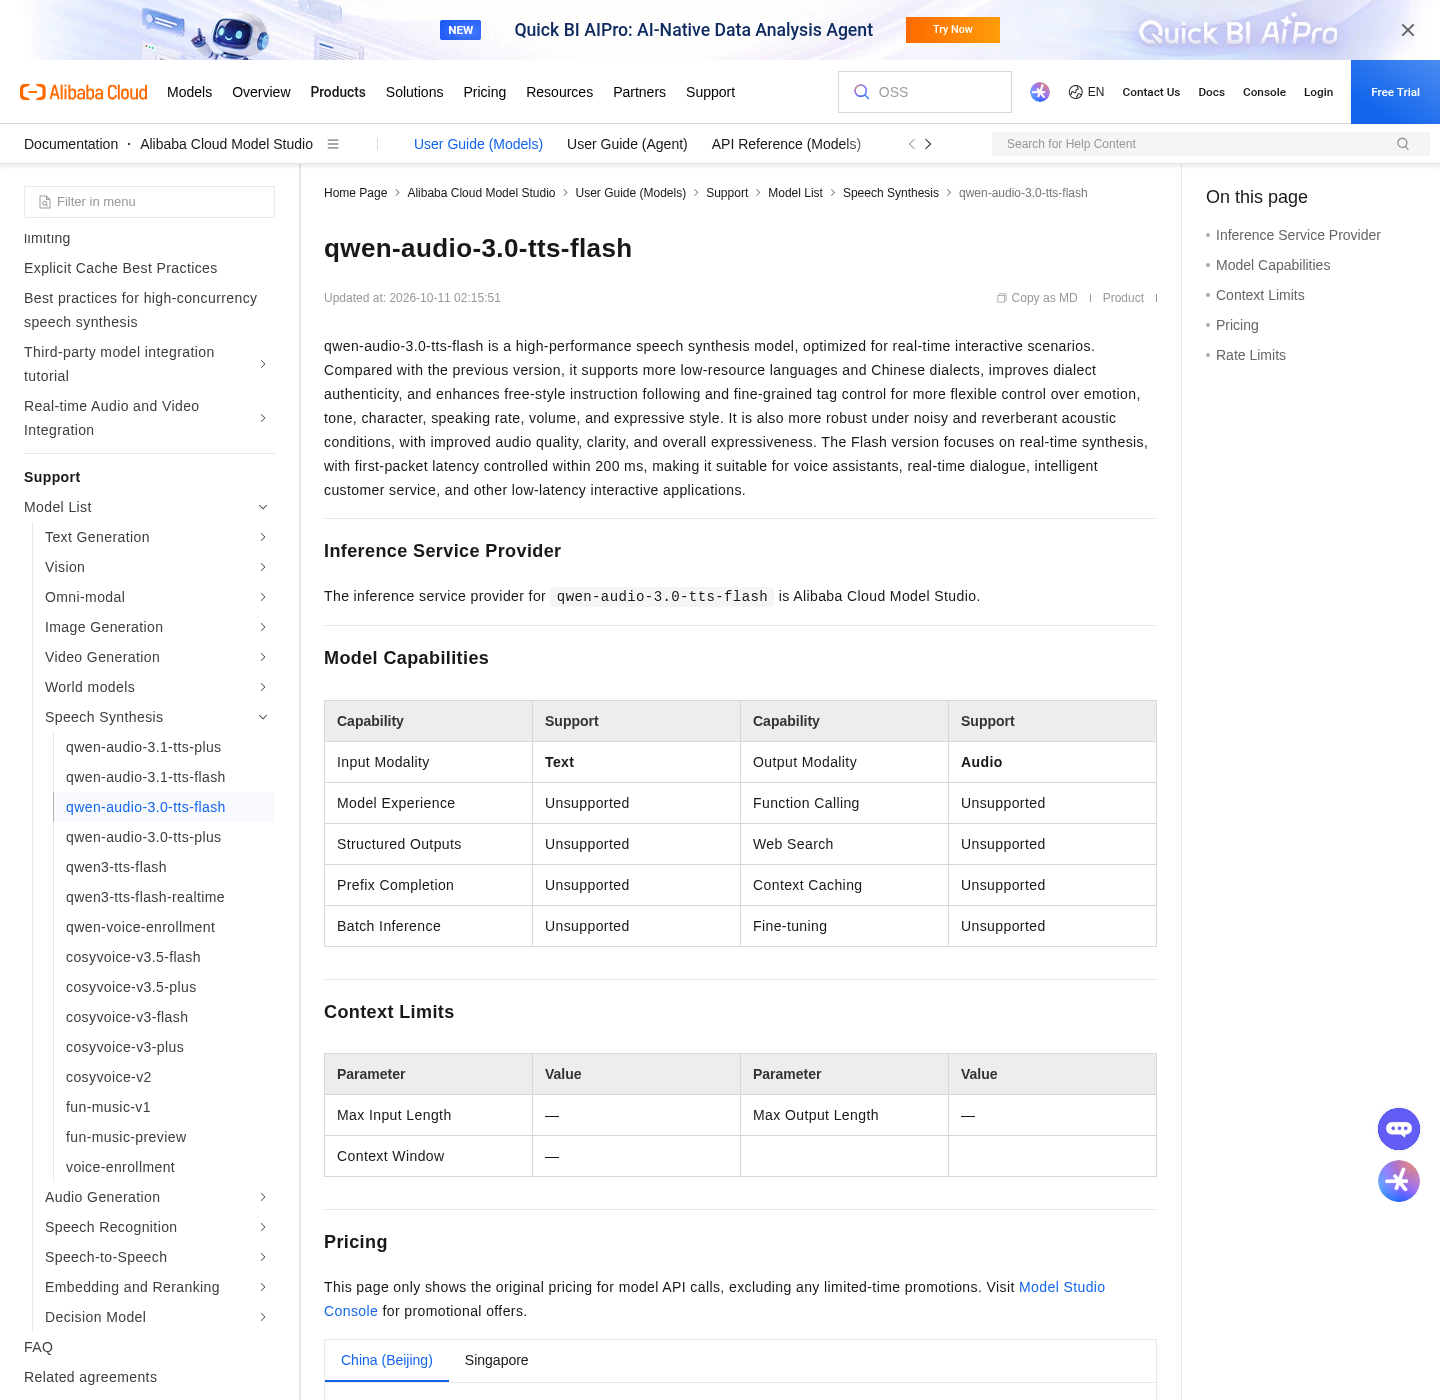
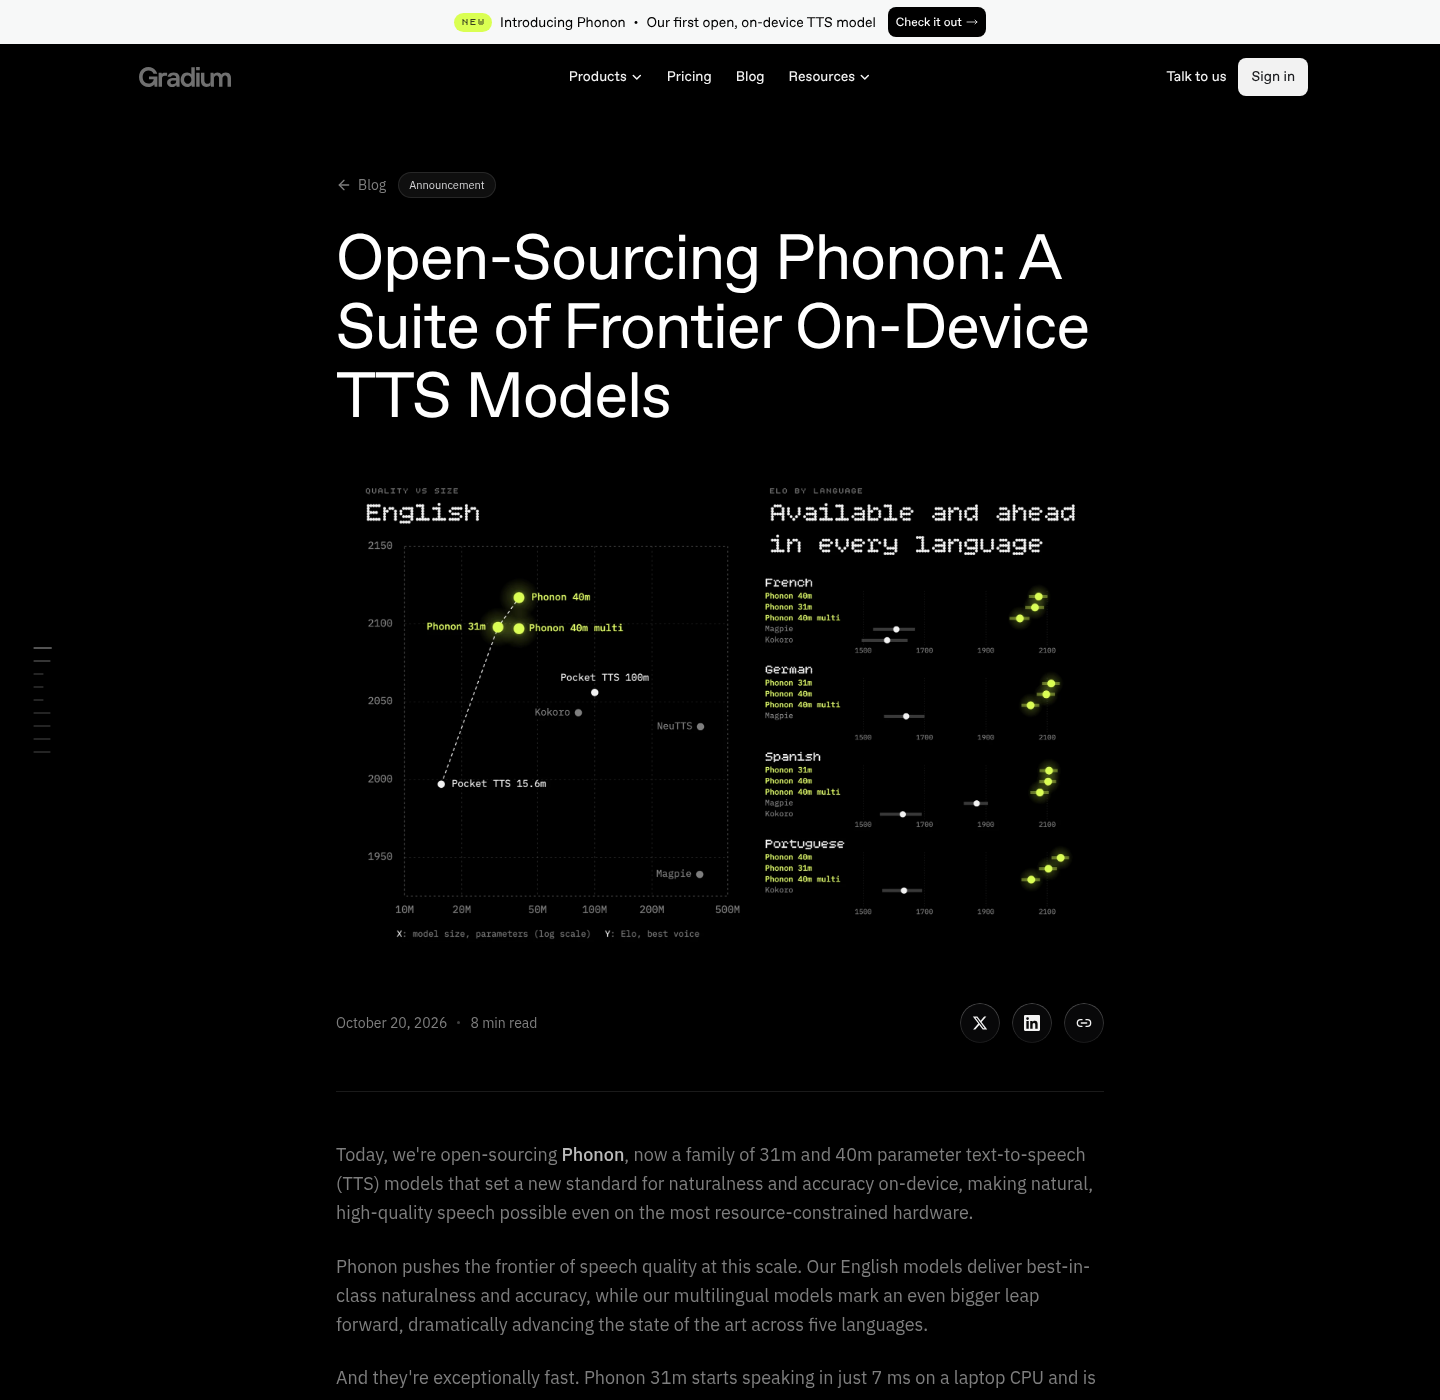
ตัวเลขอ้างอิงชี้ให้เห็นช่องว่างที่น่าสนใจ: Phonon 31M สร้างเสียงภาษาอังกฤษบนเครื่องได้ราว 7 มิลลิวินาที ขณะที่ Qwen Audio 3.0 TTS ระบุเวลาเริ่มส่งเสียงจาก API ต่ำกว่า 200 มิลลิวินาที ตัวเลขนี้ไม่ได้รวมเวลาเครือข่ายก่อนถึงบริการ และไม่ควรถือเป็นผลทดสอบที่เทียบกันทุกเงื่อนไข แต่บอกได้ว่าโลคัลเหมาะกับการโต้ตอบที่ไวต่อความหน่วงกว่า
| ข้อมูลเปรียบเทียบ | Phonon 31M แบบโลคัล | Qwen Audio 3.0 TTS แบบคลาวด์ |
|---|---|---|
| เวลาเริ่มสร้างเสียงที่รายงาน | ประมาณ 7 มิลลิวินาที | ต่ำกว่า 200 มิลลิวินาทีหลังคำขอถึงบริการ |
| ภาษา | ภาษาอังกฤษ | 16 ภาษา |
| รูปแบบเสียง | เอาต์พุต 24 กิโลเฮิรตซ์ | เอาต์พุต 48 กิโลเฮิรตซ์ |
| วิธีใช้งาน | ประมวลผลในอุปกรณ์หรือเครื่องของผู้ใช้ | เรียกใช้ผ่าน API ไม่มีไฟล์น้ำหนักสำหรับติดตั้งเอง |
สำหรับผู้ช่วยเสียงหรือระบบตอบลูกค้าแบบโต้ตอบ ค่าเริ่มเสียงมีผลต่อความรู้สึกว่าระบบตอบทันใจหรือไม่ ส่วนงานผลิตเสียงล่วงหน้า ความต่างระดับนี้อาจไม่สำคัญเท่าคุณภาพ ภาษา และการจัดการปริมาณงาน อย่างไรก็ตาม ตัวเลข 7 มิลลิวินาทีเป็นข้อมูลจากผู้พัฒนา และยังไม่มีผลทดสอบอิสระยืนยัน จึงควรวัดบนอุปกรณ์จริงก่อนเลือกใช้
ภาษา ข้อมูล และต้นทุนที่ต้องชั่งใจ
Qwen ได้เปรียบสำหรับผลิตภัณฑ์หลายภาษา เพราะรองรับ 16 ภาษา มีเสียงให้เลือกและรองรับการโคลนเสียงจากคลิปอ้างอิง รวมถึงคำสั่งกำกับอารมณ์ในข้อความ ส่วน Phonon 31M เน้นภาษาอังกฤษและมีเสียงคงที่ 37 เสียง จึงเหมาะกับงานภาษาอังกฤษที่ต้องการตอบสนองไว มากกว่างานที่ต้องรองรับผู้ใช้หลายภาษา ความต่างนี้ทำให้การเลือกโลคัลหรือคลาวด์ขึ้นอยู่กับผู้ใช้จริง ไม่ใช่แค่จำนวนฟีเจอร์
โลคัลช่วยให้ข้อความและเสียงอยู่ในระบบของผู้ใช้ และไม่ต้องพึ่งการเชื่อมต่อเพื่อสร้างเสียง แต่ทีมต้องเตรียมอุปกรณ์ ดูแลการติดตั้ง และเผื่อกำลังประมวลผลเมื่อมีงานพร้อมกัน ขณะที่เสียงพูด AI คลาวด์ลดภาระการดูแลโมเดลเอง แต่การใช้งานผูกกับเครือข่ายและต้นทุน API ซึ่งควรประเมินจากจำนวนการเรียกใช้จริง โดยไม่อาจตัดสินว่าทางใดถูกกว่าได้หากยังไม่รู้ปริมาณงานและต้นทุนโครงสร้างพื้นฐาน
ตัวอย่างจากโมเดลแปลภาษาของ Tencent ช่วยให้เห็นขอบเขตของฮาร์ดแวร์ฝั่งโลคัล แม้จะไม่ใช่ผลทดสอบ TTS: Hy-MT2-1.8B ใช้พื้นที่ราว 440 เมกะไบต์และออกแบบให้ทำงานบนโทรศัพท์ได้ ขณะที่ Hy-SimulMT-30B-A3B ต้องใช้ตัวเร่งประมวลผลหน่วยความจำ 80 กิกะไบต์ ตัวเลขนี้ไม่ควรนำไปเทียบประสิทธิภาพเสียงพูดโดยตรง แต่เตือนว่าคำว่าโลคัลครอบคลุมตั้งแต่มือถือไปจนถึงเครื่องระดับสูง
Buy if / Skip if
- Buy the Phonon 31M if งานของคุณใช้ภาษาอังกฤษ ต้องเริ่มสร้างเสียงไว ทำงานออฟไลน์ หรือไม่ต้องการส่งข้อความออกนอกระบบ
- Skip the Phonon 31M if ต้องรองรับหลายภาษา โคลนเสียง หรือปรับรูปแบบเสียงได้หลากหลาย เพราะรุ่นนี้เน้นภาษาอังกฤษและชุดเสียงที่กำหนดไว้
- Buy the Qwen Audio 3.0 TTS if ต้องการเสียงหลายภาษา การปรับอารมณ์ หรือโคลนเสียง และยอมรับการเรียกใช้ผ่านเครือข่ายได้
- Skip the Qwen Audio 3.0 TTS if ข้อความต้องอยู่ในอุปกรณ์ ต้องทำงานโดยไม่มีอินเทอร์เน็ต หรือความหน่วงจากเครือข่ายไม่เหมาะกับบทสนทนาแบบทันที
- Buy the โมเดลโลคัล if ทีมมีอุปกรณ์รองรับและต้องการควบคุมข้อมูลกับค่าใช้จ่ายระยะยาวด้วยการประเมินภาระงานเอง
- Skip the โมเดลโลคัล if ไม่ต้องการดูแลฮาร์ดแวร์และระบบติดตั้ง หรือจำเป็นต้องขยายงานหลายภาษาโดยเร็ว