
สรุปภาพใหญ่: ทำไมสตาร์ทอัพควรสนใจ 26 โมเดล AI เปิดของ Microsoft ตอนนี้
โมเดล AI สำหรับสตาร์ทอัพบน Microsoft Foundry คือชุดโมเดลเปิด 26 รายการที่ให้บริการผ่านการรวม Fireworks AI ซึ่งช่วยให้ทีมขนาดเล็กสามารถรันอินเฟอร์เรนซ์ที่มีประสิทธิภาพสูงและหน่วงต่ำโดยไม่ต้องตั้งค่าคลัสเตอร์ GPU เอง ลดต้นทุนที่ควบคุมได้ของงานอินเฟอร์เรนซ์ และเปิดทางให้เลือก ปรับแต่ง และสลับโมเดลให้ตรงกับงานของผลิตภัณฑ์ได้อย่างยืดหยุ่นในสภาพแวดล้อม Azure ของตัวเอง.
แกนสำคัญของการเปลี่ยนแปลงคือการที่ไมโครซอฟท์ผลักดันการรวม Fireworks AI ซึ่งเปิดให้ใช้งานทั่วไปในกลุ่มสตาร์ทอัพ และเผยแพร่แผนการ deployment สำหรับการทำงานแบบเปิดบน Microsoft Foundry เมื่อวันที่ 4 สิงหาคม 2026. การประกาศนี้ไม่ใช่แค่เพิ่มตัวเลือกโมเดล แต่คือการย้ายพลังการตัดสินใจเรื่องสถาปัตยกรรม AI กลับไปอยู่ในมือผู้ก่อตั้งแทนที่จะผูกกับผู้ให้บริการโมเดลเดียว. หลายทีมเคยเริ่มด้วยโมเดลแบบปิดตัวเดียวเพราะออกแบบต้นแบบเร็ว แต่การเลือกโมเดลสำหรับโหลดงานจริงจะส่งผลสะสมต่อทั้งต้นทุนและการแตกต่างของผลิตภัณฑ์ตลอดอายุโครงการ. จากมุมมองผู้ประกอบการ การอัปเดตครั้งนี้จึงเป็นโอกาสเชิงกลยุทธ์ ไม่ใช่เพียงการเปิดฟีเจอร์ใหม่.
| ประเด็น | ก่อนหน้า | หลังรวม Fireworks AI |
|---|---|---|
| การเลือกโมเดล | โฟกัสโมเดลปิดตัวเดียว | เข้าถึงโมเดลเปิดหลากหลาย 26 รายการ |
| โครงสร้างพื้นฐาน | ต้องวาง GPU เองหรือใช้บริการเฉพาะกิจ | Fireworks ให้บริการอินเฟอร์เรนซ์บน Foundry ภายใน Azure |
| ยืดหยุ่นเชิงเทคนิค | เปลี่ยนโมเดลยากและเสี่ยงต่อการล็อกอินผู้ให้บริการ | สลับและทดลองโมเดลผ่าน API ที่สม่ำเสมอได้ง่าย |
โครงสร้าง Microsoft Foundry + Fireworks AI: ทางลัดสู่ AI infrastructure สำหรับ startup
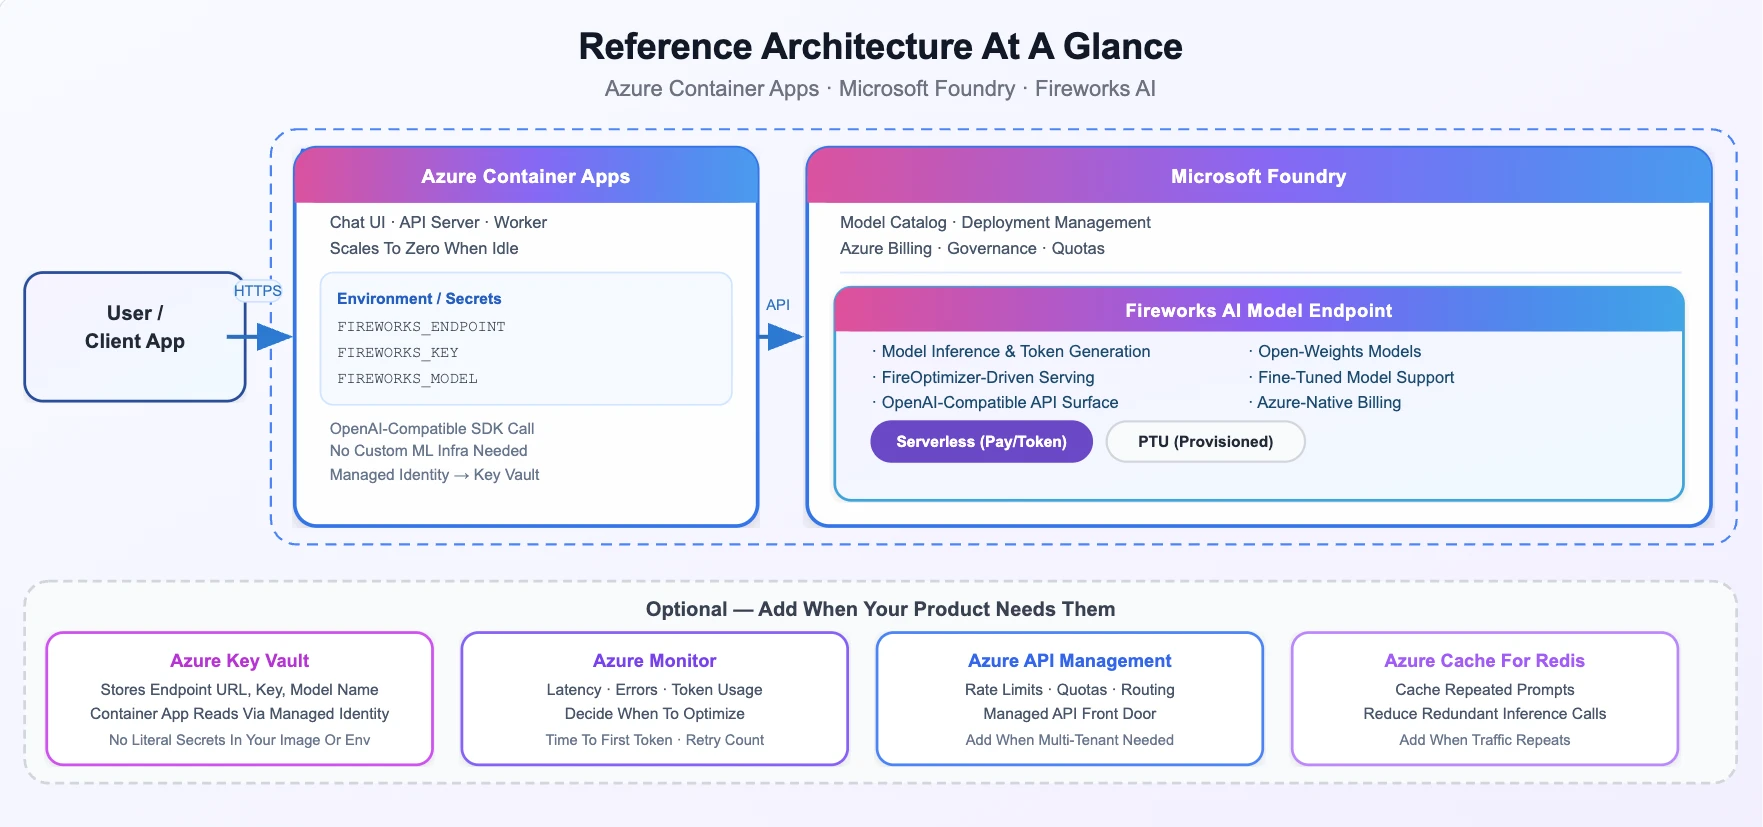
หัวใจของการเคลื่อนไหวครั้งนี้คือ Microsoft Foundry deployment ที่ฝัง Fireworks AI เข้าไปในสแต็ก Azure ของสตาร์ทอัพโดยตรง. ในเชิงสถาปัตยกรรม แอปพลิเคชันของคุณรันแบบคอนเทนเนอร์บน Azure Container Apps เรียกใช้งานจุดสิ้นสุดโมเดลของ Fireworks ซึ่งถูกจัดการผ่าน Foundry ภายใน subscription ของคุณเอง โดยมี Azure Container Registry เก็บอิมเมจ และ Azure Key Vault เก็บข้อมูลประจำตัวที่สำคัญ. จากนั้นคุณสามารถค่อยๆ ขยายโครงสร้าง: เพิ่ม Azure API Management เพื่อควบคุมการจราจรและการจำกัดอัตรา เพิ่ม Azure Cache for Redis เพื่อลดการเรียกซ้ำ และใช้ Azure Monitor ติดตามความหน่วง อัตราความผิดพลาด และการใช้โทเค็น.
จุดแข็งที่สุดสำหรับผู้ก่อตั้งคือ AI infrastructure สำหรับ startup ถูกลดภาระลงอย่างชัดเจน: คุณไม่ต้องสร้างหรือบริหารคลัสเตอร์ GPU เองอีกต่อไป เพราะ Fireworks ให้บริการอินเฟอร์เรนซ์ประสิทธิภาพสูง ขณะที่ Foundry ให้การกำกับดูแล ความปลอดภัย และการจัดการอายุใช้งานของโมเดล. บริการทำงานทั้งหมดในระนาบควบคุมเดียว ทำให้การค้นหาโมเดล การกำกับดูแล และการเรียกเก็บเงินอยู่ในระบบเดียวกัน. ตามข้อมูลของไมโครซอฟท์ สถาปัตยกรรมนี้ถูกออกแบบให้เริ่มต้นจากจุดสิ้นสุดแบบ serverless เพียงจุดเดียว และเพิ่มชิ้นส่วนเมื่อการใช้งานโตขึ้น ไม่ใช่บังคับให้ทีมลงทุนโครงสร้างพื้นฐานหนักตั้งแต่วันแรก. นี่คือแพตเทิร์นที่เหมาะมากกับทีม AI-native ที่ยังอยู่ในช่วงค้นหาตลาด.
26 โมเดล AI สำหรับสตาร์ทอัพ: เลือกให้ตรงงานและคุมต้นทุนอินเฟอร์เรนซ์
การรวม Fireworks AI integration ทำให้แค็ตตาล็อก Foundry มีโมเดลเปิดที่หลากหลาย 26 โมเดล พร้อมให้บริการผ่าน Azure. โมเดลเหล่านี้มาจากหลายผู้พัฒนา รวมถึง DeepSeek, Moonshot AI, Z.ai, MiniMax, Qwen, Google และไลน์ open-weight gpt-oss จาก OpenAI ที่ถูกวางไว้ในแค็ตตาล็อกโมเดล Azure ภายใต้การกำกับดูแลและการเรียกเก็บเงินของ Azure เอง. ตัวอย่างเช่น Kimi K2.5, DeepSeek V3.2, MiniMax M2.5, gpt-oss-120b และ DeepSeek V4 Pro ที่ถูกอธิบายว่าเป็นโมเดลเรือธงขนาด 1.6 ล้านพารามิเตอร์. จุดนี้คือจุดพลิกเกมสำหรับสตาร์ทอัพ เพราะคุณสามารถจับงานแต่ละประเภท — เช่น สรุปเนื้อหา การเขียนโค้ด หรือการช่วยงานธุรกิจ — ให้ตรงกับโมเดลที่มีค่าใช้จ่ายต่อโทเค็นเหมาะสมที่สุด และหลีกเลี่ยงการยึดติดกับผู้ให้บริการเพียงรายเดียว.
ในเชิงโมเดลการคิดค่าบริการ Foundry เสนอทั้งรูปแบบ serverless pay-per-token และหน่วยการเรียกเก็บแบบจัดสรรไว้ล่วงหน้า ซึ่งเป็นการจองความจุบน Azure. มี 6 โมเดล รวมถึง Kimi K2.6 และ GLM-5.1 จาก Z.ai ที่เปิดให้ใช้งานแบบจ่ายต่อโทเค็น ส่วนที่เหลือใช้หน่วยที่จัดสรรไว้ล่วงหน้า. แน่นอน โครงสร้างนี้มีข้อจำกัดและเส้นตาย เช่น การเรียกเก็บแบบจ่ายต่อโทเค็นสำหรับ GLM-5.1 และ MiniMax M2.5 จะไม่ใช้ได้หลังวันที่ 7 สิงหาคม 2026 แม้ทั้งสองยังมีให้บริการผ่านการจัดสรรไว้ล่วงหน้า และโมเดล pay-per-token อีกสี่รายการก็ถูกยกเลิกไปแล้ว. แต่อย่างไรก็ดี สำหรับสตาร์ทอัพ นี่คือจุดเริ่มต้นที่ดีในการสร้างวินัยด้านต้นทุน: คุณสามารถติดตามค่าใช้จ่ายต่อ ล้านโทเค็นเป็น metric วิศวกรรมหลัก เพื่อให้การเติบโตไม่หลุดกรอบ.
จาก MVP สู่ตลาด: ใช้สถาปัตยกรรม Foundry เพื่อบีบเวลาและลดความเสี่ยง
Microsoft ออกแบบ implementation blueprint ให้ตรงกับวิธีทำงานของ AI-native startups โดยเฉพาะ. แผนนี้ชี้ให้เห็นว่าทีมผู้ก่อตั้งและทีมเล็กสามารถเดินจากไอเดียสู่ MVP แล้วต่อไปยัง product-market fit ด้วยแนวทางบน Azure ที่ทำซ้ำได้: เริ่มจากการ deploy โมเดลเดียว เส้นทางทราฟฟิกผ่าน API Management และเก็บ metric ความหน่วง การใช้งาน และต้นทุนไปพร้อมกัน. เมื่อโหลดงานชัดขึ้น คุณสามารถเพิ่ม Azure Cache for Redis เพื่อลดอินเฟอร์เรนซ์ซ้ำ ปรับจูนประสิทธิภาพตามประเภทงาน และ deploy โมเดลหลายเวอร์ชันสำหรับ A/B test เพื่อหาว่าคอนฟิกไหนให้ผลลัพธ์และต้นทุนที่สมดุลที่สุด. ข้อดีคือการทดลองกับโมเดลใหม่ไม่ต้องทิ้งแพลตฟอร์มเดิม เพราะทุกอย่างยังรันบน Foundry ภายใต้ subscription เดิม.
จากมุมมองกลยุทธ์การผลิต สถาปัตยกรรมนี้ทำให้การตัดสินใจด้านโมเดลไม่กลายเป็นหนี้ทางเทคนิคในระยะยาว: เมื่อโหลดงานเริ่มนิ่ง ชุดการประเมิน Prompt library และทราฟฟิกจริงที่ถูกให้เกรดสามารถกลายเป็นข้อมูลฝึกสอน เพื่อให้ทีมปรับจูนโมเดลผ่าน Fireworks Training แล้วนำเข้า Azure ด้วยกระบวนการ bring your own weights. การเสิร์ฟ open models แบบนี้ทำให้คุณสามารถเลือก ปรับ และสลับโมเดลเบื้องหลังผลิตภัณฑ์เมื่อความต้องการด้านต้นทุนและประสิทธิภาพเปลี่ยนไป. กล่าวอีกแบบ หนึ่ง API เดียวสามารถขับเคลื่อนตั้งแต่การทดลองสเกลเล็กไปจนถึงผลิตที่รองรับทราฟฟิกระดับองค์กร โดยไม่ต้องเขียนระบบใหม่ทุกครั้งที่เปลี่ยนโมเดล.
ข้อได้เปรียบและข้อจำกัด: วิธีใช้ Microsoft Foundry ให้คุ้มสำหรับสตาร์ทอัพ
สำหรับทีมในโปรแกรม Microsoft for Startups สถาปัตยกรรมนี้เปิดข้อได้เปรียบที่จับต้องได้: คุณสามารถใช้เครดิต Azure ของโครงการกับการใช้งาน Fireworks models ที่อยู่ใน Data Zone Standard รวมถึงโครงสร้าง Azure ที่สนับสนุน. ผลคือคุณสามารถสร้างและทดสอบแอปพลิเคชัน AI ระดับผลิตจริง ทดลองโมเดลหลายตัวเพื่อหาจุดสมดุลของโมเดลเปิดในด้านต้นทุนและประสิทธิภาพก่อนขยาย และวนสร้างผลิตภัณฑ์ไปสู่ product-market fit โดยไม่ต้องเผชิญแรงกดดันเรื่องต้นทุนโครงสร้างพื้นฐานตั้งแต่แรกเริ่ม. "คุณไม่ต้องสร้างโครงสร้างพื้นฐานอินเฟอร์เรนซ์เองเพื่อรันโมเดลเปิด เพราะ Fireworks ให้บริการบน Foundry ทำให้คุณเริ่มต้นและขยายได้เร็ว" เป็นข้อความที่สะท้อนแนวคิดลดภาระโครงสร้างพื้นฐานสำหรับทีมเล็กอย่างชัดเจน.
อย่างไรก็ตาม ผู้ก่อตั้งไม่ควรมองโซลูชันนี้แบบโรแมนติกเกินไป ยังมีข้อจำกัดที่ต้องรู้ตั้งแต่ต้น: เครดิตสตาร์ทอัพใช้ได้เฉพาะกับการใช้งาน Data Zone Standard แบบจ่ายต่อโทเค็น หน่วยที่จัดสรรไว้ล่วงหน้าถูกแยกออก. การใช้งานแบบ serverless ถูกจำกัดเพียงบางภูมิภาค Azure ในสหรัฐอเมริกา และบริการอยู่นอกขอบเขต EU Data Boundary ไม่มีการอนุมัติ FedRAMP และไม่สามารถใช้กับข้อมูลการชำระเงินบัตรเครดิตได้. ที่สำคัญ ไมโครซอฟท์ระบุว่าไม่ได้ประเมินความปลอดภัยหรือพฤติกรรมของโมเดลที่ Fireworks ให้บริการ และโยนภาระการประเมินกลับมายังลูกค้า. เมื่อรวมข้อดีและข้อจำกัดเข้าด้วยกัน ข้อสรุปคือ Foundry + Fireworks เป็นทางลัดสู่ AI ระดับองค์กรสำหรับสตาร์ทอัพ แต่ต้องใช้อย่างมีวินัยด้านต้นทุน กำกับดูแลโมเดลด้วยตัวเอง และวางแผนรองรับการเปลี่ยนรูปแบบการคิดค่าบริการในอนาคต.