
PAIR คืออะไร และเหมาะกับใคร
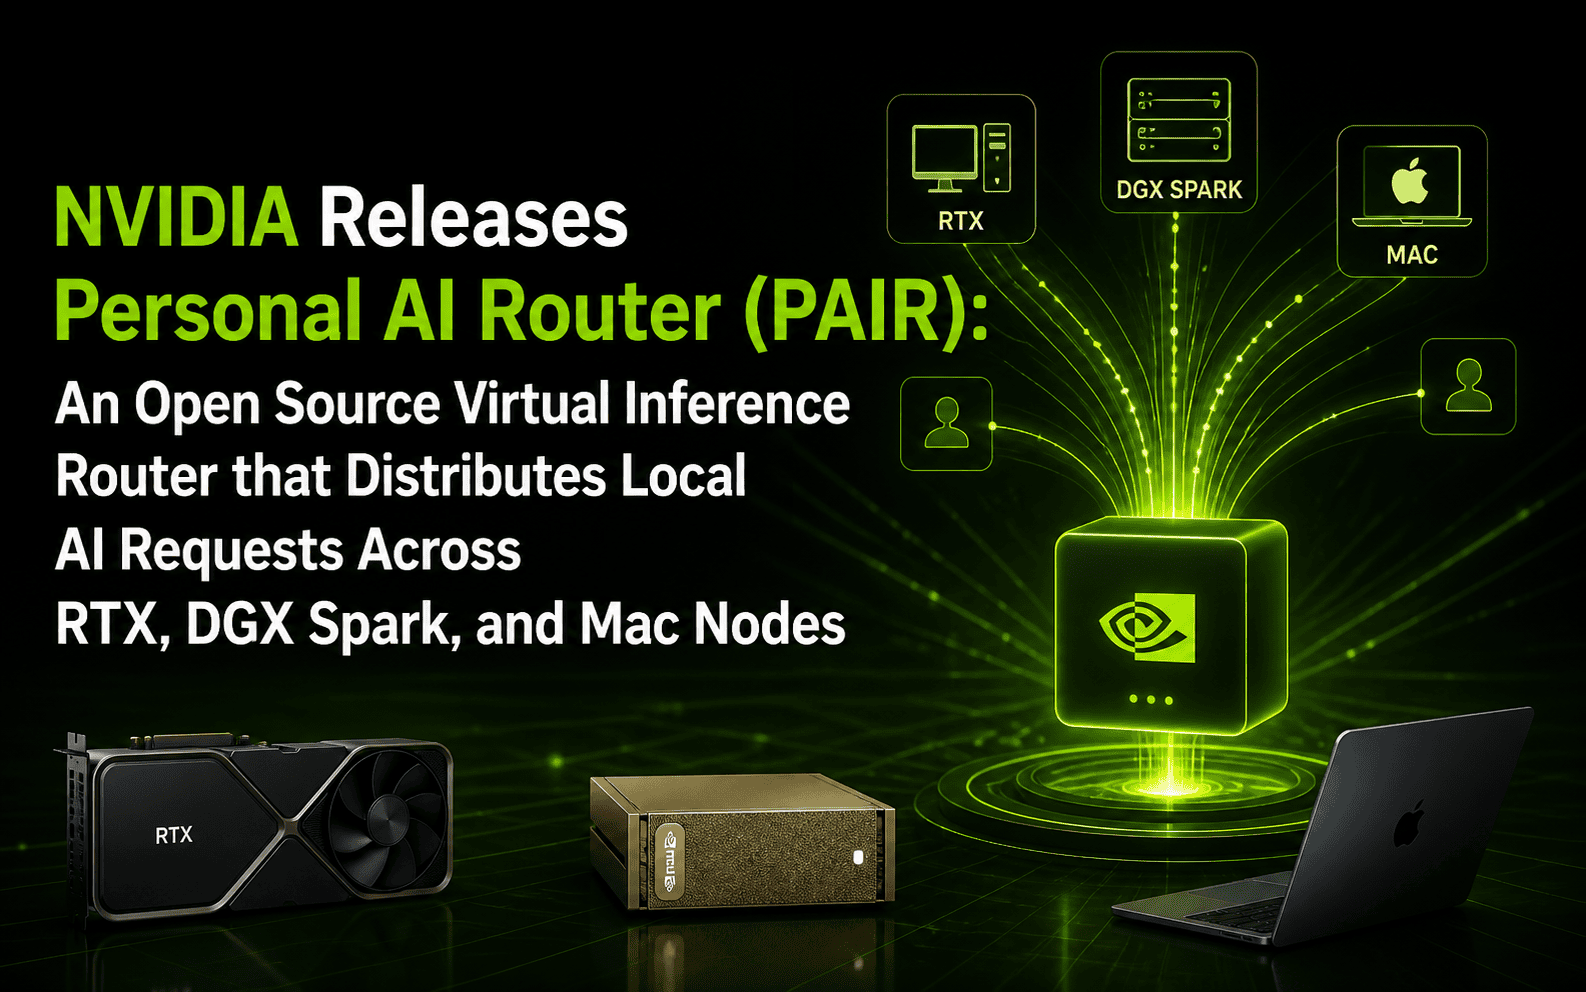
Nvidia Personal AI Router หรือ PAIR คือซอฟต์แวร์สำหรับทำ GPU clustering บ้านที่ทำหน้าที่เป็นตัวกลางกระจายคำขอจากงาน LLM และ AI agent ประมวลผล จากเครื่องหลักไปยังเครื่องอื่นในเครือข่ายเดียวกันที่มี GPU ว่าง ทำให้หลายเครื่องในบ้านหรือออฟฟิศย่อยกลายเป็นระบบ GPU กระจายโดยไม่ต้องแก้โค้ดของเอเจนต์หรือเซ็ตคลัสเตอร์ซับซ้อน เหมาะกับคนที่มีโน้ตบุ๊ก พีซี หรือเวิร์กสเตชันหลายเครื่องและต้องรันงานมัลติเอเจนต์หรือ LLM ยาวๆ บ่อยๆ
แนวคิดคือแทนที่จะปล่อยให้เครื่องแรงๆ ในบ้านว่างงานขณะเอเจนต์ยิงคำขอจำนวนมากใส่ GPU เครื่องเดียว Nvidia PAIR software จะค้นหาโหนดที่รองรับบนเครือข่ายภายในบ้านและส่งคำขออิสระไปให้ทีละเครื่องโดยอัตโนมัติ เมื่อคุณสั่งงาน AI agent ใหญ่หนึ่งงาน เอเจนต์อาจแตกออกเป็นหลายซับเอเจนต์ หากทุกอย่างวิ่งบน GPU เดียวจะเกิดคอขวด แต่ถ้าซับเอเจนต์แต่ละตัวมีโหนดของตัวเอง งานรวมจะเสร็จเร็วกว่า ข้อดีคือไม่ต้องเป็นสาย DevOps ไม่ต้องจัดการคลัสเตอร์สไตล์ดาต้าเซ็นเตอร์ ใช้ฮาร์ดแวร์ที่มีอยู่ในบ้านได้เลย
สิ่งที่ต้องมี ก่อนเริ่มทำระบบ GPU clustering บ้าน
ก่อนลงมือทำระบบ GPU clustering บ้านด้วย PAIR คุณต้องเช็กฮาร์ดแวร์และซอฟต์แวร์พื้นฐานให้พร้อมเสียก่อน PAIR รองรับการทำงานบนการ์ด GeForce RTX 20 Series ขึ้นไป RTX PRO ตั้งแต่ยุค Turing รวมถึง DGX Spark และแมคที่ใช้ Apple Silicon รุ่น M4 ขึ้นไปสำหรับงาน inference แต่ละเครื่องต้องมี RAM อย่างน้อยประมาณ 8 GB และพื้นที่ดิสก์ว่างอย่างน้อยราว 20 GB เพื่อรองรับโมเดลและเอนจิน ยิ่งมีหลายเครื่องที่ตรงสเปกมากเท่าไหร่ ระบบ GPU กระจายของคุณก็ยิ่งมีแรงมากขึ้น
ด้านระบบปฏิบัติการ PAIR มีตัวติดตั้งที่ลงนามอย่างเป็นทางการบน Windows macOS และ Linux และโค้ดเปิดอยู่บน GitHub ภายใต้ Apache 2.0 ให้คุณอ้างอิงหรือบิลด์เพิ่มเองได้ แต่ละโหนดต้องมีเอนจิน Ollama หรือ LM Studio ติดตั้งอยู่ เพราะ PAIR ไม่ใช่เอนจินใหม่ มันจะใช้เอนจินเหล่านี้เป็นตัวรันโมเดลให้บนโหนดที่เลือก ข้อดีคือ PAIR สามารถช่วยติดตั้งเอนจินและสั่งดาวน์โหลดโมเดลข้ามเครื่องได้ ลดภาระการเซ็ตหลายเครื่องลงไปมาก เครือข่ายที่ใช้เป็น LAN หรือ Wi‑Fi ภายในบ้านก็เพียงพอ อินเทอร์เน็ตต้องใช้แค่ตอนดาวน์โหลดโมเดลเท่านั้น
ขั้นตอนเซ็ต Nvidia PAIR software ให้กลายเป็นระบบ GPU กระจายที่บ้าน
ส่วนนี้คือหัวใจของการเปลี่ยนบ้านให้กลายเป็นระบบ GPU กระจายสำหรับ AI agent ประมวลผล โดยไม่ต้องแก้โค้ดเอเจนต์เดิมใดๆ จุดที่ต้องระวังคือ PAIR กระจายเฉพาะคำขออิสระไปยังโหนดเดียวต่อคำขอ ไม่ได้เอา VRAM จากหลายเครื่องมารวมกัน หรือแตกคำขอเดียวให้วิ่งข้ามเครื่อง ดังนั้นมันเหมาะกับเวิร์กโฟลว์มัลติเอเจนต์และงานที่แยกเป็นคำขอหลายชิ้นมากกว่าการรันโมเดลเดียวคำขอเดี่ยว
- ติดตั้ง Ollama หรือ LM Studio บนทุกเครื่องที่จะใช้เป็นโหนด จากนั้นดาวน์โหลดโมเดลที่ต้องการรันให้มีแท็กตรงกันบนเครื่องที่อยากใช้ร่วมงาน PAIR สามารถช่วยสั่งติดตั้งเอนจินและดาวน์โหลดโมเดลข้ามเครื่อง ลดขั้นตอนมือ
- ดาวน์โหลดและติดตั้ง PAIR เวอร์ชันทดสอบสาธารณะบน Windows macOS หรือ Linux ให้ครบทุกเครื่องที่ต้องการเข้าคลัสเตอร์ ซอฟต์แวร์จะทำงานบนเครือข่ายท้องถิ่นและต้องใช้อินเทอร์เน็ตเฉพาะตอนดาวน์โหลดโมเดล
- เปิด PAIR บนเครื่องหลักเพื่อสร้างคลัสเตอร์ จากนั้นให้เครื่องอื่นเปิด PAIR เช่นกัน ระบบจะค้นหาโหนดผ่าน mDNS หากเครื่องบางเครื่องไม่ถูกค้นพบ สามารถเพิ่มด้วยการระบุ IP ตรงๆ ได้
- เมื่อเครื่องถูกเชิญเข้าคลัสเตอร์ PAIR จะสร้าง PIN 6 หลักบนหน้าจอของเครื่องเชิญ คุณต้องกรอก PIN นี้บนเครื่องที่ถูกเชิญเพื่อยืนยันความเชื่อใจ การสื่อสารทุกอย่างจะถูกบล็อกจนกว่าการจับคู่จะสำเร็จ หลังจากนั้นทราฟฟิกระหว่างโหนดจะถูกเข้ารหัสด้วย mTLS และใบรับรองที่สร้างอัตโนมัติ
- ตั้งค่าให้เอเจนต์หรือแอป LLM ของคุณ เช่น LM Studio หรือ Ollama ต่อผ่านพร็อกซีของ PAIR แทนที่จะต่อตรงไปยังเอนจิน โดย PAIR จะทำตัวเป็นพร็อกซีเข้ากับอินเทอร์เฟซที่เอนจินเหล่านี้ใช้อยู่แล้ว รวมถึงมีพร็อกซีแบบ OpenAI‑compatible ให้ใช้ด้วย ทำให้ฮาร์เนสเอเจนต์เดิมไม่ต้องแก้โค้ด
- เริ่มรันเวิร์กโฟลว์มัลติเอเจนต์หรือยิงคำขอ LLM หลายคำขอไปยังพร็อกซีของ PAIR ตัวจัดตารางจะพิจารณาโหนดที่พร้อมจริงเท่านั้น ทั้งสถานะเอนจิน โมเดลที่มีแท็กตรงชื่อที่ขอ ภาระงานปัจจุบัน และการใช้ GPU ณ ตอนนั้น แล้วส่งคำขอหนึ่งคำขอไปยังโหนดเดียวตลอดอายุงาน
จุดที่หลายคนอาจพลาดคือการคิดว่าโหลดโมเดลให้ตรงแท็กบนทุกเครื่องเป็นเรื่องไม่จำเป็น แต่ในความเป็นจริง PAIR จะเลือกเฉพาะโหนดที่มีโมเดลตรงแท็กตามที่ร้องขอเท่านั้น ถ้าอยากให้เวิร์กโหลดกระจายตัวดีๆ คุณควรแพลนว่าโมเดลหลักจะอยู่บนเครื่องไหนบ้าง และให้ทุกเครื่องที่อยากช่วยงานโหลดแท็กเดียวกันไว้ อย่างน้อยคนละหนึ่งรุ่น เมื่อคลัสเตอร์เริ่มทำงาน คุณจะเห็นว่าคำขอจะถูกส่งสลับไปยังโหนดที่เข้าข่ายโดยอัตโนมัติ
ผลลัพธ์ที่ได้จากระบบ GPU กระจาย และข้อจำกัดที่ควรรู้
เมื่อเซ็ตทุกอย่างเสร็จ บ้านของคุณก็จะกลายเป็นระบบ GPU กระจายสำหรับงาน LLM และ AI agent ประมวลผล ที่ใช้พลังจากโน้ตบุ๊ก พีซี และเครื่องเวิร์กสเตชันพร้อมกันได้ PAIR จะส่งซับทาสก์จากเอเจนต์หลักบนเครื่องหัวไปยังเครื่องอื่นในเครือข่ายที่มี GPU ว่างและเหมาะสม แล้วรวบรวมผลกลับมายังแอปต้นทางบนเครื่องหลัก ผลลัพธ์คือเวลารวมในการทำงานของเอเจนต์หลายตัวมักจะลดลงอย่างเห็นได้ชัด โดยเฉพาะงานยาวที่ไม่จำเป็นต้องเสร็จภายในเวลาตายตัว การเอา computing power ว่างๆ มาช่วยกันทำงานยังมีประสิทธิภาพกว่าปล่อยให้เอเจนต์ทั้งฝูงวิ่งบน GPU เดียว
ตัวอย่างเดโมของ Nvidia แสดงให้เห็นว่าเมื่อใช้ PAIR จับคู่เข้ากับ Hermes Desktop เพื่อสร้างเวิร์กโหลด 5 ซับเอเจนต์บนกล่องอีเมลจำลอง โดย Ollama รันโมเดล Qwen 3.6 35B A3B บนโหนดที่ถูกเลือก เวลาเฉลี่ยบนแล็ปท็อป RTX Spark เครื่องเดียวอยู่ที่ประมาณ 18 นาที แต่เมื่อรันบนคลัสเตอร์ 3 เครื่อง ได้แก่ RTX Spark laptop DGX Spark และ RTX 5090 เวลาเฉลี่ยลดลงเหลือประมาณ 8 นาที 48 วินาที อย่างไรก็ตาม PAIR ถูกออกแบบให้เป็นระบบแบบยืดหยุ่น ไม่สงวนกำลัง GPU จากเครื่องคนอื่นไว้ตายตัว เจ้าของเครื่องยังสามารถดึง GPU กลับไปใช้เล่นเกม ทำงานสร้างสรรค์ หรือรัน AI ของตัวเองได้ ทำให้คุณภาพบริการจากคลัสเตอร์ไม่สามารถรับประกันได้ตลอดเวลา มันจึงเหมาะกับงานที่รันต่อเนื่องยาวๆ มากกว่าที่ต้องการดีเลย์ต่ำตายตัว
สรุป: คุ้มไหม และควรจับตาอะไรต่อไป
ถ้าคุณมีหลายเครื่องในบ้านหรือในออฟฟิศย่อยที่มี GPU ว่างและกำลังลองเวิร์กโฟลว์มัลติเอเจนต์หรือ LLM การตั้งระบบ GPU clustering บ้านด้วย Nvidia PAIR software ถือว่าคุ้มค่าอย่างมาก PAIR ช่วยรีดศักยภาพเครื่องว่างโดยไม่ต้องผูกมัดกับโค้ดใหม่หรือสถาปัตยกรรมคลัสเตอร์ซับซ้อน และสามารถขยายแนวคิดนี้ไปสู่การใช้กำลังประมวลผลว่างบนเดสก์ทอปขององค์กรขนาดเล็กได้เช่นกัน จุดสำคัญที่ควรจำไว้คือมันกระจายงานแบบคำขออิสระ ไม่รวม VRAM ข้ามเครื่อง และสถานะยังเป็นเบตาที่นโยบายจัดตารางยังไม่คำนึงถึงขนาด VRAM คลาส GPU หรือความอุ่นของโมเดล
มุมมองแบบเพื่อนบอกเพื่อนคือ ถ้าคุณเคยรันเอเจนต์หลายตัวบนเครื่องเดียวแล้วรู้สึกว่ามันตึง GPU จนคิวหนาแน่น การลองย้ายมาใช้ PAIR เป็นหัวใจของระบบ GPU กระจายจะช่วยให้คุณหายใจโล่งขึ้นมาก ไม่ต้องย้ายไปใช้คลาวด์ทุกรอบและยังเก็บงานไว้บนเครือข่ายส่วนตัวได้ เมื่อเซ็ตครั้งแรกเสร็จแล้ว การใช้งานต่อไปจะไม่ต่างจากรันเอเจนต์บนเครื่องเดียว เพียงแต่เบื้องหลังมีหลายเครื่องช่วยกันทำงาน สิ่งที่ควรดูต่อคืออัปเดตเวอร์ชันใหม่ๆ ของ PAIR และพิจารณาเพิ่มหรือสับเปลี่ยนโมเดลกับเอนจินบนแต่ละโหนดให้เหมาะกับงานจริงที่คุณทำอยู่ เพื่อให้ระบบนี้เติบโตไปพร้อมกับเวิร์กโฟลว์ AI ของคุณ