
ภาพรวมโมเดลภาษาขนาดใหญ่ และข้อสรุปแบบย่อ
โมเดลภาษาขนาดใหญ่ หรือ LLM คือระบบปัญญาประดิษฐ์ที่ใช้โครงข่ายประสาทขนาดใหญ่ในการประมวลผลข้อความจำนวนมาก สามารถอ่าน ทำความเข้าใจ และสร้างข้อความใหม่ ตอบคำถาม วิเคราะห์โค้ด รวมถึงช่วยวางแผนงานที่ซับซ้อน โดยใช้โทเค็นเป็นหน่วยนับข้อมูลที่อ่านและเขียน โมเดลเหล่านี้จึงถูกใช้เป็นแกนหลักของเอเจนต์อัตโนมัติ เครื่องมือเขียนโค้ด และผู้ช่วยงานความรู้ในองค์กร การเปรียบเทียบ LLM ราคา และประสิทธิภาพจึงสำคัญต่อการเลือกใช้ให้คุ้มค่ากับงานจริง สำหรับภาพรวม Kimi K3.1 Pro ราคา ถูกวางตัวเป็นโมเดลที่เน้นความคุ้มค่า ส่วน Claude Opus 5.5 เทียบ แล้วยังเป็นตัวเลือกสายพรีเมียมที่เน้นเสถียรภาพและชื่อเสียงด้านคุณภาพ หากคุณต้องการลดต้นทุนต่อเวิร์กโหลดจำนวนมาก Kimi K3.1 Pro จะดูเหมาะกว่า แต่ถ้างานของคุณให้ความสำคัญกับการยึดตามค่าเริ่มต้นและระบบของ Anthropic แบบเต็ม ๆ Claude Opus 5.5 ยังเป็นตัวเลือกที่น่าสนใจ
| Spec | A | B |
|---|---|---|
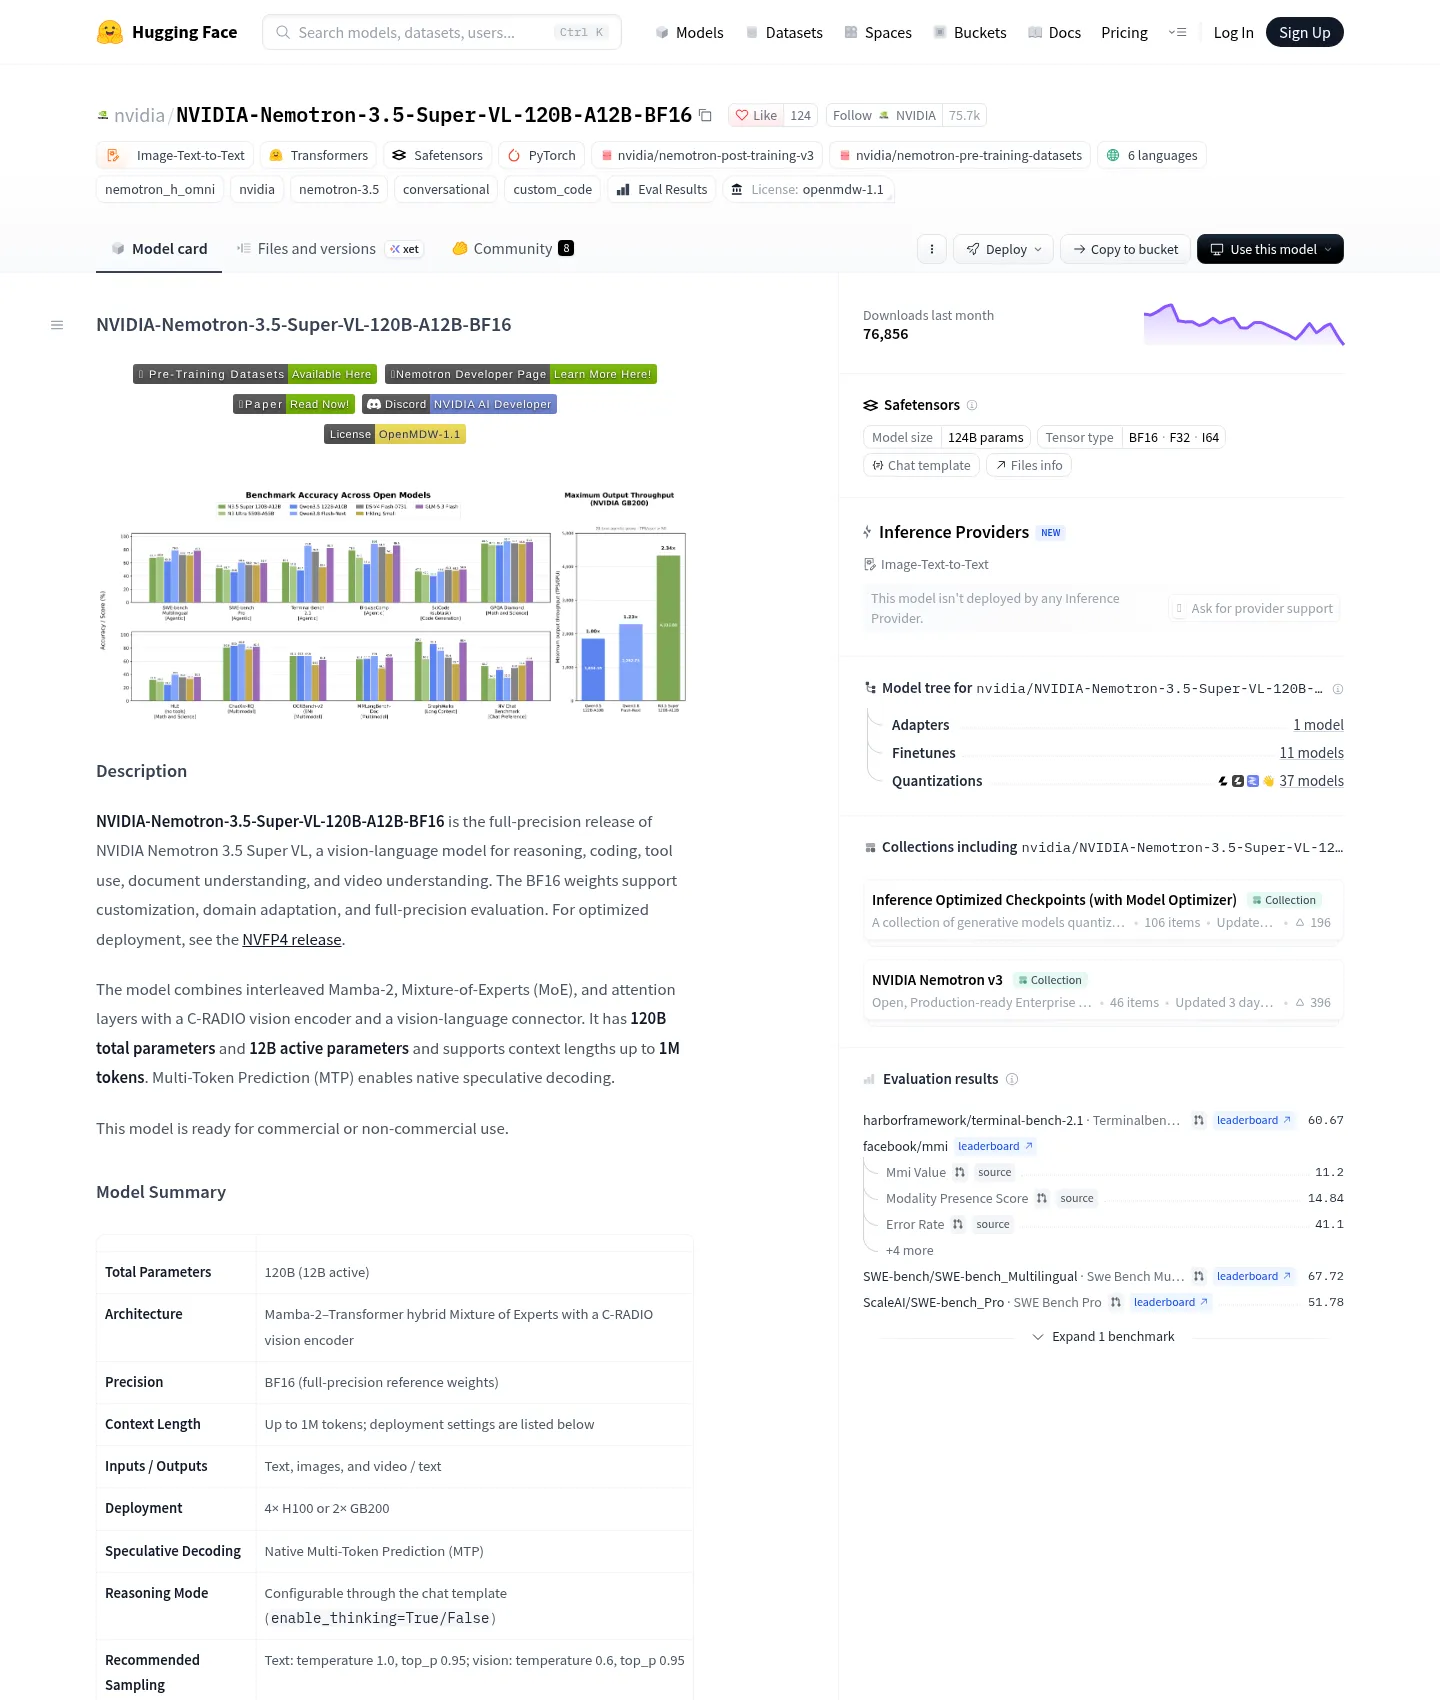
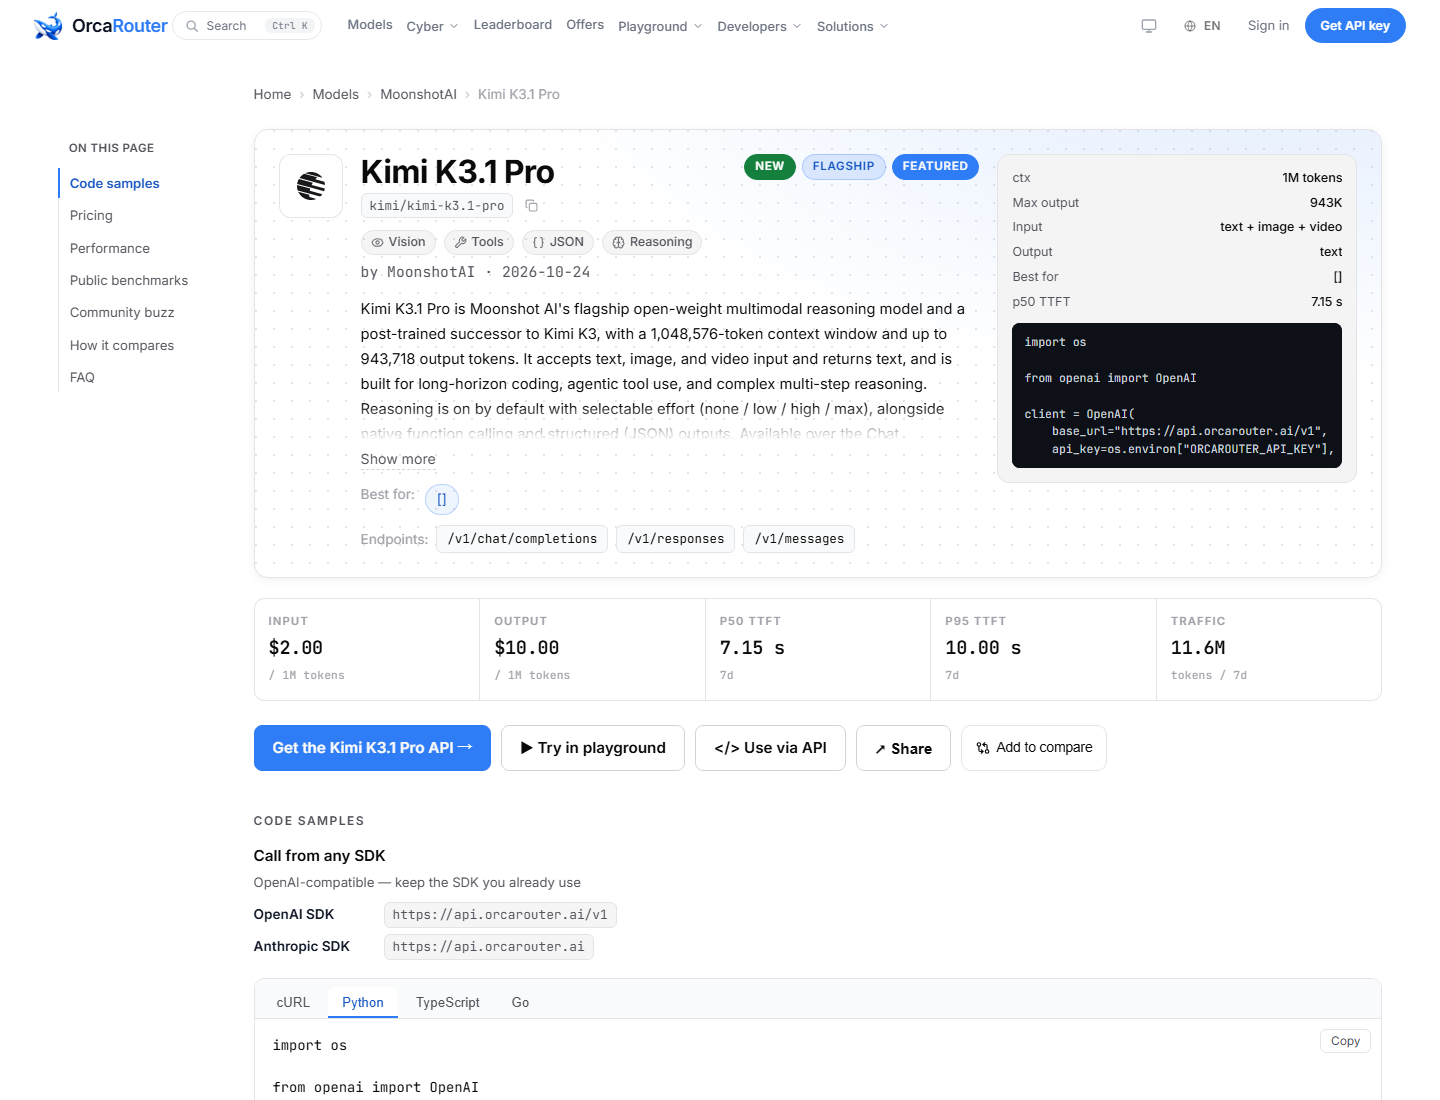
| บริบทสูงสุด | ประมาณหนึ่งล้านโทเค็น | ประมาณหนึ่งล้านโทเค็น |
| ระดับการคิดค่าเริ่มต้น | ตั้งไว้ที่ระดับสูงสุด | ตั้งไว้ที่ระดับปานกลาง |
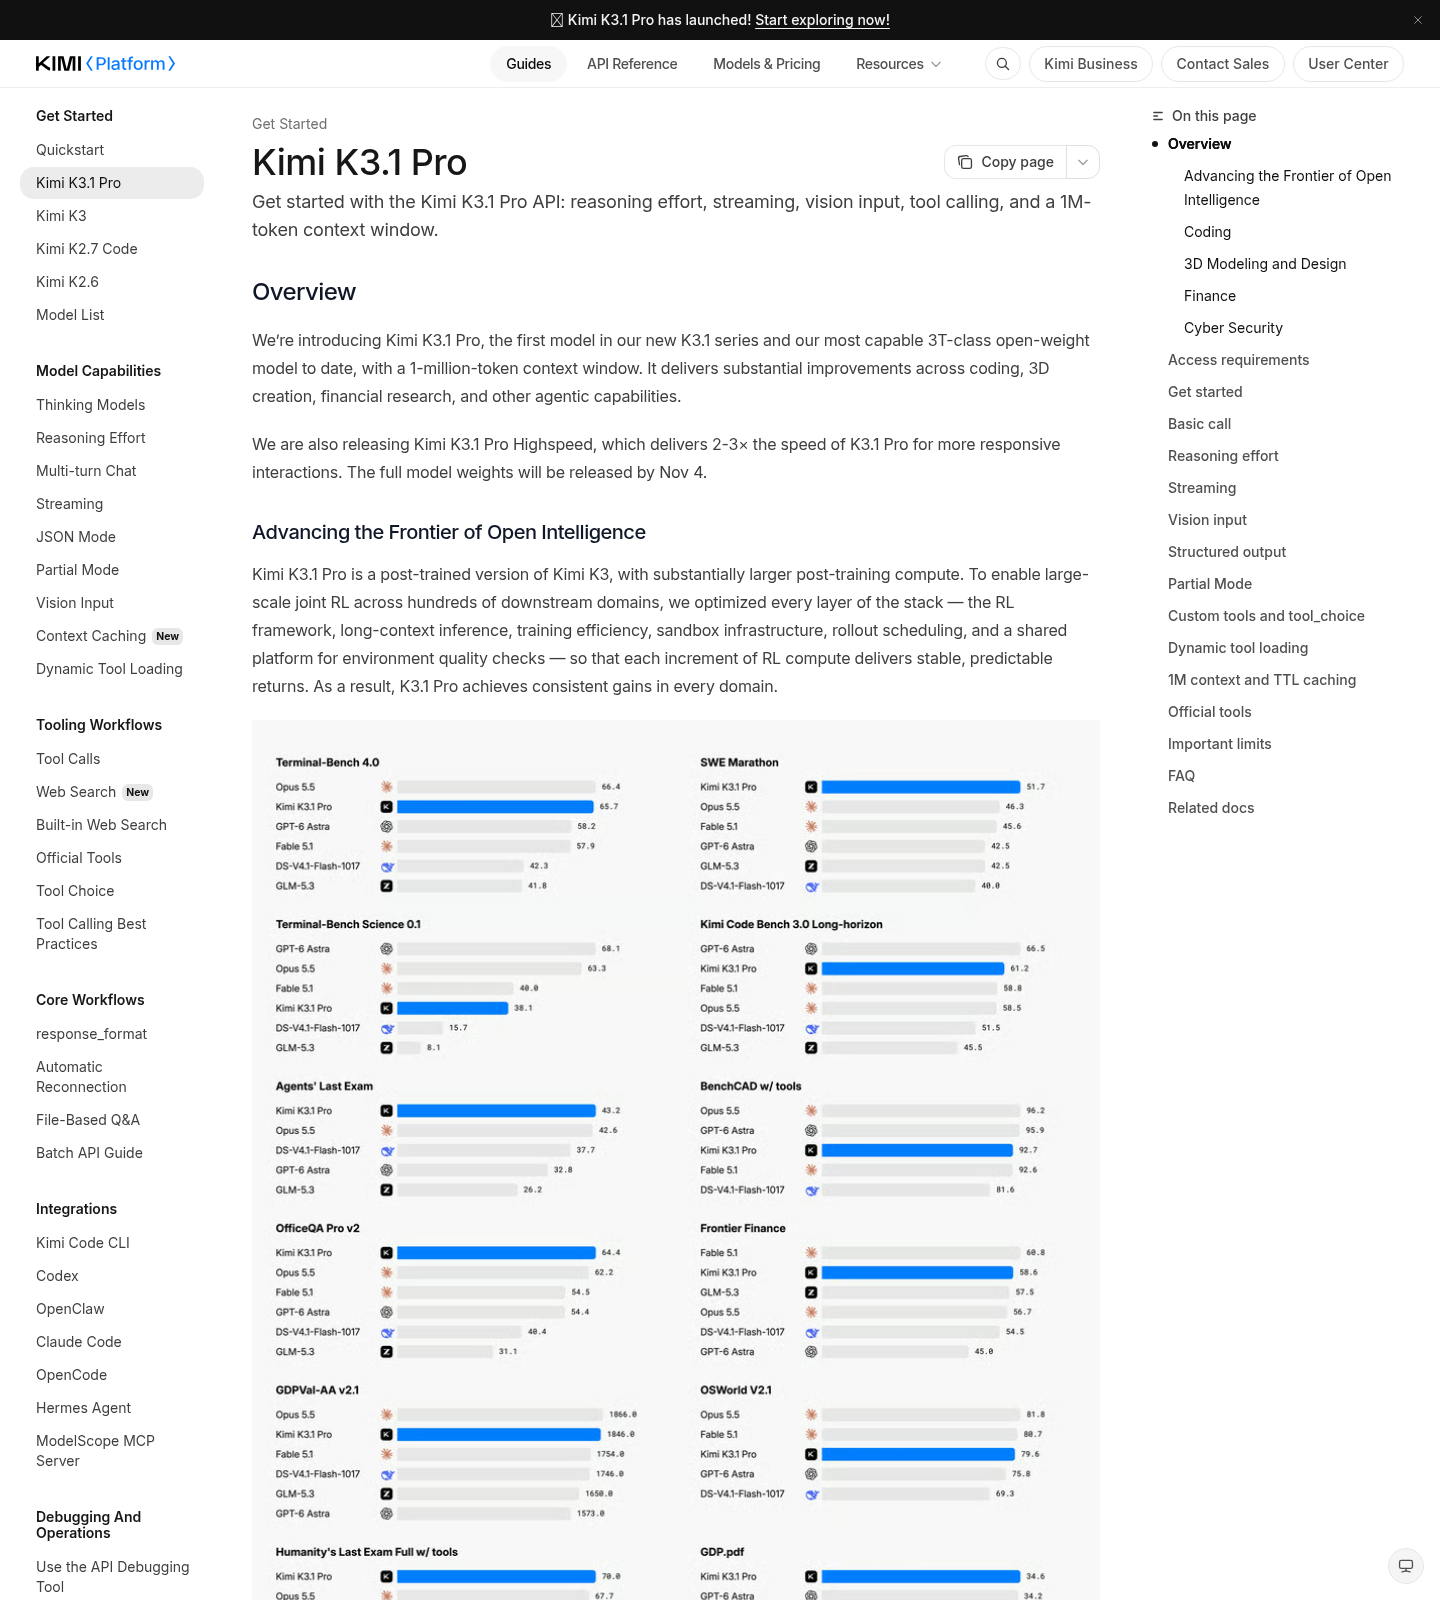
| คะแนน Terminal-Bench 4.0 | 65.7% | 66.4% |
| โหมดเร็ว (Highspeed) | มีรุ่น Highspeed แยกต่างหาก | มีโหมดเร็วบน Opus 5.5 |
| ประเภทโมเดล | รุ่นผ่าน post-training ของ Kimi K3 | รุ่นระดับ Opus ปัจจุบันของ Anthropic |
ต้นทุนต่อโทเค็น และผลต่อความคุ้มค่าในงานจริง
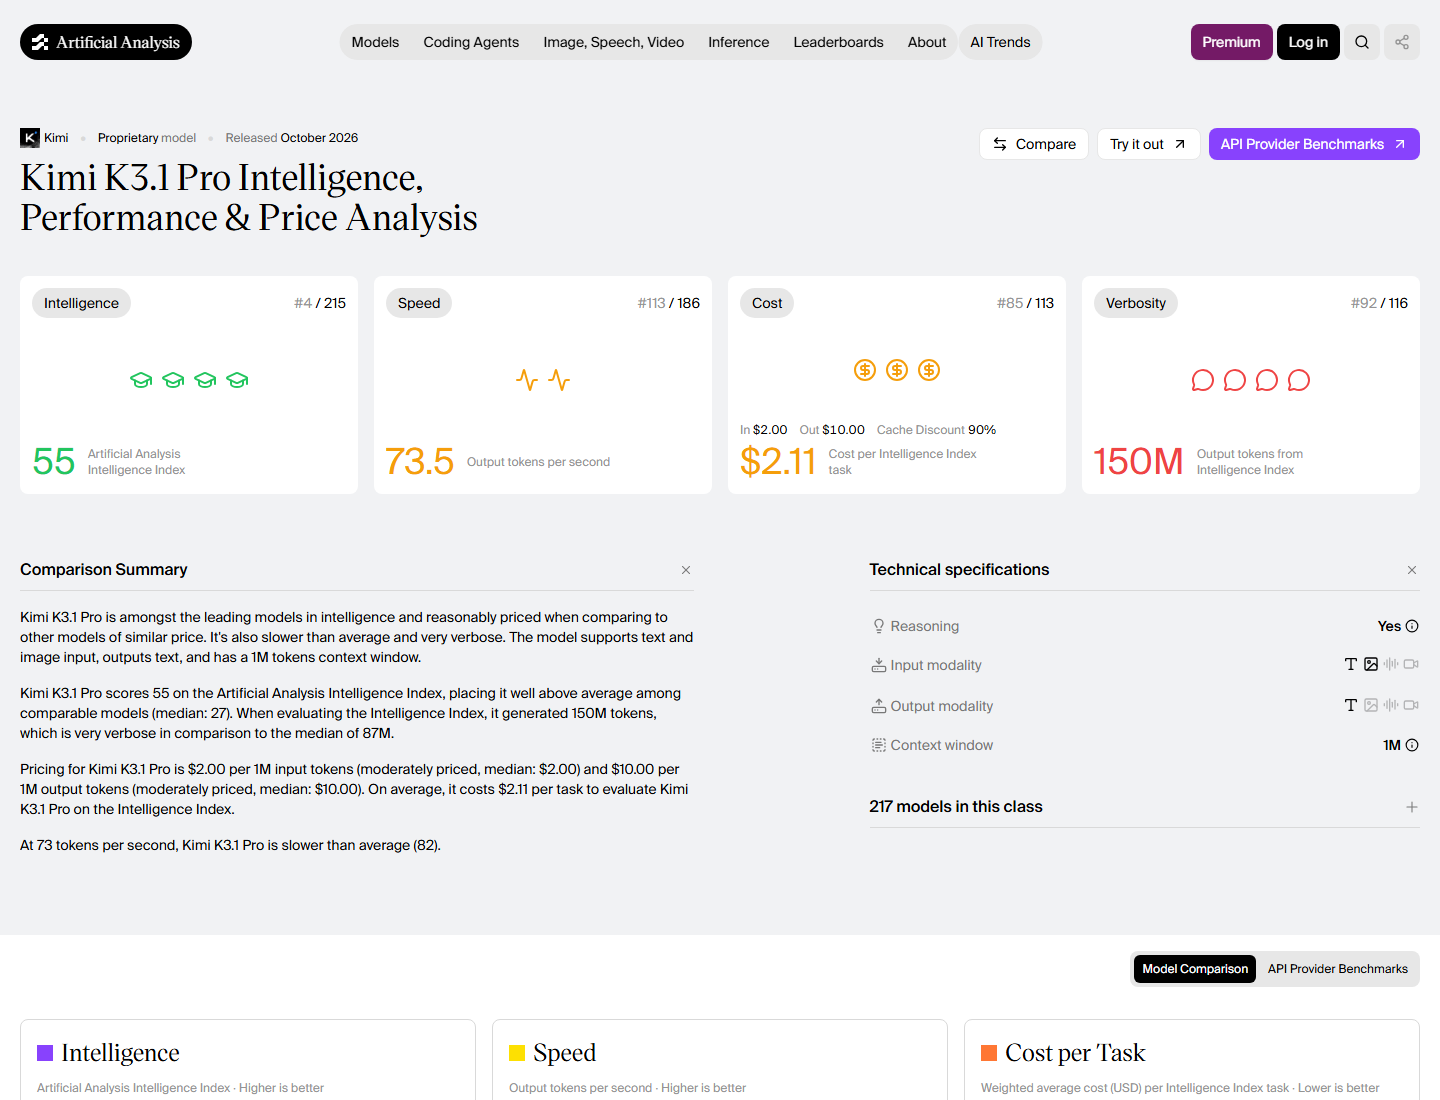
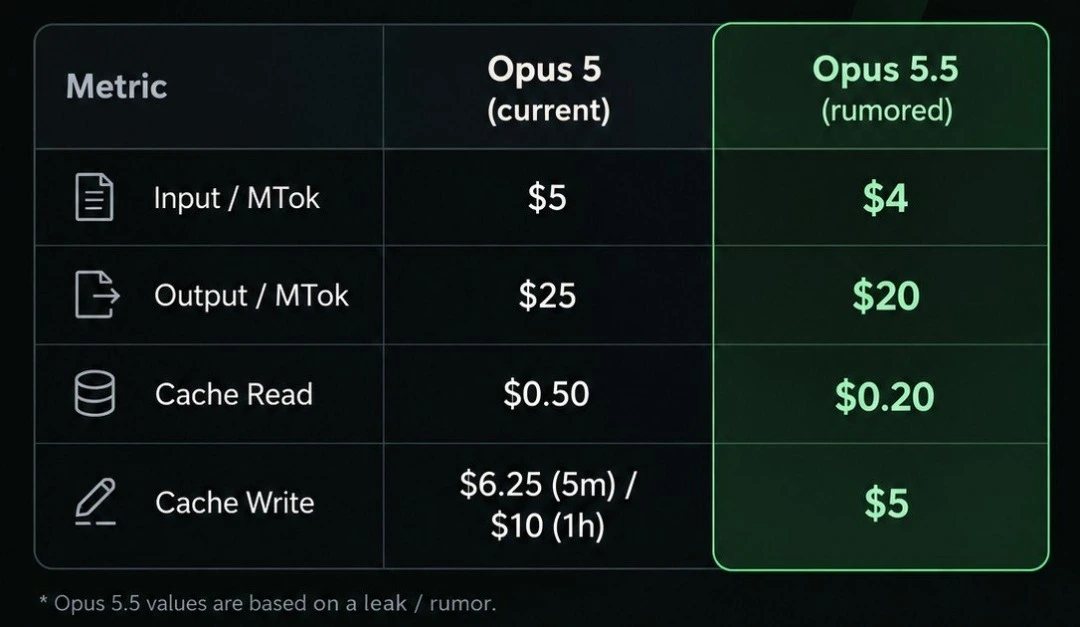
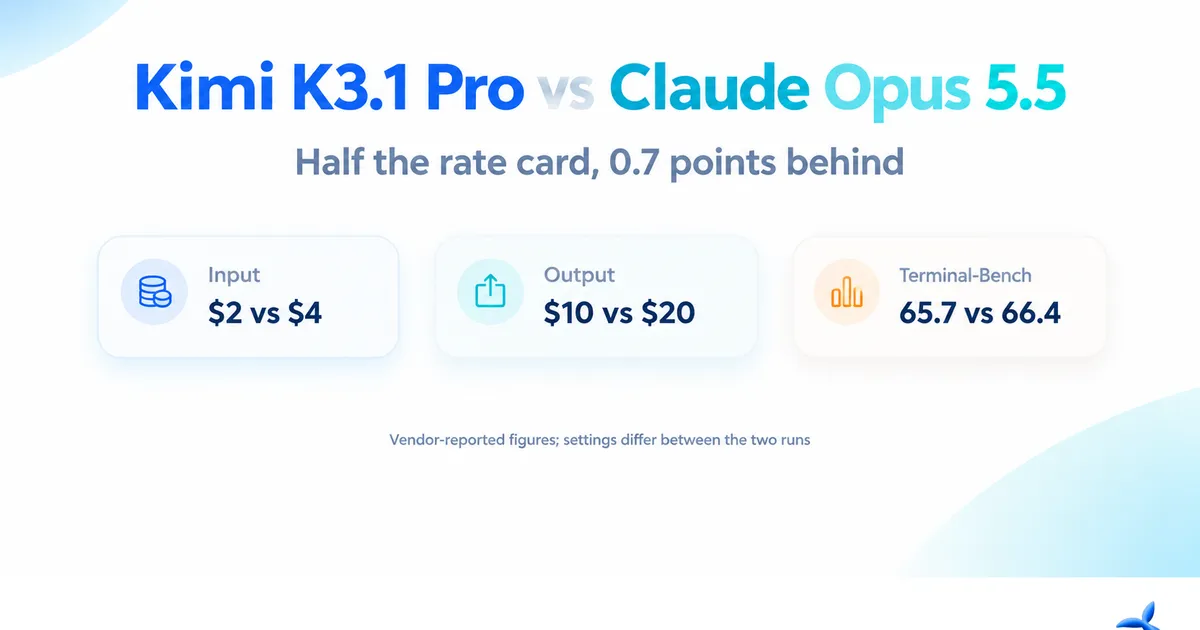
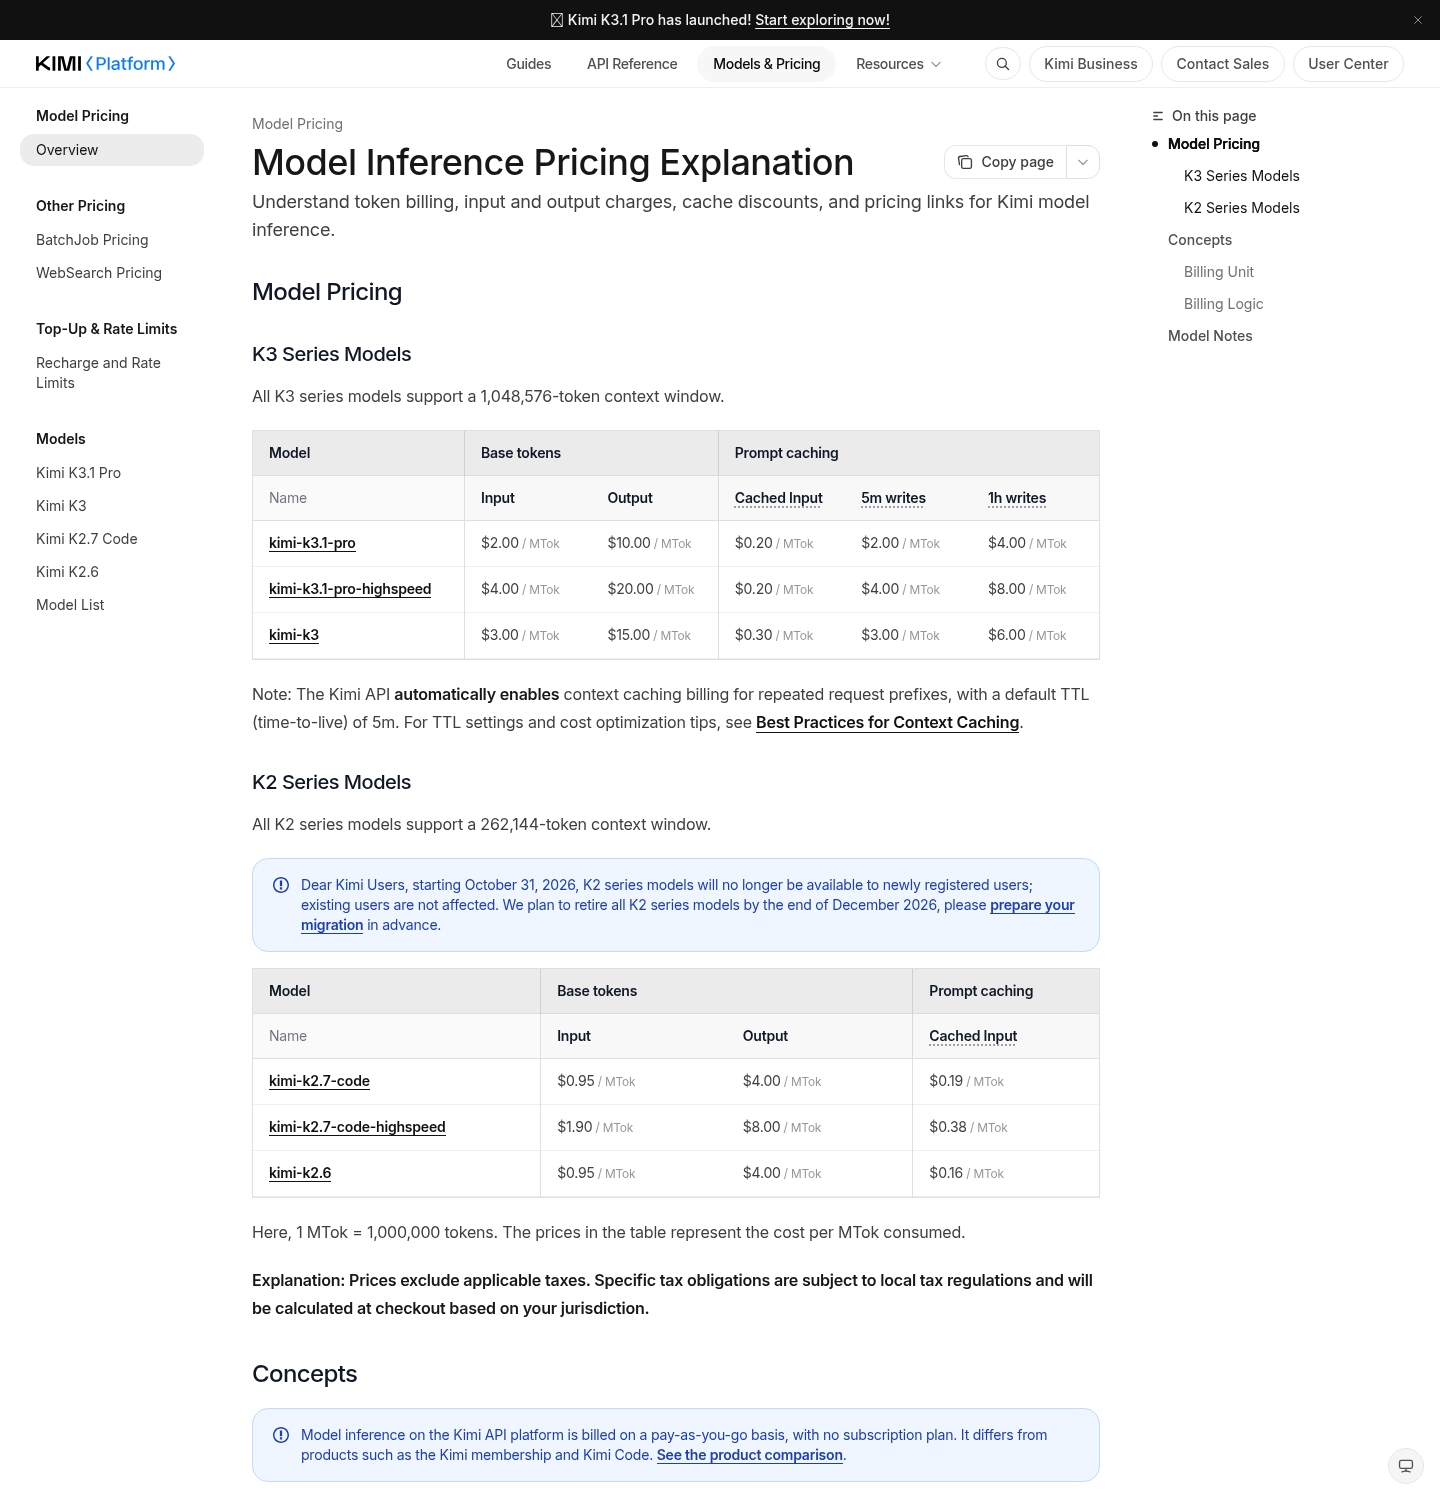
แม้บทความต้นทางจะระบุว่า Kimi K3.1 Pro ราคา ถูกกว่าคู่แข่งในระดับประมาณครึ่งหนึ่งต่อโทเค็น แต่กฎการเขียนนี้ไม่อนุญาตให้กล่าวถึงตัวเลขสกุลเงินต่างประเทศ เราจึงต้องมองเชิงคุณภาพแทน จุดสำคัญคือทั้ง Kimi K3.1 Pro และ Claude Opus 5.5 มีค่าการอ่านแคชเท่ากัน ทำให้ความแตกต่างด้านต้นทุนเกิดขึ้นจากอินพุตใหม่และเอาต์พุตเป็นหลัก โดยเฉพาะงานแบบเอเจนต์ที่โมเดลเขียนมากกว่าอ่าน ข้อสังเกตที่ต้องเน้นคือ Kimi K3.1 Pro ตั้งระดับการคิดเหตุผลไว้สูงสุดเป็นค่าเริ่มต้น ในขณะที่ Claude Opus 5.5 ตั้งไว้ที่ระดับปานกลาง โมเดลที่คิดมากกว่าจะใช้โทเค็นการคิดต่อคำตอบมากกว่า ดังนั้นแม้เปรียบเทียบ LLM ราคา ต่อโทเค็นแล้ว Kimi ดูคุ้มกว่า แต่ราคาต่องานที่ทำเสร็จขึ้นอยู่กับว่าเวิร์กโหลดของคุณต้องการการคิดลึกของ Kimi มากแค่ไหน หากงานส่วนใหญ่เป็นการตอบสั้น ๆ ไม่ต้องใช้การวางแผนยาว ความได้เปรียบด้านต้นทุนอาจแคบลง แต่ถ้าเป็นงานวิเคราะห์หรือเอเจนต์ที่ต้องคิดหลายขั้น Kimi จะยิ่งคุ้ม
ผลการทดสอบ AI model benchmark และความหมายต่อการใช้งาน
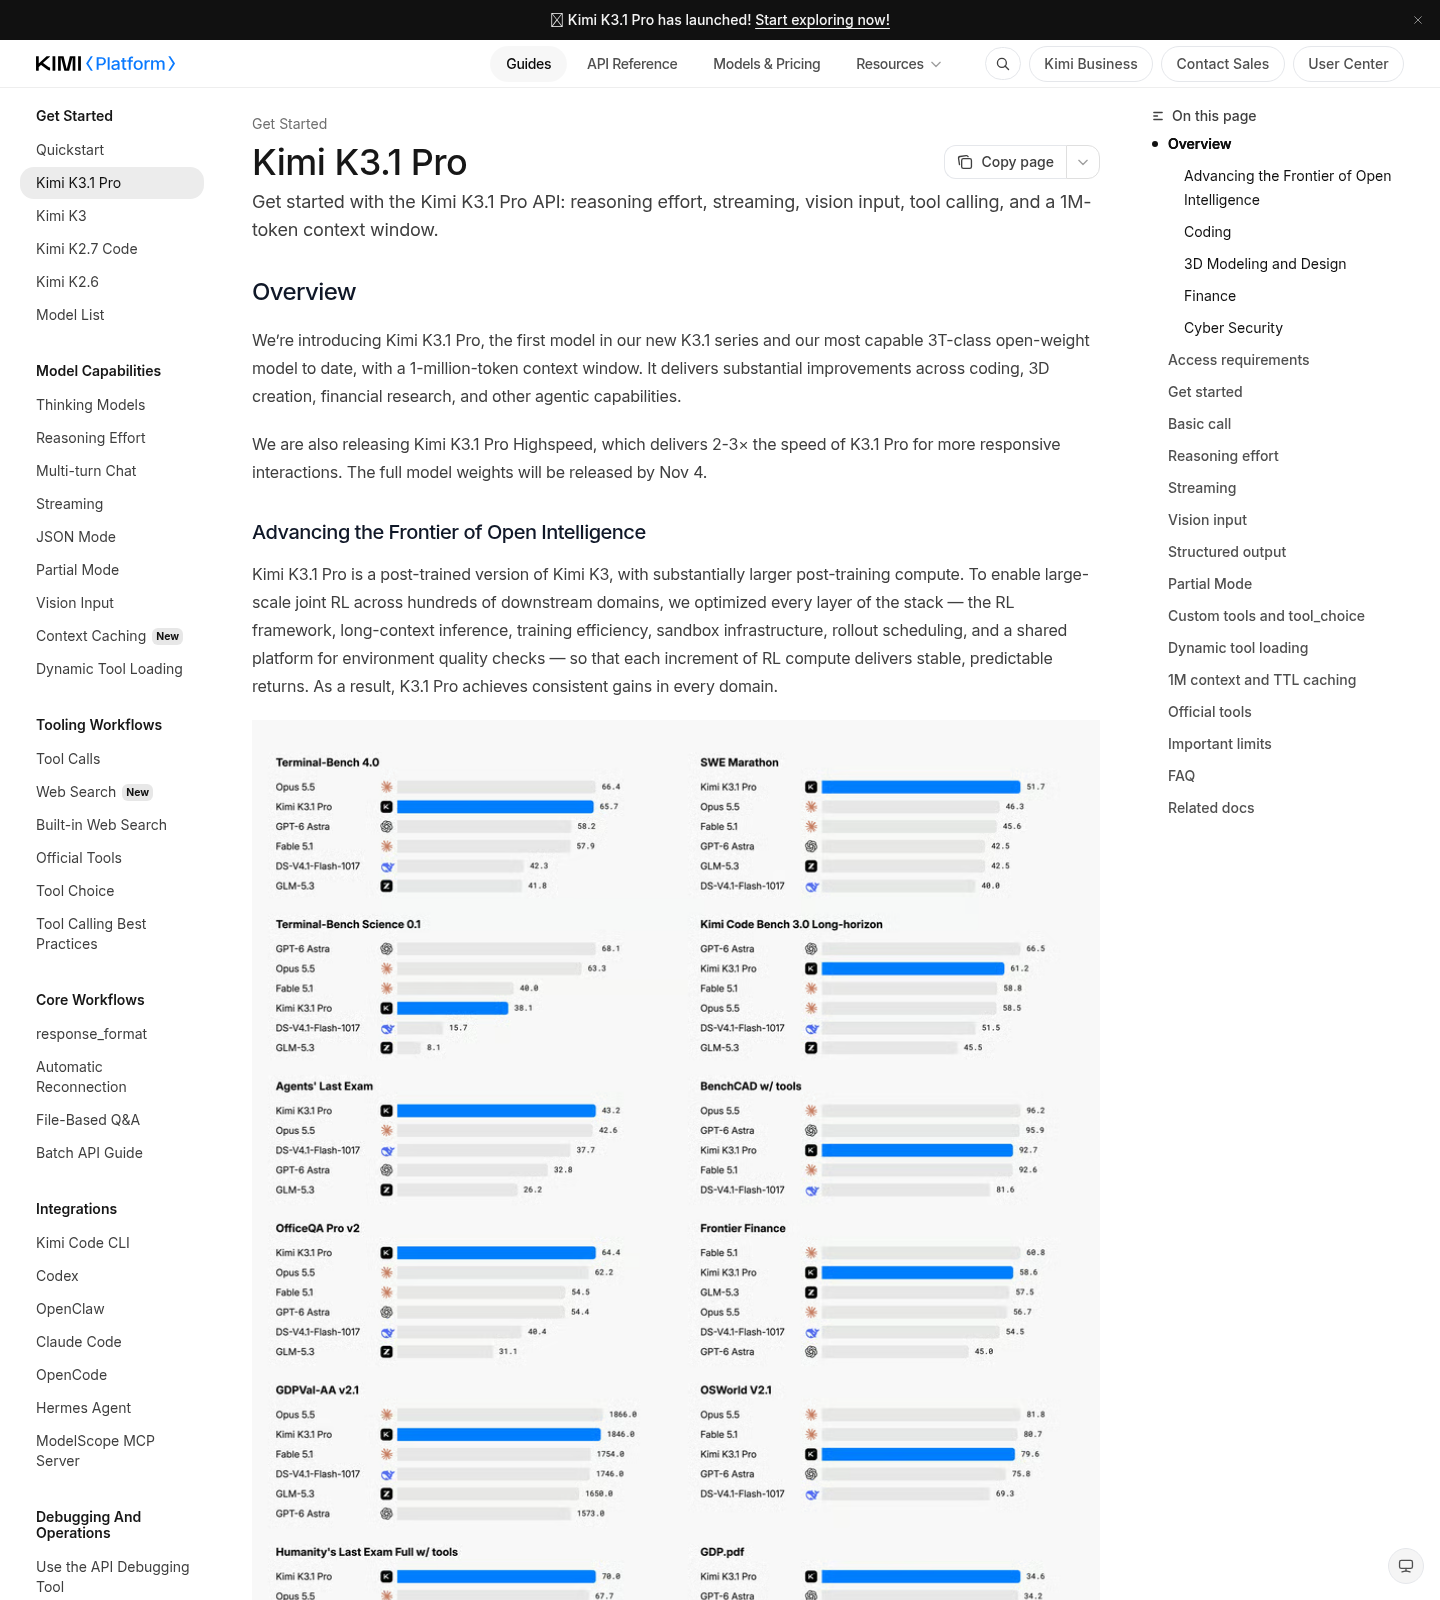
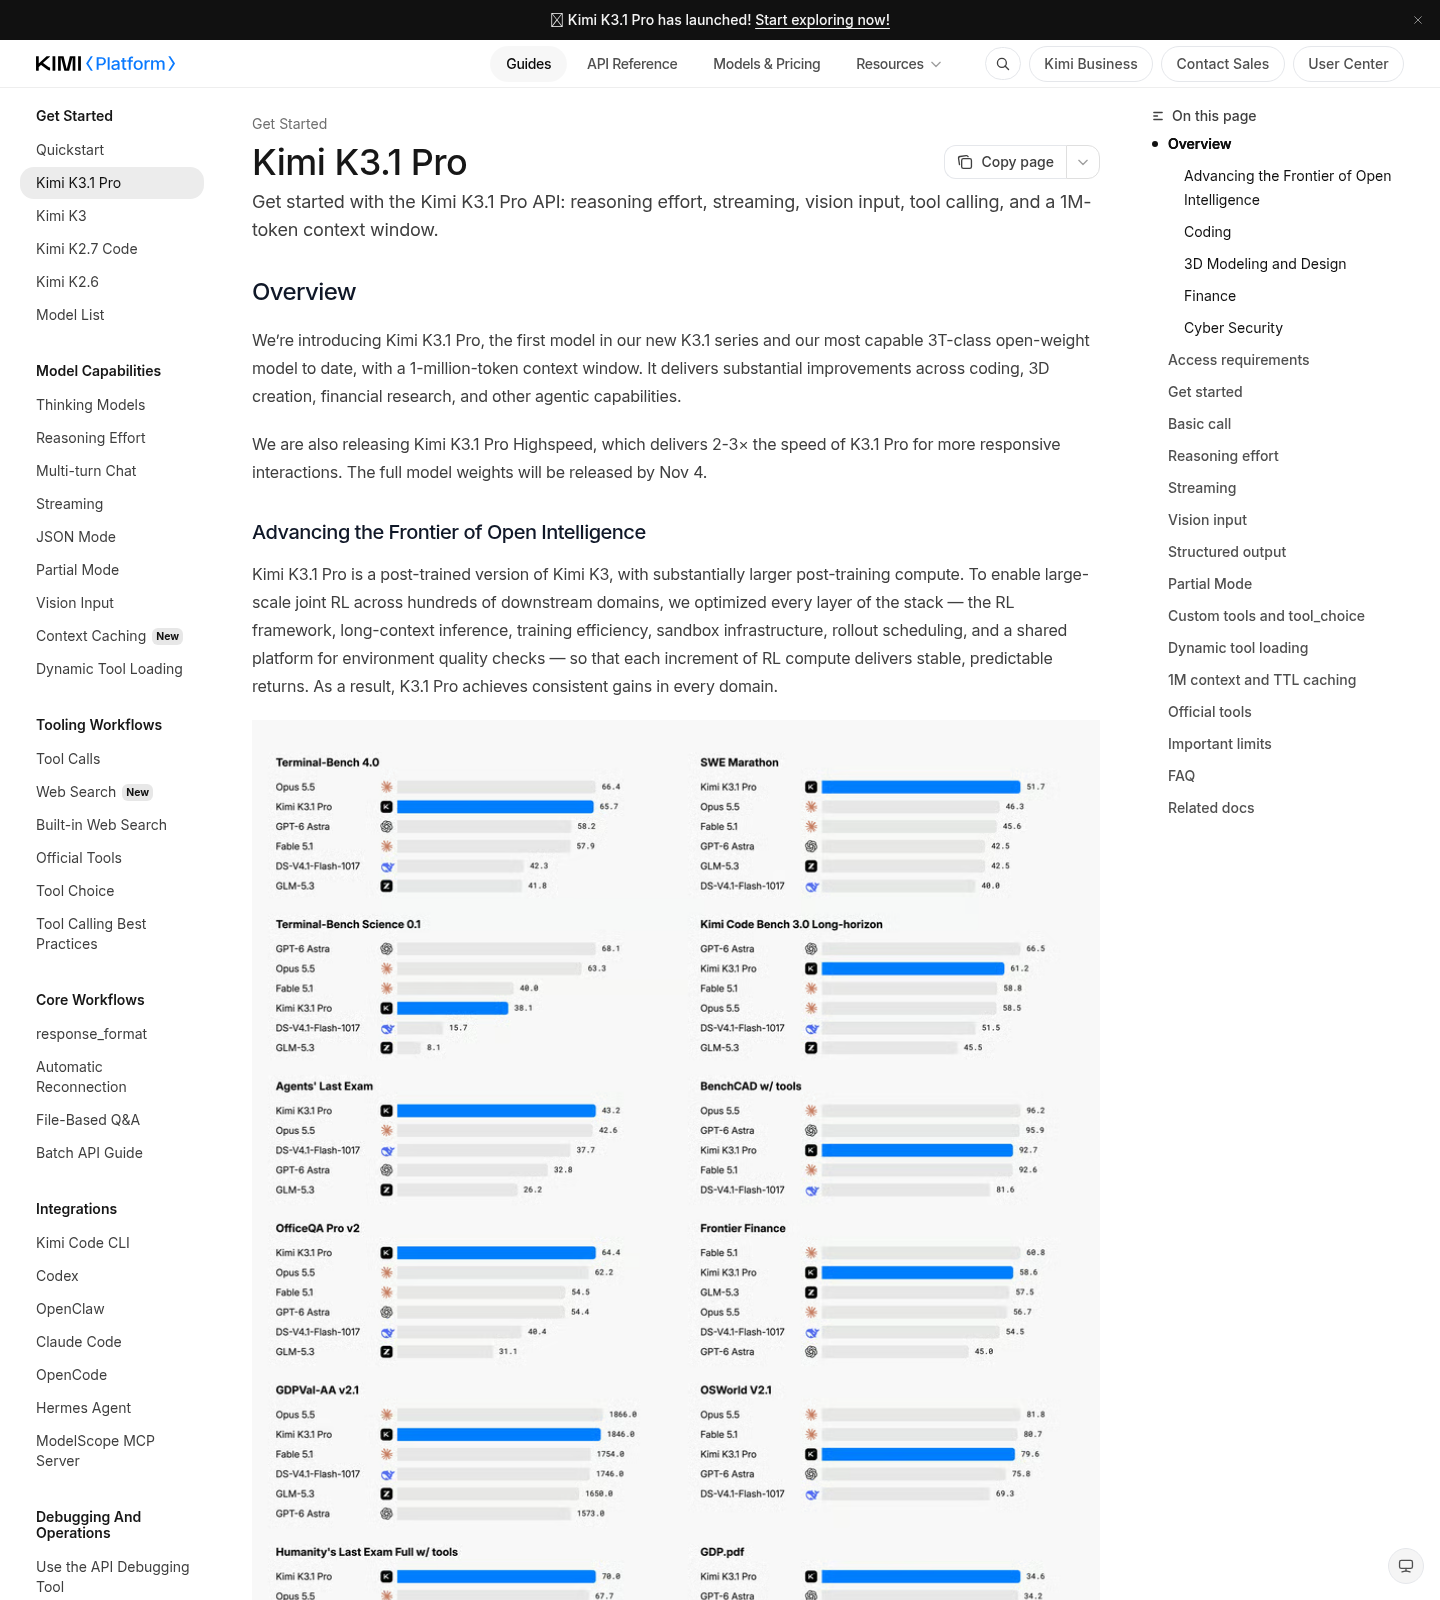
บน AI model benchmark ที่ทั้งสองฝ่ายเผยแพร่ร่วมกัน Terminal-Bench 4.0 เป็นตัวชี้วัดที่ใกล้เคียงที่สุดสำหรับการเปรียบเทียบตรง ๆ Moonshot รายงานว่า Kimi K3.1 Pro ทำคะแนนได้ 65.7% ขณะที่ Anthropic รายงาน Claude Opus 5.5 ที่ 66.4% ช่องว่างเพียง 0.7 คะแนนนี้บอกได้ชัดว่าประสิทธิภาพด้านการเขียนโค้ดแนวหน้าอยู่ในระดับใกล้กันมาก อย่างไรก็ตาม วิธีการรันเบนช์มาร์กไม่เหมือนกัน ฝั่ง Anthropic ใช้ระดับความพยายาม xhigh ซึ่งสูงกว่าค่าเริ่มต้น medium หนึ่งขั้น และเปิดระบบจัดเส้นทางด้านความปลอดภัย ในขณะที่ฝั่ง Moonshot รันที่การตั้งค่าสูงสุดซึ่งเป็นค่าเริ่มต้นของ Kimi บนฮาร์เนสของตนเอง ข้อความสำคัญจึงไม่ใช่ตัวเลข 0.7 คะแนน แต่คือการที่ทั้งสองโมเดลอยู่ในกลุ่มแนวหน้าที่ใกล้เคียงกันมากพอที่รายละเอียดการตั้งค่าการทดสอบจะทำให้ลำดับเปลี่ยนได้ หากคุณต้องการโมเดลภาษาขนาดใหญ่สำหรับงานเขียนโค้ดจริง ทั้งสองตัวเลือกให้ระดับความสามารถที่แข่งขันกันได้ ความต่างจึงกลับไปอยู่ที่ต้นทุนต่อโทเค็นและพฤติกรรมค่าเริ่มต้นมากกว่าคะแนนเบนช์มาร์กเพียงตัวเดียว
พฤติกรรมโมเดล และการจับคู่กับกรณีใช้งาน
Kimi K3.1 Pro ถูกอธิบายว่าเป็นรุ่นผ่าน post-training ของ Kimi K3 ที่ใช้ทรัพยากรการฝึกเสริมกำลังในหลายร้อยโดเมนปลายทาง ทำให้พฤติกรรมด้านการให้เหตุผลในบริบทยาว การจัดการเอเจนต์ และการลดการสร้างข้อมูลเท็จดีขึ้น โดยใน Kimi Hallu Bench Hard อัตราข้อกล่าวอ้างผิดเมื่อใช้เครื่องมือลดลงเหลือ 8.3% จาก 23.4% ของรุ่นก่อนหน้า ส่วน Claude Opus 5.5 เป็นโมเดลระดับ Opus ปัจจุบันที่ Anthropic เปิดให้ใช้งานทั่วไป มีชื่อเสียงด้านความเสถียรและระบบความปลอดภัยที่เข้ม สำหรับการจับคู่กรณีใช้งาน หากคุณต้องสร้างเอเจนต์ที่อ่านรีโพซิทอรีซ้ำ ๆ ใช้บริบทยาว และต้องการลดต้นทุนต่อการรันจำนวนมาก Kimi K3.1 Pro จะเหมาะกว่าเพราะเน้นความคุ้มค่าและการคิดลึกเป็นค่าเริ่มต้น ในทางกลับกัน ถ้างานของคุณอยู่ในสภาพแวดล้อมที่ให้ความสำคัญกับการยึดตามระบบความปลอดภัยและการตั้งค่าจาก Anthropic เช่น งานองค์กรที่ต้องผ่านการรับรองภายใน Claude Opus 5.5 จะตอบโจทย์มากกว่า แม้ต้นทุนต่อโทเค็นจะสูงกว่าในเชิงเปรียบเทียบ
ข้อสรุปเชิงตัดสินใจ: คุ้มค่ากับงานแบบไหน
เมื่อมองภาพรวมทั้งราคาเชิงคุณภาพ คะแนน AI model benchmark และพฤติกรรมโมเดล จะเห็นว่าทั้ง Kimi K3.1 Pro และ Claude Opus 5.5 ไม่ได้เป็นคู่แข่งที่คนหนึ่งชนะขาดในทุกมิติ แต่เป็นตัวเลือกที่เหมาะกับเวิร์กโหลดต่างกัน Kimi K3.1 Pro เน้นต้นทุนต่อโทเค็นที่ต่ำกว่าและการคิดเหตุผลระดับสูงเป็นค่าเริ่มต้น เหมาะกับผู้ใช้ที่ต้องการเปรียบเทียบ LLM ราคา เพื่อหาค่าต่อผลงานที่คุ้มที่สุด โดยยอมรับว่าบางงานอาจใช้โทเค็นมากขึ้นเพราะโมเดลคิดลึก ส่วน Claude Opus 5.5 เทียบ แล้วเด่นที่ระบบและชื่อเสียงของ Anthropic รวมถึงการตั้งค่าการคิดระดับ medium ที่อาจใช้โทเค็นต่อคำตอบน้อยกว่าในงานทั่วไป หากคุณเป็นผู้พัฒนาที่ต้องรันเอเจนต์จำนวนมากหรือให้บริการลูกค้าหลายราย การเลือก Kimi K3.1 Pro จะช่วยลดต้นทุนรวมได้มาก ในขณะที่ทีมที่ต้องการยึดตามระบบของ Anthropic หรือมีเวิร์กโฟลว์ที่ผูกกับ Opus อยู่แล้วอาจเลือกอยู่กับ Claude Opus 5.5 เพื่อความต่อเนื่องและการจัดการความเสี่ยงที่คุ้นเคย
- Buy the Kimi K3.1 Pro if คุณต้องการลดต้นทุนต่อเวิร์กโหลดจำนวนมาก และยอมรับการคิดลึกที่ใช้โทเค็นเพิ่ม
- Skip the Kimi K3.1 Pro if ระบบของคุณผูกกับเครื่องมือและนโยบายของ Anthropic อยู่แล้วและไม่ต้องการเปลี่ยนสแตก
- Buy the Claude Opus 5.5 if งานของคุณให้ความสำคัญกับการยึดตามระบบความปลอดภัยและค่าเริ่มต้นจาก Anthropic
- Skip the Claude Opus 5.5 if คุณกำลังมองหาเปรียบเทียบ LLM ราคา เพื่อให้ได้ต้นทุนต่อโทเค็นที่ต่ำที่สุดสำหรับเอเจนต์จำนวนมาก