
LLM บนมือถือคืออะไร และทำไมถึงน่าใช้
LLM บนมือถือคือการนำโมเดลภาษาขนาดใหญ่ไปประมวลผลภายในตัวเครื่องสมาร์ทโฟนโดยตรง โดยไม่ต้องส่งข้อมูลขึ้นไปยังเซิร์ฟเวอร์ระยะไกลหรือคลาวด์ ทำให้เราพิมพ์ถาม ขอให้เขียนอีเมล สรุปโน้ต หรืออธิบายแนวคิดต่าง ๆ โดยที่ข้อมูลยังอยู่ในอุปกรณ์ของเราเอง ลดความกังวลเรื่องความเป็นส่วนตัว ลดดีเลย์จากอินเทอร์เน็ต และยังใช้งานได้แม้ไม่มีสัญญาณอินเทอร์เน็ตหรือไฟดับ เหมาะกับคนที่อยากใช้ปัญญาประดิษฐ์ในอุปกรณ์อย่างต่อเนื่องและควบคุมได้
จากประสบการณ์ใช้งานจริง โมเดลแบบ local บนอุปกรณ์มือถือสามารถตอบโจทย์งานทั่ว ๆ ไปที่เรามักใช้บอตคลาวด์ได้ประมาณเกือบทั้งหมด เช่น รีไรต์อีเมล เช็กไวยากรณ์ภาษาอังกฤษ อธิบายคำศัพท์ หรือช่วยคิดไอเดียสั้น ๆ งานเหล่านี้ไม่จำเป็นต้องใช้โมเดลระดับศูนย์ข้อมูลขนาดใหญ่เลย เมื่อเราขยับมาใช้ AI ไม่ต้องใช้คลาวด์ งานกว่า 90 เปอร์เซ็นต์ในชีวิตประจำวันจะเริ่มรู้สึกว่าทำเสร็จได้ในเครื่องเดียวแบบไม่ติดขัด ข้อดีชัด ๆ คือดีเลย์ลดลงมาก เพราะไม่ต้องรอเครือข่าย รวมถึงความสบายใจเรื่องเอกสารส่วนตัวที่ไม่ถูกส่งออกนอกเครื่อง
รู้จักข้อจำกัดเครื่องและการเลือกโมเดลให้เหมาะ
ก่อนลงมือรัน LLM บนมือถือ สิ่งแรกที่ต้องดูคือข้อจำกัดฮาร์ดแวร์ โดยเฉพาะหน่วยความจำ เพราะหน่วยความจำในเครื่องจะเป็นตัวตัดสินว่าเรารันโมเดลขนาดไหนได้บ้างมากกว่าตัวแอปหรือการตั้งค่าใด ๆ ตัวอย่างจากการใช้มือถือที่มีหน่วยความจำรวม 8GB พบว่าพื้นที่ที่แอปจะได้ใช้จริงมีไม่เต็มทั้งหมด ทำให้ขนาดโมเดลที่เหมาะอยู่ราวช่วง 2B ถึง 4B แล้วมักใช้เวอร์ชันที่ถูกบีบอัดหรือ quant เพื่อลดขนาดไฟล์ลง เช่นระดับ Q4 ที่ใช้บิตน้อยลงแต่ยังพอรักษาประสิทธิภาพโมเดล AI ในระดับใช้งานทั่วไปได้
จุดที่หลายคนพลาดคือดูแต่ขนาดไฟล์โมเดล ไม่ดู context length ซึ่งเป็นจำนวน token สูงสุดที่โมเดลจะจำบริบทการสนทนาได้ต่อครั้ง Context length ไม่อยู่ในไฟล์ แต่เป็นค่าที่ตั้งในแอป ทุก token ที่เพิ่มเข้าไปจะกินหน่วยความจำเพิ่ม หากตั้งตามตัวเลขสูงสุดบนการ์ดโมเดล เช่นระดับหลักแสน token ที่ออกแบบมาสำหรับอุปกรณ์ใหญ่ จะทำให้มือถือมีโอกาสหน่วงหรือแอปล้ม ระบบที่ทดสอบจริงมักตั้งช่วง 4k ถึง 8k token เพื่อประหยัด token และรักษาสมดุลระหว่างความจำยาวกับความเสถียรของเครื่อง
ขั้นตอนลง LLM บนมือถือแบบเป็นเพื่อนสอนเพื่อน
ส่วนนี้จะพาเดินทีละขั้นเหมือนเล่าให้เพื่อนฟัง ว่าจะไปจากการใช้บอตคลาวด์ ไปสู่การมีปัญญาประดิษฐ์ในอุปกรณ์ของตัวเองได้อย่างไร จุดที่ต้องระวังคืออย่าคิดว่าแค่โหลดโมเดลแล้วจบ เพราะประสบการณ์ใช้งานขึ้นกับทั้งตัวแอป ฟีเจอร์รอบ ๆ และการตั้งค่าที่ช่วยประหยัด token กับแบตเตอรี่ด้วย การดูตัวอย่างการใช้งานจริงในแต่ละขั้นจะช่วยให้เห็นชัดว่าเมื่อไรควรใช้ AI ไม่ต้องใช้คลาวด์ และเมื่อไรควรกลับไปพึ่งคลาวด์
- ย้อนดูประวัติแชตเก่ากับบอตคลาวด์สักหนึ่งสัปดาห์ เพื่อเช็กว่างานไหนเป็นคำถามสั้น ๆ งานเขียน หรือการอธิบายความรู้ทั่วไปที่ไม่ต้องดึงข้อมูลออนไลน์ และงานไหนต้องค้นเว็บหรือโค้ดหนัก ๆ วิธีนี้ช่วยให้เห็นว่างานส่วนใหญ่ไม่จำเป็นต้องใช้คลาวด์ตั้งแต่แรก
- ประเมินสเปกมือถือของตัวเอง โดยดูหน่วยความจำที่มีและพื้นที่เก็บข้อมูลที่เหลือ แล้วเลือกโมเดลขนาด 2B หรือ 4B ที่เป็นเวอร์ชันบีบอัดหรือ quant ขนาดไฟล์โมเดลคือสิ่งแรกที่ควรเช็ก เพราะมันบอกคร่าว ๆ ว่าเครื่องต้องใช้หน่วยความจำเท่าไรแค่เพื่อโหลดโมเดลขึ้นมา
- เลือกแอปรัน LLM ที่ให้ฟีเจอร์มากกว่าแค่กล่องแชตและตัวเลือกโมเดล เพราะแอปที่มีแต่แชตอย่างเดียวจะไม่ตอบโจทย์ถ้าคุณอยากแทนที่ประสบการณ์แบบบอตคลาวด์ แอปที่ดีควรมีพื้นที่ทำงาน เครื่องมือเสริม และอาจรองรับไฟล์เอกสารหรือภาพเสียง เพื่อให้โมเดลช่วยงานหลากหลายกว่า
- ตั้งค่าความยาว context ให้เหมาะกับเครื่อง โดยไม่ไล่ตามค่าสูงสุดบนการ์ดโมเดล ตั้งช่วงราว 4k ถึง 8k token จะช่วยประหยัด token และลดโอกาสแอปเด้งหรือเครื่องหน่วง แอพบางตัวมีฟีเจอร์เช็กว่าโมเดลกับค่าที่ตั้งเหมาะกับเครื่องหรือไม่ ก่อนโหลดขึ้นมารัน
- ลองใช้หลายโมเดลคู่กันตามงานที่ทำ แทนที่จะหวังกับตัวเดียว เพราะในการใช้บอตคลาวด์เราก็ไม่ค่อยยึดติดกับบอตเดียวอยู่แล้ว เช่นใช้โมเดลขนาด 2B ที่ตอบเร็วสำหรับคำถามสั้น ๆ แล้วเปลี่ยนเป็นโมเดล 4B ที่เก่งด้านเหตุผลเมื่อทำงานวิเคราะห์หรือเรียบเรียงโครงสร้างยาว ๆ การมีชุดโมเดลหลายแบบทำให้ครอบคลุมงานได้กว้างขึ้น
คำพูดที่น่าอ้างอิงจากประสบการณ์หนึ่งคือ "การเลือกโมเดลตัวเดียวไม่ใช่สิ่งที่แนะนำ เพราะการใช้หลายโมเดลตามประเภทงานจะช่วยให้ครอบคลุมงานได้มากกว่า" ซึ่งสอดคล้องกับการใช้บอตคลาวด์ที่เรามักสลับไปมาระหว่างบริการต่าง ๆ อยู่แล้ว
คาดหวังประสิทธิภาพโมเดล AI บนมือถืออย่างไรดี
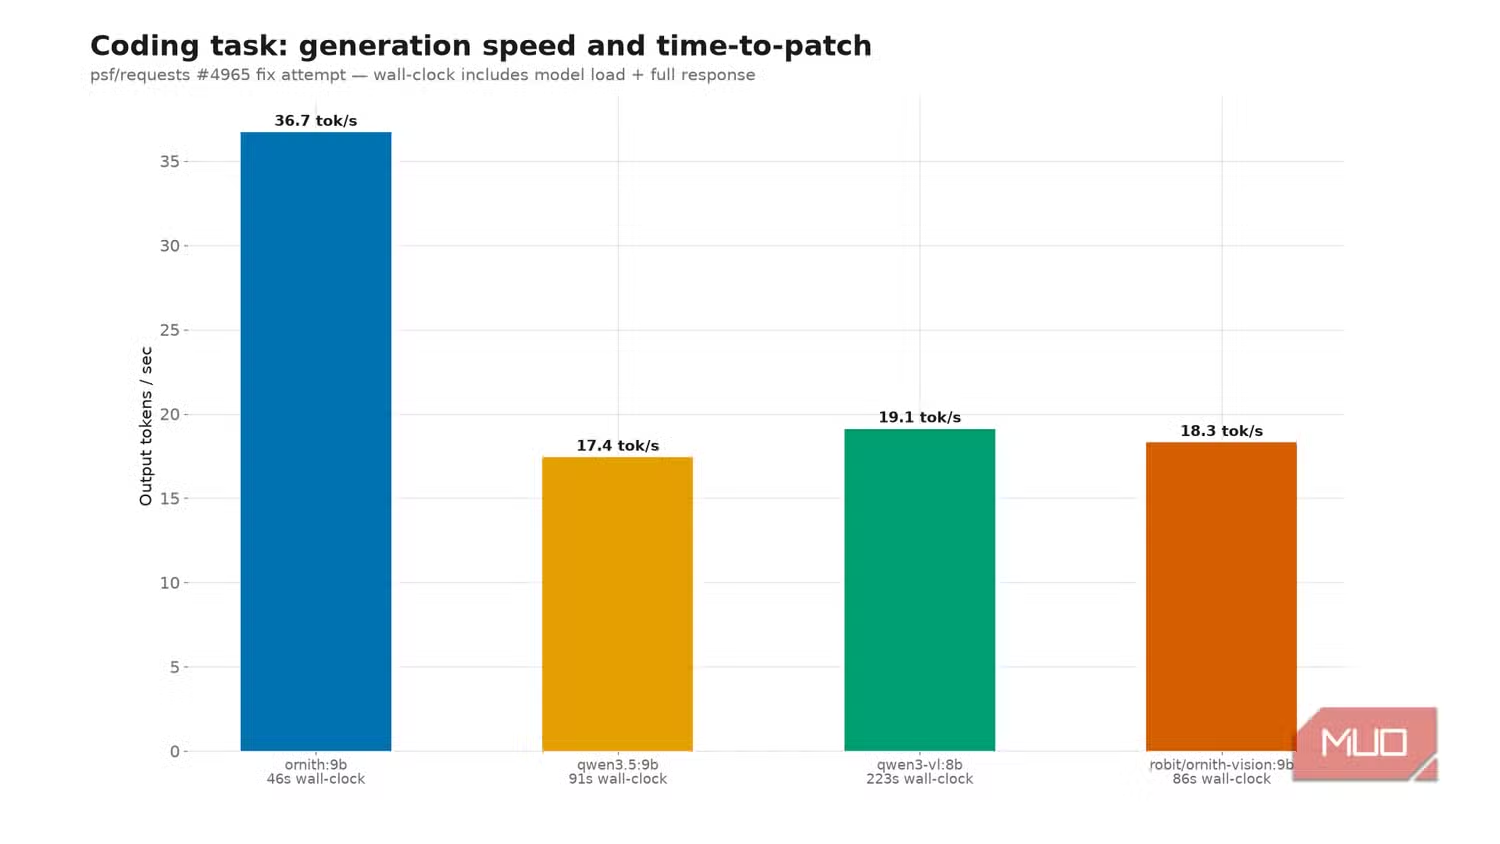
เมื่อเราตั้งค่าทุกอย่างลงตัวแล้ว LLM บนมือถือจะเริ่มให้ความรู้สึกเหมือนมีผู้ช่วยส่วนตัวที่ตอบเร็วพอสมควรและไม่ต้องแคร์สัญญาณเน็ต ด้านความเร็วมีตัวเลขให้จับต้องได้ เช่นโมเดลขนาด 2B แบบบีบอัดระดับ Q4 ที่ใช้สำหรับคำถามสั้น ๆ สามารถสร้างคำตอบได้ราว 32 token ต่อวินาที และยังรักษาได้มากกว่า 20 token ต่อวินาทีเมื่อคำถามยาวขึ้น ขณะที่โมเดล 4B เวอร์ชันบีบอัดอีกแบบแม้จะลดลงมาเหลือประมาณ 13 token ต่อวินาที แต่จะให้คำตอบด้านเหตุผลและโครงสร้างชัดกว่า เหมาะกับงานเรียนรู้หรือค้นคว้าที่จริงจังกว่า
นอกจากความเร็วแล้ว ประสิทธิภาพโมเดล AI แบบปัญญาประดิษฐ์ในอุปกรณ์ยังมีผลต่อแบตเตอรี่ หนึ่งในการทดลองพบว่าการรันคำตอบประมาณ 20 ครั้งทำให้แบตลดลงราว 10 เปอร์เซ็นต์บนเครื่องรุ่นหนึ่ง ดังนั้นหากตั้งใจใช้ LLM บนมือถือทั้งวันควรคิดเผื่อแบตสำหรับแอปอื่นด้วย ข้อจำกัดอีกอย่างคือบทสนทนาที่รัน local จะไม่ตามไปยังเดสก์ท็อป เมื่อคุณอยากย้ายไปทำงานต่อบนคอมพิวเตอร์ การใช้บอตคลาวด์จะสะดวกกว่า ทำให้ในภาพรวม AI ไม่ต้องใช้คลาวด์จะกลายเป็นตัวหลักสำหรับงานส่วนตัวและงานออฟไลน์ ส่วนคลาวด์ยังมีบทบาทในงานที่ต้องแชร์ข้ามอุปกรณ์หรือใช้โมเดลใหญ่
เมื่อไรควรใช้ AI ไม่ต้องใช้คลาวด์ และเมื่อไรควรกลับไปคลาวด์
จากการทดลองใช้โมเดลแบบ local บนอุปกรณ์มือถือเริ่มจากงานรอง ๆ แล้วค่อย ๆ ขยาย พบว่าความจำเป็นต้องใช้คลาวด์ลดลงมากกว่าที่คิด งานส่วนตัวเช่นเอกสารสำคัญที่เราไม่อยากให้ออกจากเครื่อง การจดบันทึกส่วนตัว หรือไอเดียเขียนที่ยังอยู่ในหัว เป็นพื้นที่ที่ AI ไม่ต้องใช้คลาวด์ตอบโจทย์สุด เพราะข้อมูลอยู่ในมือเราและรันได้แม้ไม่มีสัญญาณอินเทอร์เน็ตหรือมีปัญหาไฟดับบ่อย ๆ การประมวลผลในเครื่องยังช่วยลดดีเลย์จากเครือข่าย ทำให้รู้สึกว่าคำตอบโผล่ขึ้นมาได้ทันจังหวะคิดของเรา
อย่างไรก็ตาม ยังมีงานที่เหมาะกับคลาวด์มากกว่า เช่นงานวิจัยที่คุณแทบไม่รู้อะไรเลยแล้วต้องให้โมเดลค้นข้อมูลเว็บจำนวนมากหรือช่วยเขียนโค้ดซับซ้อน ในกรณีนี้โมเดลใหญ่บนคลาวด์ที่เข้าถึงเว็บและทรัพยากรสูงมักให้ผลลัพธ์ดีกว่า วิธีสรุปง่าย ๆ คือดูจากประวัติแชตในอดีต ถ้างานส่วนใหญ่เป็นคำถามทั่วไป เขียนรีไรต์ หรือสรุปความสั้น ๆ LLM บนมือถือจะพอ ข้อคิดท้ายบทความคือ การมีปัญญาประดิษฐ์ในอุปกรณ์ไม่มาแทนคลาวด์ทั้งหมด แต่เปลี่ยนบทบาทให้คลาวด์เป็นตัวเลือกเฉพาะทางมากขึ้น ส่วนงาน 90 เปอร์เซ็นต์ในชีวิตประจำวันคุณทำให้จบได้ในมือถือเครื่องเดียว