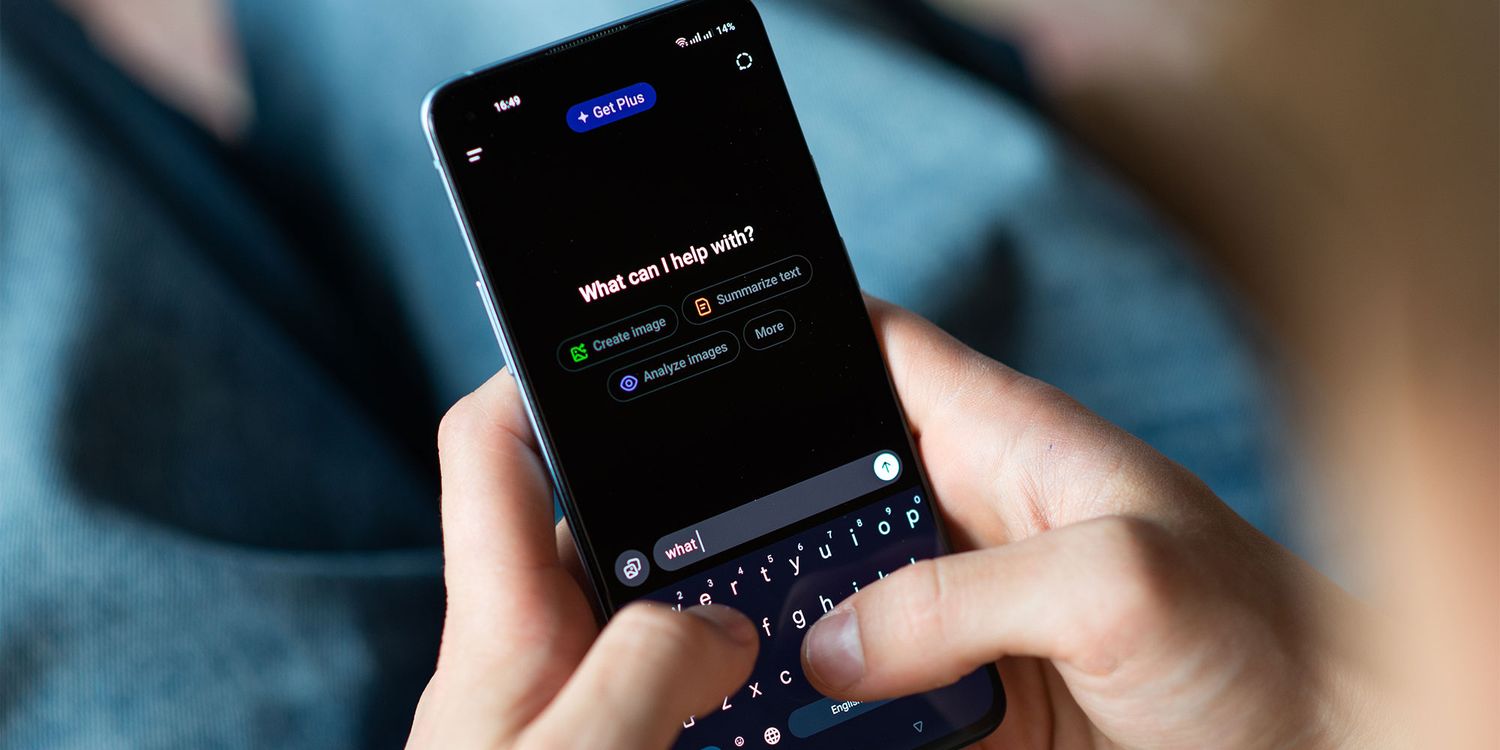

AI ออฟไลน์บนโทรศัพท์คืออะไร และเหมาะกับใคร
AI ออฟไลน์บนโทรศัพท์คือการติดตั้งและใช้งานโมเดลภาษา (Local LLM มือถือ) ที่ประมวลผลอยู่บนเครื่องของคุณเอง โดยดึงโน้ต เอกสาร และข้อมูลส่วนตัวจากแอปในเครื่องมาวิเคราะห์โดยไม่ต้องต่ออินเทอร์เน็ต ทำให้ยังถาม-ตอบ สรุป และค้นหาข้อมูลได้แม้ไม่มีสัญญาณ พร้อมลดการส่งข้อมูลขึ้นคลาวด์เพื่อรักษาความเป็นส่วนตัว AI โทรศัพท์ให้มากขึ้น เหมาะกับคนที่ใช้โทรศัพท์จดโน้ตเยอะ ทำงานหรือเรียนจากมือถือ และกังวลเรื่อง AI ที่ไม่ต้องอินเทอร์เน็ตจะเข้าไปอ่านหน้าจอหรือข้อมูลหลังบ้านแบบที่ไม่เห็นภาพชัดเจน
ก่อนจะเซตสแต็ก AI ออฟไลน์บนโทรศัพท์ สิ่งที่ต้องมีคือแอปจดโน้ตที่เก็บไฟล์เป็น .md หรือ .txt เช่น Obsidian และแอปรัน Local LLM มือถือที่รับเอกสารจากแอป Files ได้ พร้อมระบบค้นหาจากเอกสาร (RAG) ในตัว เงื่อนไขสำคัญคือเครื่องต้องมีพื้นที่เก็บข้อมูลพอ และยอมรับได้ว่าเวลาติดตั้งโมเดลครั้งแรกอาจใช้เวลาและแบตเตอรี่มากหน่อย แต่พอผ่านช่วงเซตอัพแล้ว คุณจะได้สแต็กที่ทำงานได้เองบนมือถือโดยไม่ต้องเชื่อมต่อคลาวด์แม้ขาดสัญญาณ

ทำไมต้องจับคู่ Local LLM กับ Obsidian แทนการใช้คลาวด์
หลายคนใช้ Obsidian บนมือถือเป็นเหมือนตู้เอกสารที่เอาไว้เก็บทุกอย่าง แต่พอจะกลับมาหาโน้ตเดิมอีกที การค้นหากลายเป็นงานช่างยาก เพราะจำไม่ได้ว่าใส่โฟลเดอร์ไหนหรือชื่อไฟล์อะไร เมื่อจับ Obsidian vault เข้ากับ Local LLM มือถือ สแต็กนี้จะเปลี่ยนจากแอปเก็บของให้กลายเป็นผู้ช่วยค้นข้อมูลที่รู้ลึกโน้ตทั้งหมดของคุณ และตอบเป็นประโยคสรุปที่มีการอ้างอิงส่วนของโน้ตที่ใช้ค้นจริงๆ ประสบการณ์มันใกล้เคียงกับการคุยกับแชตบอตบนคลาวด์มาก แต่ได้ทำงานออฟไลน์เต็มรูปแบบ
แอป Local LLM อย่าง PocketPal สามารถรันโมเดลบนเครื่องและใช้คุยแบบออฟไลน์ได้ แต่ข้อจำกัดคือไม่รองรับการอัปโหลดเอกสารเข้าไปอ่าน ซึ่งทำให้ช่วยเรื่องค้นโน้ตไม่ได้ สายที่เน้นงานเอกสารจึงต้องมองหาแอปที่มีระบบ RAG บนมือถือ อย่าง Noema บน iOS หรือ LocalRAG บน Android ที่อ่านไฟล์จาก vault ได้โดยตรง ข้อสำคัญคือสแต็กนี้ไม่ต้องใช้อินเทอร์เน็ตให้โมเดลไปวิ่งบนเซิร์ฟเวอร์ และไม่ต้องให้สิทธิ์ AI อ่านหน้าจอแบบตลอดเวลาเหมือนฟีเจอร์บางตัวที่คอยส่องทุกสิ่งบนเครื่อง
ขั้นตอนเซตสแต็ก AI ออฟไลน์บนโทรศัพท์ให้ใช้ทำงานได้จริง
ส่วนนี้จะพาเดินเป็นเพื่อนทีละขั้นเพื่อให้คุณได้สแต็ก AI ที่ไม่ต้องอินเทอร์เน็ตแต่ช่วยทำงานให้ได้ ใจความคือเอา Obsidian vault ที่อยู่ในเครื่องมาผูกกับ Local LLM มือถือที่รองรับเอกสาร และให้มันสร้างฐานค้นหาบนเครื่องเอง พอเสร็จแล้ว คุณถามอะไรก็ได้รับคำตอบพร้อมอ้างอิงว่าไปดึงจากโน้ตไหนบ้าง ระหว่างทำมีจุดต้องระวังเรื่องขนาดเอกสารและ context window ที่ถ้าปรับไม่ดี โมเดลจะอ่านได้ไม่ครบหรือใช้ทรัพยากรเครื่องเกินจำเป็น
- ติดตั้ง Obsidian บนมือถือและเซตให้ vault อยู่ในพื้นที่เก็บข้อมูลของโทรศัพท์ (ไม่ผูกกับคลาวด์) เพื่อให้ไฟล์ .md และ .txt อยู่บนเครื่อง
- ดาวน์โหลดแอป Local LLM มือถือที่รองรับการอ่านเอกสาร เช่น Noema บน iOS หรือ LocalRAG บน Android และตรวจสอบว่ารองรับการเลือกไฟล์จากแอป Files และมีระบบ RAG ในตัว
- เปิดแอป Local LLM ครั้งแรก เลือกโมเดลที่ต้องการใช้งานบนเครื่อง (รูปแบบ GGUF, MLX หรืออื่นๆ) และปล่อยให้แอปดาวน์โหลดโมเดลมาเก็บในเครื่องให้ครบ
- ลองเพิ่มไฟล์ Obsidian vault เข้าไปด้วยไอคอน Plus ในแอป Local LLM จากนั้นเลือกไฟล์ .md และ .txt ที่ต้องการให้โมเดลอ่านจากโฟลเดอร์ในแอป Files
- ปล่อยให้แอปดาวน์โหลด embedding model ครั้งแรก ซึ่งจะเปลี่ยนข้อความในโน้ตเป็นเวกเตอร์สำหรับค้นหา เป็นการตั้งค่าครั้งเดียว จากนั้นเอกสารที่เพิ่มเข้ามาทุกไฟล์จะถูกจัดทำดัชนีบนเครื่องโดยไม่มีการส่งข้อมูลขึ้นคลาวด์
- ปรับค่าต่างๆ เช่น temperature และความยาว context window ในแอป Local LLM เพื่อให้เหมาะกับสไตล์การตอบที่ต้องการและปริมาณข้อมูลที่โมเดลควรอ่านจากเอกสารแต่ละครั้ง
เมื่อทำครบทุกขั้น คุณจะได้สแต็ก AI ออฟไลน์บนโทรศัพท์ที่มีโมเดล ระบบฝังเวกเตอร์ และฐานโน้ตของตัวเองอยู่บนเครื่องล้วนๆ เวลาถามโมเดลเกี่ยวกับหัวข้อที่กระจายอยู่ในหลายโน้ต มันจะรวมคำตอบให้ พร้อมแนบหมายเลขอ้างอิงของชิ้นโน้ตที่ดึงมาใช้ จุดที่คนมักพลาดคือเพิ่มเอกสารจำนวนมากโดยไม่ดู context window ทำให้คำถามหนึ่งๆ ใช้บริบทเกินที่โมเดลรองรับและสิ้นเปลืองทรัพยากร การไล่เพิ่มเอกสารตามหมวดที่ใช้บ่อย และทดสอบทีละชุดจะทำให้ง่ายต่อการควบคุมมากกว่าเทใส่ทีเดียวทั้ง vault
ข้อผิดพลาดที่เจอบ่อยและวิธีเลี่ยงเพื่อให้สแต็กทำงานได้ต่อเนื่อง
เมื่อเริ่มใช้งานสักพัก ปัญหาที่เพื่อนๆ เจอกันบ่อยคือโมเดลตอบวนๆ หรือเริ่มตอบออกนอกเรื่อง ทั้งๆ ที่มีโน้ตอยู่เต็ม vault สาเหตุหลักมาจากการไม่ดู context window ที่แต่ละแอปรองรับ ถ้าคุณโยนเอกสารขนาดใหญ่หรือใส่ไฟล์เยอะเกินไปในคำถามเดียว โมเดลจะอ่านได้ไม่ครบและสุ่มเลือกส่วนข้อความมาประมวลผล ซึ่งไม่ดีทั้งกับคุณภาพคำตอบและการใช้ทรัพยากรบนเครื่อง วิธีเลี่ยงคือจำกัดจำนวนเอกสารที่แนบต่อคำถาม และใช้โครงสร้างคำถามที่บอกชัดว่าต้องการข้อมูลแบบ “สรุปจากโน้ตเหล่านี้พร้อมระบุแหล่งอ้างอิง” เพื่อบังคับให้โมเดลแสดงที่มาจากไฟล์ใน vault
อีกจุดหนึ่งคือการเข้าใจไปว่า “รันบนเครื่อง” เท่ากับไม่มีการล็อกหรือส่งข้อมูลออกเลย ทั้งที่ในโลกของฟีเจอร์ AI ที่อ่านหน้าจอหรือดึงข้อมูลจากระบบ ยังมีความเสี่ยงจากการที่ข้อมูลอาจถูกส่งไปประมวลผลบนเซิร์ฟเวอร์ในระยะถัดมาได้ ดังนั้นสแต็กที่ใช้ Local LLM มือถือกับ Obsidian จึงควรอยู่แยกจากฟีเจอร์ที่ให้สิทธิ์ AI เข้าถึงหน้าจอแบบต่อเนื่อง หรือบริการที่ไม่อธิบายชัดเจนว่าข้อมูลไปอยู่ที่ไหน การตั้งค่าปิดฟีเจอร์เชื่อมต่อกับคลาวด์ที่ไม่จำเป็น และใช้เฉพาะแอปที่ประกาศชัดว่า indexing เอกสารอยู่บนเครื่องจะช่วยรักษาความเป็นส่วนตัว AI โทรศัพท์ให้ดีขึ้น
ผลลัพธ์ที่คุ้มค่าและข้อคิดก่อนพก AI ออฟไลน์ไปทุกที่
เมื่อสแต็ก AI ออฟไลน์บนโทรศัพท์เริ่มเข้าที่ คุณจะรู้สึกเหมือนมีผู้ช่วยที่จำได้หมดทุกโน้ตที่เคยเขียน และพร้อมตอบคำถามแบบมีการอ้างอิงที่มาจากเอกสารใน vault มันให้ประสบการณ์ใกล้กับแชตบอตบนคลาวด์มาก แต่ไม่หลุดเมื่อปิดโหมดเครื่องบินหรืออยู่ในพื้นที่ไม่มีสัญญาณเลยสักขีด อีกทั้งยังไม่ต้องพึ่งระบบที่อาจอัปเดตเงื่อนไขการเก็บข้อมูลหรือการส่งต่อข้อมูลเข้าเซิร์ฟเวอร์โดยที่เราไม่ทันสังเกต จุดน่าสนใจคือ “สแต็ก AI มือถือที่รันทั้งโมเดล embedding และฐานความรู้บนเครื่องเองนั้นสามารถทำงานได้เต็มๆ แม้ไม่มีสัญญาณ”
ก่อนจะพกสแต็กนี้ไปใช้ทุกที่ ให้จำไว้ว่าความเป็นส่วนตัวไม่ใช่สวิตช์เปิดปิดทีเดียวแล้วจบ แต่เป็นนิสัยที่ต้องดูสิทธิ์แอปและรูปแบบการประมวลผลอยู่เสมอ AI ที่ไม่ต้องอินเทอร์เน็ตจะช่วยลดการส่งข้อมูลขึ้นคลาวด์ แต่ถ้าเปิดฟีเจอร์อ่านหน้าจอหรือเชื่อมต่อบริการอื่นๆ ที่เก็บข้อมูลไว้ การป้องกันก็ยังไม่สมบูรณ์ สรุปคือสแต็ก Local LLM มือถือคู่กับ Obsidian คุ้มสำหรับคนที่ใช้โทรศัพท์เป็นศูนย์กลางงานและต้องการควบคุมข้อมูลตัวเอง แต่ให้คอยดู context window และสิทธิ์ต่างๆ เป็นระยะ คุณจะได้ผู้ช่วยที่เก่งขึ้นเรื่อยๆ โดยไม่ต้องแลกด้วยความสบายใจเรื่องความเป็นส่วนตัว AI โทรศัพท์