
จากเครื่องมือเขียนโค้ดสู่ผู้ช่วยงานความรู้
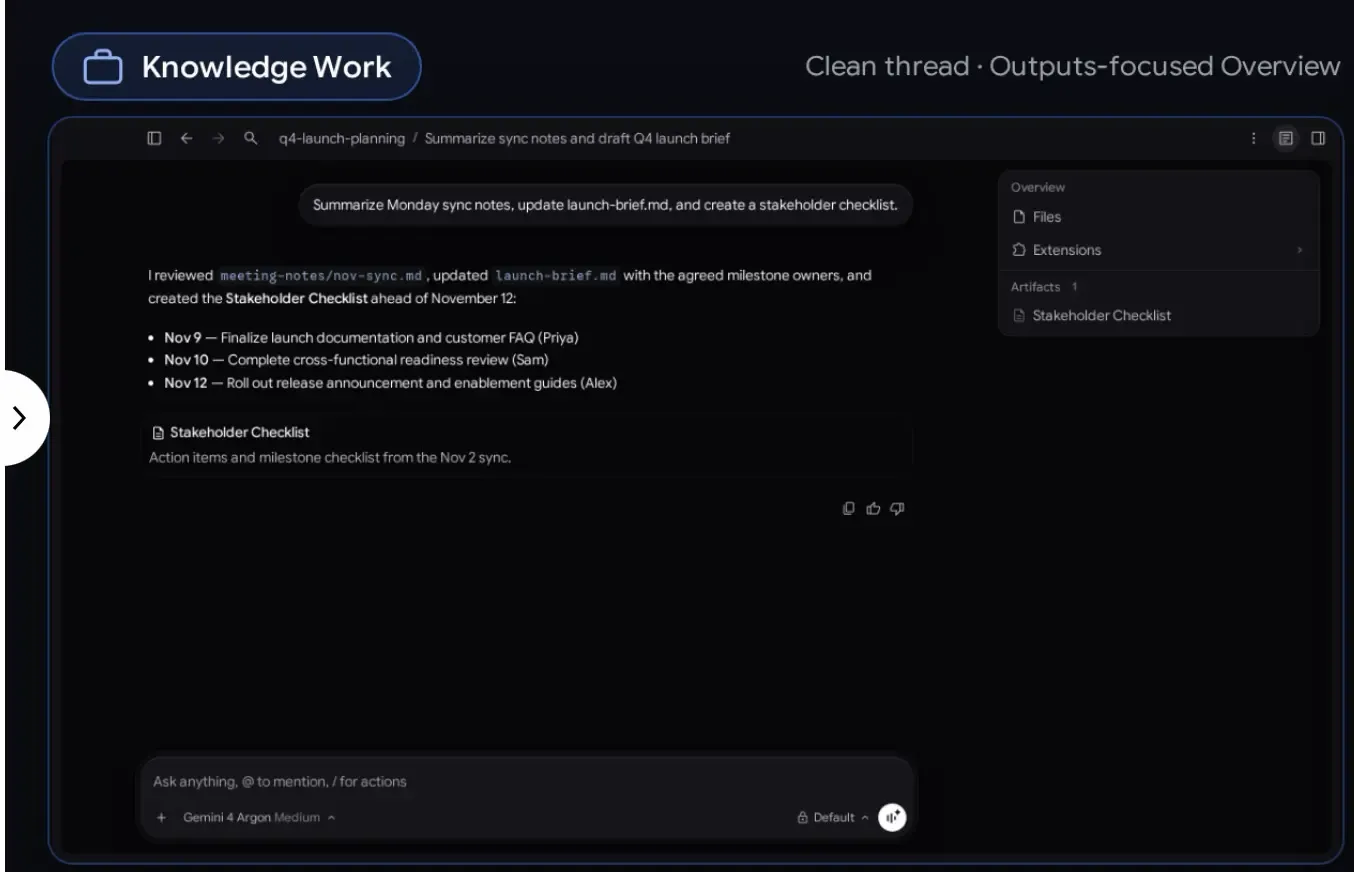
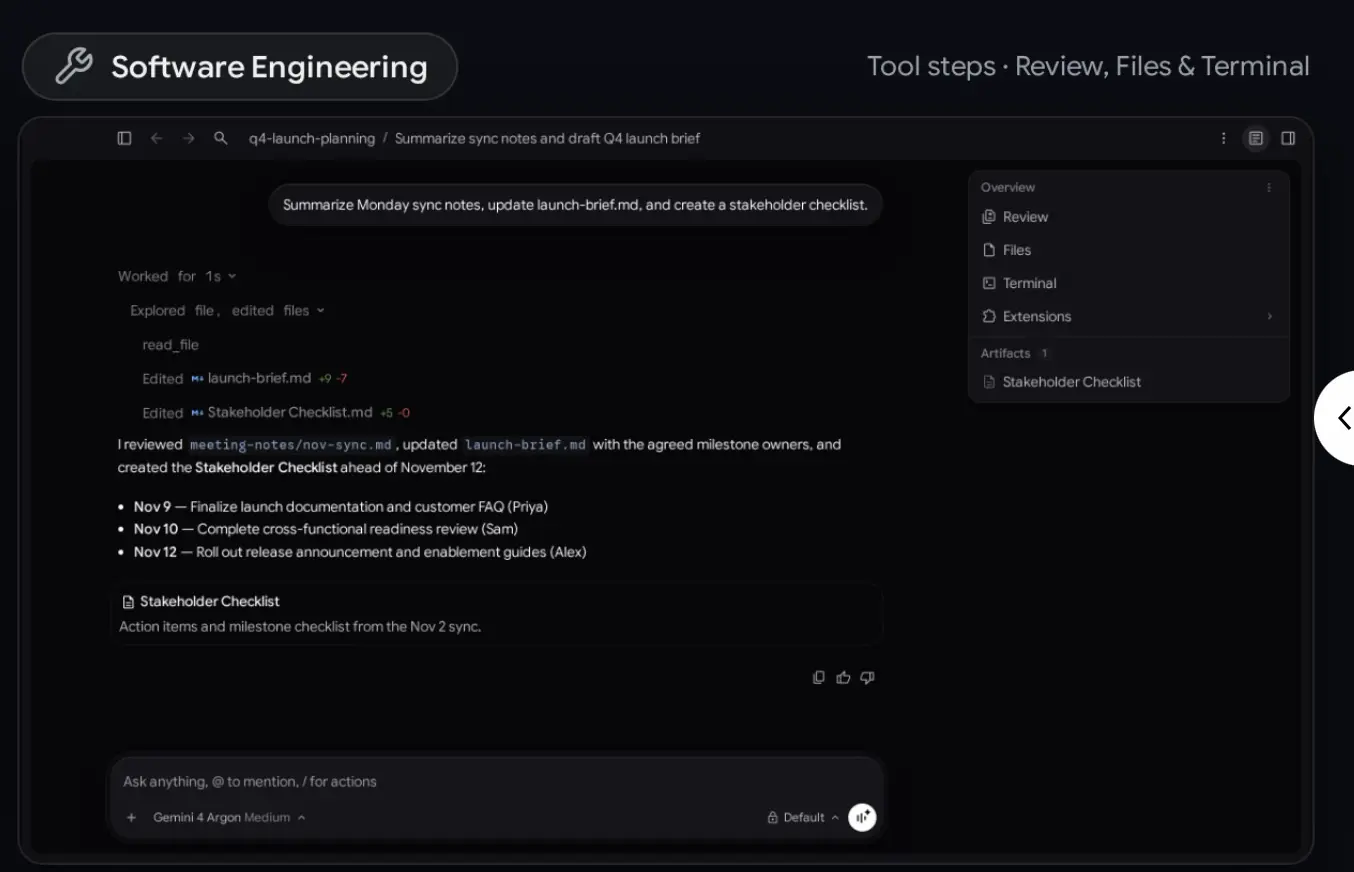
Google Antigravity คือแพลตฟอร์ม AI Agent ที่เดิมเน้นช่วยงานเขียนโค้ด และเพิ่มประสบการณ์ Knowledge Work เพื่อให้ผู้ใช้มอบหมายงานค้นคว้า วิเคราะห์ข้อมูล และร่างเอกสารได้ในพื้นที่ทำงานเดียวกัน นี่ไม่ใช่แค่การเปลี่ยนหน้าตาโปรแกรม แต่สะท้อนว่าขอบเขตงานของเอเจนต์กำลังขยับจากการสร้างซอฟต์แวร์ไปสู่งานความรู้ที่คนทำงานหลากหลายอาชีพต้องรับผิดชอบ Google เพิ่มหน้าต่าง Knowledge Work ควบคู่กับอินเทอร์เฟซ Software Engineering เดิม หลังพบว่าผู้ใช้และพนักงานภายในนำระบบไปใช้กับงานนอกเหนือจากโค้ดมากขึ้น
เหตุผลของการขยายครั้งนี้เห็นได้จากรูปแบบการใช้งานรายวัน ซึ่งครอบคลุมการค้นคว้าเชิงลึก การวิเคราะห์ข้อมูลด้วย AI การร่างเอกสารและงานนำเสนอ การทำต้นแบบดีไซน์ ตลอดจนงานอัตโนมัติทั่วไป พนักงานหลายหมื่นคนจากฝ่ายขาย การเงิน กฎหมาย ผลิตภัณฑ์ ดีไซน์ วิจัย การตลาด และปฏิบัติการ ใช้ Antigravity เป็นประจำร่วมกับทีมวิศวกร การมีโหมดเฉพาะจึงเป็นการตอบรับพฤติกรรมที่เกิดขึ้นแล้ว มากกว่าการคาดเดาว่าผู้ใช้ในอนาคตอาจต้องการอะไร

หน้าตาใหม่ แต่แกนของ AI Agent ยังเดิม
จุดน่าสนใจคือ Google ปรับประสบการณ์ใช้งานให้เหมาะกับงานความรู้ แต่ไม่ได้เปลี่ยนระบบ AI Agent ทำงานที่อยู่เบื้องหลัง เอเจนต์ยังเข้าถึงโมเดล ไฟล์ในเครื่อง ปลั๊กอิน ทักษะ กฎ ตัวแทนที่ผู้ใช้กำหนดเอง และเซิร์ฟเวอร์ MCP ได้ตามเดิม แนวทางนี้มีเหตุผล เพราะงานวิจัยหรือการร่างรายงานต้องอาศัยบริบทและเครื่องมือหลายชนิด ไม่ต่างจากงานพัฒนาซอฟต์แวร์ที่ต้องเปิดไฟล์และเรียกใช้เครื่องมือเฉพาะทาง
ผู้ใช้เปิดโหมด Knowledge Work ได้จากการตั้งค่า แล้วเลือกทั่วไปและรูปแบบอินเทอร์เฟซ เมื่อเปิดครั้งแรกจะมีขั้นตอนแนะนำการใช้งานแบบใหม่ด้วย การมีหน้าต่างแยกช่วยให้ผู้ใช้เข้าถึงงานที่ไม่ใช่โค้ดได้ชัดขึ้น แต่คุณค่าที่แท้จริงจะขึ้นกับว่าเอเจนต์ทำงานต่อเนื่องได้แค่ไหน ตั้งแต่ค้นแหล่งข้อมูล ทำความเข้าใจไฟล์ ไปจนถึงส่งมอบเอกสารที่ตรวจสอบได้ หากยังต้องให้คนคอยแก้ทุกขั้น ความสะดวกของอินเทอร์เฟซก็ยังไม่เท่ากับประสิทธิภาพในการทำงานจริง
MKA Benchmark ทดสอบมากกว่าคำตอบจากข้อความ
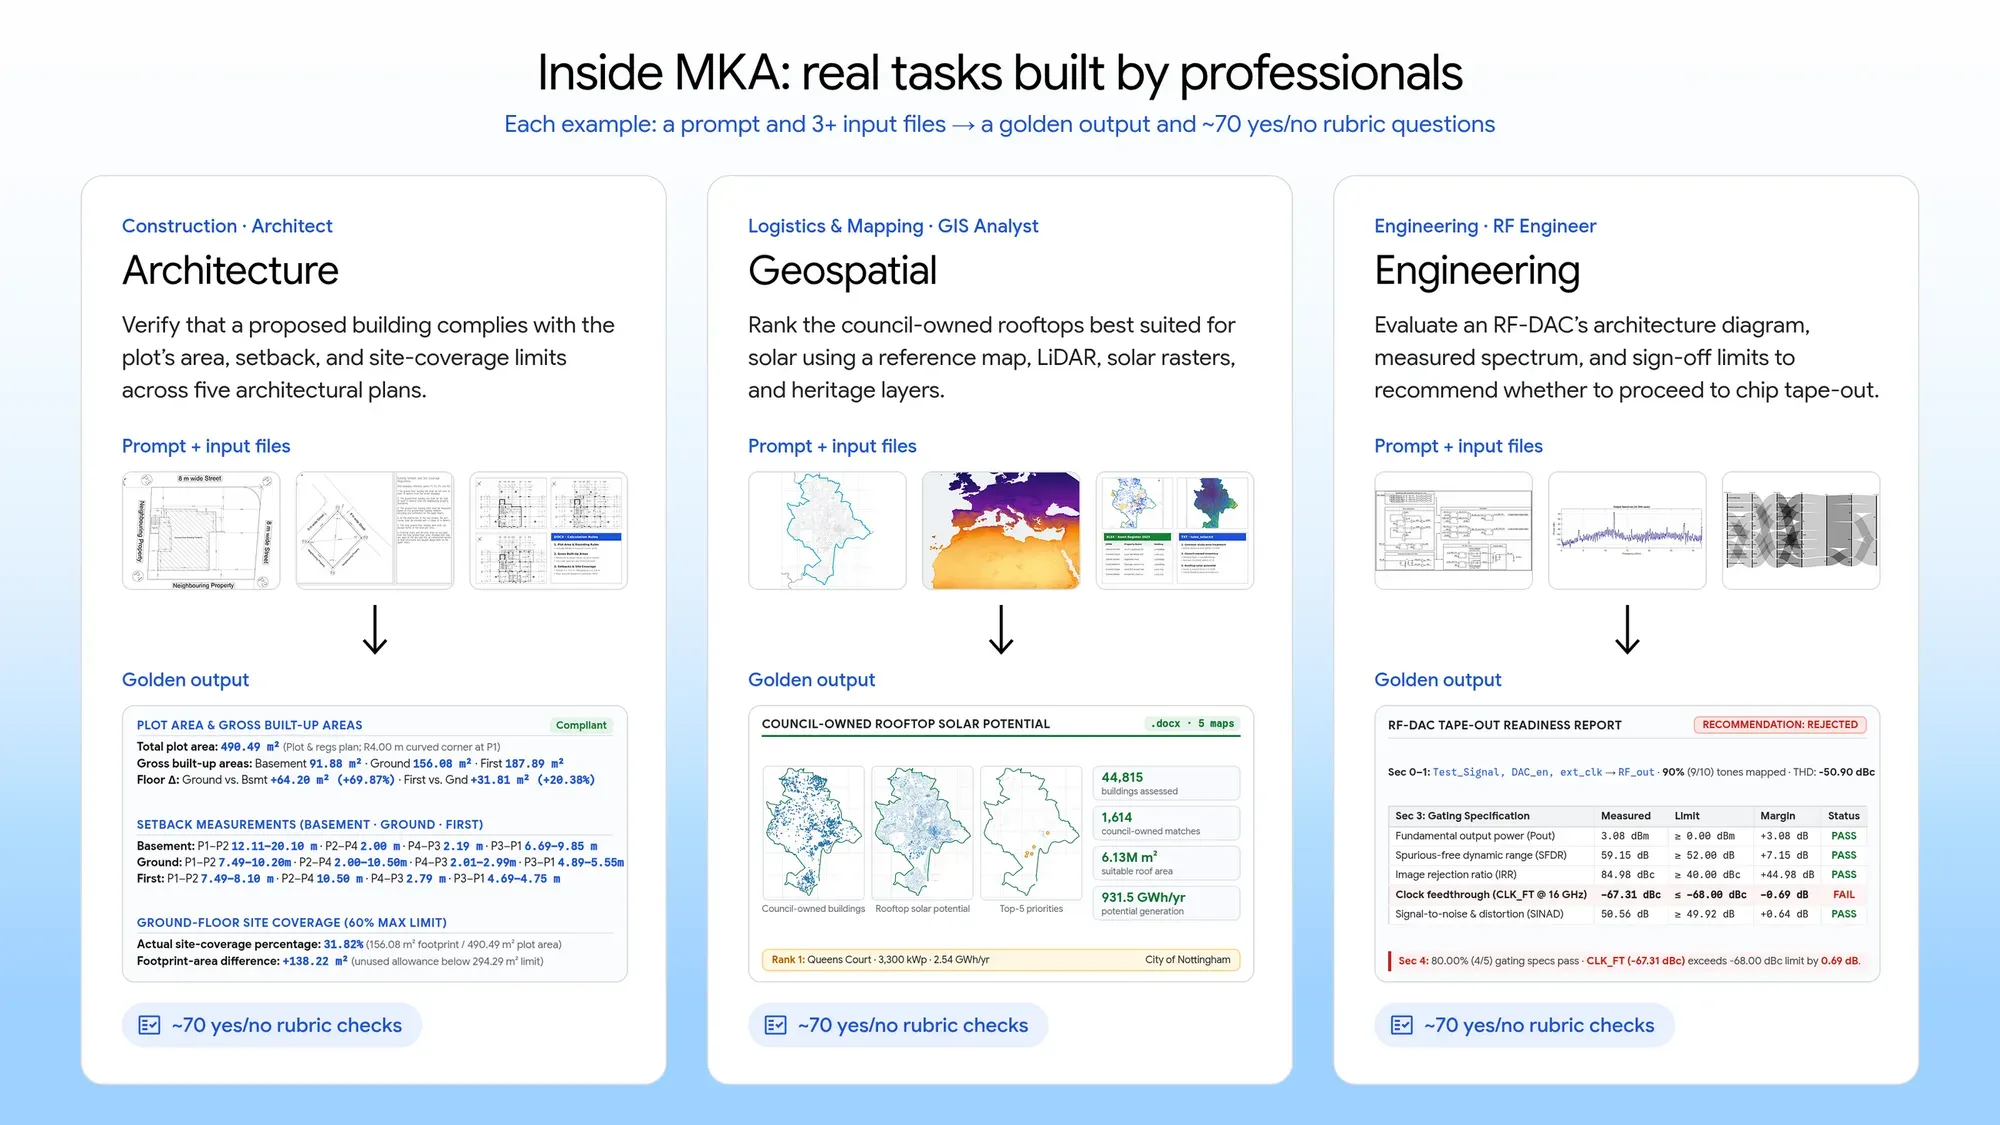
การย้ายเอเจนต์สู่งานความรู้ทำให้เกิดคำถามสำคัญว่า จะวัดความสามารถอย่างไรให้ใกล้กับงานอาชีพจริง MKA Benchmark หรือ Multimodal Knowledge Agent เกิดจากความร่วมมือกับ Artificial Analysis เพื่อทดสอบว่าเอเจนต์ให้เหตุผลกับไฟล์ที่มีข้อมูลภาพซับซ้อนได้เพียงใด ผู้จัดทำชี้ว่าโจทย์ความรู้จำนวนมากวัดด้วยข้อความอย่างเดียว ทั้งที่งานจริงต้องอ่านภาพและเค้าโครง เช่น แบบสถาปัตยกรรม แผนผังวิศวกรรม สไลด์ และตารางคำนวณ
MKA มีงานประเมิน 200 งาน ซึ่งพัฒนาร่วมกับผู้เชี่ยวชาญจาก 10 กลุ่มอุตสาหกรรมและ 83 อาชีพ งานแต่ละชิ้นจำลองโครงการหลายขั้นตอนที่ผู้เชี่ยวชาญมักใช้เวลาทำ 3–8 ชั่วโมง และให้คะแนนตามเกณฑ์ที่ผ่านการตรวจสอบราว 70 รายการ โดยให้น้ำหนักความถูกต้องของข้อเท็จจริง 75% และการออกแบบภาพ 25% รายละเอียดเหล่านี้ทำให้การทดสอบมีน้ำหนักกว่าการถามตอบสั้น ๆ เพราะบังคับให้เอเจนต์อ่านข้อมูลหลายรูปแบบและผลิตชิ้นงานที่ใช้ต่อได้
ขยายงานได้เร็ว แต่การวัดผลงานยังเป็นโจทย์
ผลทดสอบเบื้องต้นย้ำว่าความสามารถด้านภาพไม่ใช่ส่วนเสริม หากตัดการมองเห็นออก โมเดลจะล้มเหลวชัดเจนในงานที่ต้องอาศัยไฟล์และผังภาพ โมเดลระดับแนวหน้าก็ยังทำผลงานต่างกันมาก โดยใช้รอบทำงานเฉลี่ยตั้งแต่ 30 ถึง 130 รอบ กล่าวอีกอย่างคือ การมีเอเจนต์ที่รับงานหลายขั้นตอนยังไม่รับประกันว่าจะได้ผลลัพธ์ถูกต้องหรือทำงานได้คุ้มเวลา
เกณฑ์ MKA จึงเป็นพัฒนาการที่มีประโยชน์ แต่ยังไม่ควรถูกมองเป็นคำตัดสินสุดท้ายของความสามารถในทุกอาชีพ การประเมินต้องสะท้อนทั้งความถูกต้อง การจัดรูปแบบ และการทำงานกับไฟล์จริง อีกทั้งผลจากชุดทดสอบไม่อาจแทนความเสี่ยงเฉพาะองค์กรหรือความรับผิดชอบทางวิชาชีพได้ทั้งหมด ขณะเดียวกัน ผู้สนใจสามารถสำรวจเกณฑ์และทดสอบโมเดลของตนผ่าน Artificial Analysis ได้แล้ว ส่วน Gemini 4 Carbon เปิดให้ใช้งานผ่าน Gemini API ใน Google AI Studio โดยรายงานระบุว่าได้อันดับสองด้านคุณภาพ และมีต้นทุนเฉลี่ยต่ำกว่าโมเดลอันดับหนึ่ง 6 เท่า สรุปแล้ว Antigravity กำลังขยายบทบาทของเอเจนต์อย่างมีทิศทาง ส่วน MKA ช่วยตั้งคำถามที่จำเป็นกว่าแค่ความเร็ว นั่นคือมันทำงานอาชีพได้ถูกต้องและน่าเชื่อถือเพียงใด