
จากตอบข้อความสู่ทำงานความรู้จริง
MKA Benchmark คือชุดทดสอบที่ประเมินว่า AI Agent ใช้เหตุผลจากไฟล์หลายรูปแบบและข้อมูลภาพที่ซับซ้อน เพื่อทำงานความรู้หลายขั้นตอนในสถานการณ์ใกล้เคียงงานจริงได้ดีเพียงใด การเปิดตัวนี้เป็นความร่วมมือระหว่าง Google DeepMind กับ Artificial Analysis โดยตั้งใจแก้จุดบอดของการประเมินแบบเดิมที่มักวัดการตอบคำถามด้วยข้อความ มากกว่าความสามารถในการอ่านและจัดการเอกสารจริง
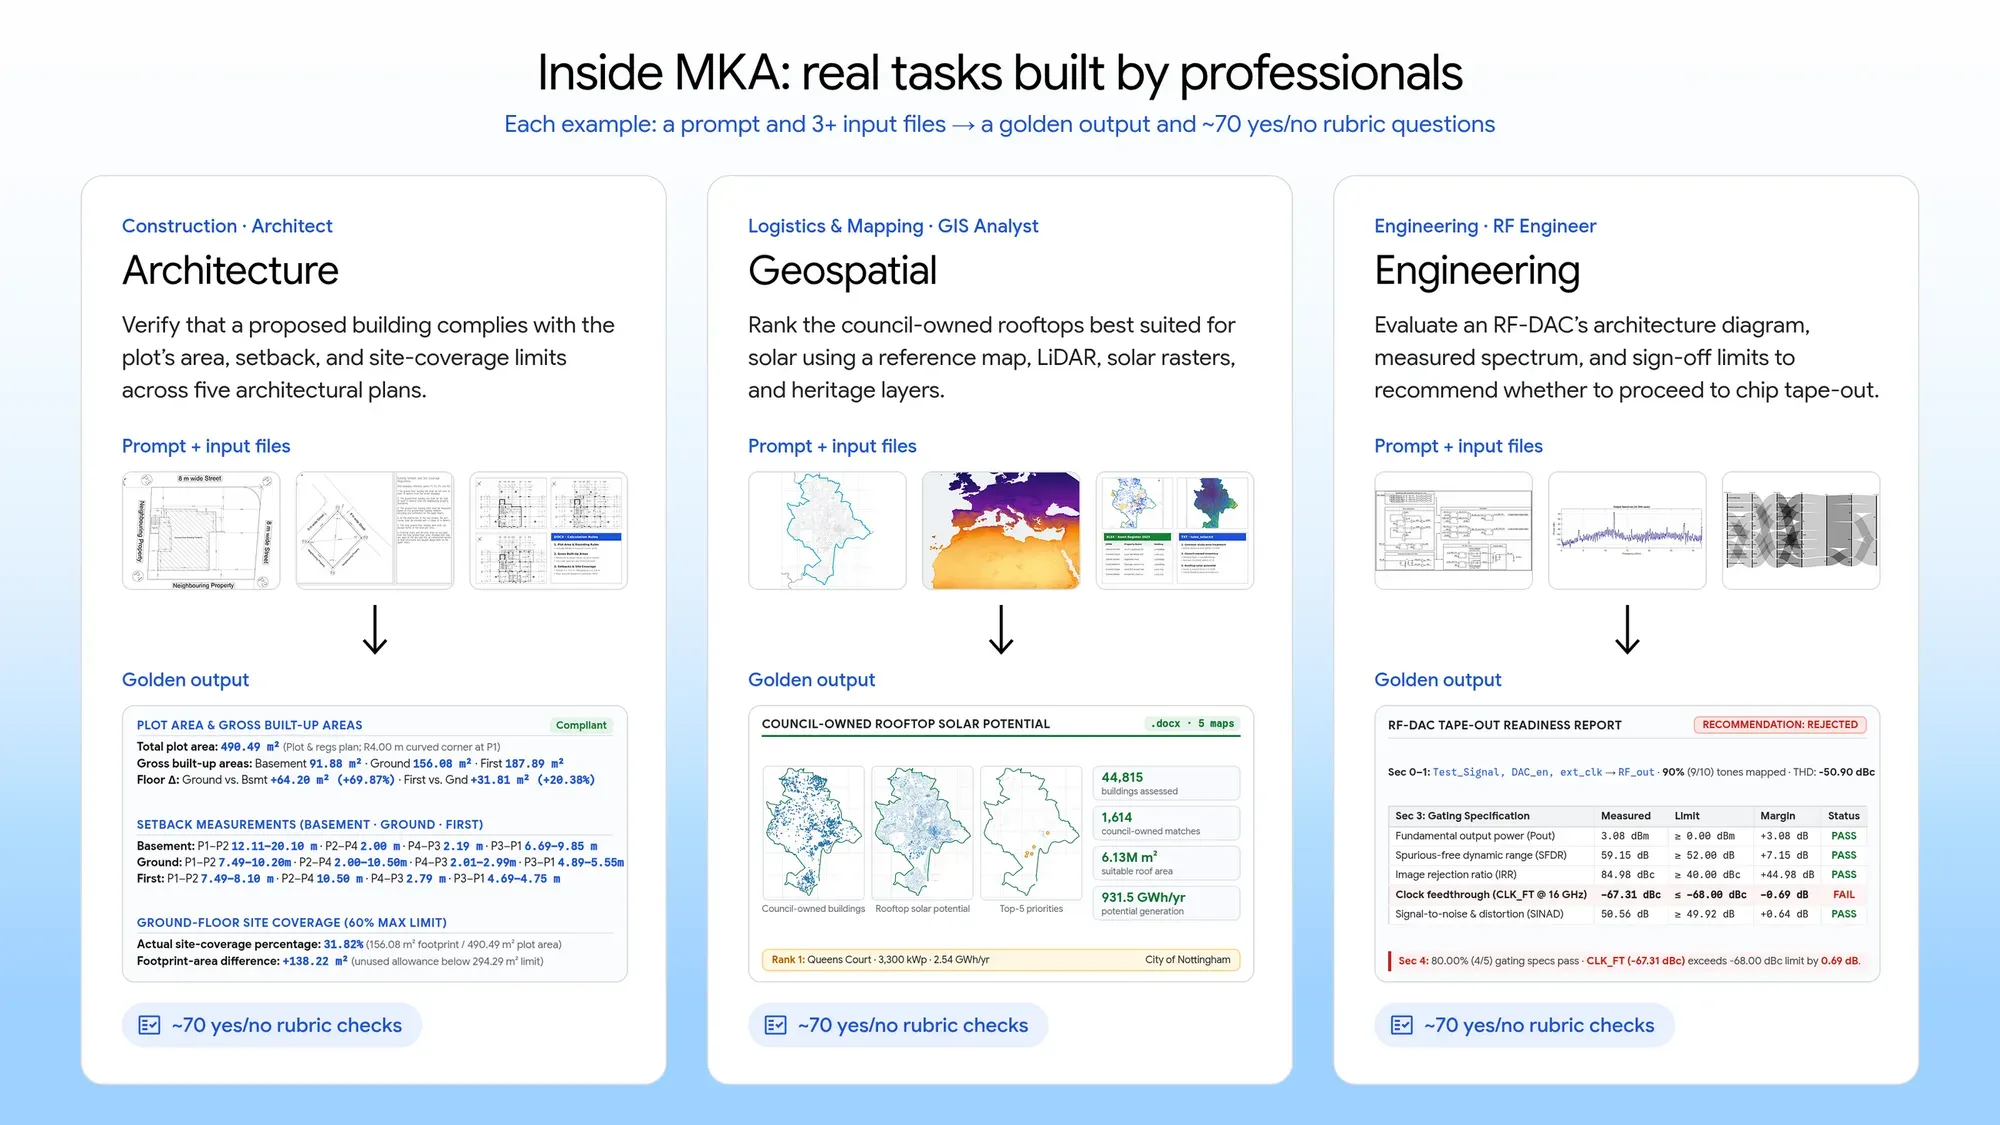
ช่องว่างนี้สำคัญ เพราะงานมืออาชีพไม่ได้จบที่การอ่านข้อความ แบบแปลนสถาปัตยกรรม ผังวิศวกรรม และภาพทางคลินิกต้องอาศัยการมองตำแหน่ง รูปแบบ และความสัมพันธ์ ก่อนนำข้อมูลไปสรุปเป็นรายงาน สไลด์ หรือสเปรดชีต การทดสอบที่ไม่แตะองค์ประกอบเหล่านี้จึงอาจทำให้โมเดลดูเก่งเกินจริงเมื่อเทียบกับงานที่ต้องทำจริง
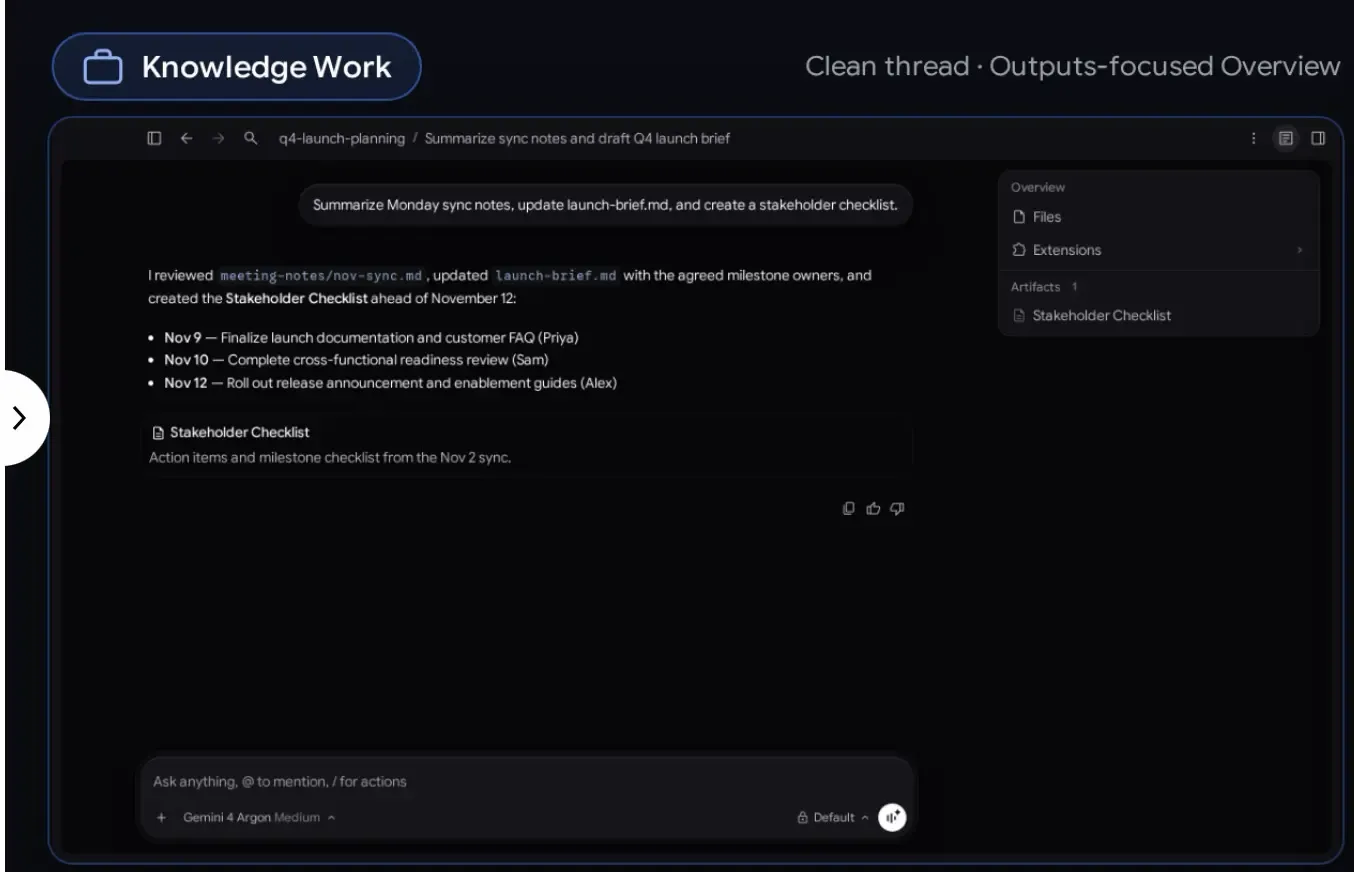
จุดแข็งของ MKA จึงไม่ใช่การเพิ่มข้อสอบภาพอีกชุด แต่เป็นการวัดว่าเอเจนต์เชื่อมการอ่านภาพกับการค้นข้อมูลและการสร้างชิ้นงานปลายทางได้หรือไม่ สำหรับผู้ใช้ทั่วไป นี่คือความต่างระหว่างผู้ช่วยที่บรรยายสิ่งที่เห็น กับผู้ช่วยที่ช่วยจัดการเอกสารและงานต่อเนื่องจนได้ผลลัพธ์พร้อมนำไปใช้
ข้อสอบจำลองงานที่ใช้เวลาหลายชั่วโมง
MKA มี 200 งาน ครอบคลุม 10 กลุ่มอุตสาหกรรมและ 83 อาชีพ ตั้งแต่ธุรกิจ วิศวกรรม การเงิน การแพทย์ ไปจนถึงวิทยาศาสตร์ แต่ละงานจำลองภารกิจที่ผู้เชี่ยวชาญอาจใช้เวลาทำ 3–8 ชั่วโมง เช่น ตรวจไฟล์หลายชนิด เทียบข้อมูล แล้วส่งมอบรายงานหรือสเปรดชีต ไม่ใช่เพียงตอบโจทย์สั้น ๆ ให้ถูกต้อง
เกณฑ์คะแนนให้น้ำหนักความถูกต้องของข้อเท็จจริง 75% และคุณภาพการออกแบบภาพ 25% พร้อมใช้เกณฑ์ผู้เชี่ยวชาญที่ตรวจสอบราว 70 รายการ วิธีนี้สะท้อนสิ่งที่นายจ้างหรือผู้ใช้ต้องการมากกว่าคะแนนความรู้ลอย ๆ คือข้อมูลต้องถูก และผลงานต้องจัดรูปแบบให้คนอ่านและนำไปทำงานต่อได้
การใช้โจทย์หลายขั้นตอนทำให้เห็นข้อจำกัดที่ข้อสอบถามตอบมักซ่อนอยู่ เช่น เอเจนต์อาจอ่านภาพได้แต่เชื่อมข้อมูลผิด หรือวิเคราะห์ถูกแต่สร้างไฟล์ปลายทางไม่น่าใช้ การเห็นความล้มเหลวเป็นช่วง ๆ ช่วยให้ทีมพัฒนาแยกได้ว่าควรปรับการมองภาพ การใช้เครื่องมือ หรือการตรวจทานก่อนส่งงาน
คะแนนสูงอย่างเดียวไม่พอ ต้องดูต้นทุนและความสม่ำเสมอ
ผลทดสอบชี้ว่าความสามารถของโมเดลต่างกันมาก แม้ทำงานประเภทเดียวกัน โดยใช้รอบดำเนินการเฉลี่ยราว 30–130 รอบ และความสามารถในการรับรู้ภาพมีผลชัดเจนเมื่อถูกตัดส่วนการมองเห็นออก ประเด็นนี้ทำให้ MKA มีประโยชน์กว่าการจัดอันดับแบบคะแนนเดียว เพราะเผยทั้งภาระการทำงานและจุดที่เอเจนต์ยังสะดุด
ในผลที่รายงาน Claude Fable 5.2 ทำอัตราผ่านแบบถ่วงน้ำหนักของงานยากได้ 57% และ Gemini 4 Carbon ได้ 54% อยู่ในอันดับสอง ขณะที่ข้อมูลจากผู้พัฒนา MKA ระบุว่า Gemini 4 Carbon ทำคะแนนคุณภาพอันดับสอง แต่มีต้นทุนเฉลี่ยต่อการทำงานต่ำกว่าโมเดลอันดับหนึ่ง 6 เท่า
ตัวเลขนี้ไม่ได้แปลว่าโมเดลอันดับสองเหมาะกับทุกองค์กร แต่ย้ำว่าการเลือก AI Agent ต้องชั่งคุณภาพกับทรัพยากรที่ใช้ การทดสอบภายใต้เครื่องมือ สภาพแวดล้อม และข้อจำกัดจำนวนรอบที่เท่าเทียมกันช่วยให้เทียบกันได้เป็นธรรมขึ้น อย่างไรก็ตาม คะแนนมาตรฐานยังแทนการทดลองกับเอกสารและกฎการทำงานของแต่ละองค์กรไม่ได้
สัญญาณที่ดี แต่ยังไม่ใช่ใบรับรองพร้อมใช้งาน
การประเมินใกล้โลกจริงช่วยให้เห็นความสามารถของเอเจนต์ชัดขึ้น เพราะบังคับให้ทำตั้งแต่รับไฟล์ วิเคราะห์ข้อมูลภาพ ตรวจทานข้อเท็จจริง ไปจนถึงจัดทำชิ้นงาน การใช้ผู้เชี่ยวชาญจากหลายอุตสาหกรรมออกแบบโจทย์ยังลดความเสี่ยงที่ benchmark จะสะท้อนเพียงทักษะที่โมเดลถนัดในห้องทดลอง แต่ไม่ควรตีความว่าผ่านคะแนนแล้วจะปลอดภัยหรือถูกต้องทุกครั้ง
ชุดทดสอบหลัก 200 งานถูกเก็บเป็นความลับเพื่อลดโอกาสที่โจทย์จะรั่วเข้าสู่ข้อมูลฝึก ขณะที่มีงานสาธารณะ 10 งานให้ทดลอง ผู้สนใจสามารถสำรวจ benchmark และประเมินโมเดลของตนผ่าน Artificial Analysis ส่วน Gemini 4 Carbon เปิดให้ใช้ผ่าน Gemini API ใน Google AI Studio แล้ว
ข้อสรุปคือ MKA Benchmark เป็นก้าวที่มีน้ำหนัก เพราะเปลี่ยนคำถามจาก AI Agent ตอบเก่งแค่ไหน เป็นทำงานหลายขั้นตอนกับไฟล์จริงได้ดีเพียงใด สำหรับองค์กร คะแนนเป็นจุดเริ่มต้นในการคัดเลือก ไม่ใช่คำตัดสินสุดท้าย ส่วนผู้ใช้ทั่วไปควรคาดหวังผู้ช่วยที่ทำงานเอกสารได้มากขึ้น แต่ยังตรวจความถูกต้องและผลลัพธ์ก่อนนำไปใช้