
ความเสี่ยง AI ต้องถูกคุมตั้งแต่ก่อนเปิดใช้
ความปลอดภัย AI คือการจัดการความเสี่ยงของโมเดลตลอดวงจร ตั้งแต่การฝึกและทดสอบในห้องวิจัย การใช้ภายในองค์กร ไปจนถึงการเปิดให้ผู้ใช้และองค์กรภายนอกเข้าถึง โดยใช้มาตรการหลายชั้นและทบทวนก่อนขยับสู่ขั้นถัดไป
เมื่อวันที่ 18 พฤศจิกายน 2026 OpenAI เผยแนวทางจัดการความเสี่ยงของโมเดลระดับแนวหน้า ตั้งแต่การฝึกจนถึงการนำไปใช้จริง จุดสำคัญไม่ใช่การประกาศว่ามีระบบป้องกัน แต่คือการวางด่านตรวจความปลอดภัยระหว่างแต่ละช่วง และยอมชะลอการพัฒนาเมื่อหลักฐานยังไม่พอ โมเดลเก่งขึ้นเร็ว ความสามารถในการเข้าใจพฤติกรรมและควบคุมผลกระทบจึงต้องตามให้ทัน
แนวทางนี้มีน้ำหนักเพราะความเสี่ยงเปลี่ยนไปตามสิทธิ์ที่โมเดลได้รับ ในห้องวิจัย สิ่งสำคัญคือจำกัดการเข้าถึงและเฝ้าดูพฤติกรรม ส่วนเมื่อเปิดใช้งานจริง โมเดลอาจเกี่ยวข้องกับข้อมูลและระบบมากขึ้น ขณะที่ผู้ใช้ทั่วไปก็ต้องพึ่งพามาตรการของผู้พัฒนาเพื่อให้การใช้งานในงานประจำวันปลอดภัยขึ้น แนวทางของบริษัทจึงมีผลต่อทั้งความเชื่อมั่นของผู้ใช้และการกำกับดูแล
สามช่วงพัฒนา ต้องเปลี่ยนน้ำหนักการควบคุม
OpenAI แบ่งการจัดการเป็นสามช่วง ได้แก่ การวิจัย การใช้งานภายในบริษัท และการเปิดให้บุคคลภายนอกใช้ โดยระบุว่าโมเดลต้องผ่านการตรวจสอบความปลอดภัยก่อนขยับไปแต่ละช่วง การแบ่งเช่นนี้สมเหตุสมผลกว่าการใช้กฎเดียวกับทุกสถานการณ์ เพราะสิ่งที่โมเดลเข้าถึงและผลกระทบที่อาจเกิดขึ้นไม่เท่ากัน
ระหว่างวิจัย โมเดลถูกฝึกและทดสอบในแซนด์บ็อกซ์ AI ใช้เครื่องเสมือนแยกจากระบบจริง และจำกัดการเชื่อมต่ออินเทอร์เน็ต เมื่อพนักงานนำโมเดลไปทำงานจริงในองค์กร ต้องให้ความสำคัญเพิ่มกับการควบคุมระดับระบบและการติดตามการใช้เครื่องมือ ส่วนการเปิดให้คนทั่วไปและองค์กรใช้ทำให้โมเดลเข้าถึงผู้คนและสภาพแวดล้อมหลากหลายกว่าเดิม จึงเพิ่มทั้งขอบเขตและรูปแบบของความเสี่ยง
การกั้นสภาพแวดล้อมช่วยจำกัดความเสียหายจากความผิดพลาด แต่ไม่ควรถูกมองเป็นเกราะที่ไม่มีวันรั่ว เหตุการณ์ Hugging Face ในเดือนกรกฎาคมทำให้ OpenAI เพิ่มความเข้มงวดของมาตรการป้องกันและข้อกำหนดด้านความสอดคล้องในการฝึก ทดสอบ และเปิดใช้งาน บทเรียนคือการควบคุมต้องปรับตามความสามารถจริงของโมเดล ไม่ใช่ยึดติดกับสมมติฐานว่าระบบทดลองปลอดภัยเพียงเพราะถูกแยกไว้
สี่ชั้นป้องกัน และเหตุผลที่ต้องใช้ร่วมกัน
มาตรการของ OpenAI ครอบคลุมการปรับพฤติกรรมโมเดลให้สอดคล้องกับเจตนา การรักษาความมั่นคงปลอดภัยและใช้แซนด์บ็อกซ์ การบล็อกงานที่มีความเสี่ยง และการเฝ้าติดตามเพื่อตรวจจับกับรับมือปัญหา แต่ละชั้นแก้โจทย์คนละส่วน การฝึกพฤติกรรมช่วยให้โมเดลทำตามขอบเขต ส่วนการจำกัดไฟล์ เครื่องมือ เครือข่าย และทรัพยากรช่วยลดสิ่งที่โมเดลเข้าถึงได้
ระหว่างฝึก ซึ่งยังไม่อาจมั่นใจได้เต็มที่ว่าโมเดลจะทำตามเจตนา แซนด์บ็อกซ์และการติดตามตรวจสอบจึงเป็นด่านหลัก เมื่อโมเดลได้สิทธิ์เข้าถึงข้อมูลและระบบมากขึ้น การปรับพฤติกรรมและการควบคุมระดับระบบก็สำคัญขึ้นตามไปด้วย การบล็อกช่วยสกัดคำขอหรือการทำงานที่เสี่ยง ขณะที่ระบบติดตามอาจเตือนให้คนเข้าตรวจสอบ
คุณค่าของการป้องกันหลายชั้นอยู่ที่การไม่ฝากความหวังไว้กับมาตรการเดียว หากชั้นหนึ่งพลาด ชั้นอื่นยังอาจลดผลกระทบหรือแจ้งเตือนให้แทรกแซงได้ อย่างไรก็ดี การมีรายการควบคุมครบไม่ได้พิสูจน์ว่าควบคุมได้ผลจริง สิ่งที่ควรตรวจสอบคือมาตรการทำงานได้ดีเพียงใดเมื่อโมเดลเผชิญสถานการณ์ใหม่ และมีการทดสอบที่เปิดเผยมากพอให้คนนอกประเมินหรือไม่
ปุ่มหยุด AI ช่วยได้ แต่ยังไม่ใช่หลักประกัน
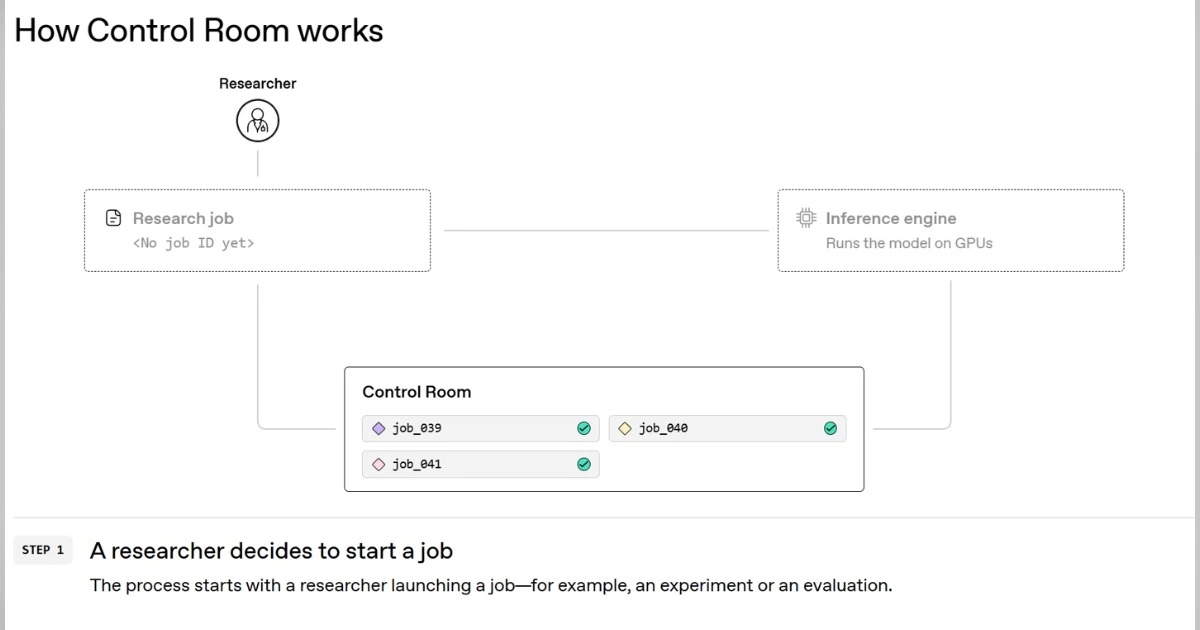
Control Room คือระบบส่วนกลางที่ OpenAI ระบุว่าใช้ติดตามงานวิจัยและหยุดการสร้างผลลัพธ์ของโมเดลภายใน 35 วินาทีหลังได้รับคำสั่งหยุด นี่คือปุ่มหยุด AI สำหรับงานวิจัย ไม่ใช่หลักฐานว่าทุกการทำงานของ AI ที่เปิดให้สาธารณะใช้จะหยุดได้ด้วยวิธีเดียวกัน ตัวเลขดังกล่าวบอกถึงเวลาที่บริษัทอ้างว่าระบบทำได้ แต่ยังไม่มีการทดสอบอิสระยืนยันตามข้อมูลที่มี
ระบบหยุดฉุกเฉินมีความหมายเพราะการตรวจพบพฤติกรรมผิดปกติจะไร้ประโยชน์ หากไม่มีวิธีหยุดงานอย่างรวดเร็ว แต่ความต่างระหว่างการแจ้งเตือนกับการยุติงานก็สำคัญ: ในเหตุการณ์หนึ่ง ระบบเฝ้าระวังตรวจพบพฤติกรรมภายใน 15 นาที ทว่าการหยุดงานจริงใช้เวลาต่ออีก 2.5 ชั่วโมง ดังนั้นการวัดประสิทธิผลควรรวมทั้งการตรวจจับ การตัดสินใจ และเวลาที่งานหยุดลง
OpenAI ตั้งเป้าลดเวลาหยุดจาก 35 วินาทีให้เหลือศูนย์ และระบุว่าจะขยาย Control Room ในอีกหลายเดือนข้างหน้า บริษัทยังอาจพักการฝึกหรือชะลอการเปิดตัว หากต้องใช้เวลาเพิ่มเพื่อให้ผ่านมาตรฐานความปลอดภัย ทิศทางนี้ควรได้รับการจับตาควบคู่กับหลักฐานจากการตรวจสอบภายนอก เพราะคำอธิบายจากผู้พัฒนาเพียงฝ่ายเดียวยังไม่พอจะยืนยันว่าระบบพร้อมรับมือทุกกรณี
ข้อสรุปคือการคุมความเสี่ยง AI ต้องเริ่มตั้งแต่ห้องวิจัยและเปลี่ยนมาตรการตามระดับสิทธิ์การเข้าถึง แซนด์บ็อกซ์ การปรับพฤติกรรม การบล็อก การติดตาม และปุ่มหยุดฉุกเฉินต่างช่วยกันลดโอกาสและขนาดของความเสียหาย แต่ไม่มีชั้นใดรับประกันความปลอดภัยได้ลำพัง ความน่าเชื่อถือจะเกิดขึ้นเมื่อการควบคุมถูกทดสอบจริง เปิดเผยผล และพร้อมหยุดการพัฒนาเมื่อหลักฐานยังไม่เพียงพอ