
เริ่มจากรูปแบบงาน ไม่ใช่ตัวเลขเบนช์มาร์ก
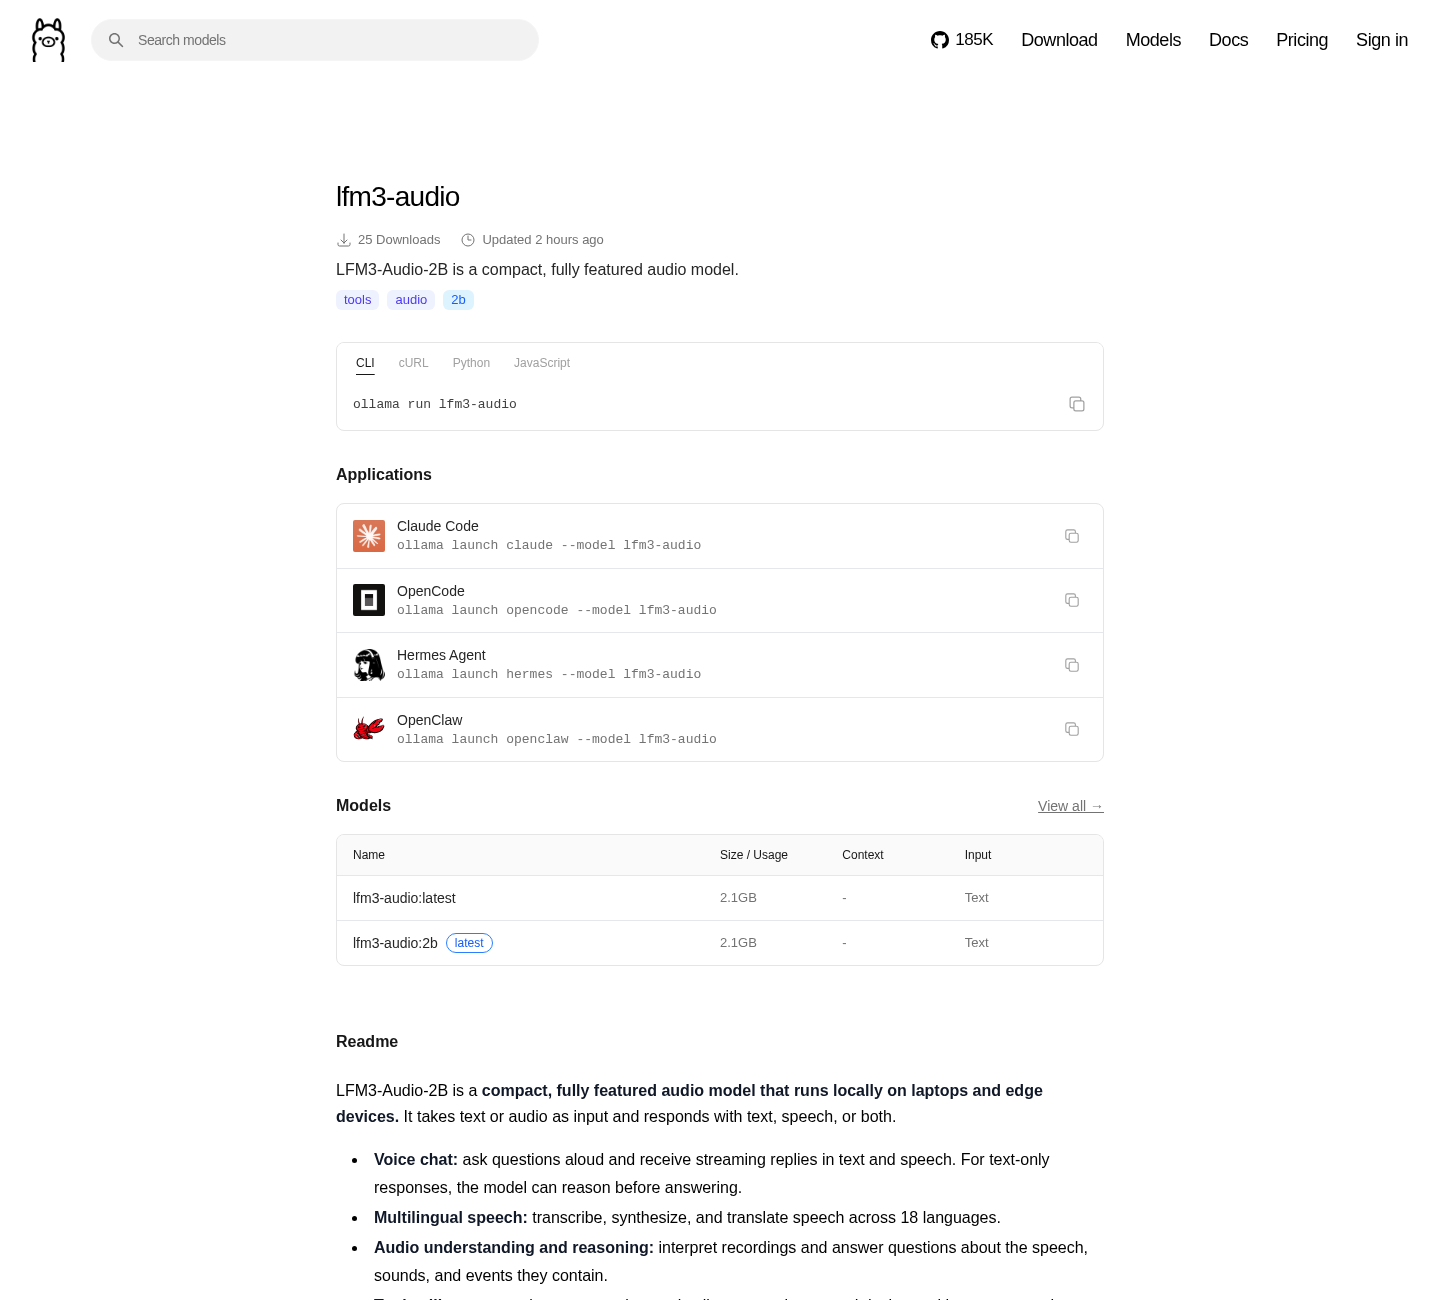
โมเดลเสียง AI คือระบบที่รับหรือสร้างเสียงพูด และอาจเชื่อมเสียงเข้ากับข้อความ ภาพ หรือคำสั่ง เพื่อใช้ถอดเสียง แปลภาษา สนทนา หรือเรียกเครื่องมือได้ โดยความเหมาะสมขึ้นกับรูปแบบอินพุตและเอาต์พุต วิธีติดตั้ง และทรัพยากรที่มี มากกว่าคะแนนทดสอบเพียงค่าเดียว ถ้าต้องการดาวน์โหลดไฟล์มารันเองบนอุปกรณ์ที่มีอยู่ LFM3-Audio-2B เป็นตัวเลือกตรงโจทย์ ส่วน Voxtral 3 เหมาะกับทีมที่ต้องการบริการผ่าน API และชุดเครื่องมือเสียงที่จัดไว้ให้ แต่ยังไม่มีผลทดสอบตัวต่อตัวที่ยืนยันว่าโมเดลใดแม่นยำกว่า จึงไม่ควรนำคะแนนจากคนละชุดทดสอบมาเรียงเป็นอันดับเดียวกัน
| หัวข้อ | LFM3-Audio-2B | Voxtral 3 |
|---|---|---|
| รูปแบบการให้บริการ | ดาวน์โหลดน้ำหนักโมเดล เปิดใช้งานผ่าน Ollama ได้ ขนาดไฟล์ 2.1 GB | บริการผ่าน API ไม่มีน้ำหนักโมเดลให้ดาวน์โหลด |
| อินพุตและเอาต์พุต | รับข้อความหรือเสียง 16 kHz ส่งข้อความ เสียงพูด 24 kHz หรือสลับข้อความกับเสียงพูด พร้อมเรียกเครื่องมือ | ชุดผลิตภัณฑ์แยกตัวถอดเสียงแบบชุดและสตรีมมิง โมเดลสร้างเสียง และเครื่องมือสำหรับเอเจนต์ |
| บริบท | 32K โทเค็น ทั้งอินพุตและเอาต์พุต | ไม่เปิดเผยตัวเลขบริบทของตัวถอดเสียง คิดการใช้งานตามระยะเวลาเสียง |
| ภาษาและความสามารถที่ระบุ | รองรับ 18 ภาษาใน 19 โลแคล | ตัวถอดเสียงรองรับมากกว่า 50 ภาษา ส่วนรุ่นเรียลไทม์ระบุ 35+ ถึง 40+ ภาษา |
| จุดเด่นที่มีข้อมูลเผยแพร่ | โมเดลเดียวรองรับการฟัง พูด เข้าใจ แปล และเรียกเครื่องมือ | มีการแยกผู้พูดและปรับเอนเอียงตามบริบท โดยมีข้อมูลทดสอบเฉพาะของผู้ให้บริการ |
จุดต่างที่ใช้ตัดสินใจได้ชัดที่สุดคือการควบคุมการติดตั้ง: LFM3-Audio-2B เป็นโมเดลรันในเครื่อง ส่วน Voxtral 3 เป็นบริการที่เรียกใช้ผ่าน API หากต้องการข้อมูลแยกผู้พูดหรือให้ระบบรู้จักคำเฉพาะจากบริบท Voxtral 3 เปิดเผยความสามารถเหล่านี้ พร้อมรายงานค่า cpWER 18.4% และการเรียกคืนคีย์เฟรสที่เพิ่มจาก 81.4% เป็น 94.6% เมื่อให้บริบท แต่ตัวเลขดังกล่าวมาจากชุดทดสอบของผู้ให้บริการ ไม่ใช่การเทียบตรงกับ LFM3-Audio-2B
LFM3-Audio-2B เทียบกับ Voxtral 3: เลือกการควบคุมหรือความพร้อมใช้
LFM3-Audio-2B เหมาะกับนักพัฒนาที่ต้องการทดลอง สร้างระบบส่วนตัว หรือให้เสียงทำงานในเครื่องโดยไม่ส่งข้อมูลไปยังบริการภายนอก น้ำหนักโมเดลเปิดภายใต้สัญญาอนุญาต LFM Open License v1.0 และขนาดดาวน์โหลด 2.1 GB ทำให้เริ่มทดสอบได้โดยไม่ต้องจัดโครงสร้าง API ก่อน อย่างไรก็ตาม ความพร้อมใช้งานจริงยังขึ้นกับหน่วยความจำและกำลังประมวลผลของอุปกรณ์ รวมถึงความสามารถของทีมในการดูแลการติดตั้งและการอัปเดต Voxtral 3 เหมาะกับทีมที่ต้องการเวิร์กโฟลว์ซึ่งแยกงานถอดเสียงแบบชุด งานสตรีมมิง การสร้างเสียง และการเชื่อมต่อเอเจนต์ผ่าน SDK การไม่มีน้ำหนักให้ดาวน์โหลดแลกกับการไม่ต้องบริหารโมเดลเอง แต่หมายถึงการพึ่งพา API และบริการของผู้ให้บริการ อีกทั้งยังไม่มีตัวเลขบริบทที่ประกาศไว้สำหรับตัวถอดเสียง จึงควรตรวจสอบข้อจำกัดและรูปแบบการคิดค่าบริการก่อนนำไปใช้จริง
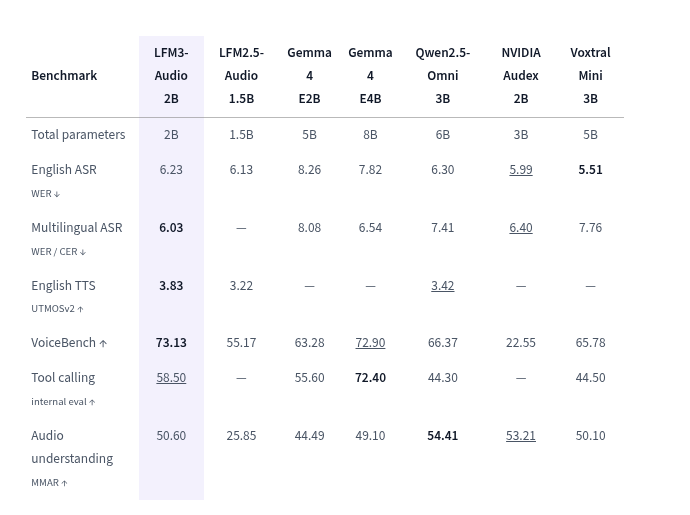
อย่าใช้ผลของ Voxtral Mini 3B ในตารางหนึ่งเป็นคำตอบแทน Voxtral 3 เพราะเป็นคนละรุ่นและคนละผลิตภัณฑ์ รุ่นดังกล่าวเคยมีผลถอดเสียงภาษาอังกฤษ 5.51% เทียบกับ 6.23% ของ LFM3-Audio-2B ในการทดสอบที่ระบุไว้ แต่ไม่ได้พิสูจน์ว่า Voxtral 3 เหนือกว่า และไม่มีการเปรียบเทียบแบบตัวต่อตัวระหว่าง LFM3-Audio-2B กับโมเดล Voxtral 3
Omni หรือโมเดลเสียงเฉพาะทาง
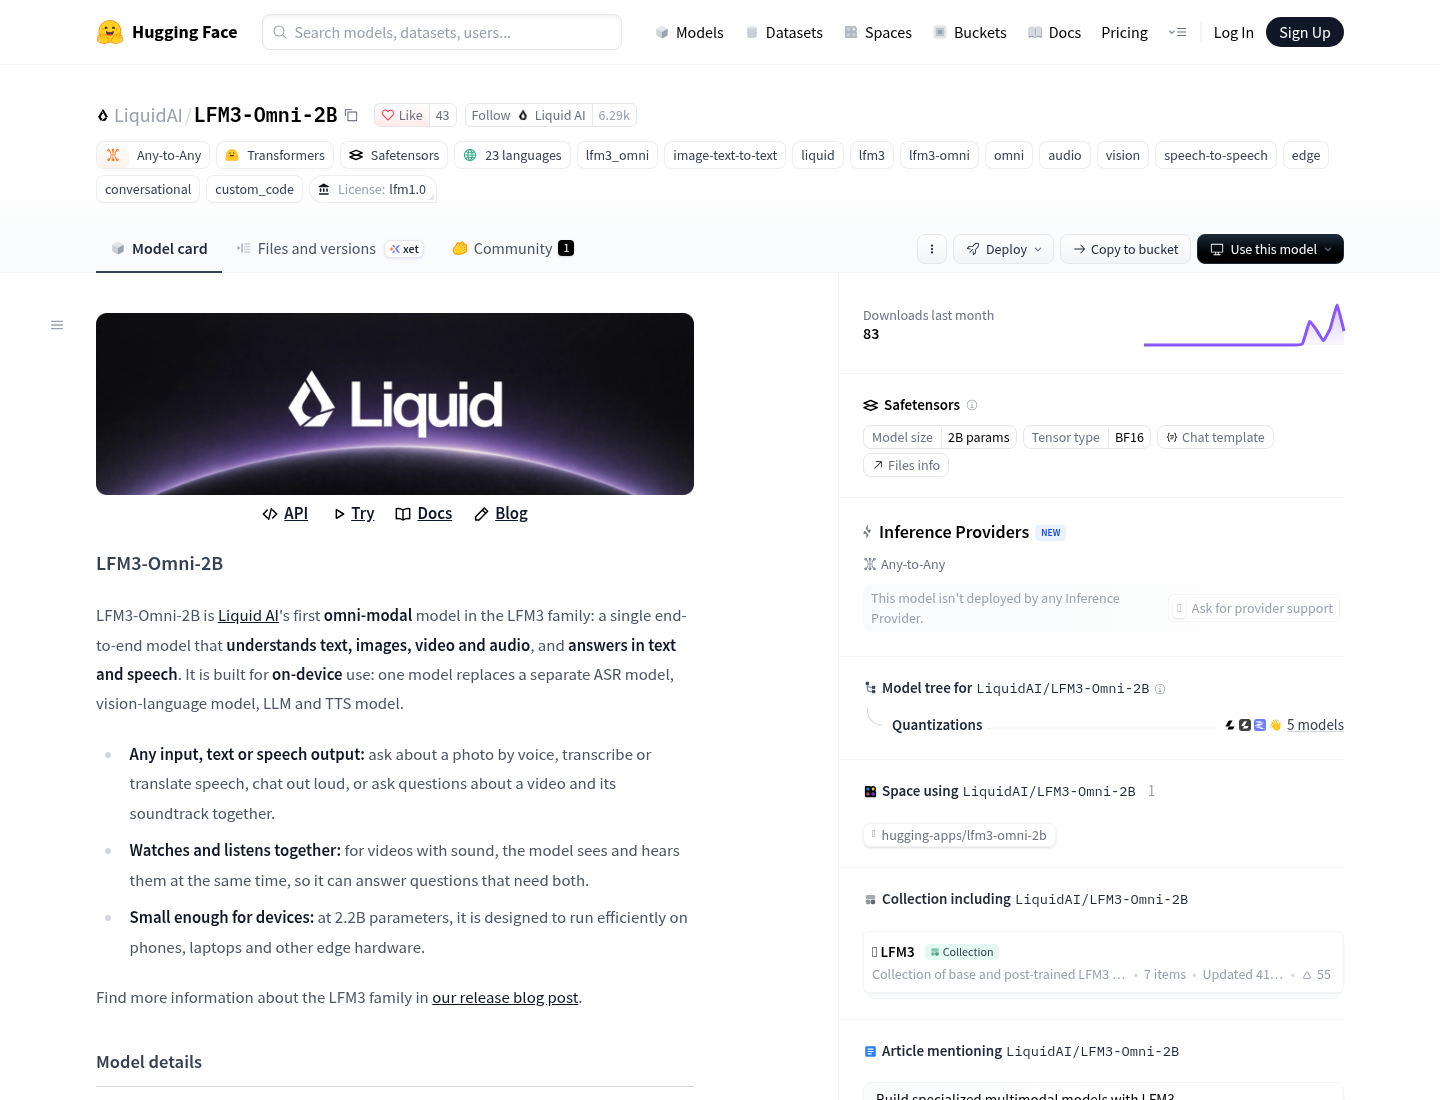
หากงานไม่ได้จำกัดอยู่ที่เสียง LFM3-Omni-2B มีความยืดหยุ่นกว่า: รับข้อความ ภาพ วิดีโอ และเสียง แล้วตอบกลับเป็นข้อความหรือเสียงพูด 24 kHz ด้วยโมเดลขนาด 2.17 พันล้านพารามิเตอร์ ส่วน Ming-3.0-audio-tiny มุ่งเน้นงานเสียง รับเสียงและข้อความ และสร้างข้อความหรือเสียงพูด 44.1 kHz ขนาดรวม 9.3 พันล้านพารามิเตอร์ โดยมีพารามิเตอร์ที่ทำงานในแต่ละขั้น 2.7 พันล้าน ชื่อ tiny อาจทำให้เข้าใจว่ากินทรัพยากรน้อยกว่าเสมอ แต่ขนาดพารามิเตอร์รวมของ Ming มากกว่า LFM3-Omni-2B หลายเท่า แม้จำนวนที่ทำงานต่อขั้นจะต่ำกว่าขนาดรวมก็ตาม ค่าใช้จ่ายหน่วยความจำและฮาร์ดแวร์ที่ใช้ได้จริงจึงเป็นตัวกำหนดว่าจะติดตั้งไหวหรือไม่ ไม่ใช่ชื่อรุ่นหรือคะแนนเบนช์มาร์กเพียงอย่างเดียว
เลือก LFM3-Omni-2B เมื่อผู้ช่วยต้องดูภาพหรือวิดีโอไปพร้อมกับฟัง และต้องการให้คำตอบออกมาเป็นเสียงโดยตรง ส่วน Ming-3.0-audio-tiny เหมาะกับผลิตภัณฑ์ที่เน้นการถอดเสียง บทสนทนาเสียง การโคลนเสียง หรือวิเคราะห์สายสนทนา โดยไม่ต้องใช้ความสามารถด้านภาพ หรือพร้อมจับคู่โมเดลภาพแยกต่างหาก
เสียงตอบกลับหรือข้อความพร้อมบริบทขนาดใหญ่
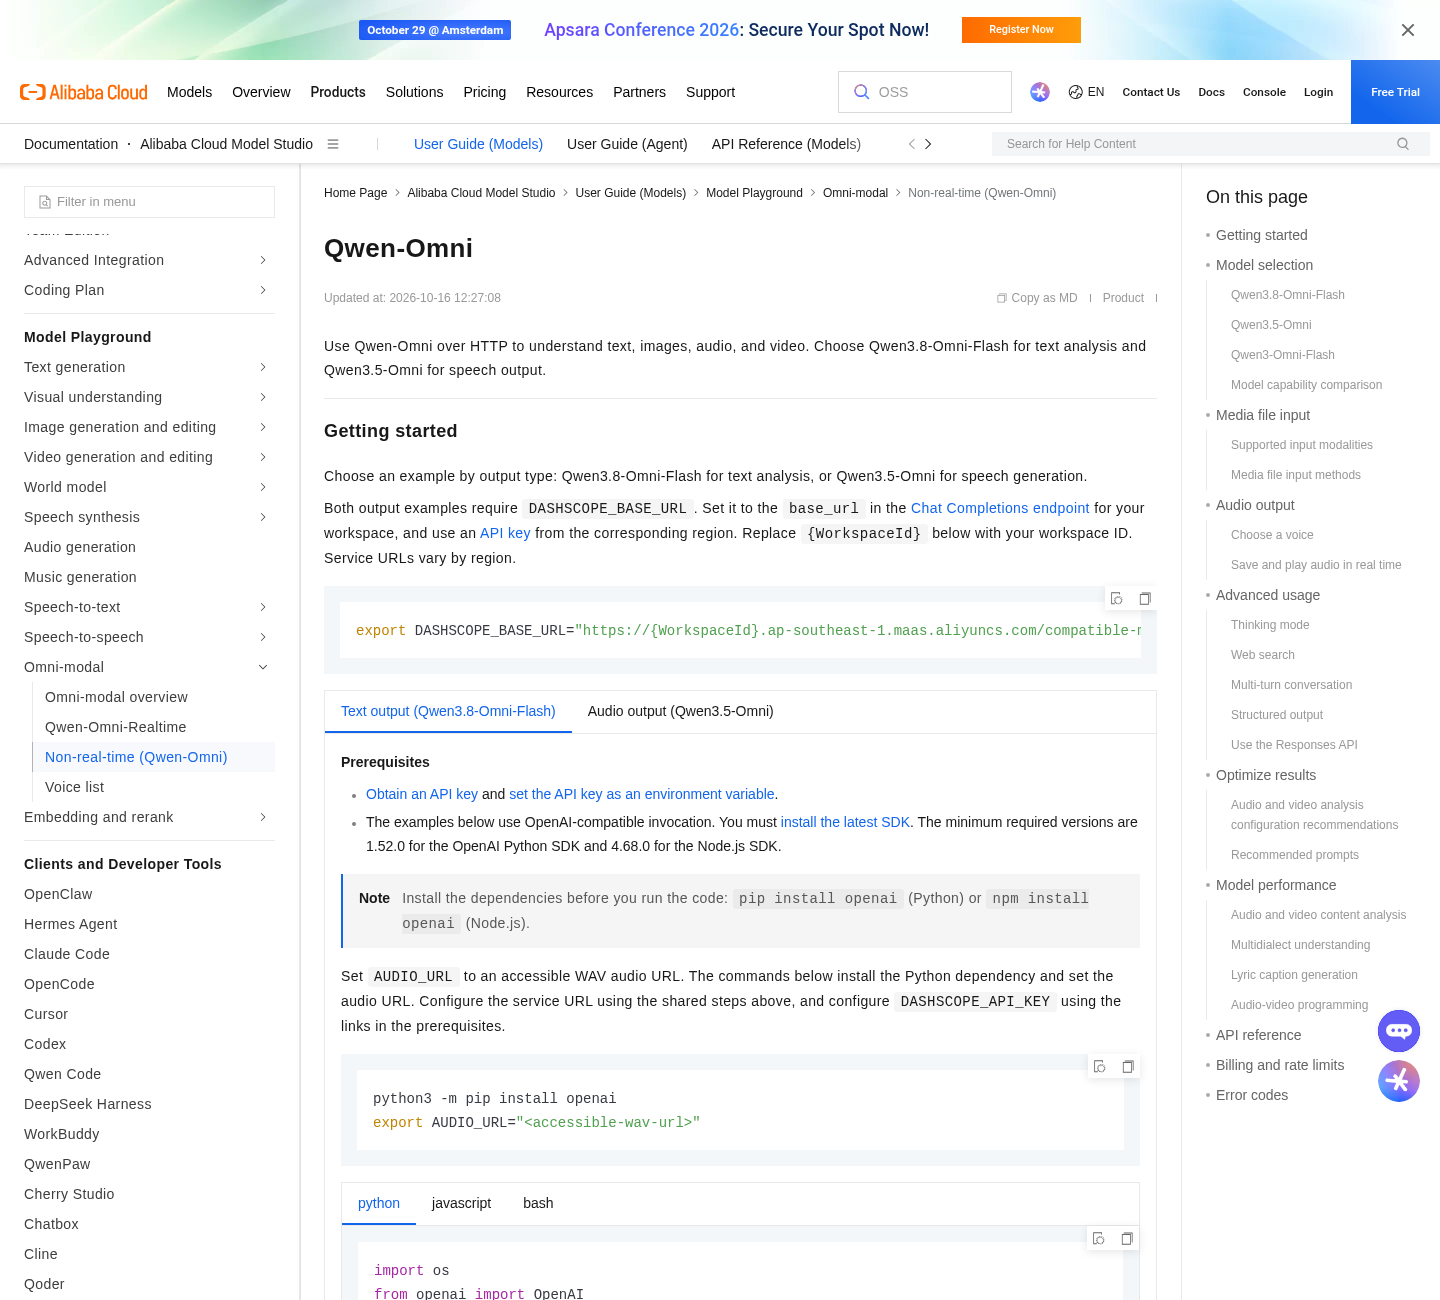
เมื่อต้องเลือกระหว่างผู้ช่วยที่พูดได้กับระบบที่เน้นการทำความเข้าใจและบริบท ให้ดูปลายทางของงานเป็นหลัก LFM3-Omni-2B ส่งเสียงพูด 24 kHz ได้โดยตรง และมีบริบท 32K โทเค็น ขณะที่ Qwen3.8-Omni-Flash รองรับเสียงและวิดีโอแต่ส่งคืนข้อความเท่านั้น หากต้องการเสียงพูดจาก Qwen ต้องเรียกโมเดลอื่นในตระกูลเดียวกัน Qwen3.8-Omni-Flash ให้บริบทสูงสุด 1 ล้านโทเค็น โดยมีอินพุตได้ประมาณ 991K และเอาต์พุตได้ถึง 131K จึงเหมาะกับการวิเคราะห์สื่อที่ยาวและต้องการพื้นที่บริบทมาก แต่เป็นบริการ API แบบปิดน้ำหนัก ส่วน LFM3-Omni-2B เป็นตัวเลือกที่น่าสนใจกว่าสำหรับผู้ช่วยที่ต้องตอบด้วยเสียงและทำงานกับหลายสื่อในโมเดลเดียว การสร้างระบบพูดโต้ตอบด้วยโมเดลที่คืนข้อความอาจต้องเพิ่มขั้นตอนรู้จำเสียงและสังเคราะห์เสียง จึงควรนับทั้งความซับซ้อนและจำนวนบริการที่ต้องเชื่อมต่อในการตัดสินใจ
สำหรับการเปรียบเทียบ AI Audio ให้เริ่มจากสิ่งที่ต้องทำจริง แล้วค่อยตรวจความเข้ากันได้กับอุปกรณ์ จำนวนข้อมูลที่ต้องประมวลผล และรูปแบบการติดตั้ง โมเดลเล็กที่รันได้ในเครื่องอาจเหมาะกับการทดลองหรือการใช้งานเฉพาะจุด ขณะที่โมเดลหรือ API ที่มีความสามารถกว้างกว่าอาจตอบโจทย์ระบบที่ต้องรองรับบริบทและเวิร์กโฟลว์ซับซ้อนกว่า จุดคุ้มทุนจึงขึ้นกับอัตราการใช้งานและภาระดูแลระบบ ไม่ใช่ผลเบนช์มาร์กอย่างเดียว
Buy if / Skip if
- Buy the LFM3-Audio-2B if ต้องการดาวน์โหลดโมเดลรันในเครื่อง ทดลองงานเสียงหลายภาษา และใช้การสร้างเสียงหรือเรียกเครื่องมือจากโมเดลเดียว
- Skip the LFM3-Audio-2B if ต้องการข้อมูลยืนยันการแยกผู้พูดหรือการปรับเอนเอียงตามบริบท และต้องการตัวเลขทดสอบที่เทียบตรงกับ Voxtral 3
- Buy the Voxtral 3 if ต้องการ API สำหรับงานถอดเสียง สตรีมมิง การสร้างเสียง และเครื่องมือเชื่อมต่อเอเจนต์ โดยไม่ต้องจัดการน้ำหนักโมเดลเอง
- Skip the Voxtral 3 if ต้องดาวน์โหลดน้ำหนักมารันแบบออฟไลน์ หรือจำเป็นต้องรู้ขนาดไฟล์และตัวเลขบริบทของตัวถอดเสียงก่อนเริ่มใช้งาน
- Buy the LFM3-Omni-2B if ผู้ช่วยต้องรับภาพหรือวิดีโอควบคู่กับเสียง และต้องการให้ตอบกลับเป็นเสียงพูด
- Skip the LFM3-Omni-2B if งานเน้นเสียงอย่างเดียวและต้องการใช้ความสามารถเฉพาะทางด้านเสียงของ Ming-3.0-audio-tiny
- Buy the Ming-3.0-audio-tiny if ผลิตภัณฑ์เน้นถอดเสียง สนทนาเสียง หรือโคลนเสียง และมีทรัพยากรพอสำหรับโมเดลขนาดใหญ่กว่า
- Skip the Ming-3.0-audio-tiny if ต้องใช้ภาพและวิดีโอในโมเดลเดียว หรือต้องจำกัดภาระหน่วยความจำให้ใกล้กับโมเดลขนาด 2B